Comment Meituan a construit une plateforme de retrieval à l'échelle de 10B sur Milvus pour alimenter plus de 100 cas d'utilisation

10 milliards+ de vecteurs
En production, auto-hébergé sur Milvus
2B+ dans une seule collection
La plus grande charge de travail unique, ayant grandi sans réarchitecture.
P99 8.1 ms
~1 000 QPS et >97% de recall sur un benchmark de 100M vecteurs, 768 dimensions
100+ cas d'utilisation
Sur une plateforme Milvus partagée : RAG, mémoire d'agent, et plus encore.
« Lorsque Meituan s’est engagé dans l’IA, il nous fallait une fondation de recherche conçue pour les vecteurs dès le départ. Nous avons choisi Milvus en open source et l’avons transformé en une plateforme sur laquelle chaque équipe peut s’appuyer. Un an plus tard, elle contient plus de 10 milliards de vecteurs et fait tourner nos charges de travail IA qui connaissent la croissance la plus rapide, du RAG à la mémoire d’agent. »
The Meituan Database Team
À propos de Meituan
Meituan est l'une des plus grandes entreprises technologiques d'Asie et exploite une plateforme de premier plan à la demande pour les services locaux. Son super-app couvre la livraison de repas, la restauration sur place et les avis des consommateurs, la réservation d'hôtels et de voyages, l'épicerie et le retail instantané — le tout assuré par un vaste réseau de commerçants et de livreurs locaux.
L'IA est devenue centrale dans la manière dont Meituan sert ce marché, depuis la réponse aux questions des clients jusqu'à la fourniture d'outils plus intelligents aux commerçants. Plus de 100 scénarios métier utilisent désormais le RAG, la mémoire d'agent et la recherche multimodale, et chacun a besoin d'une recherche vectorielle rapide et filtrée en dessous. L'équipe de bases de données de Meituan fait fonctionner cette fondation de données partagée sur Milvus open-source.
Le défi
À mesure que la recherche vectorielle s'est étendue dans Meituan, l'équipe de bases de données a dû prendre en charge un ensemble de charges de travail de plus en plus varié. Différentes applications ont apporté des exigences différentes en termes de types de données vectorielles, d'algorithmes d'index, de dimensions et de performances de récupération, tandis que la taille des jeux de données allait de quelques millions à des milliards de vecteurs.
Meituan avait besoin d'une infrastructure partagée capable de répondre à ces différentes exigences à grande échelle tout en équilibrant les performances des requêtes, l'efficacité des ressources et le coût opérationnel. Au départ, ils utilisaient Elasticsearch pour la recherche vectorielle, mais il ne pouvait bientôt plus répondre aux exigences de performance et de coût de Meituan. Elasticsearch plafonnait les vecteurs à 4 096 dimensions, ne supportait qu'un petit nombre de types de vecteurs et ne disposait pas d'index sur disque, de sorte que chaque vecteur devait être stocké en mémoire. Avec des centaines de millions de vecteurs, cela rendait les jeux de données les plus volumineux et dont la croissance était la plus rapide les plus coûteux à maintenir en ligne. L'équipe avait besoin d'un moteur de recherche vectorielle spécialement conçu dont les types d'index pouvaient contenir d'énormes jeux de données sur disque, et pas seulement en RAM.
Pourquoi Milvus
L'équipe de bases de données a évalué les principaux moteurs de recherche vectorielle en termes de capacité, de performance et d'écosystème, puis a choisi Milvus open-source. Trois raisons ont conduit à cette décision.
Capacité. Milvus offrait la diversité de types de données vectorielles et d'algorithmes d'index dont Meituan avait besoin pour un ensemble très varié de charges de travail, y compris des index sur disque pour de très grandes collections. Son architecture à séparation stockage-calcul a également donné à l'équipe plus de flexibilité pour faire évoluer efficacement de grandes charges de travail vectorielles.
Performance. Dans le benchmark interne de l'équipe portant sur 100 millions de vecteurs à 768 dimensions avec un index HNSW, Milvus a maintenu une latence P99 à 8,1 ms et environ 1 000 QPS, avec un rappel supérieur à 97 %.
Écosystème. Milvus s'intégrait également naturellement dans la pile d'IA open-source plus large de Meituan. Il offrait des SDK matures, une documentation et une communauté active (46k+ étoiles GitHub), tandis que certains des frameworks open-source adoptés par les équipes internes prenaient déjà en charge Milvus directement. Cela a réduit les frictions d'intégration et a facilité l'ajout de nouveaux scénarios de recherche vectorielle sur la plateforme.
La solution
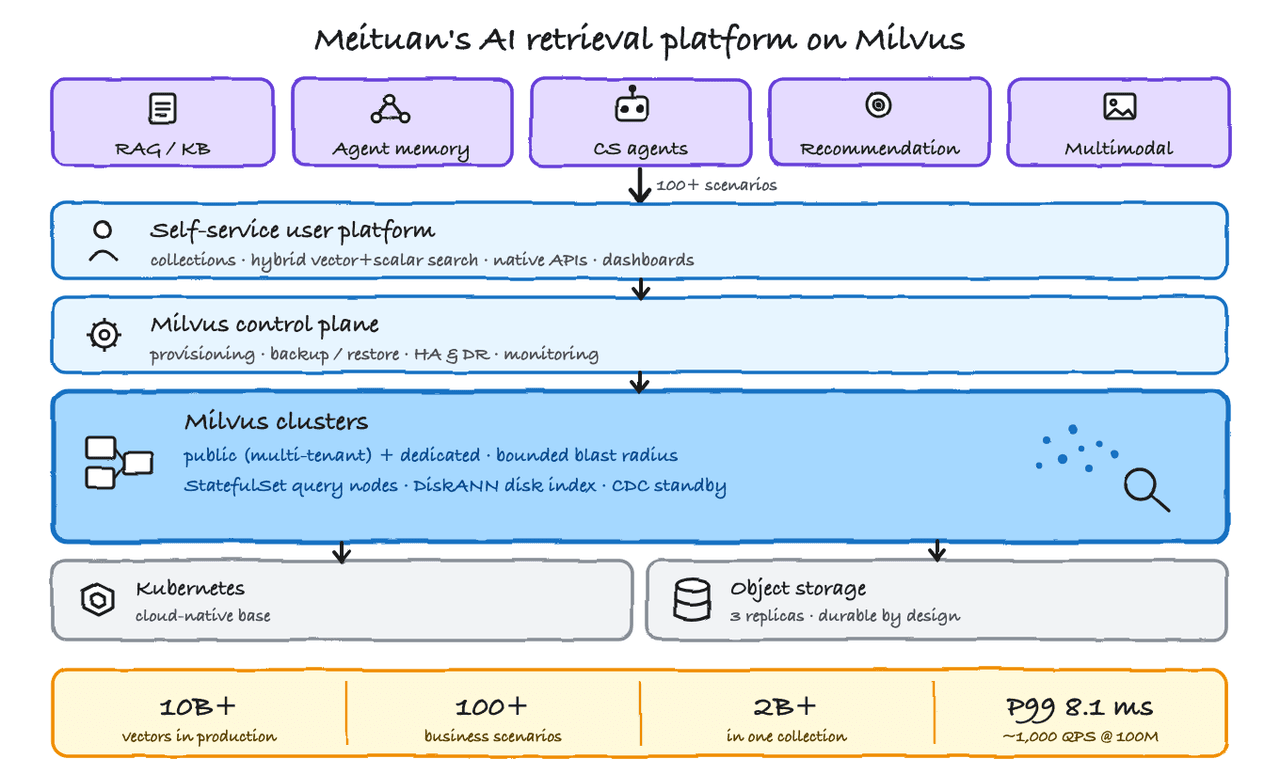
Après avoir évalué les principaux moteurs de recherche vectorielle, Meituan a choisi Milvus comme fondation vectorielle native pour ses charges de travail d'IA croissantes, tandis que son déploiement Elasticsearch existant restait partie intégrante de l'architecture plus large à double moteur. Ces cas d'usage vectoriels couvrent le RAG et les bases de connaissances, la mémoire d'agent, les agents de service client et de diagnostic, la recommandation et la recherche multimodale. La plupart partagent une forme similaire : de quelques millions à des dizaines de millions de vecteurs, de 768 à 1 536 dimensions, servis à ~100 requêtes par seconde. Quelques-uns sont beaucoup plus grands, comme la charge de travail qui a dépassé les deux milliards de vecteurs.
Au lieu de laisser chaque équipe faire tourner son propre Milvus, l’équipe base de données a tout centralisé sur une plateforme partagée qui offre à n’importe quelle équipe un cluster prêt pour la production, sans en faire des expert·es des bases vectorielles. Servir des charges de travail aussi variées depuis une seule plateforme tenait à quatre points : héberger des milliards de vecteurs à moindre coût, garantir l’isolation des locataires pour qu’aucun ne puisse entraîner les autres vers le bas, rester fiable pour des charges critiques pour l’entreprise, et proposer un niveau de self-service suffisant pour qu’une petite équipe puisse soutenir tout le monde.
 Meituan's AI retrieval platform on Milvus.PNG
Héberger des milliards de vecteurs à moindre coût, grâce aux index disque
Le gain de coût vient des index disque de Milvus. Avec DiskANN, une grande collection vit principalement sur disque plutôt qu’en mémoire, ce qui maintient même une charge de deux milliards de vecteurs à un coût abordable. Sur le matériel de Meituan, ces index exigeaient plus de disque local qu’un déploiement standard n’en accorde à un nœud de requête ; l’équipe a donc monté des volumes dédiés et exécuté l’opérateur de Milvus sous forme de StatefulSets, afin que chaque nœud conserve son propre disque à travers les redémarrages. Comme l’opérateur est open source, ce fut une modification simple à réaliser, et c’est pourquoi Meituan peut s’appuyer aussi fortement sur les index disque.
Isolation entre de nombreux locataires : clusters publics et dédiés avec un rayon d’explosion maîtrisé
Milvus permet à de nombreux locataires de partager un même cluster, chacun dans sa propre base, si bien que Meituan regroupe la longue traîne des petites charges sur des clusters publics et maintient un taux d’utilisation élevé. Les charges plus importantes disposent de leurs propres clusters dédiés : tout ce qui dépasse un million de vecteurs, tout ce qui exige un QPS élevé, tout ce qui est critique pour l’entreprise, ou tout ce qui nécessite un réglage spécifique.
Le seul risque du partage, c’est le rayon d’explosion : un locataire mal comporté qui entraîne ses voisins vers le bas. Meituan plafonne donc le nombre de locataires par cluster public et évalue la charge de travail de chaque nouveau venu, son importance et ses données avant de le placer.
Fiabilité pour les charges critiques : bascule rapide, puis secours CDC
Parce que Milvus sépare le stockage du calcul, les données elles-mêmes sont déjà sûres (elles résident dans le stockage objet, avec trois copies) ; le travail de fiabilité de Meituan consiste donc surtout à maintenir le service joignable. Les clients atteignent Milvus par ses nœuds proxy, et quand un proxy meurt, le trafic doit être redirigé rapidement. Meituan a intégré la bascule dans ses propres SDK Milvus, en Python et en Java : le plan de contrôle suit quels proxies sont sains et transmet cette liste au SDK, si bien que les clients se dirigent directement vers un proxy actif, et qu’un proxy défaillant est retiré avant même d’être arrêté. Cela permet d’éviter un load balancer devant chaque cluster, et la surcharge qui va avec.
Pour la reprise après sinistre, Meituan répartit les nœuds d’un cluster entre les centres de données, d’abord les proxies et les coordinateurs, puis le middleware, dans le but d’équilibrer chaque composant entre les zones de disponibilité, plus une marge (N+1). Pour les charges qui ne peuvent vraiment pas tomber, ils utilisent le CDC de Milvus pour maintenir un cluster de secours synchronisé, prêt à prendre le relais en cas de défaillance totale du primaire.
Self-service, pour qu’une petite équipe serve tout le monde
La plateforme de Meituan confie le contrôle quotidien aux équipes propriétaires des charges : gestion visuelle des collections (créer, supprimer, charger, libérer), accès en un clic aux API natives de Milvus, recherche hybride vecteurs-plus-scalaires, tableaux de bord de supervision, et contrôle d’accès au niveau des bases. Les sauvegardes s’exécutent automatiquement au niveau de la base, et les canaux de synchronisation des données font entrer les vecteurs depuis des sources comme Hive et RDS ou les font sortir pour la reprise après sinistre. Comme le travail courant est transféré aux utilisateurs, la charge d’astreinte reste faible, et une petite équipe plateforme maintient toute la flotte en bonne santé.
Résultats et bénéfices
Plus de 10B de vecteurs en production, partis de zéro en environ un an. Une plateforme standardisée fait désormais tourner Milvus à grande échelle pour plus de 100 cas d’usage, avec une livraison automatisée des clusters, des sauvegardes et du self-service qui maintiennent l’équipe d’exploitation réduite.
À l'échelle du milliard dans une seule charge de travail, avec de la marge. La plus grande charge de travail unique a dépassé les 2 milliards de vecteurs sans repenser l'architecture.
P99 8,1 ms à ~1 000 QPS, recall >97 % sur le benchmark de 100M de vecteurs et 768 dimensions de l'équipe, avec bien plus de marge que ce dont ses charges de travail, pour la plupart inférieures à 100 QPS, ont besoin.
Les charges de travail d'IA à la croissance la plus rapide de l'entreprise tournent ici. Le RAG et la mémoire d'agent stimulent la croissance, alors Meituan construit une infrastructure de recherche partagée au lieu de laisser chaque équipe monter la sienne.
Les collections à l'échelle du milliard restent abordables. Garder la majeure partie d'une collection sur disque plutôt qu'en RAM rend l'exécution d'une charge de travail de deux milliards de vecteurs abordable, et parce que Milvus est open source, l'équipe continue de réduire encore les coûts avec son propre index sur disque.
Le bénéfice stratégique : la recherche vectorielle n'est plus un problème que chaque équipe de Meituan résout isolément. C'est une plateforme standardisée et fiable, ce qui libère les équipes d'IA qui s'appuient dessus pour construire des produits plutôt que de l'infrastructure.
La suite
Meituan approfondit son investissement dans Milvus sur trois fronts. Les nouveaux clusters utilisent désormais Milvus 2.6 par défaut, et l'équipe migre les charges de travail existantes à mesure qu'elle adopte des fonctionnalités telles que les fonctions d'embedding intégrées. Côté noyau, elle développe un index sur disque développé en interne, basé sur la quantification, sur Milvus 2.6 pour pousser encore plus loin l'efficacité des coûts à l'échelle du milliard. Et à mesure que les agents se répandent dans l'entreprise, l'équipe construit une capacité de mémoire d'agent au niveau de la plateforme sur Milvus et son écosystème, afin que les équipes internes disposent de briques de mémoire et de base de connaissances prêtes à l'emploi. Chacune de ces avancées accroît ce qui tourne sur Milvus, et l'équipe prévoit de continuer à contribuer en retour à la communauté au fur et à mesure.
« Meituan est exactement le genre d'entreprise axée sur l'ingénierie qui fait avancer l'open source : ils font tourner Milvus à une échelle que la plupart des équipes n'atteignent jamais, et ils partagent ce qu'ils apprennent. Nous sommes fiers que Milvus soit la fondation vectorielle des charges de travail d'IA de Meituan, et nous sommes ravis de continuer à construire aux côtés de leur équipe et de la communauté. » — James Luan, CTO, Zilliz
Commencer avec Milvus ou essayer le service Milvus géré
Milvus est la base de données vectorielle open source la plus largement adoptée au monde, conçue pour la recherche de similarité à l'échelle du milliard et fonctionnant d'un ordinateur portable à un cluster distribué. Elle vous offre le même moteur vectoriel natif qui se trouve derrière la plateforme de Meituan : une gamme complète de types d'index, une recherche hybride vectorielle et scalaire, et une architecture à séparation stockage-calcul qui passe à l'échelle.
Commencez avec Milvus sur GitHub, lisez la documentation et rejoignez la communauté sur Discord.
Quand vous voulez le même moteur sous forme de service entièrement géré, avec des opérations sans maintenance et une sécurité d'entreprise, Zilliz Cloud est construit sur Milvus et compatible avec ses API.
- À propos de Meituan
- Le défi
- Pourquoi Milvus
- La solution
- Résultats et bénéfices
- La suite
- Commencer avec Milvus ou essayer le service Milvus géré
Contenu
Secteur d'activité
Commerce électronique