Wie Meituan auf Milvus eine Retrieval-Plattform im 10B-Maßstab baute, um 100+ Anwendungsfälle zu unterstützen

10B+ Vektoren
In Produktion, selbst betrieben auf Milvus.
2B+ in einer Sammlung
Die größte einzelne Arbeitslast, gewachsen ohne Neuarchitektur.
P99 8.1 ms
~1.000 QPS und >97 % Recall bei einem Benchmark mit 100 Millionen Vektoren und 768 Dimensionen
100+ Anwendungsfälle
Auf einer gemeinsamen Milvus-Plattform: RAG, Agentenspeicher und mehr
Als sich Meituan zu KI verpflichtete, brauchten wir eine Retrieval-Grundlage, die von Grund auf für Vektoren gebaut wurde. Wir wählten das Open-Source-Milvus und machten daraus eine Plattform, auf der jedes Team aufbauen kann. Ein Jahr später enthält sie mehr als 10 Milliarden Vektoren und betreibt unsere am schnellsten wachsenden KI-Workloads – von RAG bis zum Agentengedächtnis.
The Meituan Database Team
Über Meituan
Meituan ist eines der größten Technologieunternehmen Asiens und betreibt eine führende On-Demand-Plattform für lokale Dienstleistungen. Die Super-App umfasst Essenslieferung, Restaurantbesuche und Verbraucherbewertungen, Hotel- und Reisebuchung, Lebensmittel und Sofort-Einzelhandel – all das wird über ein riesiges Netzwerk lokaler Händler und Kurierfahrer abgewickelt.
KI ist inzwischen zentral dafür, wie Meituan diesen Marktplatz bedient – von der Beantwortung von Kundenfragen bis hin zu intelligenteren Tools für Händler. Mehr als 100 Geschäftsszenarien nutzen heute RAG, Agent Memory und multimodale Suche, und jedes benötigt darunter eine schnelle, gefilterte Vektorsuche. Das Datenbankteam von Meituan betreibt diese gemeinsame Datenbasis auf Open-Source-Milvus.
Die Herausforderung
Mit der Ausweitung der Vektorsuche bei Meituan musste das Datenbankteam eine immer vielfältigere Palette von Workloads unterstützen. Verschiedene Anwendungen brachten unterschiedliche Anforderungen an Vektordatentypen, Indexalgorithmen, Dimensionen und Suchleistung mit sich, während die Datensatzgrößen von Millionen bis zu Milliarden von Vektoren reichten.
Meituan benötigte eine gemeinsame Infrastruktur, die diese unterschiedlichen Anforderungen skalieren konnte und dabei Abfrageleistung, Ressourceneffizienz und Betriebskosten ausbalancierte. Zunächst setzten sie für die Vektorsuche Elasticsearch ein, doch das konnte Meituans Leistungs- und Kostenanforderungen bald nicht mehr erfüllen. Elasticsearch begrenzte Vektoren auf 4.096 Dimensionen, unterstützte nur eine Handvoll Vektortypen und hatte keinen Disk-Index, sodass jeder Vektor im RAM liegen musste. Bei hunderten Millionen von Vektoren bedeutete das, dass Meituans größte und am schnellsten wachsende Datensätze am teuersten online zu halten waren. Das Team brauchte eine spezialisierte Vektorsuchmaschine, deren Indextypen riesige Datensätze auf der Festplatte halten konnten, nicht nur im Arbeitsspeicher.
Warum Milvus
Das Datenbankteam bewertete die wichtigsten Vektorsuchmaschinen nach Fähigkeit, Leistung und Ökosystem und entschied sich dann für Open-Source-Milvus. Drei Gründe führten zu dieser Entscheidung.
Fähigkeit. Milvus bot die Bandbreite an Vektordatentypen und Indexalgorithmen, die Meituan über eine sehr unterschiedliche Palette von Workloads hinweg benötigte, einschließlich disk-basierter Indizes für sehr große Sammlungen. Die Architektur mit getrenntem Storage und Compute gab dem Team außerdem mehr Flexibilität, große Vektor-Workloads effizient zu skalieren.
Leistung. Im eigenen Benchmark des Teams mit 100 Millionen 768-dimensionalen Vektoren auf einem HNSW-Index hielt Milvus die P99-Latenz bei 8,1 ms und etwa 1.000 QPS, mit einer Recall-Rate über 97 %.
Ökosystem. Milvus fügte sich außerdem natürlich in Meituans breiteren Open-Source-KI-Stack ein. Es bot ausgereifte SDKs, Dokumentation und eine aktive Community (46k+ GitHub-Sterne), während einige der von internen Teams übernommenen Open-Source-Frameworks Milvus bereits direkt unterstützten. Das reduzierte den Integrationsaufwand und erleichterte es, neue Vektorsuch-Szenarien auf die Plattform zu bringen.
Die Lösung
Nach der Bewertung der wichtigsten Vektorsuchmaschinen wählte Meituan Milvus als vektornative Grundlage für seine wachsenden KI-Workloads, während die bestehende Elasticsearch-Bereitstellung Teil der breiteren Zwei-Engine-Architektur blieb. Diese Vektor-Anwendungsfälle umfassen RAG und Wissensdatenbanken, Agent Memory, Kundendienst- und Diagnose-Agenten, Empfehlungen und multimodale Suche. Die meisten haben eine ähnliche Form: einige Millionen bis zig Millionen Vektoren, 768 bis 1.536 Dimensionen, bedient mit ~100 Abfragen pro Sekunde. Einige wenige sind weitaus größer, wie etwa der eine Workload, der die Marke von zwei Milliarden Vektoren überschritten hat.
Anstatt dass jedes Team sein eigenes Milvus betreibt, hat das Datenbank-Team alles auf einer gemeinsamen Plattform vereint, die jedem Team einen produktionsreifen Cluster bietet, ohne sie zu Vektor-Datenbank-Experten zu machen. Arbeitslasten dieser Vielfalt von einer einzigen Plattform aus zu bedienen, hing von vier Dingen ab: Milliarden von Vektoren kostengünstig zu halten, Mieter voneinander zu isolieren, damit einer keinen anderen mit nach unten ziehen kann, zuverlässig für geschäftskritische Arbeitslasten zu bleiben und genug Self-Service anzubieten, dass ein kleines Team alle unterstützen kann.
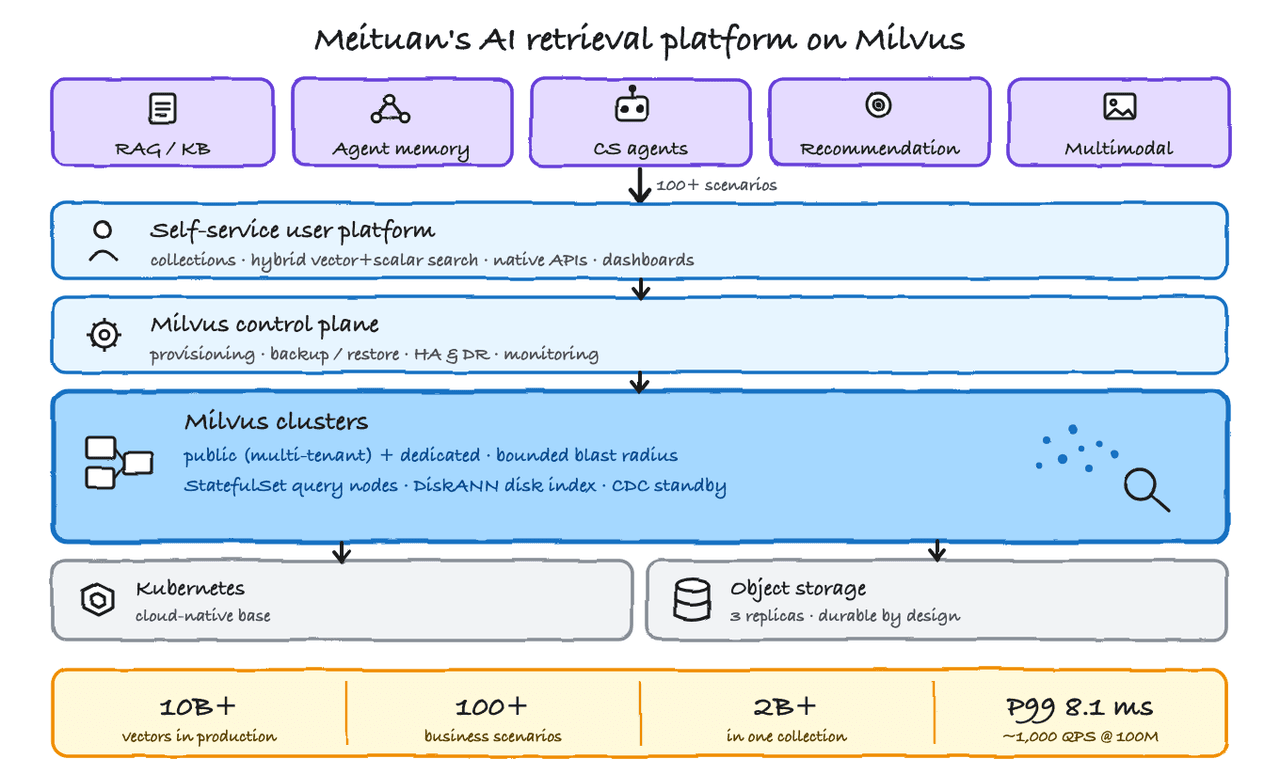 Meituan's AI retrieval platform on Milvus.PNG
Milliarden von Vektoren kostengünstig halten, mit Disk-Indexen
Der Kostenvorteil kommt von Milvus' Disk-Indexen. Mit DiskANN lebt eine große Sammlung hauptsächlich auf der Platte statt im Speicher, was selbst eine Arbeitslast mit zwei Milliarden Vektoren erschwinglich hält. Auf Meituans Hardware benötigten diese Indexe mehr lokalen Speicherplatz, als eine Standard-Bereitstellung einem Query-Node gibt, also mounted das Team dedizierte Volumes und betrieb Milvus' Operator als StatefulSets, sodass jeder Node seinen eigenen Speicherplatz über Neustarts hinweg behält. Da der Operator Open Source ist, war das eine einfache Änderung – und genau deshalb kann sich Meituan so stark auf Disk-Indexe stützen.
Isolation über viele Mieter hinweg: öffentliche und dedizierte Cluster mit begrenztem Blast Radius
Milvus erlaubt vielen Mietern, einen Cluster zu teilen, jeder in seiner eigenen Datenbank, also gruppiert Meituan den langen Schwanz kleiner Arbeitslasten auf öffentlichen Clustern und hält die Auslastung hoch. Die größeren Arbeitslasten bekommen ihre eigenen dedizierten Cluster: alles über einer Million Vektoren, alles, was hohe QPS braucht, alles Geschäftskritische oder alles, was eigene Abstimmung benötigt.
Das eine Risiko beim Teilen ist der Blast Radius – ein Fehlverhalten eines Mieters, das die Nachbarn mit nach unten zieht –, also begrenzt Meituan, wie viele Mieter auf einen öffentlichen Cluster gehen, und bewertet Job, Wichtigkeit und Daten jeder neuen Arbeitslast, bevor sie platziert wird.
Zuverlässigkeit für kritische Arbeitslasten: schnelles Failover, dann CDC-Standby
Da Milvus Speicher von Rechenleistung trennt, sind die Daten selbst bereits sicher (sie liegen in Objektspeicher mit drei Kopien), also dreht sich Meituans Zuverlässigkeitsarbeit wirklich darum, den Dienst erreichbar zu halten. Clients erreichen Milvus über seine Proxy-Nodes, und wenn ein Proxy stirbt, muss Verkehr sich schnell bewegen. Meituan baute Failover in seine eigenen Milvus-SDKs ein, in Python und Java: Die Control Plane verfolgt, welche Proxies gesund sind, und speist diese Liste ins SDK, sodass Clients direkt zu einem lebenden Proxy gehen und ein ausfallender Proxy entfernt wird, bevor er heruntergefahren wird. Das erlaubt ihnen, auf einen Load Balancer vor jedem Cluster und den damit verbundenen Overhead zu verzichten.
Für Disaster Recovery verteilt Meituan die Nodes eines Clusters über Rechenzentren, zuerst Proxies und Koordinatoren, dann die Middleware, mit dem Ziel, dass jede Komponente über Availability Zones plus ein Ersatzgerät (N+1) ausbalanciert ist. Für Arbeitslasten, die wirklich nicht ausfallen dürfen, nutzen sie Milvus' CDC, um einen Standby-Cluster synchron zu halten, bereit zur Übernahme, falls der Primärcluster vollständig ausfällt.
Self-Service, sodass ein kleines Team allen dient
Meituans Plattform gibt die tägliche Kontrolle an die Teams ab, die die Arbeitslasten besitzen: visuelles Collection-Management (erstellen, löschen, laden, freigeben), Ein-Klick-Zugriff auf Milvus' native APIs, hybride Vektor-plus-Skalar-Suche, Monitoring-Dashboards und Zugriffskontrolle auf Datenbankebene. Backups laufen automatisch auf Datenbankgranularität, und Daten-Synchronisationskanäle bewegen Vektoren aus Quellen wie Hive und RDS hinein oder für Disaster Recovery hinaus. Da die Routinearbeit zu den Nutzern verlagert wird, bleibt die Bereitschaftslast niedrig, und ein kleines Plattformteam hält die gesamte Flotte gesund.
Ergebnisse & Nutzen
10B+ Vektoren in Produktion, von null in etwa einem Jahr. Eine standardisierte Plattform betreibt nun Milvus in großem Maßstab für 100+ Anwendungsfälle, mit automatisierter Cluster-Bereitstellung, Backup und Self-Service, die das Betriebsteam klein halten.
Milliarden-Maßstab in einem einzigen Workload, mit Luft nach oben. Der größte einzelne Workload ist ohne Neuarchitektur auf über 2 Milliarden Vektoren gewachsen.
P99 8,1 ms bei ~1.000 QPS, Recall >97% im 100M-Vektor-, 768-Dimensions-Benchmark des Teams, weit mehr Luft nach oben, als seine meist unter 100 QPS liegenden Workloads benötigen.
Die am schnellsten wachsenden KI-Workloads des Unternehmens laufen hier. RAG und Agent-Memory treiben das Wachstum, daher baut Meituan eine gemeinsame Retrieval-Infrastruktur auf, anstatt dass jedes Team eine eigene aufsetzt.
Collections im Milliarden-Maßstab bleiben bezahlbar. Wenn der größte Teil einer Collection auf der Platte statt im RAM liegt, wird ein Workload mit zwei Milliarden Vektoren erschwinglich zu betreiben, und da Milvus Open Source ist, senkt das Team die Kosten mit einem eigenen Disk-Index weiter.
Der strategische Nutzen: Vektor-Retrieval ist nicht länger etwas, das jedes Meituan-Team allein löst. Es ist eine standardisierte, zuverlässige Plattform, die die darüberliegenden KI-Teams davon befreit, Produkte statt Infrastruktur zu bauen.
Wie es weitergeht
Meituan vertieft seine Investitionen in Milvus an drei Fronten. Neue Cluster setzen jetzt standardmäßig auf Milvus 2.6, und das Team migriert bestehende Workloads, während es Funktionen wie integrierte Embedding-Funktionen übernimmt. Auf der Kernel-Seite entwickelt es einen selbst gebauten, quantisierungsbasierten Disk-Index auf Milvus 2.6, um die Kosteneffizienz im Milliarden-Maßstab weiter zu steigern. Und da sich Agents im gesamten Unternehmen ausbreiten, baut das Team eine Agent-Memory-Funktion auf Plattformebene auf Milvus und seinem Ökosystem auf, sodass interne Teams Speicher- und Wissensbasis-Bausteine sofort einsatzbereit erhalten. Jede dieser Maßnahmen vergrößert das, was auf Milvus läuft, und das Team plant, weiterhin etwas an die Community zurückzugeben.
"Meituan ist genau die Art von technikgetriebenem Unternehmen, das Open Source voranbringt: Sie betreiben Milvus in einer Größenordnung, die die meisten Teams nie erreichen, und sie geben zurück, was sie lernen. Wir sind stolz darauf, dass Milvus das Vektor-Fundament unter Meituans KI-Workloads ist, und wir freuen uns darauf, weiterhin an der Seite ihres Teams und der Community aufzubauen." — James Luan, CTO, Zilliz
Loslegen mit Milvus oder den verwalteten Milvus-Service ausprobieren
Milvus ist die weltweit am häufigsten eingesetzte Open-Source-Vektordatenbank, entwickelt für Ähnlichkeitssuche im Milliarden-Maßstab und vom Laptop bis zum verteilten Cluster lauffähig. Sie bietet Ihnen dieselbe vektornative Engine, die hinter Meituans Plattform steht: eine vollständige Palette an Index-Typen, hybride Vektor-und-Skalar-Suche und eine Architektur mit getrenntem Speicher und Rechenleistung, die skaliert.
Starten Sie mit Milvus auf GitHub, lesen Sie die Dokumentation und treten Sie der Community auf Discord bei.
Wenn Sie dieselbe Engine als vollständig verwalteten Service möchten, mit wartungsfreiem Betrieb und Enterprise-Sicherheit, basiert Zilliz Cloud auf Milvus und ist mit dessen APIs kompatibel.
- Über Meituan
- Die Herausforderung
- Warum Milvus
- Die Lösung
- Ergebnisse & Nutzen
- Wie es weitergeht
- Loslegen mit Milvus oder den verwalteten Milvus\-Service ausprobieren
Inhalte
Branche
Elektronischer Geschäftsverkehr