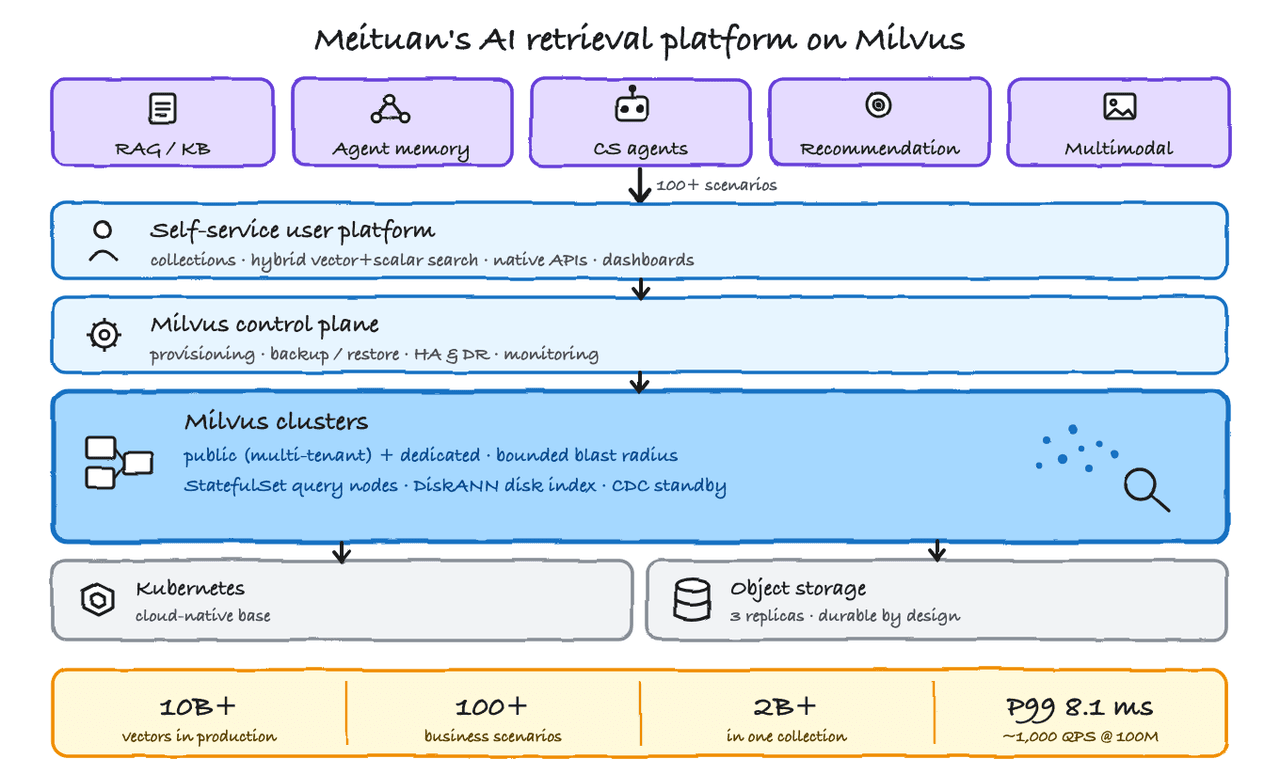
Come Meituan ha costruito una piattaforma di retrieval su scala 10B basata su Milvus per supportare oltre 100 casi d'uso.

10B+ vettori
In produzione, auto-gestito su Milvus
2B+ in un'unica collezione
Il più grande carico di lavoro singolo, cresciuto senza ri-architettura
P99 8.1 ms
~1.000 QPS e >97% di recall su un benchmark di 100 milioni di vettori a 768 dimensioni.
100+ casi d'uso
Su un'unica piattaforma Milvus condivisa: RAG, memoria dell'agente e altro ancora
"Quando Meituan si è impegnata nell'AI, avevamo bisogno di una base di retrieval costruita per i vettori da zero. Abbiamo scelto Milvus open-source e l'abbiamo trasformato in una piattaforma su cui ogni team può costruire. Un anno dopo, contiene più di 10 miliardi di vettori e gestisce i nostri carichi di lavoro AI in più rapida crescita, dalla RAG alla memoria degli agenti."
The Meituan Database Team
Informazioni su Meituan
Meituan è una delle più grandi aziende tecnologiche dell'Asia e gestisce una piattaforma leader on-demand per servizi locali. La sua super-app copre consegna di cibo, ristorazione in loco e recensioni dei consumatori, prenotazione di hotel e viaggi, generi alimentari e vendita al dettaglio immediata — tutto realizzato tramite una vasta rete di commercianti e corrieri locali.
L'IA è diventata centrale nel modo in cui Meituan serve questo mercato, dal rispondere alle domande dei clienti al fornire agli esercenti strumenti più intelligenti. Più di 100 scenari aziendali ora usano RAG, memoria degli agenti e ricerca multimodale, e ognuno necessita di una ricerca vettoriale rapida e filtrata alla base. Il team di database di Meituan gestisce questa infrastruttura dati condivisa su open-source Milvus.
La sfida
Con l'espansione della ricerca vettoriale in tutta Meituan, il team di database ha dovuto supportare un insieme di carichi di lavoro sempre più diversificato. Diverse applicazioni presentavano requisiti differenti per tipi di dati vettoriali, algoritmi di indicizzazione, dimensioni e prestazioni di ricerca, mentre le dimensioni dei dataset variavano da milioni a miliardi di vettori.
Meituan necessitava di un'infrastruttura condivisa in grado di soddisfare questi diversi requisiti su larga scala, bilanciando prestazioni delle query, efficienza delle risorse e costo operativo. All'inizio eseguivano la ricerca vettoriale su Elasticsearch, ma presto non riuscì più a soddisfare i requisiti di prestazioni e costi di Meituan. Elasticsearch limitava i vettori a 4,096 dimensioni, supportava solo un numero limitato di tipi di vettore e non disponeva di indice su disco, quindi ogni vettore doveva risiedere in memoria. Con centinaia di milioni di vettori, ciò rendeva i dataset più grandi e in più rapida crescita di Meituan i più costosi da mantenere online. Il team aveva bisogno di un motore di ricerca vettoriale appositamente progettato, i cui tipi di indice potessero gestire enormi dataset su disco, non solo in RAM.
Perché Milvus
Il team di database ha valutato i principali motori di ricerca vettoriale in termini di capacità, prestazioni ed ecosistema, quindi ha scelto open-source Milvus. Tre ragioni hanno portato a questa decisione.
- Capacità. Milvus offriva l'ampiezza di tipi di dati vettoriali e algoritmi di indicizzazione di cui Meituan aveva bisogno in un insieme di carichi di lavoro molto vario, inclusi indici su disco per collezioni molto grandi. La sua architettura a separazione storage-compute ha inoltre offerto al team maggiore flessibilità per scalare in modo efficiente carichi di lavoro vettoriali di grandi dimensioni.
- Prestazioni. Nel benchmark interno del team su 100 milioni di vettori 768-dimensionali con un indice HNSW, Milvus ha mantenuto una latenza P99 a 8.1 ms e circa 1,000 QPS, con recall superiore al 97%.
- Ecosistema. Milvus si integrava inoltre naturalmente nello stack IA open-source più ampio di Meituan. Offriva SDK maturi, documentazione e una community attiva (46k+ stelle su GitHub), mentre alcuni dei framework open-source adottati dai team interni supportavano già direttamente Milvus. Ciò ha ridotto l'attrito di integrazione e ha reso più semplice portare nuovi scenari di ricerca vettoriale sulla piattaforma.
La soluzione
Dopo aver valutato i principali motori di ricerca vettoriale, Meituan ha scelto Milvus come base vector-native per i suoi carichi di lavoro IA in crescita, mentre la sua implementazione Elasticsearch esistente è rimasta parte della più ampia architettura dual-engine. Questi casi d'uso vettoriali spaziano da RAG e basi di conoscenza, memoria degli agenti, agenti per l'assistenza clienti e la diagnosi, raccomandazione e ricerca multimodale. La maggior parte ha una struttura simile: da pochi milioni a decine di milioni di vettori, da 768 a 1,536 dimensioni, serviti a ~100 query al secondo. Alcuni sono molto più grandi, come il carico di lavoro che ha superato i due miliardi di vettori.
Invece di far gestire a ogni team il proprio Milvus, il team database ha concentrato tutto su una piattaforma condivisa che offre a qualsiasi team un cluster pronto per la produzione senza trasformarli in esperti di database vettoriali. Servire workload così eterogenei da un'unica piattaforma si è ridotto a quattro punti: contenere miliardi di vettori a basso costo, mantenere i tenant isolati così che uno non possa trascinare giù gli altri, restare affidabili per i workload business-critical e offrire abbastanza self-service che un piccolo team possa supportare tutti.
Mantenere miliardi di vettori a basso costo con gli indici su disco
Il vantaggio economico deriva dagli indici su disco di Milvus. Con DiskANN, una grande collection vive prevalentemente su disco invece che in memoria, il che mantiene conveniente anche un workload da due miliardi di vettori. Sull'hardware di Meituan, questi indici richiedevano più disco locale di quanto una distribuzione standard assegni a un query node, così il team ha montato volumi dedicati e ha eseguito l'operator di Milvus come StatefulSets, in modo che ogni nodo conservi il proprio disco attraverso i riavvii. Poiché l'operator è open source, è stata una modifica semplice da implementare, ed è per questo che Meituan può fare così tanto affidamento sugli indici su disco.
Isolamento tra molti tenant: cluster pubblici e dedicati con un raggio di esplosione limitato
Milvus consente a molti tenant di condividere un unico cluster, ciascuno nel proprio database, così Meituan raggruppa la coda lunga dei workload piccoli su cluster pubblici, mantenendo alto il tasso di utilizzo. I workload più grandi ottengono i propri cluster dedicati: tutto ciò che supera un milione di vettori, tutto ciò che richiede QPS elevati, tutto ciò che è business-critical, o tutto ciò che richiede una propria ottimizzazione. L'unico rischio della condivisione è il raggio di esplosione: un tenant che si comporta male trascina giù i vicini. Per questo Meituan limita il numero di tenant su un cluster pubblico e valuta il compito, l'importanza e i dati di ogni nuovo workload prima di collocarlo.
Affidabilità per i workload critici: failover rapido, poi standby con CDC
Poiché Milvus separa lo storage dal compute, i dati stessi sono già al sicuro (risiedono in object storage con tre copie), quindi il lavoro sull'affidabilità di Meituan consiste essenzialmente nel mantenere il servizio raggiungibile. I client raggiungono Milvus attraverso i suoi nodi proxy, e quando un proxy muore, il traffico deve spostarsi rapidamente. Meituan ha integrato il failover nei propri SDK Milvus, in Python e Java: il control plane tiene traccia di quali proxy sono sani e passa questa lista all'SDK, così i client vanno direttamente a un proxy attivo, e un proxy guasto viene rimosso prima di essere spento. Questo consente loro di evitare sia di eseguire un load balancer davanti a ogni cluster, sia l'overhead che ne deriva.
Per il disaster recovery, Meituan distribuisce i nodi di un cluster tra i data center, prima i proxy e i coordinator, poi il middleware, con l'obiettivo che ogni componente sia bilanciato tra le availability zone e abbia una riserva (N+1). Per i workload che davvero non possono andare giù, usano la CDC di Milvus per mantenere sincronizzato un cluster di standby, pronto a subentrare se il primario fallisce completamente.
Self-service, così un piccolo team serve tutti
La piattaforma di Meituan affida il controllo quotidiano ai team che possiedono i workload: gestione visuale delle Collection (creazione, eliminazione, caricamento, rilascio), accesso con un clic alle API native di Milvus, ricerca ibrida vettori+scalari, dashboard di monitoraggio e controllo degli accessi a livello di database. I backup vengono eseguiti automaticamente a granularità di database, e i canali di sincronizzazione dei dati spostano i vettori da fonti come Hive e RDS, o verso l'esterno per il disaster recovery. Poiché il lavoro di routine passa agli utenti, il carico di reperibilità rimane basso, e un piccolo team di piattaforma mantiene in salute l'intera flotta.
Risultati e vantaggi
10B+ vettori in produzione, partendo da zero in circa un anno. Una piattaforma standardizzata ora esegue Milvus su larga scala per oltre 100 casi d'uso, con distribuzione automatizzata dei cluster, backup e self-service che mantengono piccolo il team operativo.
Scala miliardaria in un singolo carico di lavoro, con margine di riserva. Il più grande carico di lavoro singolo è cresciuto oltre i 2 miliardi di vettori senza richiedere una riarchitettura.
P99 di 8,1 ms a ~1.000 QPS, recall >97% sul benchmark del team da 100 milioni di vettori e 768 dimensioni, con un margine di riserva ben maggiore di quello richiesto dai suoi carichi di lavoro, per lo più sotto i 100 QPS.
I carichi di lavoro IA in più rapida crescita dell'azienda girano qui. RAG e la memoria degli agenti guidano la crescita, quindi Meituan costruisce un'infrastruttura di retrieval condivisa invece di lasciare che ciascun team ne crei una propria.
Le collezioni su scala miliardaria restano convenienti. Mantenere la maggior parte di una collezione su disco invece che in RAM rende conveniente eseguire un carico di lavoro da due miliardi di vettori e, poiché Milvus è open source, il team continua a ridurre ulteriormente i costi con il proprio indice su disco.
Il vantaggio strategico: il retrieval vettoriale non è più qualcosa che ogni team di Meituan risolve da solo. È una piattaforma standardizzata e affidabile, che dà ai team IA che vi si appoggiano la libertà di costruire prodotti invece di infrastrutture.
Prossimi passi
Meituan sta approfondendo il suo investimento in Milvus su tre fronti. I nuovi cluster ora adottano Milvus 2.6 come impostazione predefinita e il team sta migrando i carichi di lavoro esistenti man mano che adotta funzionalità come le funzioni di embedding integrate. Sul fronte del kernel, sta sviluppando un indice su disco autoprodotto e basato sulla quantizzazione su Milvus 2.6 per spingere ulteriormente l'efficienza dei costi su scala miliardaria. E mentre gli agenti si diffondono in tutta l'azienda, il team sta costruendo una capacità di memoria per agenti a livello di piattaforma su Milvus e sul suo ecosistema, così i team interni dispongono di componenti pronti all'uso per memoria e knowledge base. Ciascuno di questi fronti accresce ciò che gira su Milvus, e il team ha in programma di continuare a contribuire alla community man mano che avanza.
"Meituan è esattamente il tipo di azienda guidata dall'ingegneria che fa progredire l'open source: eseguono Milvus a una scala che la maggior parte dei team non raggiunge mai e restituiscono ciò che imparano. Siamo orgogliosi che Milvus sia la base vettoriale sotto i carichi di lavoro IA di Meituan, e siamo entusiasti di continuare a costruire insieme al loro team e alla community." — James Luan, CTO, Zilliz
Inizia con Milvus o prova il servizio Managed Milvus
Milvus è il database vettoriale open source più adottato al mondo, progettato per la ricerca di similarità su scala miliardaria e in grado di funzionare da un laptop a un cluster distribuito. Offre lo stesso motore nativo vettoriale alla base della piattaforma di Meituan: una gamma completa di tipi di indice, ricerca ibrida vettoriale e scalare e un'architettura che separa storage e calcolo e che scala.
Inizia con Milvus su GitHub, leggi la documentazione e unisciti alla community su Discord.
Quando desideri lo stesso motore come servizio completamente gestito, con operazioni a manutenzione zero e sicurezza di livello enterprise, Zilliz Cloud è basato su Milvus e compatibile con le sue API.