Cómo Meituan construyó una plataforma de recuperación a escala de 10B sobre Milvus para impulsar más de 100 casos de uso.

10B+ vectores
En producción, autoalojado en Milvus
2B+ en una colección
La mayor carga de trabajo individual, que ha crecido sin rediseñar su arquitectura.
P99 8.1 ms
~1,000 QPS y >97% de recall en un benchmark de 100M vectores y 768 dimensiones
100+ casos de uso
En una plataforma compartida de Milvus: RAG, memoria del agente y más
"Cuando Meituan se comprometió con la IA, necesitábamos una base de recuperación construida para vectores desde cero. Elegimos Milvus de código abierto y lo convertimos en una plataforma sobre la que cualquier equipo puede construir. Un año después, alberga más de 10 mil millones de vectores y ejecuta nuestras cargas de trabajo de IA de más rápido crecimiento, desde RAG hasta la memoria de agentes."
The Meituan Database Team
Acerca de Meituan
Meituan es una de las empresas tecnológicas más grandes de Asia y opera una plataforma líder bajo demanda para servicios locales. Su superapp abarca entrega de comida, cenas en restaurantes y reseñas de consumidores, reservas de hoteles y viajes, comestibles y venta minorista instantánea, todo ello realizado a través de una vasta red de comerciantes y repartidores locales.
La IA se ha vuelto central en la forma en que Meituan atiende ese mercado, desde responder preguntas de los clientes hasta ofrecer a los comerciantes herramientas más inteligentes. Más de 100 escenarios de negocio utilizan ahora RAG, memoria de agentes y búsqueda multimodal, y cada uno necesita una búsqueda vectorial rápida y filtrada subyacente. El equipo de bases de datos de Meituan gestiona esa infraestructura de datos compartida sobre Milvus de código abierto.
El desafío
A medida que la recuperación vectorial se expandió en Meituan, el equipo de bases de datos tuvo que soportar un conjunto de cargas de trabajo cada vez más diverso. Diferentes aplicaciones trajeron requisitos diferentes en cuanto a tipos de datos vectoriales, algoritmos de indexación, dimensiones y rendimiento de recuperación, mientras que los tamaños de los conjuntos de datos iban desde millones hasta miles de millones de vectores.
Meituan necesitaba una infraestructura compartida que pudiera cumplir estos diferentes requisitos a escala, equilibrando el rendimiento de las consultas, la eficiencia de los recursos y el costo operativo. Inicialmente, ejecutaron la búsqueda vectorial en Elasticsearch, pero pronto no pudo cumplir con los requisitos de rendimiento y costo de Meituan. Elasticsearch limitaba los vectores a 4096 dimensiones, soportaba solo un puñado de tipos de vectores y no tenía índice en disco, por lo que todos los vectores tenían que estar en memoria. Con cientos de millones de vectores, eso convertía a los conjuntos de datos más grandes y de más rápido crecimiento de Meituan en los más costosos de mantener en línea. El equipo necesitaba un motor de búsqueda vectorial diseñado específicamente cuyos tipos de índice pudieran contener conjuntos de datos enormes en disco, no solo en RAM.
Por qué Milvus
El equipo de bases de datos evaluó los principales motores de búsqueda vectorial según capacidad, rendimiento y ecosistema, y luego eligió Milvus de código abierto. Tres razones llevaron a esa decisión.
Capacidad. Milvus proporcionaba la amplitud de tipos de datos vectoriales y algoritmos de indexación que Meituan necesitaba en un conjunto muy variado de cargas de trabajo, incluidos índices basados en disco para colecciones muy grandes. Su arquitectura de almacenamiento y cómputo separados también dio al equipo más flexibilidad para escalar eficientemente cargas de trabajo vectoriales grandes.
Rendimiento. En el propio benchmark del equipo con 100 millones de vectores de 768 dimensiones en un índice HNSW, Milvus mantuvo una latencia P99 de 8.1 ms y alrededor de 1000 QPS, con una recuperación superior al 97%.
Ecosistema. Milvus también encajaba naturalmente en el stack de IA de código abierto más amplio de Meituan. Ofrecía SDKs maduros, documentación y una comunidad activa (46k+ estrellas de GitHub), mientras que algunos de los frameworks de código abierto adoptados por equipos internos ya soportaban Milvus directamente. Eso redujo la fricción de integración y facilitó la incorporación de nuevos escenarios de búsqueda vectorial a la plataforma.
La solución
Después de evaluar los principales motores de búsqueda vectorial, Meituan eligió Milvus como la base vectorial nativa para sus crecientes cargas de trabajo de IA, mientras que su despliegue existente de Elasticsearch permaneció como parte de la arquitectura más amplia de doble motor. Estos casos de uso vectorial abarcan RAG y bases de conocimiento, memoria de agentes, agentes de atención al cliente y diagnóstico, recomendación y búsqueda multimodal. La mayoría comparte una forma similar: desde unos pocos millones hasta decenas de millones de vectores, de 768 a 1536 dimensiones, atendidos a ~100 consultas por segundo. Unos pocos son mucho más grandes, como la carga de trabajo que ha superado los dos mil millones de vectores.
En lugar de que cada equipo ejecute su propio Milvus, el equipo de bases de datos lo puso todo en una plataforma compartida que brinda a cualquier equipo un clúster listo para producción sin convertirlos en expertos en bases de datos vectoriales. Atender cargas de trabajo tan variadas desde una sola plataforma se resumió en cuatro cosas: almacenar miles de millones de vectores de forma económica, mantener aislados a los inquilinos para que uno no pueda afectar a otro, mantener la fiabilidad para cargas de trabajo críticas para el negocio y ofrecer suficiente autoservicio para que un equipo pequeño pueda dar soporte a todos.
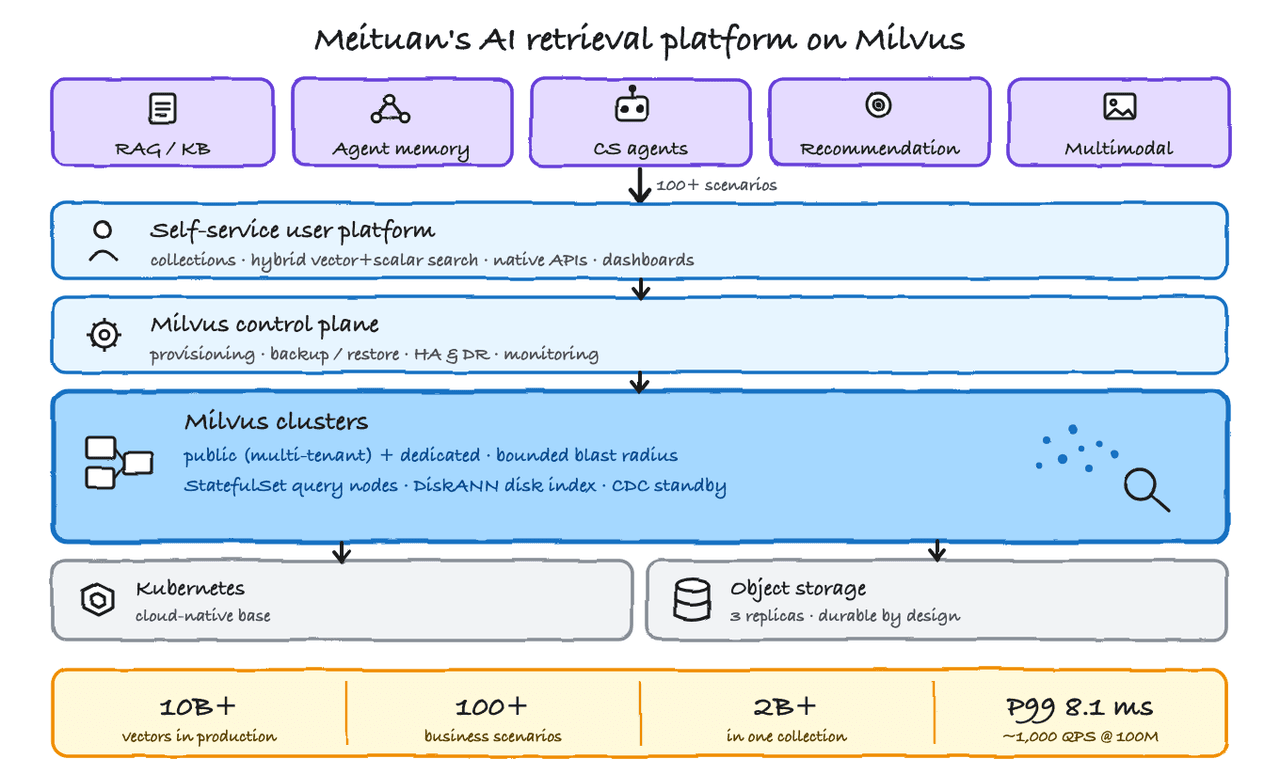 Plataforma de recuperación de IA de Meituan en Milvus.PNG
Almacenar miles de millones de vectores de forma económica, con índices de disco
La ventaja en costos proviene de los índices de disco de Milvus. Con DiskANN, una gran colección reside principalmente en disco en lugar de en memoria, lo que mantiene asequible incluso una carga de trabajo de dos mil millones de vectores. En el hardware de Meituan, esos índices necesitaban más disco local del que una implementación estándar le da a un nodo de consulta, por lo que el equipo montó volúmenes dedicados y ejecutó el operador de Milvus como StatefulSets, de modo que cada nodo conserva su propio disco a través de reinicios. Debido a que el operador es de código abierto, ese fue un cambio simple de hacer, y es por eso que Meituan puede apoyarse en los índices de disco tanto como lo hace.
Aislamiento entre muchos inquilinos: clústeres públicos y dedicados con un radio de explosión limitado
Milvus permite que muchos inquilinos compartan un clúster, cada uno en su propia base de datos, por lo que Meituan agrupa la larga cola de cargas de trabajo pequeñas en clústeres públicos y mantiene una alta utilización. Las cargas de trabajo más grandes obtienen sus propios clústeres dedicados: cualquier cosa que supere un millón de vectores, cualquier cosa que necesite un QPS alto, cualquier cosa crítica para el negocio, o cualquier cosa que necesite su propio ajuste.
El único riesgo con compartir es el radio de explosión: un inquilino con mal comportamiento que arrastra a sus vecinos, por lo que Meituan limita cuántos inquilinos van en un clúster público y evalúa el trabajo, la importancia y los datos de cada nueva carga de trabajo antes de colocarla.
Fiabilidad para cargas de trabajo críticas: conmutación por error rápida, luego un respaldo con CDC
Debido a que Milvus separa el almacenamiento del cómputo, los datos en sí ya están seguros (residen en el almacenamiento de objetos con tres copias), por lo que el trabajo de fiabilidad de Meituan realmente consiste en mantener el servicio accesible. Los clientes acceden a Milvus a través de sus nodos proxy, y cuando un proxy muere, el tráfico debe moverse rápido. Meituan incorporó la conmutación por error en sus propios SDK de Milvus, en Python y Java: el plano de control rastrea qué proxies están sanos y alimenta esa lista al SDK, por lo que los clientes van directamente a un proxy en vivo, y uno que falla se elimina antes de que se apague. Eso les permite omitir la ejecución de un balanceador de carga frente a cada clúster, y la sobrecarga que conlleva.
Para la recuperación ante desastres, Meituan distribuye los nodos de un clúster entre centros de datos, primero los proxies y coordinadores, luego el middleware, con el objetivo de que cada componente esté equilibrado entre zonas de disponibilidad más un repuesto (N+1). Para las cargas de trabajo que realmente no pueden caerse, utilizan el CDC de Milvus para mantener un clúster en espera sincronizado, listo para asumir el control si el primario falla por completo.
Autoservicio, para que un pequeño equipo atienda a todos
La plataforma de Meituan entrega el control del día a día a los equipos que poseen las cargas de trabajo: gestión visual de Colecciones (crear, eliminar, cargar, liberar), acceso con un clic a las API nativas de Milvus, búsqueda híbrida de vectores y escalares, paneles de monitoreo y control de acceso a nivel de base de datos. Las copias de seguridad se ejecutan automáticamente a nivel de base de datos, y los canales de sincronización de datos mueven vectores desde fuentes como Hive y RDS, o hacia afuera para la recuperación ante desastres. Debido a que el trabajo rutinario se traslada a los usuarios, la carga de guardia se mantiene baja y un pequeño equipo de plataforma mantiene toda la flota saludable.
Resultados & Beneficios
10B+ vectores en producción, desde cero en aproximadamente un año. Una plataforma estandarizada ahora ejecuta Milvus a gran escala para 100+ casos de uso, con entrega automatizada de clústeres, copias de seguridad y autoservicio que mantienen al equipo operativo pequeño.
Escala de miles de millones en una sola carga de trabajo, con margen. La mayor carga de trabajo individual ha superado los 2 mil millones de vectores sin necesidad de rediseñar la arquitectura.
P99 8.1 ms a ~1,000 QPS, recall >97% en el benchmark del equipo de 100M de vectores y 768 dimensiones, con mucho más margen del que necesitan sus cargas de trabajo, en su mayoría por debajo de 100 QPS.
Las cargas de trabajo de IA de más rápido crecimiento de la empresa se ejecutan aquí. RAG y la memoria de agentes impulsan el crecimiento, por lo que Meituan construye una infraestructura de recuperación compartida en lugar de que cada equipo levante la suya propia.
Las colecciones a escala de miles de millones siguen siendo asequibles. Mantener la mayor parte de una colección en disco en lugar de en RAM hace que una carga de trabajo de dos mil millones de vectores sea asequible de ejecutar, y como Milvus es de código abierto, el equipo sigue reduciendo aún más los costos con su propio índice en disco.
El beneficio estratégico: la recuperación de vectores ya no es algo que cada equipo de Meituan resuelva por separado. Es una plataforma estandarizada y confiable, lo que libera a los equipos de IA que trabajan sobre ella para crear productos en lugar de infraestructura.
Qué sigue
Meituan está profundizando su inversión en Milvus en tres frentes. Los nuevos clústeres ahora usan Milvus 2.6 por defecto, y el equipo está migrando las cargas de trabajo existentes a medida que adoptan funciones como las de incrustación integradas. En el lado del kernel, está desarrollando un índice en disco propio, basado en cuantización, sobre Milvus 2.6 para llevar la eficiencia de costos aún más lejos a escala de miles de millones. Y a medida que los agentes se extienden por toda la empresa, el equipo está construyendo una capacidad de memoria de agentes a nivel de plataforma sobre Milvus y su ecosistema, para que los equipos internos obtengan bloques de construcción de memoria y base de conocimiento listos para usar. Cada una de estas iniciativas hace crecer lo que se ejecuta en Milvus, y el equipo planea seguir contribuyendo a la comunidad a medida que avanza.
"Meituan es exactamente el tipo de empresa impulsada por la ingeniería que hace avanzar el código abierto: ejecutan Milvus a una escala que la mayoría de los equipos nunca alcanza, y devuelven lo que aprenden. Estamos orgullosos de que Milvus sea la base vectorial que sustenta las cargas de trabajo de IA de Meituan, y nos entusiasma seguir construyendo junto a su equipo y la comunidad." — James Luan, CTO, Zilliz
Empieza con Milvus o prueba el servicio administrado de Milvus
Milvus es la base de datos vectorial de código abierto más adoptada del mundo, diseñada para la búsqueda de similitud a escala de miles de millones y que se ejecuta desde una laptop hasta un clúster distribuido. Te da el mismo motor nativo de vectores que está detrás de la plataforma de Meituan: una gama completa de tipos de índice, búsqueda híbrida de vectores y escalares, y una arquitectura de almacenamiento y cómputo separados que escala.
Empieza con Milvus en GitHub, lee la documentación y únete a la comunidad en Discord.
Cuando quieras el mismo motor como un servicio totalmente administrado, con operaciones de cero mantenimiento y seguridad empresarial, Zilliz Cloud está construido sobre Milvus y es compatible con sus APIs.