




MemGPTの紹介とMilvusとの統合
5月に開催した非構造化データミートアップでは、カリフォルニア大学バークレー校の博士課程に在籍し、MemoryGPT(MemGPT)の共同設立者であるCharles Packer に参加していただきました。Charlesは、現在の大規模言語モデル(LLMsの根本的なボトルネックであるメモリの制限について強調し、OSの設計からヒントを得ることでこの問題を解決することを目的としたMemGPTについて説明しました。
このブログでは、講演で議論された主要なコンセプトを取り上げ、MemGPTが導入した「仮想拡張メモリ」について説明します。しかし、知識を直接吸収したい方は、YouTubeで講演全体を再確認することができます。
現在のLLMにおける限られたメモリー
チャールズは講演の冒頭で、LLMの文脈としての記憶を紹介し、その重要性を強調した:「LLMにとって、記憶がすべてだ。LLMのコンテキスト・ウィンドウは、会話中にどれだけの情報を保持できるかを定義する。この記憶能力により、言語モデルは以前のクエリから情報を呼び出すことができ、様々なチャットボットアプリケーションを開発するための強力なツールとなる。
しかし、ほとんどの主流のLLMでは、コンテキストウィンドウはかなり限られている。例えば、GPT4では32kトークン、GPT4-Turboでは128kです。メモリが限られているということは、これらのチャットボット・アプリケーションは、一定のクエリー回数が過ぎると古い会話を忘れてしまう傾向があるということであり、これは残念なユーザー・エクスペリエンスにつながる可能性がある。チャールズは、この問題をLLMアプリケーションの大きなボトルネックとして強調し、さらに、LLMはアシスタントというより検索エンジンに成り下がっていると述べた。
検索エンジン、LLM、AIアシスタントの関係](https://assets.zilliz.com/The_relations_between_search_engines_LL_Ms_and_AI_assistants_3d45844c4a.png)
記憶問題に対する最も近い解決策は、検索拡張世代(RAG)とGeminiのようなロングコンテクストLLMである。しかし、これらはある程度の改善をもたらすものの、RAGは真の記憶ではないし、ロングコンテクストLLMは計算コストを何倍にも増大させる。さらに、DevinAIのようなロングコンテキストモデルの劣悪な性能は、限られたコンテキストが問題なのではなく、トークンの誤操作によるコンテキスト汚染が問題であることを証明している。
MemGPT:検索エンジンからアシスタントへ
MemGPTは、コンピュータシステムで実装されているメモリのページネーションにヒントを得て、仮想的に拡張されたコンテキストウィンドウを導入している。コンピュータでは、主要な情報は高速アクセスのためにメモリ(RAM)に保存されますが、RAMがいっぱいになると、残りのデータは永続記憶装置(ROM)に保存されます。オペレーティング・システム(OS)は、アクセスする内容に応じてRAMとROMの間で情報を入れ替える。
MemGPTは、拡張メモリシステムを作成することで、同じコンセプトに従っている。LLMコンテキストを2つの部分に分割します。
メイン・コンテキスト:***これはLLMのコンテキスト・ウィンドウです。限られた帯域幅を持ち、すぐにアクセスできる最も関連性の高い情報を保存します。
外部コンテキスト:*** 外部コンテキストは永続記憶装置(ROM)上に作成され、無限のウィンドウを持つ。会話が続き、メインのコンテキストがいっぱいになると、重要なアイデアや情報が保存される。
MemGPTは2つのコンテキスト間の情報の流れを管理します。MemGPTは、現在のコンテキストに基づいて動的にメモリを更新し、メインと外部メモリストア間の情報を効率的にスワップします。この制御と効率性がシステムの性能の鍵となる。
このアプローチにより、MemGPTは長いコンテキストのメモリを必要とするアプリケーションにおいて重要なコンポーネントとなる。例えば、重要なユーザー生活の詳細を保持する必要があるパーソナルアシスタントチャットボットは、大きな恩恵を受けることができます。個人的な関係や仕事の詳細は外部コンテキストに保存され、進行中の会話の必要に応じて取り出される。このアプローチは、ユーザーに真に「パーソナル」な体験を提供し、システムの関連性と有用性を高める。
MemGPTの構造
チャールズ氏は、MemGPTのアーキテクチャ設計と標準的なLLMとの主な違いを説明した。第一に、コンテキスト処理の違いである。次に、入力と出力の処理方法だ。入出力はJSONとして構造化され、プレーンテキストではなく、イベントや関数呼び出しとして扱われる。
標準LLMセットアップ](https://assets.zilliz.com/Standard_LLM_Setup_d8cd9843ae.png)
MemGPTの仕組み](https://assets.zilliz.com/How_Mem_GPT_works_6293e7446f.jpeg)
MemGPTは、ドキュメント、ユーザークエリ、システムアラートを入力として受け付け、LLMのイベントをトリガーします。イベントは解析されてLLMに転送され、LLMは拡張コンテキストを利用して要件を処理し、関数呼び出しのようなアクションを実行します。このアーキテクチャ設計により、特定のタスクを実行するように訓練されたエージェントのように動作することができる。たとえば、電子メールを受信するとイベントがトリガーされ、LLMは電子メールを解析して重要な詳細を抽出して強調表示します。
サービスとしてのMemGPT
チャールズ氏はセッションの最後に、MemGPTをプライベートサーバーにデプロイして長期的に使用する方法を説明した。すべてのインタラクションやクエリはステートフルなデータベースに保存され、システムを閉じた後でもアクセスできる。
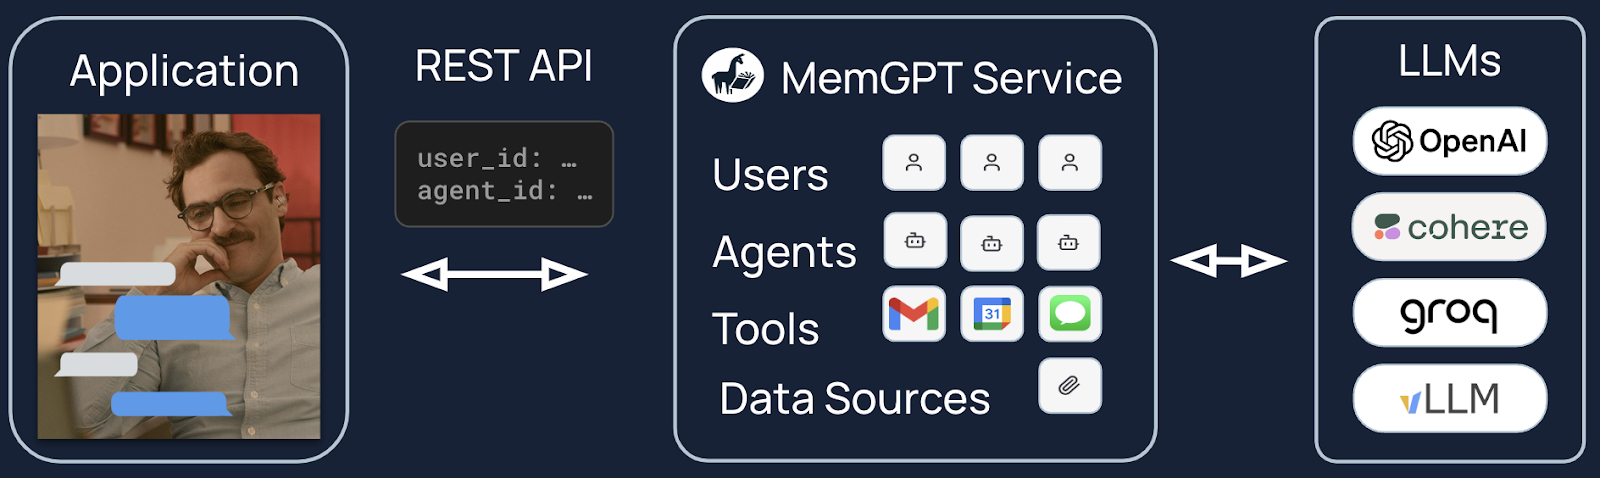
MemGPTエージェントはサーバー上に存在するため、RESTアプリケーションプログラミングインターフェース(API)を介してアクセスされます。エージェントはインターネット経由でどこからでもアクセスできるため、商用アプリケーションとの統合が容易です。
MemGPT と Milvus ベクターデータベースの統合
Milvusは、10億スケールのベクターの保存と検索のためのオープンソースのベクターデータベースです。また、検索拡張世代(RAG)アプリケーションを構築するための最も重要な技術の1つでもあります。
MilvusはMemGPTと統合されており、開発者は外部データソースに接続したAIエージェントを簡単に構築できる。
以下の例では、Milvusに保存されたカスタムデータソースとチャットするためにMemGPTを使用します。
構成
必要な依存関係をインストールします。
pip install 'pymemgpt[milvus]'
以下のコマンドでMilvusの接続設定を行う:
memgpt configure
    ...
    ?アーカイブデータのストレージバックエンドを選択: milvus
    ?Milvus接続URIを入力します(デフォルト:~/.memgpt/milvus.db):~/.memgpt/milvus.db
URIにローカルのファイルパス、例えば~/.memgpt/milvus.dbを設定するだけで、クイックプロトタイピング用のMilvusの軽量版であるMilvus Liteを通じてローカルのMilvusサービスインスタンスが自動的に呼び出されます。
重要: 100万ドキュメントを超えるような大量のデータをお持ちの場合は、DockerまたはKubernetes上でよりパフォーマンスの高いMilvusサーバを構築することをお勧めします。その場合、URIはサーバURI、例えば <http://localhost:19530> を指定してください。
外部データソースの作成
このステップでは、外部データをMemGPTチャットボットに入力するためのデータソースを作成する必要があります。ここでは、MemGPTの研究論文をデータソースの例として使用します。
この論文をダウンロードするには、curlコマンドを使用します。ブラウザからPDFをダウンロードすることもできます。
curl -L -o memgpt_research_paper.pdf https://arxiv.org/pdf/2310.08560.pdf
これで論文をダウンロードした。次に、memgpt loadを使用してMemGPTデータソースを作成しなければならない:
memgpt load directory --name memgpt_research_paper --input-files=memgpt_research_paper.pdf
    ファイルを読み込んでいます:100%|""""""""| 1/1 [00:00<00:00, 3.94file/s].
    memgpt_research_paper から 74 個の文章と 13 個の文書を読み込んだ。
データソースをMemGPTエージェントにアタッチする
これでデータソースが作成できました。いつでもMemGPTチャボにアタッチできます。
memgpt_doc`ペルソナを使用して新しいチャットボットを作成してみましょう(ペルソナは何でもかまいません):
memgpt run --persona memgpt_doc
エージェントとチャットするとき、データソースをエージェントのアーカイブメモリに "アタッチ "することができる:
    ?既存のエージェントを選択しますか?いいえ


    🧬 新しいエージェントの作成...
    -> 🤖 ペルソナのプロファイルを使用しています:'sam_pov'
    -> 🧑 ヒューマンプロファイルを使用しています:'basic'
    🎉 新しいエージェント 'PoliteButterfly' を作成 (id=d26e1981-ff36-4095-97a0-61a1601dfb5d)


    エンターキーを押して開始する(最初のMemGPTメッセージを要求する)


    💭 面白いですね、初めてのユーザーです。自分をアピールして、ユーザーのニーズを理解する時間だ。今日はチャドに何をしに来たんだろう。
    🤖 はじめまして、チャド!私はMemGPTです。本日はどのようなご用件でしょうか?


    > メッセージを入力してください:/attach
    ?データソースを選択 memgpt_research_paper
    100%|"""""""""""| 1/1 [00:00<00:00, 4.81it/s].
新しいチャットボットをテスト中
データをチャットボットのメモリにロードしました。さあ、質問を始めましょう。
    > メッセージを入力してください:私があなたのアーカイブメモリーにロードした紙はMemGPTと呼ばれています。それについて詳しく教えてください。


    💭 チャドは、私のアーカイバル・メモリーに保存されている「MemGPT」というタイトルの論文についてもっと知りたがっているようだ。その論文を包括的に理解するために、詳細と背景データをアーカイバル・メモリーで検索する時が来た。
    その論文を包括的に理解するために。チャドの問い合わせに答えるのに十分な情報が集まるまで、結果をページ送りするのを忘れないようにしよう。
    ⚡ [機能] archival_memory_searchでメモリを検索する
    💭 発見された結果に基づいて、MemGPTは拡張会話や文書分析のようなタスクのために設計されたAIシステムです。LLMの限られた容量内で拡張コンテキストを提供するために、異なる層のストレージを効率的に管理する。
    LLMの限られた容量内で拡張コンテキストを提供する。また、MemGPTは、ディープ・メモリー・リトリーバル(DMR)やドキュメントのQAタスクで素晴らしいパフォーマンスを発揮している。チャドのために包括的な回答を用意しよう。
    確かに、チャド。MemGPT(MemoryGPT)は、会話や文書分析のようなタスクのために特別に設計されたシステムです。
    ラージ・ランゲージ・モデル(LLM)。仮想コンテキスト管理と呼ばれる、従来のオペレーティングシステムにおける階層型メモリシステムにヒントを得た技術を使用しています。この手法により、LLM内の拡張コンテキスト
    この技術は、物理メモリとディスク間のページングのように、異なるストレージ階層をインテリジェントに管理することで、LLMの限られたコンテキストウィンドウ内で拡張コンテキストを効果的に提供することを可能にします。注目すべきは、MemGPTが固定コンテキスト・ベースラインよりも優れている点です。
    を凌駕し、大規模なドキュメントを正確に解析することができる。
最終的な感想
Charles Packer氏による短い講演は、MemGPTのコンセプトについて深く掘り下げた素晴らしいものだった。セッションでは、従来のLLMのメモリとコンテキストの制限について議論し、LLMアプリケーションのボトルネックとして提示した。
MemGPTは、ディスクストレージに保存された外部コンテキストを作成することで、拡張仮想メモリの概念を導入している。このコンセプトは、コンピュータOSがRAMとROMの間で情報をスワップすることでメモリを管理する方法にヒントを得ています。MemGPTエージェントは、重要な情報を外部データベースに保存し、現在のコンテキストに基づいて情報にアクセスすることができます。このエージェントは、ロングコンテキストのアプリケーション開発に新たな道を開きます。
MilvusベクトルデータベースとMemGPTを統合することで、外部データソースへの接続を持つAIエージェントの開発を合理化する上で、さらに一歩前進しました。この投稿では、この統合を使用して外部記憶を持つチャットボットを構築する方法を示す例も共有しました。
読み続けて
Zilliz Skills Breakdown: How AI Agents Master Vector Databases
Zilliz's Milvus Skill (pymilvus, 7 files) and Zilliz Cloud Skill (zilliz-cli, 14 modules) bring vector-DB dev and ops into one Claude Code session.
Introducing Customer-Managed Encryption Keys (CMEK) on Zilliz Cloud
We're announcing the general availability of Customer-Managed Encryption Keys (CMEK) on Zilliz Cloud.
AI Agents Are Quietly Transforming E-Commerce — Here’s How
Discover how AI agents transform e-commerce with autonomous decision-making, enhanced product discovery, and vector search capabilities for today's retailers.