




Создание демонстрационного мультимодального рекомендателя товаров с использованием Milvus и Streamlit
Демо Milvus Composed Image Retrieval демонстрирует обратный поиск изображений, а демо Milvus Multimodal RAG использует эту технику для рекомендаций продуктов. Просто загрузите изображение и введите текстовые инструкции — мультимодальная модель эмбеддингов Google MagicLens закодирует и изображение, и текст в единый мультимодальный вектор. Затем этот вектор используется для поиска наиболее похожих товаров Amazon в векторной базе данных Milvus.
🎨🔍 Представляем магию Milvus: поиск по изображениям и умный шопинг!
Вы когда-нибудь хотели находить товары, просто показывая картинку и описывая, что вам нужно? Что ж, теперь это возможно! 🛍️✨
Вот как работают наши классные демо:
📸 Сделайте снимок и введите, что вы ищете
🧙♂️ Наша магия Milvus превращает ваш ввод в специальный «мультимодальный вектор» (звучит круто, правда?)
🕵️♀️ Этот вектор становится супер-сыщиком для поиска в нашей векторной базе данных Milvus
🎉 Вуаля! Он находит товары Amazon, которые соответствуют вашему изображению и описанию
В этом блоге мы покажем, как запустить демо Milvus Multimodal RAG.
Технологии, используемые для мультимодальной системы рекомендаций продуктов
MagicLens от Google DeepMind (MagicLens) — это мультимодальная модель эмбеддингов, использующая архитектуру с двумя энкодерами для обработки текста и изображений на основе либо CLIP (OpenAI 2021), либо CoCa (Google Research 2022). MagicLens поддерживает различные задачи поиска, включая поиск изображение-изображение и текст-изображение, объединяя обученные веса в общем векторном пространстве. Обученная на 36,7 млн триплетов, она может выполнять задачи поиска изображение-изображение, текст-изображение и мультимодального комбинированного поиска текст-изображение, превосходя предыдущие модели при значительно меньшем размере модели.
GPT-4o от OpenAI (GPT-4o) — это генеративная мультимодальная большая языковая модель от OpenAI, которая объединяет текст, изображения и другие типы данных в одной модели, расширяя возможности традиционных языковых моделей. Этот продвинутый ИИ обеспечивает более глубокое понимание и обработку сложной информации, повышая точность и контекстную осведомленность. Он поддерживает различные приложения — от обработки естественного языка до компьютерного зрения.
Milvus — это распределенная векторная база данных с открытым исходным кодом для хранения, индексирования и поиска векторов в рабочих нагрузках генеративного ИИ. Ее способность выполнять гибридный поиск, фильтрацию метаданных, reranking и эффективно обрабатывать триллионы векторов делает Milvus предпочтительным выбором для рабочих нагрузок ИИ и машинного обучения. Milvus можно запускать локально, в кластере или использовать как размещенный сервис в Zilliz Cloud.
Streamlit — это Python-библиотека с открытым исходным кодом, которая упрощает создание и запуск веб-приложений. Она позволяет разработчикам создавать и развертывать панели мониторинга, отчеты по данным и простые интерфейсы машинного обучения с помощью простых Python-скриптов без необходимости глубоких знаний веб-технологий, таких как CSS, или JavaScript-фреймворков, таких как Node.js.
Подготовка данных
Данные в этой демонстрации взяты из набора данных Amazon Reviews 2023. Исходный источник данных включает 54 миллиона пользовательских отзывов о 48 миллионах товаров в 33 категориях, таких как бытовая техника, красота, одежда, спорт, товары для активного отдыха, а также дополнительная категория “Unknown”.
Мы будем использовать только подмножество из 5K товаров из доступных данных, равномерно отбирая их по категориям. Загрузите изображения, запустив download_images.py.
$ python download_images.py
Каждая строка данных о продукте состоит из метаданных товара (таких как название категории и средний рейтинг пользовательских отзывов) и URL-адресов изображений для миниатюры и больших изображений продукта.
Для векторных данных в этой демонстрации используется один вектор эмбеддинга большого изображения на каждый продукт.
Инструкции по настройке MagicLens
Это руководство проведет вас через настройку окружения и загрузку весов модели для MagicLens, мощной системы поиска изображений, разработанной Google DeepMind. Для получения более подробной информации посетите репозиторий MagicLens GitHub.
Настройка окружения
- Создайте conda-окружение:
$ conda create --name magic_lens python=3.9
- Активируйте окружение:
$ conda activate magic_lens
- Клонируйте репозиторий Scenic:
$ git clone https://github.com/google-research/scenic.git
- Перейдите в директорию Scenic:
$ cd scenic
- Установите Scenic:
$ pip install
- Установите зависимости CLIP:
$ pip install -r scenic/projects/baselines/clip/requirements.txt
- Установите Jax:
Если вы используете GPU для обработки, вам может потребоваться установить соответствующую GPU-версию Jax. Следуйте инструкциям на странице документации JAX для подробных шагов.
Вот примеры для конкретных версий CUDA (только Linux):
Установка CUDA 12:
$ pip install --upgrade "jax[cuda12_pip]" -f https://storage.googleapis.com/jax-releases/jax_cuda_releases.html
Установка CUDA 11:
$ pip install --upgrade "jax[cuda11_pip]" -f https://storage.googleapis.com/jax-releases/jax_cuda_releases.html
Загрузите веса модели локально
- Вернитесь в основную папку:
$ cd .. # This will take you back to the main directory where you cloned the demo.
- Загрузите модель (может потребоваться аутентификация):
$ gsutil cp -R gs://gresearch/magiclens/models ./
Создайте коллекцию Milvus и сохраните векторы
Сервер Milvus в этой демонстрации — это Milvus Lite с Milvus Client без схемы.
Создайте коллекцию, закодируйте каждое изображение в векторы и загрузите векторные данные в Milvus, запустив index.py.
$ python index.py
Этот шаг закодирует каждое изображение в 768-мерный вектор. Для каждого продукта в выборке вектор изображения вместе с соответствующими метаданными продукта сохраняется в коллекцию Milvus под названием “cir_demo_large” с AUTOINDEX (HNSW).
Индексация и поиск Milvus
Во время выполнения, когда вы выполняете обратный поиск по изображению и тексту, Milvus будет искать top_k = 100 ближайших векторов изображений, используя COSINE векторное расстояние.
Milvus автоматически сортирует top_k в порядке убывания (поскольку большие значения расстояния COSINE означают, что они ближе).
Запустите фронтенд сервера Streamlit
Обновите локальный файл
cfg.py, заменив имена путей вашими локальными путями к изображениям и весам модели.Запустите приложение из терминала:
$ streamlit run ui.py
- Использование приложения:
Загрузите изображение, чтобы направить поиск продуктов.
Введите текстовую инструкцию, чтобы направить поиск.
Нажмите "Search", чтобы найти похожие товары в векторной базе данных Milvus.
Нажмите "Ask GPT", чтобы получить рекомендации на основе ИИ.
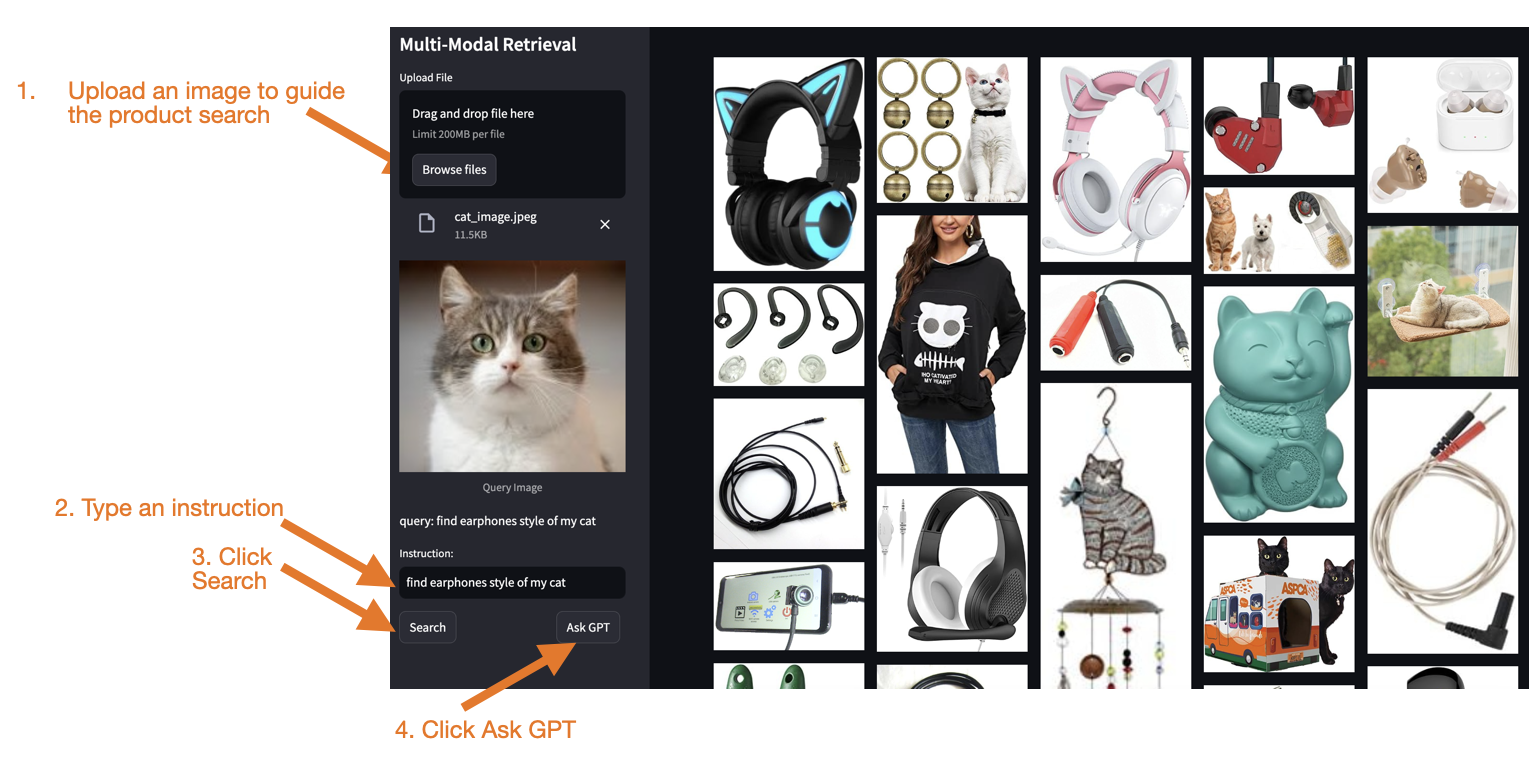 Figure 1- Интерфейс нашего демо-приложения
Рисунок 1: Интерфейс нашего демо-приложения
Как работает это приложение:
Функция Search преобразует ваше изображение и текст в вектор с помощью мультимодальной модели эмбеддингов MagicLens — той же модели, которая используется для преобразования в эмбеддинги изображений товаров, хранящихся в векторной базе данных Milvus. Затем Milvus выполнит векторный поиск Approximate Nearest Neighbor (ANN), чтобы найти ближайшие top_k изображений товаров к вашему входному вектору.
Функция Ask GPT вызовет мультимодальную генеративную модель OpenAI GPT-4o mini. Она возьмет первые 25 изображений из результатов поиска, поместит их в промпт и отправит модели. Затем GPT-4o mini выберет лучшее изображение и объяснит причину своего выбора.
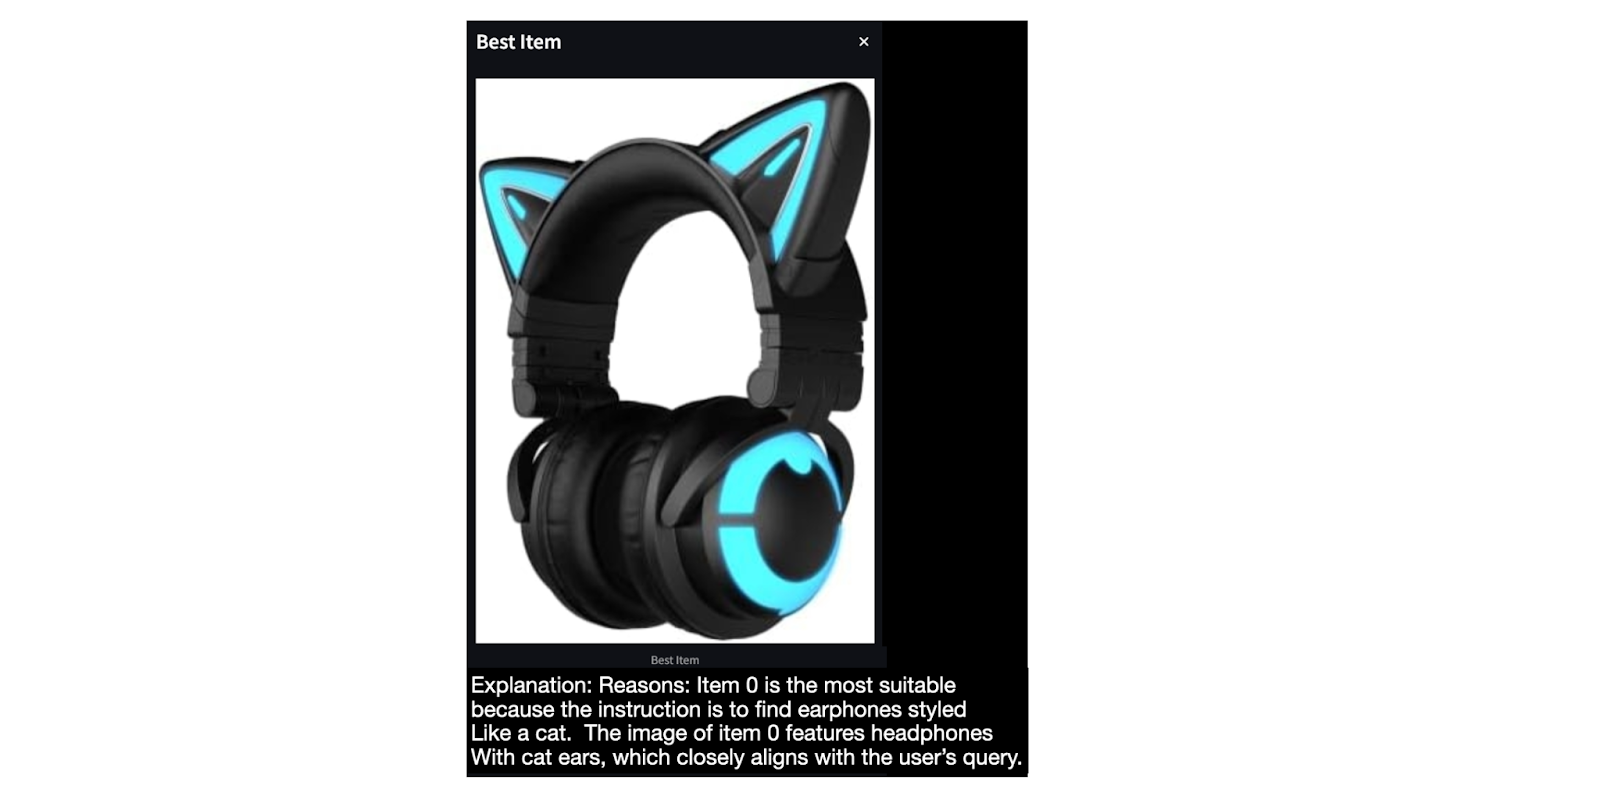 Figure 2- Ответы, предоставленные GPT-4o mini
Рисунок 2: Ответы, предоставленные GPT-4o mini
Ссылки
Multimodal Image Retrieval на bootcamp: https://github.com/milvus-io/bootcamp/tree/master/bootcamp/tutorials/quickstart/apps/cir_with_milvus
Multimodal RAG with Re-ranking Recommendations на bootcamp: https://github.com/milvus-io/bootcamp/tree/master/bootcamp/tutorials/quickstart/apps/multimodal_rag_with_milvus
Модель Google MagicLens: https://github.com/google-deepmind/magiclens
Видео о теории, лежащей в основе этой демонстрации: https://youtu.be/uaqlXRCvjG4?si=e83DnUsLZvVnWt-0&t=51
 Christy Bergman
 is a passionate Developer Advocate at Zilliz. She previously worked in distributed computing at Anyscale and as a Specialist AI/ML Solutions Architect at AWS. Christy studied applied math, is a self-taught coder, and has published papers, including one with ACM Recsys. She enjoys hiking and bird watching.
 David Wang
, Algorithm Engineer at Zilliz, brings extensive expertise in computer vision and natural language processing. His contributions to advanced embedding algorithm research, including projects like Towhee and GPTCache, reflect his commitment to advancing AI technologies. Before joining Zilliz, he worked at Alibaba Cloud for large-scale object recognition and classification projects. David holds a Master's degree from Dalian University of Technology.
 Reina Wang
 is a Software Engineer Intern at Zilliz.
Читать далее
A Few Notes from Databricks Data + AI Summit 2026: Why the Data Layer Matters Again
James Luan shares notes from Databricks Data + AI Summit 2026 on why production AI is pushing the data layer back to the center of infrastructure.

Introducing Zilliz MCP Server: Natural Language Access to Your Vector Database
Developers can easily manage and query vector databases with natural language via Zilliz MCP Server in AI-native environments.
Similarity Metrics for Vector Search
Exploring five similarity metrics for vector search: L2 or Euclidean distance, cosine distance, inner product, and hamming distance.