




Flajolet-Martin Algorithm
ユニーク訪問者数、個別の IP アドレス、または多様な検索クエリを正確に数えることは、有意義な洞察を得ようとする組織にとって不可欠です。しかし、すべてのデータポイントを追跡することはリソースを大量に消費し、リアルタイム分析を遅くする可能性があります。ハッシュセットを維持するような従来の方法は、多くの計算とメモリを必要とするため、データが増えるにつれて実用的ではなくなります。
 図 1 データストリームとハッシュ化の可視化
図 1:データストリームとハッシュ化の可視化
Flajolet-Martin アルゴリズムは、この問題を効果的に解決します。メモリ要件を最小限に抑え、正確な結果を提供しながら、効率的な操作によって大規模なデータフロー内の個別要素数を推定します。
このアルゴリズムは、各エンティティを明示的に追跡する代わりに、ハッシュ関数を使用してハッシュ値のパターンを分析し、一意性を推定します。この方法によりメモリ要件が削減され、高速処理とリアルタイム分析機能が可能になります。
Flajolet-Martin アルゴリズムを使用する組織は、監視と分析におけるリアルタイムのスケーラビリティを得られます。これにより、従来のカウント方法よりも低コストで迅速な意思決定が可能になります。そのメモリ効率の高い設計は、データ集約型環境に適しており、個々のデータポイントをすべて保存するオーバーヘッドなしに、精度とパフォーマンスのバランスを取ります。
本稿では、FMA アルゴリズムの概念、仕組み、主なユースケースについて説明します。また、個人や組織にどのようなメリットをもたらすか、実装時にどのような課題が生じるかについても見ていきます。
Flajolet-Martin アルゴリズムとは?
Flajolet-Martin アルゴリズムは、大規模なデータセットやストリーミング情報内の個別要素数(カーディナリティ)を評価するための確率的アプローチです。Philippe Flajolet と G. Nigel Martin は、メモリまたは計算上の制約により正確なカウントが実用的でなくなる状況を解決するために、1984年にこのアルゴリズムを導入しました。
このアルゴリズムは、近似技術を通じて最大限のメモリ効率を提供します。これにより、時間制約のあるリアルタイム条件下で大規模データセットを分析できます。大量のストレージを必要とする決定論的手法とは異なり、その確率的アプローチは効率を維持しながらメモリ消費を大幅に削減します。これにより、大規模データ処理に非常に適しています。
このアルゴリズムの近似手法は、厳密な精度と引き換えにデータ処理を高速化し、計算コストを削減します。これにより、組織は最小限のリソースを使用して、ほぼリアルタイムの運用内でデータ駆動型の洞察を分析し、対応できるようになります。
Flajolet-Martin アルゴリズムの仕組み
Flajolet-Martin アルゴリズムは、大規模データセット内の一意な要素数を効率的に推定するために、確率的手法を採用しています。基本原理は、ハッシュ関数のランダム性を使用して効率的なカーディナリティ近似手法を作成し、大規模なデータ構造や正確なカウントを維持する必要をなくすことです。仕組みは次のとおりです。
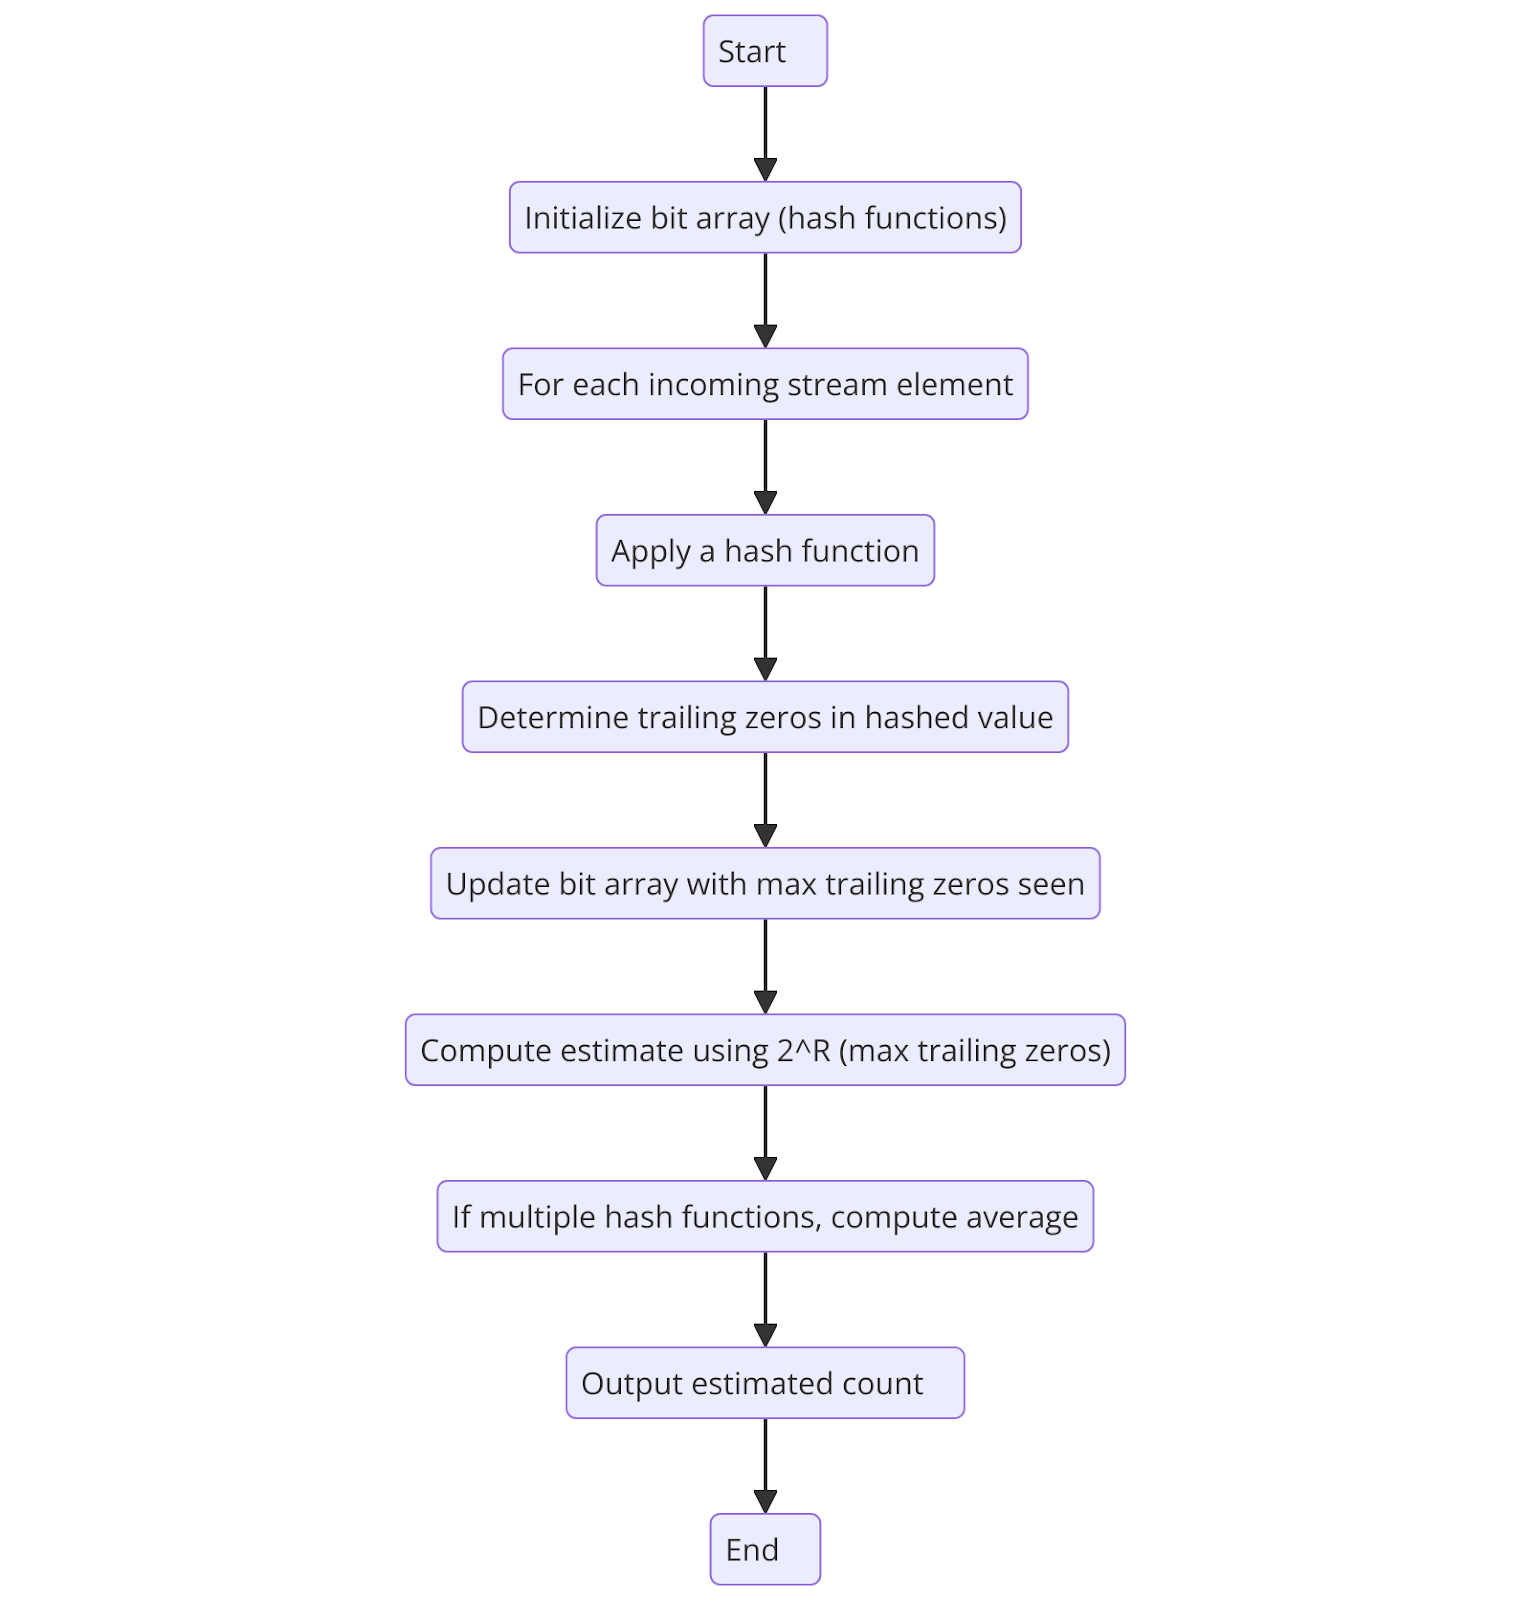 図 2 Flajolet-Martin アルゴリズムのフローチャート
図 2:Flajolet-Martin アルゴリズムのフローチャート
入力のハッシュ化
ハッシュ関数は、入力される要素をランダムに分布した二進数に処理します。一様分布方式により、各ビットが「0」または「1」になる確率が等しくなります。これにより、ハッシュ化プロセスにおけるランダム性が最大化されます。適切に設計されたハッシュ関数は、衝突を最小限に抑え、精度を向上させ、信頼性の高いカーディナリティ推定を保証するために不可欠です。
末尾のゼロの特定
アルゴリズムは、各ハッシュ値について右側(最下位ビット)から最初の「1」に到達するまで調べることで、末尾のゼロの数を決定します。これらの末尾ゼロ数は、ハッシュ値の確率分布を反映します。Flajolet-Martinアルゴリズムは、要素のハッシュ値に含まれる末尾のゼロを数えることで、異なる値の数を推定します。
最大の末尾ゼロ数が大きいほど、カーディナリティが大きいことを示します。異なる要素の推定値は、2を最大の末尾ゼロ数の累乗にすることで計算されます。このアルゴリズムは、最小限のメモリリソースで正確なカーディナリティ推定を生成するために、バイナリハッシュ関数に依存しています。
最大末尾ゼロ数の記録
このアルゴリズムは、すべてのデータセット要素を監視するのではなく、任意のハッシュ値に現れる末尾のゼロの最大数を追跡します。データセット内に追加の一意な要素が現れると、より長い末尾ゼロ列を持つハッシュ値が観測される確率が高まります。
末尾ゼロの統計分布により、アルゴリズムは一意な要素数を間接的に測定できます。このアルゴリズムは個々のデータ項目を保存しないため、ストリーミングデータや大規模処理に最適です。この設計により、優れたメモリ効率が確保され、高速な処理速度が可能になります。
カーディナリティの推定
このアルゴリズムは、次の重要な数式によって一意な要素数を決定します。
E = 2R
where:
- Rは、すべてのハッシュ値の中で観測された末尾ゼロの最大数です。
確率に基づくロジックは、より多くの異なる要素を持つデータセットほど、多数の末尾ゼロで終わるハッシュ値を生成することを示唆しています。
このアルゴリズムは、少なくとも末尾ゼロを持つ値が要素あたり約1回発生すると仮定することで、データセット内の異なる要素を推定します。この方法は、すべての個別項目を保存する必要をなくしながら、大規模なデータ数を高速に推定できます。
比較
Flajolet-Martinアルゴリズムを他の方法と比較して、その性能を確認することは有用です。どの程度正確なのか?どれくらいのメモリを必要とするのか?どのくらい高速にデータを処理するのか?これらの要因は、その有効性を判断するのに役立ちます。
| 特徴 | Flajolet-Martin | HyperLogLog | Count-Min Sketch |
| 主なユースケース | 大規模なデータセットやストリームにおける相異なる要素数(カーディナリティ)の推定。 | メモリ使用量を削減しつつ、カーディナリティ推定の精度を向上させる。 | データストリーム内の要素の頻度を推定し、ヘビーヒッターを特定する。 |
| メモリ使用量 | 準線形未満の空間、具体的には O(log log n) ビットを必要とする。ここで n は相異なる要素の数。 | O(log log n) ビットを使用するよう最適化されている。たとえば、数十億個の相異なる項目を ~2% の誤差でカウントする場合、約 1.5 キロバイトのメモリで実現できる。 | O(w × d) の空間を使用する。ここで w はスケッチの幅、d は深さ。通常、求める精度と入力サイズに応じて、数キロバイトから数メガバイトを必要とする。 |
| 精度 | 標準誤差を伴う推定値を提供する。ハッシュ関数を増やし、ビットマップを大きくするほど精度が向上する。 | 使用するレジスタ数を m とすると、約 1.04/√m の標準誤差で高い精度を提供する。 | ハッシュ衝突により頻度を過大推定する可能性がある。精度はハッシュ関数の数とスケッチサイズに依存する。 |
| 時間計算量 | 各要素を定数時間 O(1) で処理するため、高速なデータストリームに適している。 | 挿入およびクエリ操作において、要素ごとに定数時間 O(1)。 | 更新およびクエリごとに定数時間 O(1)。効率はハッシュ関数の数とスケッチの次元に依存する。 |
| 重複の扱い | 自然に重複を考慮する。各一意な要素は、そのハッシュ値に基づいて推定に寄与する。 | 重複を効果的に処理する。同じ要素が複数回出現しても、カーディナリティ推定には影響しない。 | 要素の頻度を記録するため、重複はその要素のカウントを増加させる。 |
| マージ可能性 | 複数の FM スケッチをマージして、異なるデータストリームからの推定値を統合できる。 | 容易にマージ可能。複数の HyperLogLog 構造を組み合わせて集約推定値を生成できる。 | 異なるスケッチの対応するカウンタを要素ごとに加算することでマージ可能。 |
| 産業での利用 | Flajolet-Martin は基礎的なアルゴリズムであり、ネットワークトラフィック分析や大規模データ処理で使用される HyperLogLog のような、より高度な構造につながっている。 | 効率的なカーディナリティ推定のため、Redis、Apache Druid、Google BigQuery などのシステムで広く採用されている。 | ネットワーク監視、自然言語処理、データベースシステムなど、頻度推定を必要とするアプリケーションで利用されている。 |
利点と課題
flajolet-martinアルゴリズムにはさまざまな利点がありますが、課題も伴います。利点と課題の両方を見ていきましょう。
利点
メモリ効率: このアルゴリズムは、データ表現を最適化するハッシュ関数とビット操作技術によって効率性を実現します。
単一パス処理: このアルゴリズムは、データを1回通過するだけでユニーク数を推定します。そのため、リアルタイム分析に最適です。
スケーラビリティ: Flajolet-Martinアルゴリズムは、対数空間計算量により最小限のメモリリソースで大規模データセットを処理するため、自然なスケーラビリティを示します。
ビッグデータ分析への適用性: このアルゴリズムは、効率的でスケーラブルな設計により、ビッグdata analyticsへの高い適用性を示します。これにより、ユニーク要素の近似を迅速に行えます。
高度なアルゴリズムの基盤: Flajolet-Martinアルゴリズムは、より高い精度を提供するHyperLogLogを含む、高度なカーディナリティ推定アルゴリズムを開発するための基本的な基盤です。
課題
推定値の分散: このアルゴリズムは推定値の分散が大きいことを示します。そのため、正確な結果を得るには複数のハッシュ関数の実行が必要です。
ハッシュ関数選択への感度: アルゴリズムが最適な性能を発揮するにはハッシュ値が一様に分布する必要があるため、不適切なハッシュ関数の選択は誤った結果を生みます。
カーディナリティ推定に限定: このアルゴリズムは、異なる項目の数を判定する一方で、個々の要素やその出現回数を特定できないため、カーディナリティ推定のみに機能します。
適用性の制約: このアルゴリズムは大規模データセットには有効である一方、小規模データセットを扱う場合には適切性が低下します。
実装の複雑さ: ハッシュ関数と確率的カウント手法を理解する専門家を育成する必要があるため、Flajolet-Martinアルゴリズムの採用は難しくなります。
ユースケースとツール
Flajolet-Martinアルゴリズムの利点と課題を理解したところで、実世界での応用について説明します。また、効果的な実装を支援する主要なツールについても見ていきます。
ユースケース
FMAは、以下を含むいくつかの応用シナリオでその有効性を示します。
Web分析: Webサイトでは、個人のユーザー情報を保存せずにユニーク訪問者数を推定する必要が頻繁にあります。FMA手法は、訪問者数を推定するためのメモリ効率の高い計算を提供し、それによってwebsitesがサイト利用状況とユーザーインタラクションを追跡するのに役立ちます。
ネットワーク監視: ネットワークセキュリティは、ネットワークにアクセスしているユニークIPアドレスの正確な数を特定することに依存します。この検出は、セキュリティ脅威や異常の特定に役立ちます。FMAは、異なるIPアドレスのリアルタイム計算を提供し、組織が異常なnetwork behaviorを迅速に検出して対応するのに役立ちます。
データベース管理: データベースは、列内のエントリ数を数えるために定期的な操作を実行します。FMAは迅速なカウント推定を提供し、databasesがクエリ計画とリソース管理プロセスを最適化するのに役立ちます。
ビッグデータ処理: ビッグデータ環境では、データストリーム分析中に限られたメモリリソースで連続データストリームを処理するアルゴリズムが必要です。FMAはApache SparkおよびFlinkフレームワークの一部として機能し、高効率のリアルタイムストリーミングdata analyticsを提供します。
リアルタイム処理: 金融ティッカー、ソーシャルメディアフィード、センサーネットワークなどのアプリケーションは、即時処理を必要とするデータを生成します。FMA はユニーク要素の迅速な推定を提供し、即時の意思決定アプリケーションに不可欠なツールとなっています。
ツール
Flajolet-Martin アルゴリズムとその変種を実装するために、ライブラリと併せて複数のツールが存在し、システム統合を簡素化します。これらには以下が含まれます。
Apache DataSketches: オープンソースの library DataSketches は、近似データ分析のための Flajolet-Martin ベースのアルゴリズムを含む、複数の確率的ストリーミングアルゴリズムを提供します。Flajolet-Martin アルゴリズムは、テレメトリシステムやネットワーク監視業務を含む、大規模なデータストリームを処理・分析するリアルタイムシステムで広く応用されています。
PostgreSQL Flajolet-Martin Extension: PostgreSQL Flajolet-Martin 拡張機能は、PostgreSQL データベースに algorithm-based functions を追加し、ユーザーが SQL クエリを通じて近似 distinct count 操作を実行できるようにします。この拡張機能は、正確な計算を必要とせずに大規模テーブル内のユニーク値を迅速に推定することで、データベース性能にメリットをもたらします。
Python Implementation by ApoorvaSaxena1: Flajolet-Martin アルゴリズムの Python ベースの implementation は、ストリーミングデータ内の distinct item 数を推定する能力を示しています。
Probabilistic Counting with Stochastic Averaging: algorithm PCSA は、ハッシュ値の末尾ゼロを追跡するためにビットマップを使用し、ストリーム内のユニーク要素推定を可能にします。
FAQs
Flajolet-Martin アルゴリズムはどの問題を効率的に解決しますか?
Flajolet-Martin アルゴリズムは、すべての要素を保存する必要をなくしながら、大規模データストリーム内のユニーク要素を推定します。このアルゴリズムはサブリニアな空間要件で効率的な推定を行うため、ネットワーク監視、データベースクエリ、Web 分析アプリケーションに適しています。
このアルゴリズムはストリーム内の重複値をどのように処理しますか?
このアルゴリズムは、ハッシュ値内の最右の 1 ビットを追跡し、完全なリストを保存せずに繰り返し出現を検出するのに役立ちます。このアプローチにより、繰り返しの多いデータストリーム内の重複を自動的に除外しながら、ユニーク数の正確な推定を保証します。
Flajolet-Martin アルゴリズムはリアルタイム分析に使用できますか?
このアルゴリズムは、最小限のメモリリソースしか必要とせずにデータをストリーミング処理するため、リアルタイムデータ処理に適しています。実用的なアプリケーションには、Web サイトトラフィック監視、プラットフォーム上のアクティブユーザー数のカウント、ネットワーク接続の識別、ソーシャルメディアプラットフォーム上のハッシュタグ追跡などがあります。
Flajolet-Martin アルゴリズムの主な制限は何ですか?
ハッシュ関数がエラーを生成する場合や、データ分布が不均衡な場合には、有効性が低下します。このアルゴリズムは高度に偏ったデータの処理に困難を伴いますが、メモリ消費を増やさずに正確な結果を得るには確率的平均化手法が必要です。
このアルゴリズムは HyperLogLog とどのように比較されますか?
Flajolet-Martin の高度なバージョンである HyperLogLog は、推定品質を向上させるために改良された統計手法と高度なデータ構造を実装しています。この手法は、メモリ効率の高い設計を損なうことなくエラーを減少させます。