




テキストをデータとして、どこからどこへでも
#はじめに
2024年3月、SFのUnstructured Data MeetupでAJ Steersから、AirbyteとPyAirbyteを利用して、テキストをデータとしてどこからでも利用できる方法について聞いた。つまり、さまざまなプラットフォーム上のさまざまなソースから、構造化データと非構造化データの両方を統合して利用することができるということだ。
AJ Steersの講演のYouTube再生へのリンク:YouTubeで見る.
AJ Steersとは何者か?なぜユニファイド・データ統合に関心を持つべきなのか?
AJ Steers は経験豊富なアーキテクト、データエンジニア、ソフトウェア開発者、データ運用のエキスパートである。彼はアマゾンでエンド・ツー・エンドのソリューションを設計し、定量化されたセルフ・データ・モデルのビジョンを作り上げた。現在はAirbyteのスタッフ・ソフトウェア・エンジニア。
統一データ統合は、多様なデータタイプとソースを単一のまとまったシステムに統合し、効率的な分析と処理を可能にする。この機能は、データの可能性を最大限に活用し、さまざまなプラットフォームやアプリケーションでシームレスなアクセスと活用を実現する上で極めて重要です。AJが言うように、「かつてないほど、私たちは使えるデータに囲まれている」。価値があると思われるデータをソースから入手するために、どれだけの時間が必要なのか?
それでは、Airbyteを使ったAJの「データとしてのテキスト、どこからでもどこへでも」の話に飛び込もう。
エアバイトの対応ソースと送信先の拡大
Airbyteのこれまでの焦点は、信頼性、柔軟な導入オプション、そして従来の表形式データのシームレスなデータ統合を保証する堅牢なコネクタライブラリを提供することでした。しかし、非構造化データについてはどうでしょうか?Airbyteチームが過去6ヶ月間取り組んできたことについて、AJが語ります。
2024年3月から遡ってこの半年間で、Airbyteは従来の表形式データソースに加えて、非構造化データソースをカバーするために機能を拡張しました。これは、今日のデータエコシステムにおける非構造化データの重要性と普及率の高まりによるものです。この拡張により、AirbyteはSQLタイプやファイルタイプの送信先にとどまらず、Milvusのようなベクトルデータベース送信先もカバーするようになり、様々なアプリケーションでデータを効果的に活用できるようになりました。構造化データソースと非構造化データソースの両方について、Airbyteがサポートしているコネクタのいくつかを見てみましょう。
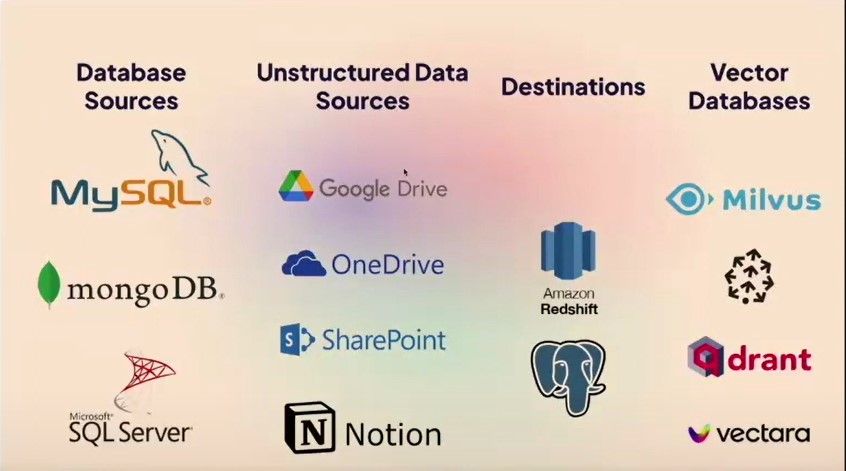
Airbyteは350以上のコネクタをサポートしているため、そのすべてを列挙することはできません。しかし、AJによって共有された上記のスライドは、各ソースと宛先カテゴリのコネクタのサンプルを示しています。ここまでは、非構造化データと、それをサポートするためにAirbyteがどのように拡張しているかについて話してきました。しかし、このようなデータの実際の例はどのようなものでしょうか?
あなたが読んでいるこのブログを思い浮かべてみてください。表形式で並べられていますか?それは非構造化データの典型例で、行や列にきれいに収まらないテキストで構成されています。 非構造化データとは、従来の行と列のデータベースに存在しない情報を指す。テキスト、画像、動画、ソーシャルメディアへの投稿などのデータが含まれる。下のスライドで、AJが共有した非構造化データを見てみよう。
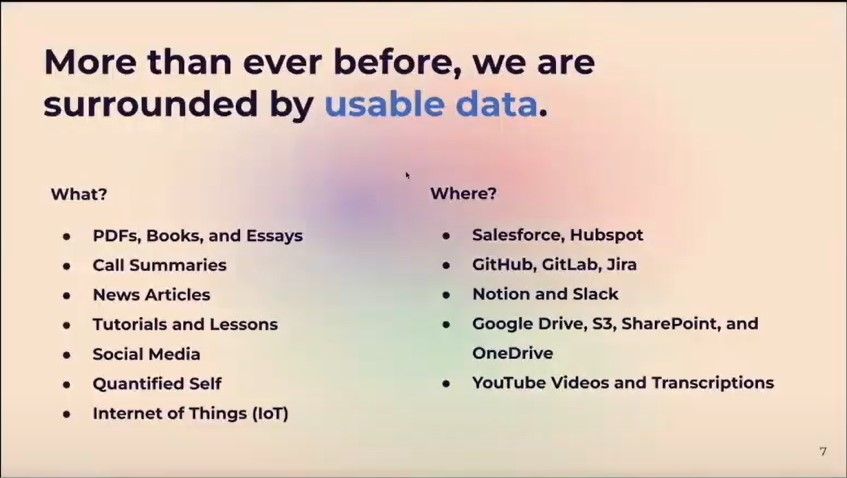
このようなデータと、それを消費するためのAirbyteの支援により、コミュニティによってAirbyteに期待することは異なります。
ジェンアル開発者**:他のエコシステム・ツールやパラダイムとの合理的な統合を望んでいる。
データ科学者**:中央データウェアハウスから切り離されたJupyterノートブックで実行できるライブラリが欲しい。
データエンジニアパイプライン・アズ・コード・アプローチ、CIテスト・パイプラインの実行、摩擦のない開発を望んでいる。
開発者ローカルでビルドして反復し、後でデプロイしたい。
このことから、私たちは皆、優れたライブラリ、優れた相互運用性、より多くのコントロールを望んでいることがわかる。しかし、それはすべてあなたが何を望んでいるかということになる。コードを書いてコントロールできるものを求める人もいれば、あまり技術的でなくユーザー・インターフェースを使いたい人もいる。伝統的に、これは私たちを全く異なる道へと導いてきた。Airbyteは、Pythonコードを実行して書ける人なら誰でも、PyAirbyteを使って数行のコードをコピーペーストできる人なら誰でも、これらの障壁を打ち破ろうとしています。PyAibyteとは何か、その長所を見てみましょう。
PyAirbyte の紹介
PyAirbyteはAirbyteと対話するためのインタフェースを提供するPythonライブラリです。Pythonを使ってAirbyteインスタンスを制御・管理することができます。すべてのPython開発者にAirbyteの力をもたらすものと考えてください。
PyAirbyteの利点
- どこでも実行可能データウェアハウスから切り離されたJupyterノートブックでPyAirbyteを実行できます。これは、特定のデータウェアハウスに縛られることなく、多くの環境で使用できることを意味し、私たちのニーズに最も適した環境で作業できる柔軟性を与えてくれます。
Reduce time to value:PyAirbyteを使えば、デプロイする前にローカルでデータパイプラインを構築し、反復することができます。これにより、パイプラインが期待通りに動作しているかどうかをテストして改善することができ、データから価値ある洞察を得るまでの時間を短縮できます。
- 迅速なプロトタイピング**:PyAirbyteはユーザーインターフェイスやサインアップを必要としないため、データパイプラインの定義をコードですぐに始めることができます。これにより、プロトタイピングプロセスがスピードアップします。
- 柔軟性**:PyAirbyteはエコシステムにあるツールやフレームワークと一緒に使うことができます。つまり、すでに使っている他のツールと統合できるので、既存のワークフローやプロセスに簡単に組み込むことができます。
それでは、わずか数ステップでAirbyteとPyAirbyteを使い始める方法を紹介しましょう。
UIとコードのデモ
AJはデモセッションで、ホスト版Airbyte(コードなしアプローチ)とPyAirbyte(最小コードアプローチ)を使ってデータソースとデータ送信先を統合する方法を紹介します。
UI アプローチのデモ
コードを入力するよりもボタンをクリックする方が好きな人にとって、UIアプローチは夢のような方法です。お気に入りのビデオゲームの「イージーモード」のようなものです。Airbyteのホスト版を使ってデータソースとデスティネーションを接続する方法](https://zilliz.com/blog/use-milvus-and-airbyte-for-similarity-search-on-all-your-data)はすでに詳しく説明したので、ここでは簡単に説明します。リンク先の記事は、統合の部分を超えて、確立された接続を使用して実際のアプリを構築する方法を示しています。
データソースとデータデスティネーションを接続するためのノーコード・アプローチには、主に4つのステップがあります。
1.Airbyteアカウント](https://airbyte.com/)にサインアップまたはログインします。サインアップすると、14日間のトライアルが提供されます。
2.データソースを設定します。
3.データ送信先を設定する。
4.ソースとデスティネーション間の接続を作成する。
接続が確立されると、データを使用する準備が整います。もしあなたが私のようなコードオタクで、コードによるアプローチを好むのであれば、PyAirbyteにお任せください。
コードアプローチのデモ
**PyAirbyteを使った3ステップのデータ取得
PyAirbyteを使ってデータを取得するプロセスは非常に簡単です。
ステップ 1:
get_source()関数を使用してsource` を作成する。
abとしてairbyteをインポートする。

# サポートされているソースをチェックする

print(ab.get_available_connectors())

# 欲しいデータソースを作成する

source = ab.get_source("source-github")
Airbyteがサポートしているすべてのコネクタを視覚的に確認するには、サポートされているコネクタのページをご覧ください。しかし、あなたのソースのコネクタがサポートされていない場合はどうしますか?その場合は、独自のカスタムコネクタを作成する必要があります。ご心配なく、それほど難しくはありません。このガイドに従うだけです](https://docs.airbyte.com/connector-development/connector-builder-ui/tutorial)。Airbyteは10分もかからずにコネクタを構築できるノーコード・コネクタ・ビルダーを提供しています。
ステップ2:
set_config()`でソースを設定します。
source.set_config()

    {

        # 希望のリポジトリに置き換える

    "リポジトリ":[FINCH285/engineering-education"]、

    "credentials":{

        "personal_access_token": ab.get_secret(

        "github_personal_access_token"

            )

        }

    }

)

# 設定と認証情報を検証する

ソース.check()
これは、データを取得したいソースの場所と、必要な認証情報を渡すだけです。
ステップ 3:
read() 関数を使用してデータを読み込む。
# ソースから利用可能なストリームを確認する。

print(source.get_available_streams())

#選択したストリームからデータを引き出す

read_result = source.read(

    streams=['ブランチ', '共同作業者'].

)

# interopオプションを使う

branches_dataframe = read_result["branches"].to_pandas()

branches_sql_table = read_result["branches"].to_sql_table()

branches_lln_docs = read_result["branches"].to_documents()
interop オプションを使うと、取得したデータをユースケースに最適な別のデータ構造に変換することができる。これで3ステップのプロセスは完了です。ただし、データをフェッチするために3つのステップを個別に実行することは必須ではありません。Airbyteは、同じことを実現するためのワンステッププロセスをサポートしています。
PyAirbyte を使った1ステップでのデータ取得
これはスピードランバージョンです。3つのステップを1つのステップにまとめる。
abとしてairbyteをインポート

ソース = ab.get_source(

    "source-github"、

    config={

        # 希望のリポジトリに置き換える

        "repositories":[FINCH285/engineering-education"]、

        "credentials":{

            "personal_access_token": ab.get_secret(

                "github_personal_access_token"

            ),

        },

    },

    streams=['branches', 'collaborators'].

).read()
このコードでは、3つの操作を1つのステップで行っている。ソースを作成し、設定し、最後にデータを読み込む。これで、先ほどと同じように interop オプションを使用して、取得したデータを異なるデータ構造に変換することができます。しかし、表形式データからLLMドキュメントを生成したい場合は、次のセクションでその方法を説明します。
表データからLLMドキュメントを生成する
データをLangChainと互換性を持たせたい場合、LLM文書に変換する必要があります。LLMドキュメントは質問応答、要約、テキスト生成など様々な自然言語処理タスクに利用できます。
インポートリッチ

from itertools import islice

dataset = source_github.get_documents(

   "issues"、

   title_property="title"、

   content_property=["本文"]、

)

# いくつかのドキュメントを取得する(最初の2つをスキップする)

ドキュメント = list(islice(dataset, 2, 5))

# マークダウンとして印刷する

for document in documents:

   display(rich.markdown.Markdown(document.content))
このコードは GitHub の課題を取得し、それをドキュメントとしてレンダリングします。そして、ドキュメントのタイトルを issue のタイトルに設定し、ドキュメントの内容を issue の本文に設定します。そして、rich を使ってドキュメントをマークダウン形式でコンソールに出力します。
2つの選択肢がある中で、どちらのアプローチが一番適しているか見てみよう。
AirbyteとPyAirbyteの選択
ゼロコードでベクターストアを実現したいのであればホスティング版を。最小限のコードでフルコントロールしたいならPyAirbyteを。AJは、理論的には仮想環境でサポートされているPythonであればどこでもPyAirbyteを実行できると主張しています。どのアプローチが自分に合っているかを決めるのに役立つ表をまとめました。
| 基準 | エアバイト(UI/ホスト型) | PyAirbyte |
| アプローチ|ノーコード|コード/Python | ||
| セットアップ|シンプルなサインアッププロセス|Pythonのコーディングスキルが必要 | ||
| ユーザーインターフェース|ユーザーフレンドリーなインターフェースを提供します。 | ||
| データ統合|従来のデータ統合タスクと最新のデータ統合タスクの両方に適している(非構造化データ、ベクトル・データベースなど)|従来のデータ統合タスクと最新のデータ統合タスクの両方に適している(非構造化データ、ベクトル・データベースなど)|データ統合|従来のデータ統合タスクと最新のデータ統合タスクの両方に適している。 | ||
| 柔軟性|UIで提供されるオプションに限定される|柔軟性が高く、他のPythonツールやフレームワークと統合できる | ||
| 環境|ホスト環境|あらゆるPython環境(例:Jupyter Notebook、ローカルマシン)で実行可能。 | ||
| デプロイ|Airbyteのホスト環境にデータパイプラインをデプロイ|コードベースのデプロイはCI/CDパイプラインと統合可能|プロトタイピング|Airbyteのホスト環境にデータパイプラインをデプロイ。 | ||
| プロトタイピング|非技術的なユーザーや迅速なプロトタイピングに最適|技術的なユーザーや迅速なプロトタイピングに最適 | ||
| 学習曲線|低い学習曲線|Pythonのコーディングスキルまたは基本的なコーディングスキルが必要です。 |
比較の後、あなた自身の冒険を続けることができます。
PyAirbyteの今後の機能
PyAirbyteはまだベータ版です。そのため、現時点では完全なデスティネーションはサポートしていません。つまり、デスティネーションとしてベクトルストアは持っていませんが、LangChainに渡すことはできます。Ajは今年のPyAirbyteチームに期待することをいくつか話してくれました: **PyAirbyteの次は?
2024年第2四半期の計画
Python 3.9と3.11のサポートの改善
Windows サポートの追加
ソース設定用APIの改良
Airbyteクラウド版、OSS版、エンタープライズ版との相互運用性の向上
2024年下半期の計画
リバースETLのサポート追加
ベクターストアのデスティネーションのサポートを追加
Publishタイプのデスティネーションのサポートを追加
フィードバックやバグ報告をしたい場合は、PyAirbyte の GitHub ページ に issue を書くことを検討してください。
結論
AirbyteとPyAirbyteは、構造化データと非構造化データの両方を統合するための堅牢なソリューションを提供します。AJ Steers氏は、データ・ワークフローに革命をもたらすこれらのツールの可能性をよく描き出している。詳細については、以下のリソースをチェックし、どこからでも、どこからでも、テキストをデータとして活用する旅を始めてください。
その他のリソース
https://zilliz.com/blog/use-milvus-and-airbyte-for-similarity-search-on-all-your-data
https://zilliz.com/blog/zilliz-introduces-upsert-kafka-connector-and-airbyte-integration
https://github.com/airbytehq/quickstarts/tree/main/pyairbyte_notebooks
AJ SteerのトークのYouTube再生へのリンク:YouTubeで講演を見る。
読み続けて
Why I’m Against Claude Code’s Grep-Only Retrieval? It Just Burns Too Many Tokens
Learn how vector-based code retrieval cuts Claude Code token consumption by 40%. Open-source solution with easy MCP integration. Try claude-context today.
Demystifying the Milvus Sizing Tool
Explore how to use the Sizing Tool to select the optimal configuration for your Milvus deployment.
Vector Databases vs. Spatial Databases
Use a vector database for AI-powered similarity search; use a spatial database for geographic and geometric data analysis and querying.