




OpenAIを使わないRAG:BentoML、OctoAI、Milvus
この記事はThe New Stackに掲載されたもので、許可を得てここに再掲載している。
拡張された検索拡張生成オプションは、開発者のOpenAIへの依存をなくすことができる
ChatGPTは、2023年にAIを公的知識の最前線にもたらした。しかし、今ではさらに多くの選択肢があり、もはやOpenAIに縛られることはありません。これは、OpenAIのGPTではないLLMを使ってretrieval augmented generation (RAG)アプリを構築する方法についてのブログシリーズの3番目のエントリです。part1](https://zilliz.com/blog/building-rag-apps-without-openai-part-I?utm_source=vendor&utm_medium=referral&utm_campaign=2024-03-25_blog_rag-bentoml-milvus-octoai_tns)とpart2はこちらです。このプロジェクトのGitHubレポはこちらです。
このチュートリアルでは、BentoMLを埋め込みに、OctoAIをLLMに、Milvusをベクトルデータベースに使います。このチュートリアルでは
BentoMLによる埋め込み処理
RAG用ベクトルデータベースへのデータの挿入
Milvusコレクションの作成
挿入のためのデータの解析と埋め込み
RAGのためのLLMのセットアップ
LLMに指示を与える
RAGの例
BOMドットコムの概要RAGのためのBentoML、OctoAI、Milvus
BentoMLでエンベッディングを扱う
BentoMLのSentence Transformers Embeddingsリポジトリを使って、BentoMLで提供されている文埋め込みを使うことができます。このリポジトリで何が行われているかを簡単に説明しましょう。主なものは service.py ファイルです。基本的に、このファイルはサーバーを立ち上げ、APIエンドポイントを設置します。 APIエンドポイントでは、Hugging Faceのall-MiniLM-L6-v2を読み込み、エンベッディングを作成するために使用しています。
このリポジトリはサーバーを立ち上げ、エンドポイント <http://localhost:3000> を提供してくれる。このエンドポイントを使うために、bentomlをインポートして、SyncHTTPClientネイティブオブジェクト型を使ってHTTPクライアントを立ち上げる。
bentoml をインポートする。
bento_client = bentoml.SyncHTTPClient("http://localhost:3000")
クライアントに接続したら、文字列のリストからエンベッディングのリストを取得する関数を作成します。注意すべき点は、リストを一度に25個の文字列に分割していることです。これは、同期エンドポイントを使っているためです。文字列のリストを分割することで、呼び出しの計算量が少なくなり、タイムアウトを避けることができます。
リストを25のセクションに分割した後、上で作成した bento_client を呼び出して文章をエンコードする。BentoMLクライアントはベクトルのリストを返す。それぞれのベクトルを取り出し、空の埋め込みリストに追加します。このループの最後に、最終的な埋め込みリストを返します。
もしテキストリストに25個以上の文字列がなければ、渡された文字列リストに対してクライアントから encode メソッドを呼び出すだけです。
def get_embeddings(texts: list) -> list:
   if len(texts) > 25:
       splits = [text[x:x+25] for x in range(0, len(texts), 25)]] とする。
       embeddings = [].
       for split in splits:
           embedding_split = bento_client.encode()
               文 = split
           )
           for embedding in embedding_split:
               embeddings.append(embedding)
       return embeddings
   return bento_client.encode(
       sentences=texts、
   )
データをRAG用のベクターデータベースに挿入する
埋め込み関数が準備できたので、RAGアプリケーションのためにMilvusに挿入するデータを準備します。まずはMilvusを起動して接続します。上記リンク先のリポジトリにdocker-compose.ymlファイルがあります。また、Milvus Docker Composeもこのdocsページにあります。
Dockerがインストールされており、そのリポジトリをダウンロードしていれば、docker compose up -d を実行してMilvusを立ち上げることができるはずです。Milvusサーバが立ち上がったら、いよいよ接続だ。このパートでは connections モジュールをインポートし、ホスト (localhost または 127.0.0.1) とポート (19530) を指定して connect を呼び出します。また、以下のコードブロックでは、コレクション名とディメンションの2つの定数を定義している。コレクション名は自由に設定できます。次元のサイズは埋め込みモデルのサイズ all-MiniLM-L6-v2 に由来する。
from pymilvus import connections
COLLECTION_NAME = "bmo_test"
ディメンション = 384
connections.connect(host="localhost", port=19530)
Milvusコレクションの作成
Milvus](https://zilliz.com/what-is-milvus?utm_source=vendor&utm_medium=referral&utm_campaign=2024-03-25_blog_rag-bentoml-milvus-octoai_tns)でコレクションを作成するには、スキーマの定義とインデックスの定義の2つのステップがあります。このセクションでは、4つのモジュールが必要である:FieldSchemaはフィールドを定義し、CollectionSchemaはコレクションを定義し、DataTypeはフィールドのデータのタイプを示し、Collection`はMilvusがコレクションを作成するために使用するオブジェクトである。
ここでコレクションのスキーマ全体を定義することができる。あるいは、単純に必要な2つの部分を定義することもできる:idとembeddingである。それから、スキーマを定義するときに、enabled_dynamic_field`というパラメータを渡す。これにより、Milvusへのデータ挿入をMongoDBのようなNoSQLデータベースと同じように扱うことができる。次に、先に指定した名前とスキーマでコレクションを作成します。
from pymilvus import FieldSchema, CollectionSchema, DataType, Collection
# 定義にはidとembeddingが必要
fields = [
   FieldSchema(name="id", dtype=DataType.INT64, is_primary=True, auto_id=True)、
   FieldSchema(name="embedding",dtype=DataType.FLOAT_VECTOR,dim=DIMENSION)]。
]
# "enable_dynamic_field "により、任意のメタデータ・フィールドでデータを挿入することができます。
schema = CollectionSchema(fields=fields, enable_dynamic_field=True)
# コレクション名を定義し、スキーマを渡す
コレクション = コレクション(name=COLLECTION_NAME, schema=schema)
コレクションを作成したので、インデックスを定義する必要があります。検索において、「インデックス」はデータを検索するためにどのようにマッピングするかを定義します。このプロジェクトでは、HSNW (hierarchical navigable small worlds) を使ってインデックスを作成します。また、ベクトル距離の測定の方法も定義する必要があります。この例では、内積またはIPを使用します。
Milvusで提供されている11のインデックスタイプはそれぞれ異なるパラメータを持っています。HNSWでは2つのパラメータを調整する:M "と "efConstruction "である。M "は各グラフにおけるノードの次数の上限値であり、"efConstruction "はインデックス構築時に使用されるexploratory f要素である。
実用的な観点からは、"M "と "efConstruction "の両方が高いほど良い検索につながる。M "の値が高いほど、インデックスがより多くのメモリを消費することを意味する。efConstruction "の値が高いほど、インデックスの構築に時間がかかることを意味する。最適な値を見つけるには、これらの値を弄る必要がある。
インデックスを定義したら、選択したフィールド(この場合は embedding)にインデックスを作成する。そして、コレクションをメモリにロードするために load を呼び出す。
index_params = {
   "index_type":"HNSW", # 11種類のMilvusインデックスのうちの1つ。
   "metric_type":"IP": # L2、コサイン、IPのいずれか
   「params":{
       "M":8, # より高いM = より多くのメモリを消費するが、より良い検索品質
       "efConstruction":64 # より高い efConstruction = より遅い構築、より良い検索
   },
}
# インデックスを作成するフィールドと、インデックスを作成するパラメータを渡します。
collection.create_index(フィールド名="embedding", index_params=index_params)
# コレクションをメモリにロードする
コレクションをメモリにロードする
挿入のためのデータの解析と埋め込み
Milvusの準備ができ、接続ができたので、vector databaseにデータを挿入することができます。しかし、まず挿入するデータを準備しなければなりません。この例では、repoのdataフォルダにあるtxtファイルの束を用意します。このデータをチャンクに分割し、埋め込み、Milvusに保存します。
まず、このテキストをチャンクする関数を作ることから始めましょう。チャンキングの方法はたくさんあります](https://zilliz.com/blog/experimenting-with-different-chunking-strategies-via-langchain?utm_source=vendor&utm_medium=referral&utm_campaign=2024-03-25_blog_rag-bentoml-milvus-octoai_tns)が、この例では素朴にやってみましょう。以下の関数はファイルを文字列として読み込み、改行ごとに分割する。そして、新しく作られた文字列のリストを返す。
# 改行で素朴にチャンクする
def chunk_text(filename: str) -> list:
   with open(filename, "r") as f:
       text = f.read()
   sentences = text.split("n")
   文を返す
次に、各ファイルを処理する。すべてのファイル名のリストを取得し、チャンクされた情報を保持するために空のリストを作成する。そして、すべてのファイルをループで処理し、それぞれのファイルに対して上記の関数を実行して、各ファイルの素朴なチャンクを取得する。チャンクを保存する前に、チャンクをクリーニングする必要がある。
個々のファイルがどのようにチャンクされているかを見てみると、多くの空行がある。中にはタブやその他の特殊文字だけの行もある。それらを避けるために、空のリストを作り、ある長さ以上のチャンクだけを保存する。簡単のため、7文字とする。
各文書のチャンクをきれいにリストアップしたら、データを保存します。各チャンクのリストをドキュメントの名前(この場合は都市名)にマッピングする辞書を作成する。そして、これらをすべて、上で作った空のリストに追加します。
インポート os
cities = os.listdir("data")
# 各都市のチャンクされたテキストをdictsのリストに格納する。
city_chunks = [].
for city in cities:
   chunked = chunk_text(f "data/{city}")
   クリーン = [].
   for chunked in chunked:
       if len(chunk) > 7:
           cleaned.append(chunk)
   マップされた = {
       "city_name": city.split(".")[0]、
       「チャンク": cleaned
   }
   city_chunks.append(mapped)
各都市のチャンクされたテキストのセットが準備できたので、いよいよ埋め込みを行う。Milvusはコレクションに挿入する辞書のリストを受け取ることができるので、別の空のリストから始めることができる。上記で作成した各辞書について、文のリストにマッチする埋め込みリストを取得する必要があります。
これはBentoMLを使うセクションで作成した get_embeddings 関数をチャンクのリストそれぞれに対して直接呼び出すことで行います。次に、これらをマッチさせる必要があります。埋め込みリストと文のリストはインデックスで一致するはずなので、どちらかのリストを enumerate して一致させることができます。
Milvusの1つのエントリーを表す辞書を作成することで照合する。各エントリにはエンベッディング、関連文、都市が含まれる。都市を含めるかどうかは任意だが、使えるように含めることにしよう。このエントリーにidを入れる必要がないことに注目してほしい。上のスキーマを作ったときに id を自動インクリメントすることにしたからだ。
これらのエントリーをループしながらリストに追加していく。最後に、各ディクショナリがMilvusへの1行のエントリーを表すディクショナリのリストができます。あとはこれらのエントリをMilvusコレクションに挿入するだけです。最後のステップはエントリをフラッシュすることです。
entries = [].
for city_dict in city_chunks:
   embedding_list = get_embeddings(city_dict["chunks"]) # リストのリストを返す。
   # エンベッディングと都市名をマッチさせる
   for i, embedding in enumerate(embedding_list):
       entry = {"embedding": embedding、
                "文": city_dict["chunks"][i], # 名前が悪いので本当は文の束なのだが、まあいいか。
                "city": city_dict["city_name"]}
       entries.append(entry)
collection.insert(エントリー)
collection.flush()
RAG用にLLMをセットアップする
さて、LLMを用意して、ゴロゴロする準備をしよう。ガタゴトというのはRAGをするという意味だ。このセクションを正確に行うには、OctoAIのアカウントが必要です。また、好きなLLMをドロップインすることもできます。
この最初のコードブロックでは、環境変数をロードし、OctoAI API トークンを取り出し、クライアントを起動します。
from dotenv import load_dotenv
load_dotenv()
os.environ["OCTOAI_TOKEN"] = os.getenv("OCTOAI_API_TOKEN")
from octoai.client import クライアント
octo_client = クライアント()
LLMの指示を与える
LLMがRAGを実行するために知る必要のあるものが2つある。質問とコンテキストの2つの文字列を受け取る関数を作成することで、これらの両方を一度に渡すことができます。 この関数を使い、OctoAIクライアントのチャット補完機能を使ってLLMを呼び出します。 この例では、Nous Research fine-tuned Mixtralモデルを使用します。
このモデルに2つの "メッセージ "を与えます。まず、LLMにメッセージを送り、与えられたコンテキストだけに基づいてユーザーからの質問に答えることを伝えます。次に、LLMにユーザーが存在することを伝え、単に質問を渡します。
その他のパラメータは、モデルの動作をチューニングするためのものです。トークンの最大数や、モデルがどの程度 "創造的 "に振る舞うかを制御することができます。
この関数は、クライアントからの出力をJSON形式で返します。
def dorag(question: str, context: str):
   完了 = octo_client.chat.completions.create(
   messages=[
           {
               "role":"system"、
               "content": f "あなたは親切なアシスタントです。ユーザーは質問をしています。コンテキストのみに基づいてユーザーの質問に答えてください:{コンテキスト}"
           },
           {
               "role":"ユーザー"、
               "content": f"{質問}".
           }
       ],
       model="nous-hermes-2-mixtral-8x7b-dpo"、
       max_tokens=512、
       presence_penalty=0、
       temperature=0.1、
       top_p=0.9、
   )
   return completion.model_dump()
RAGの例
これで準備は整った。質問の時間だ。これは関数を作らなくてもできるかもしれませんが、関数を作ることで再現性が高くなります。この関数は単に質問を受け取り、それに答えるためにRAGを実行します。
まず、文書を埋め込むのに使ったのと同じ埋め込みモデルを使って、質問を埋め込むことから始めます。次に、Milvusで検索を実行します。get_embeddings関数に質問をリスト形式で渡し、出力されたリストをMilvus検索のdata`セクションに直接渡していることに注目してください。これは関数のシグネチャの設定方法によるもので、複数の関数を書き換えるよりも再利用する方が簡単だからです。
検索呼び出しの内部では、さらにいくつかのパラメータを指定する必要があります。anns_fieldはMilvusにどのフィールドに対して[近似最近傍探索](https://zilliz.com/glossary/anns?utm_source=vendor&utm_medium=referral&utm_campaign=2024-03-25_blog_rag-bentoml-milvus-octoai_tns) (ANNS)を行うかを伝えます。また、インデックスのパラメータも渡す必要があります。メトリックタイプがインデックスの作成に使用したものと一致することを確認する。また、一致するインデックスパラメータ、この場合はef`、つまり探索的因子を使用する必要がある。
efが高いほど検索時間は長くなるが、リコールは高くなる。efは最大2048まで設定できるが、ここではスピードと簡略化のために16を使用している。このデータセットには数千のエントリーしかない。次に limit パラメータを渡して、Milvusから何件の検索結果を返すかを指定する。
最後のsearchパラメータは、検索結果からどのフィールドを取得するかを定義する。この例では、テキストのチャンクを保存するために使用したフィールドである sentence を取得します。検索結果が戻ってきたら、それを処理する必要がある。Milvusはhitsを含むエンティティを返すので、ヒットした5件すべてから "sentence "を取り出し、ピリオドで連結してリストの段落を形成する。
そして、ユーザーが質問した内容とその段落を、上で作成した dorag 関数に渡して、レスポンスを返します。
def ask_a_question(question):
   embeddings = get_embeddings([question])
   res = collection.search(
       data=embeddings, # リストのリストとして返された1つの埋め込みを検索する
       anns_field="embedding", # 埋め込みを横断して検索する
       param={"metric_type":"IP"、
               「params":{"ef":16}},
       limit = 5, # 上位5位までの結果を得る
       output_fields=["sentence"] # 文章/チャンクと都市を取得する
   )
   センテンス = [].
   for hits in res:
       for hit in hits:
           sentences.append(hit.entity.get("sentence"))
   context = ".".join(sentences)
   リターンdorag(質問、コンテキスト)
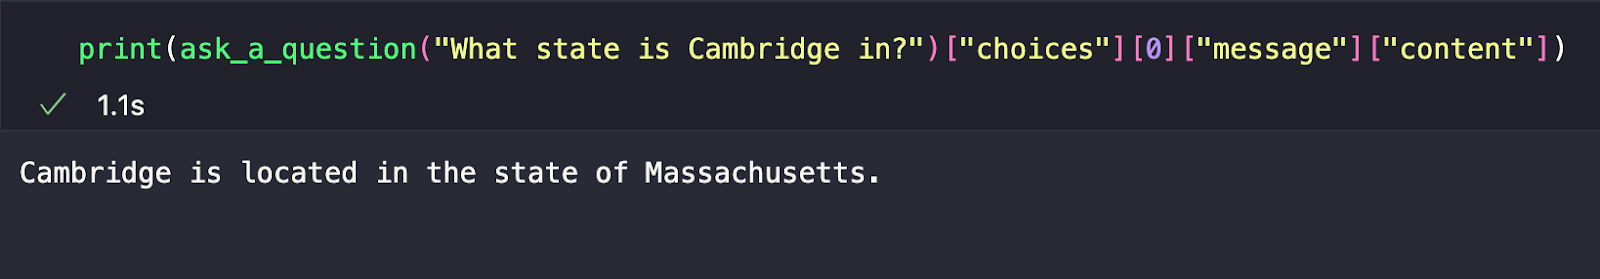
print(ask_a_question("Cambridge is What state in?")["choices"][0]["message"]["content"])
ケンブリッジはどの州にあるかという質問例では、OctoAIからの応答全体を表示すればよい。しかし、時間をかけて解析すれば、より見栄えが良くなり、ケンブリッジがマサチューセッツ州にあることを教えてくれるはずです。
BOMドットコムのまとめ:BentoML、OctoAI、Milvus for RAG
今回の例では、OpenAIやフレームワークを使わずにRAGを実現する方法を紹介しました。以前のいくつかの例とは異なり、LangChainやLlamaIndexを使っていないことに注意してください。今回のスタックはBOM.COM - BentoML、OctoAI、Milvusです。BentoMLのエンベッディングモデルエンドポイント、OctoAIのLLMエンドポイント、Milvusをベクトルデータベースとして使用しました。
これらの異なるパズルのピースを使用する順序を構成する方法はたくさんあります。この例では、まずBentoMLでローカルサーバーを立ち上げ、Hugging Faceの埋め込みモデルをホストします。次に、Docker Composeを使ってローカルのMilvusインスタンスを立ち上げました。
Wikipediaからスクレイピングしたデータを、シンプルな方法でチャンクアップしました。そして、そのチャンクをBentoMLでホストされている埋め込みモデルに渡して、Milvusに入れるベクトル埋め込みを取得しました。すべてのベクトル埋め込みがMilvusに入ったことで、RAGを実行する準備が完全に整った。
今回選んだLLMは、Nous Hermesのfine-tuned Mixtralモデルで、OctoAIで公開されている多くのオープンソースモデルの一つです。RAGを可能にするために2つの関数を作成した。ひとつは質問とコンテキストをLLMであるdoragに渡す関数で、もうひとつはユーザーの質問を埋め込み、Milvusを検索し、質問と一緒に検索結果を元のRAG関数に渡す関数です。最後に、正気度チェックとして簡単な質問でRAGをテストした。
読み続けて
Why Teams Are Migrating from Weaviate to Zilliz Cloud — and How to Do It Seamlessly
Explore how Milvus scales for large datasets and complex queries with advanced features, and discover how to migrate from Weaviate to Zilliz Cloud.
Why Context Engineering Is Becoming the Full Stack of AI Agents
Discover how context engineering unifies prompts, RAG, and tools to build smarter, production-ready AI agents powered by Milvus.
Why AI Databases Don't Need SQL
Whether you like it or not, here's the truth: SQL is destined for decline in the era of AI.