Zilliz Cloud Pipelinesによるメタデータのフィルタリング
よくある質問に、"ベクター・データベースに加えて、通常のSQLデータベースも必要ですか?"というものがある。この質問は、非構造化データに追加情報を含める場合に必要かもしれません。さらに、意味類似性検索を実行する前に、ビジネス目的でデータをフィルタリングすることができます。例えば
法的な文脈では、契約書データベースや特定の契約書からテキストの塊だけを検索する必要があるかもしれません。
小売業では、紳士靴の特定のサイズに絞って検索したいかもしれません。
画像検索では、2010年から2016年に公開された映画のポスターで、IMDBスコアが7.0以上のものを検索したい場合があります。
上の質問に戻りますが、私の答えは "いいえ、Milvusベクターデータベース、またはフルマネージドMilvusのZilliz Cloudを使用する場合、それを心配する必要はありません。"です。Milvusを使えば、ベクトル検索とスカラー検索のハイブリッド検索を行うことができ、より精度の高い検索を行うことができます。
以下では、スカラー検索やメタデータフィルタリング、Zilliz Cloudでのメタデータフィルタリングについて説明します。このブログはたった5分でRAGを使い始めるという前回のブログの続きです。そのコードはこのノートブックのセル#27までスクロールしてください。
Milvusのメタデータフィルタリングを理解するには?
Milvusのベクトルデータベースでは、boolean式を適用してベクトル検索を行うことができます。属性は、非構造化データを埋め込むベクトル以外のフィールドであれば何でもよい。また、Milvusではメタデータフィルタリングがベクトル検索と共存しています。フィルタ式で埋め込みベクトル以外のフィールドを使用し、vector indexを使用して埋め込みベクトルフィールドを検索することができます。**検索コマンドにフィルタ式を指定すると、Milvusは自動的に両方の処理を行います。
Zilliz Cloudでメタデータフィルタリングを行うには?
手っ取り早く反復処理を始めるために、このガイドではフルマネージドのMilvusであるZilliz Cloud (Free Tier)を使ってみます。これはサーバーレスのクラウドサーバー上でデータベースをホストしますが、PyMilvus APIコールを行うことでローカルでデータベースを操作することができます。また、ビルトイン機能であるZilliz Cloud Pipelinesを使って、非構造化データをベクトル埋め込みにエンコードし、操作を効率化します。
以下のデータはMilvus Documentationのドキュメントページからのものです。
ステップ 1: コレクション(データベーステーブル)とパイプラインの作成
データをS3またはGCSにアップロードする。
https://cloud.zilliz.com/](https://cloud.zilliz.com/) に別のブラウザウィンドウを開き、"Starter" を作成する。クラスターを作成する。
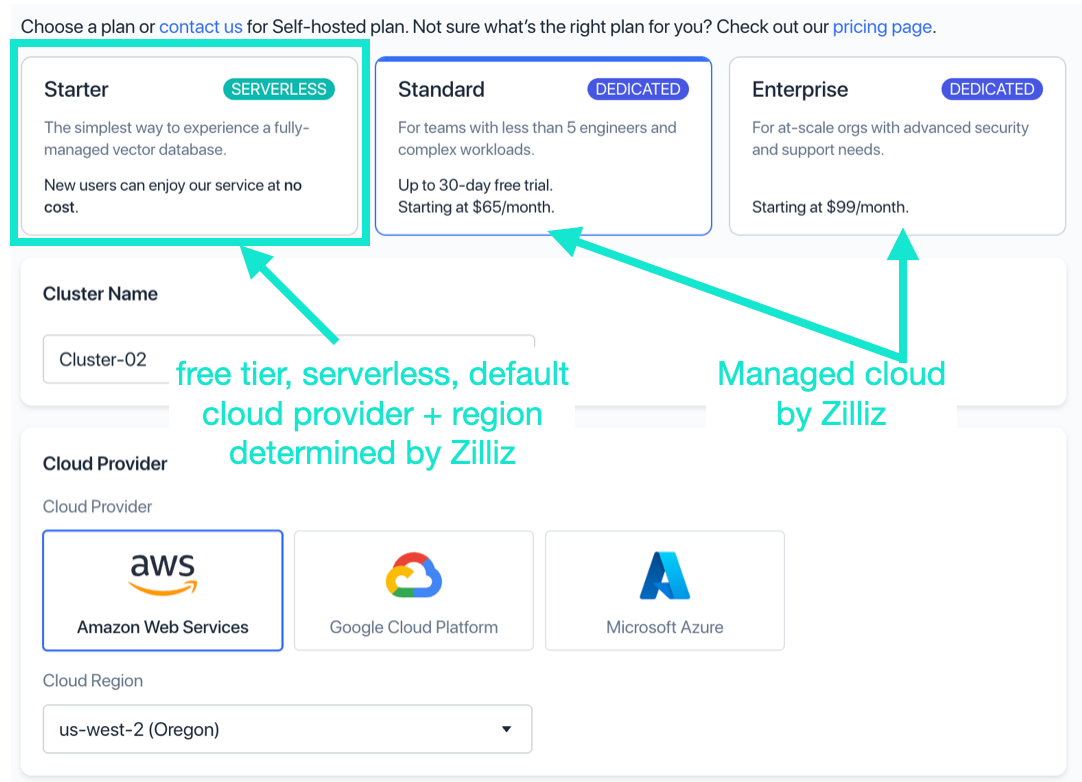
3.コレクション名を追加し、"Create Collection and Cluster "をクリックする。

注意:最初のZilliz Cloudクラスタを作成する際、デフォルトで新しいコレクションも作成されます。Zilliz Cloud Pipelinesを使用する場合は、別の新しいコレクションを作成します。
4.左側のメニューからPipelinesに移動し、ガイドされた手順に従ってデータをアップロードします。
a. "Ingestion Pipeline" から始めます。
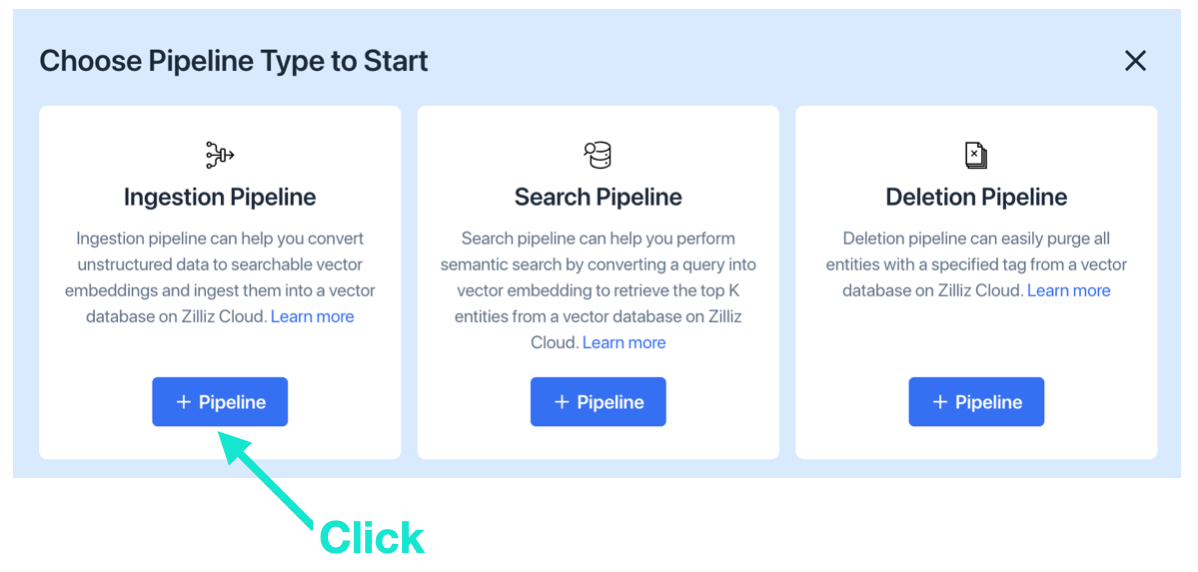
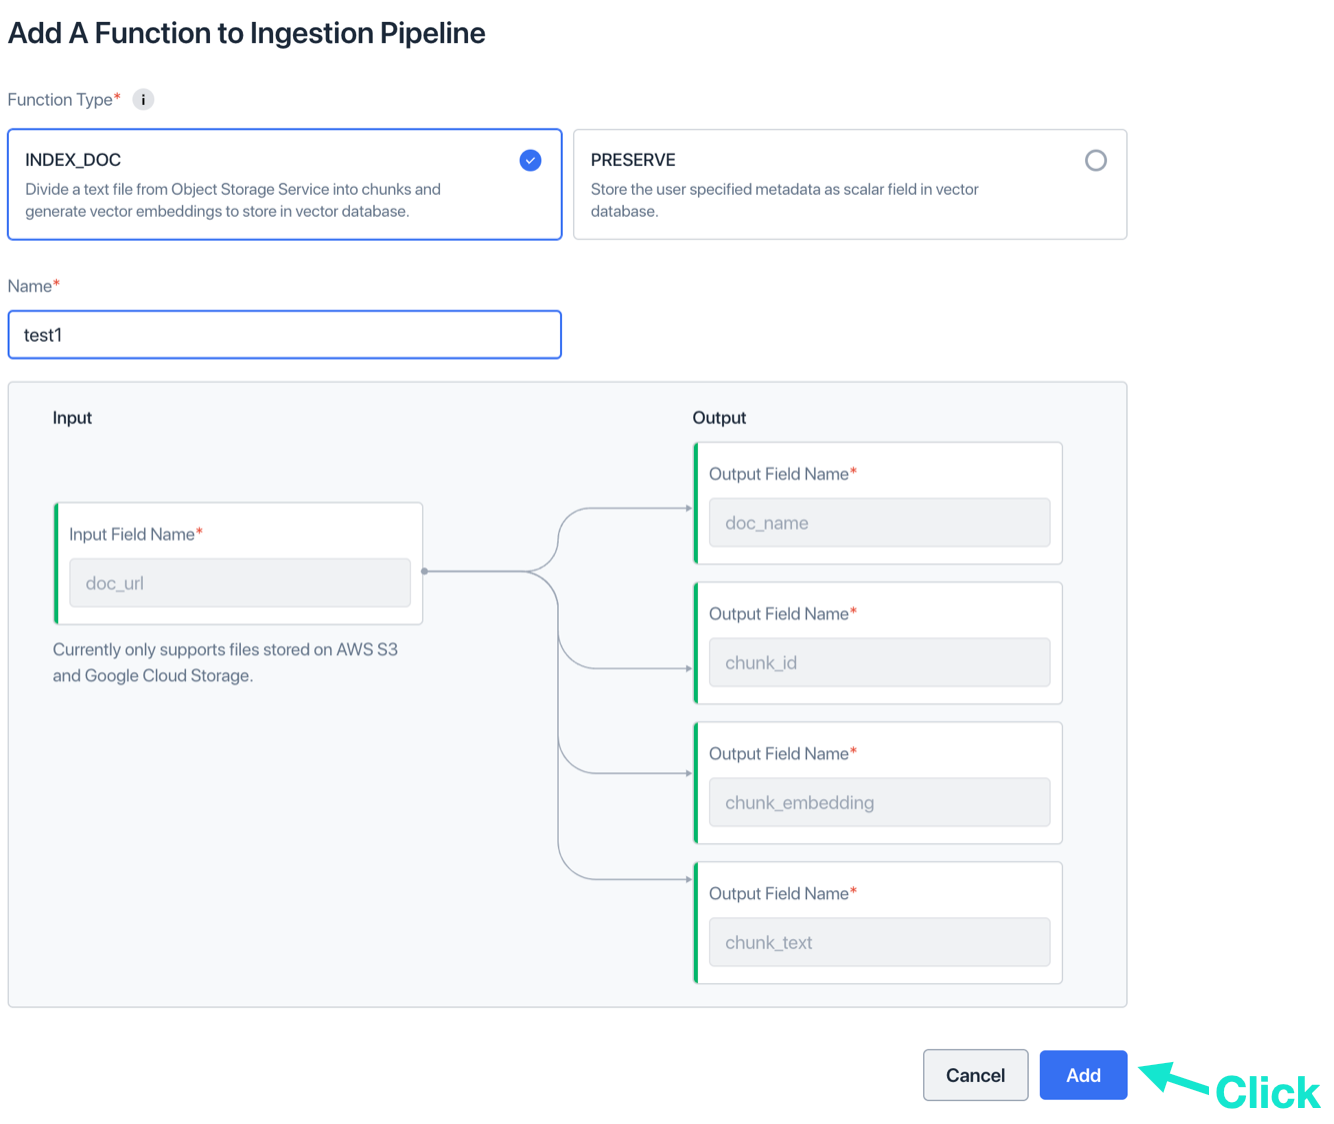
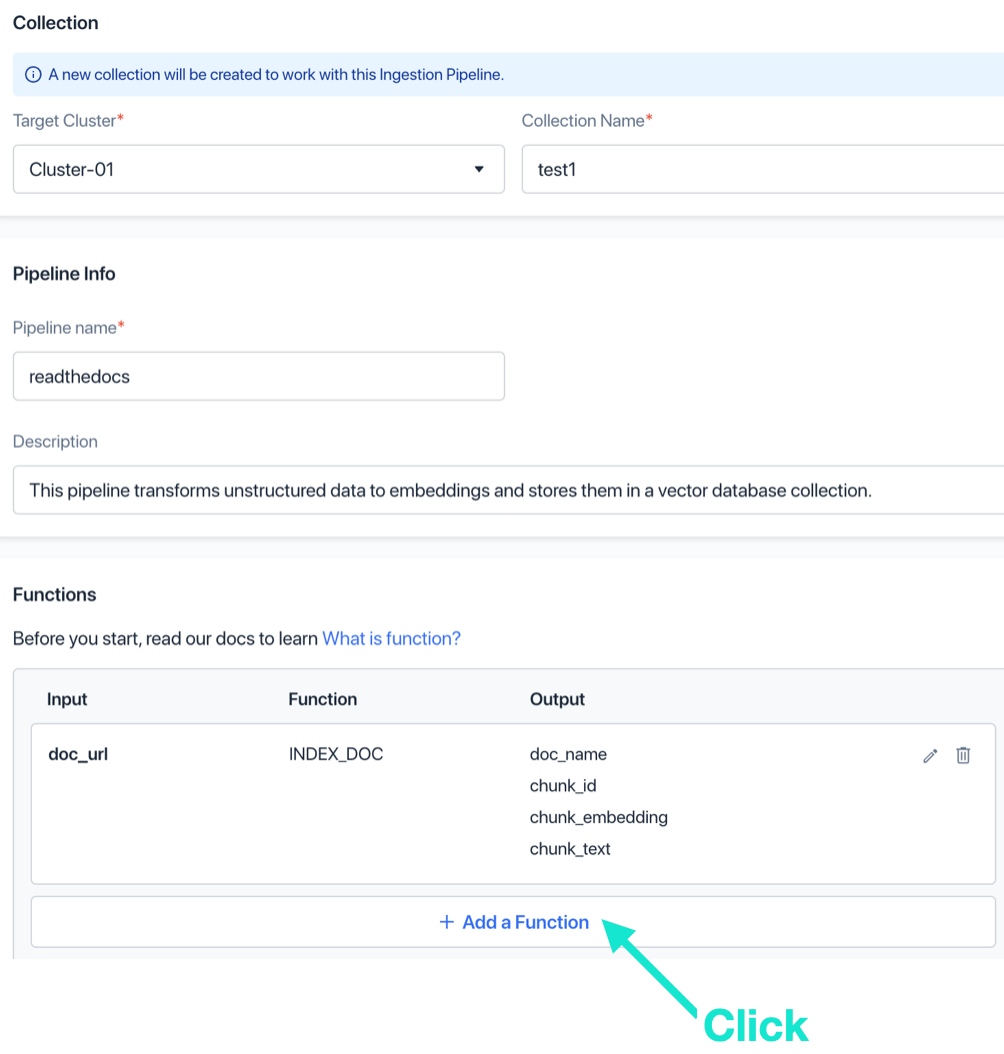
b. クラスタ名を選択し、コレクション名とパイプライン名を追加し、"Add a Function" をクリックします。
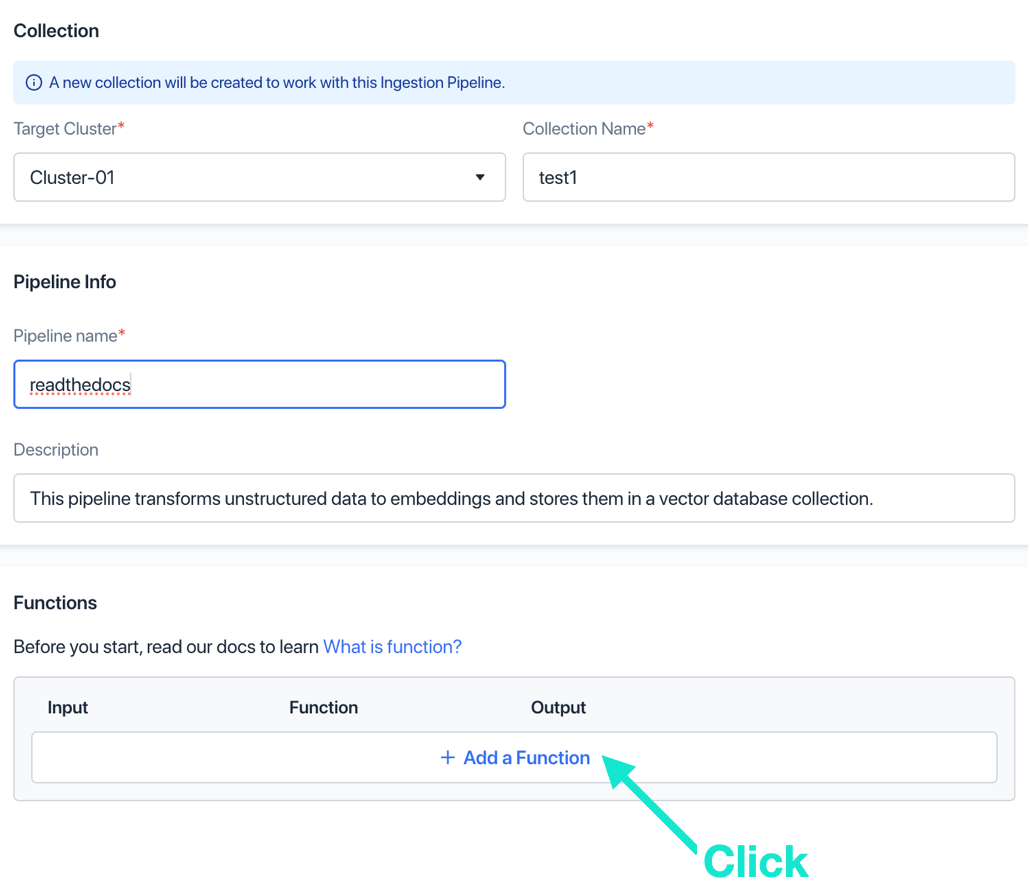
c. 名前を追加し、"Add"をクリックします。パイプラインのこのステップでは、何も変更できません。
d. オプション:再度 "Add a Function"をクリックします。
e. 任意:e オプション: メタデータ・フィールド・ステップ、メタデータ・フィールド、タイプに名前を付ける。Add**"をクリックする。
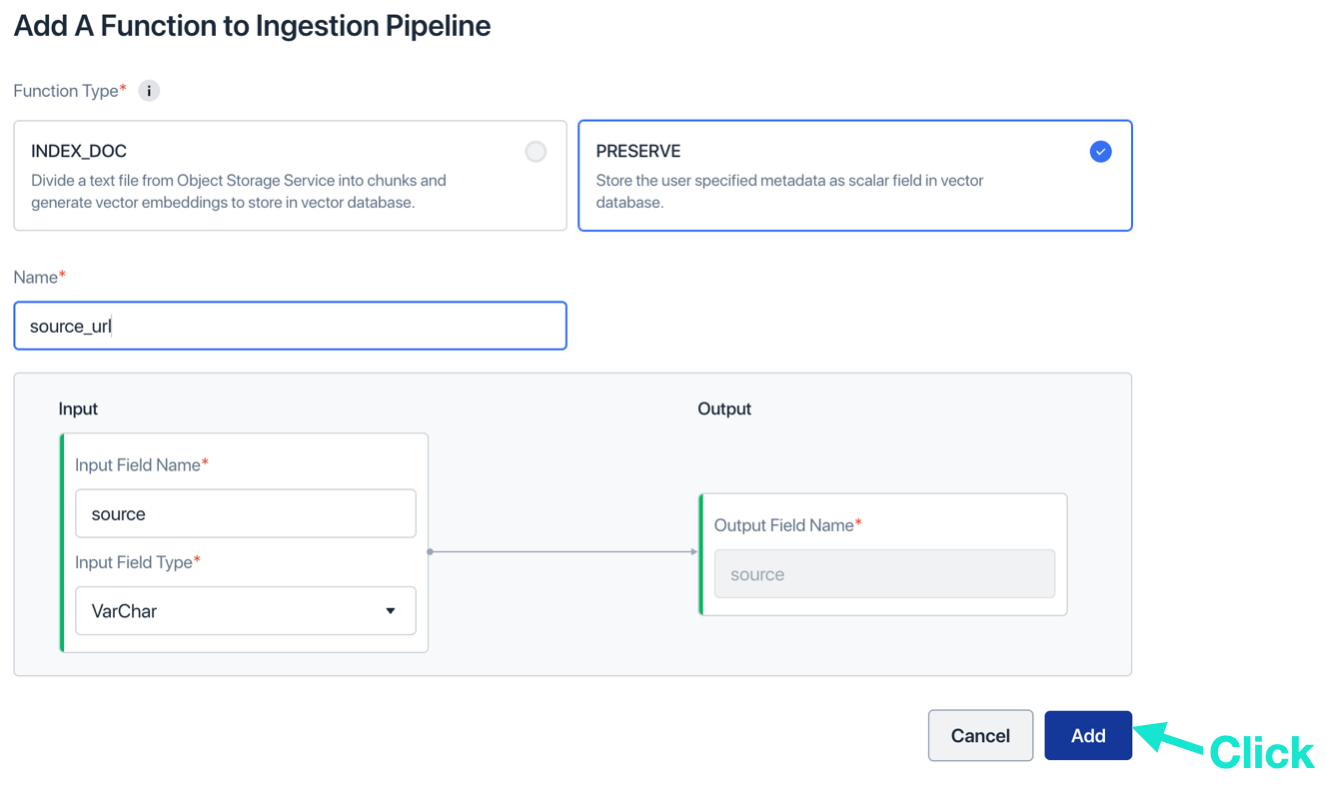
5.Create Ingestion Pipeline**"をクリックします。 これで、新しいIngestion Pipelineと新しいCollectionが作成されました。

Create Deletion and Search Pipelines**"をクリックして、削除パイプラインと検索パイプラインを作成します。
パイプライン "Ingestion"を見つけるには、"Actions "の下にある "Run "アイコンをクリックする。

- データを指定する。AWSでは、最も簡単な方法は一時的な署名済みURLです。共有したいタイミングを選択し、署名済みURLをコピーする。
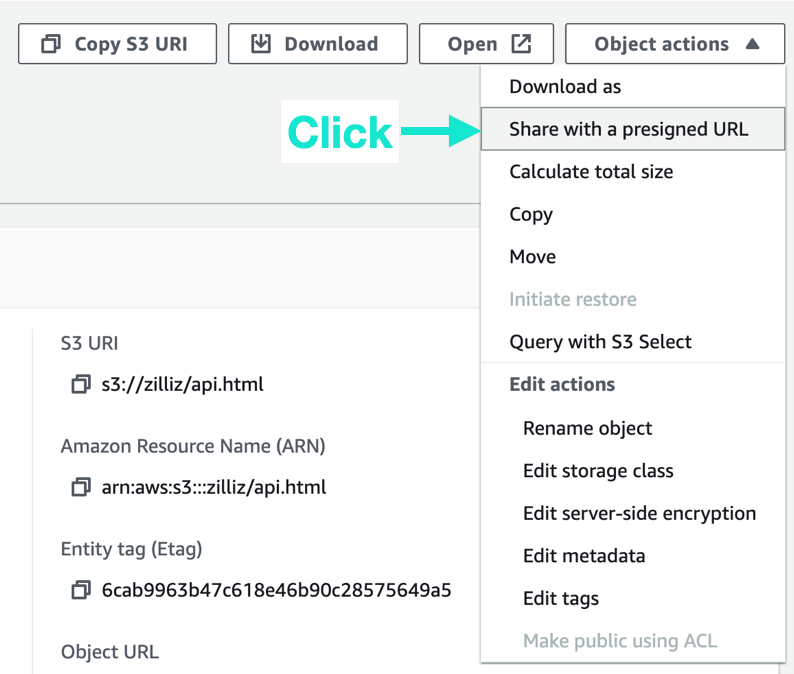
- 署名済みのURLを貼り付け、"Run"をクリックする。
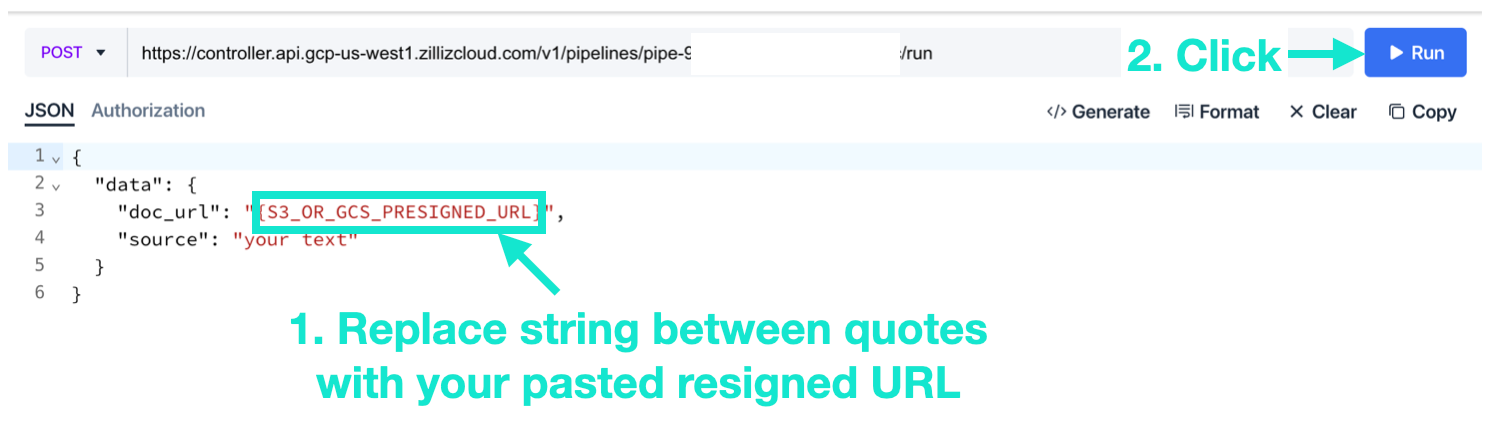
- ブラウザをリフレッシュし、新しいコレクションとスキーマが正しいかどうか確認してください。
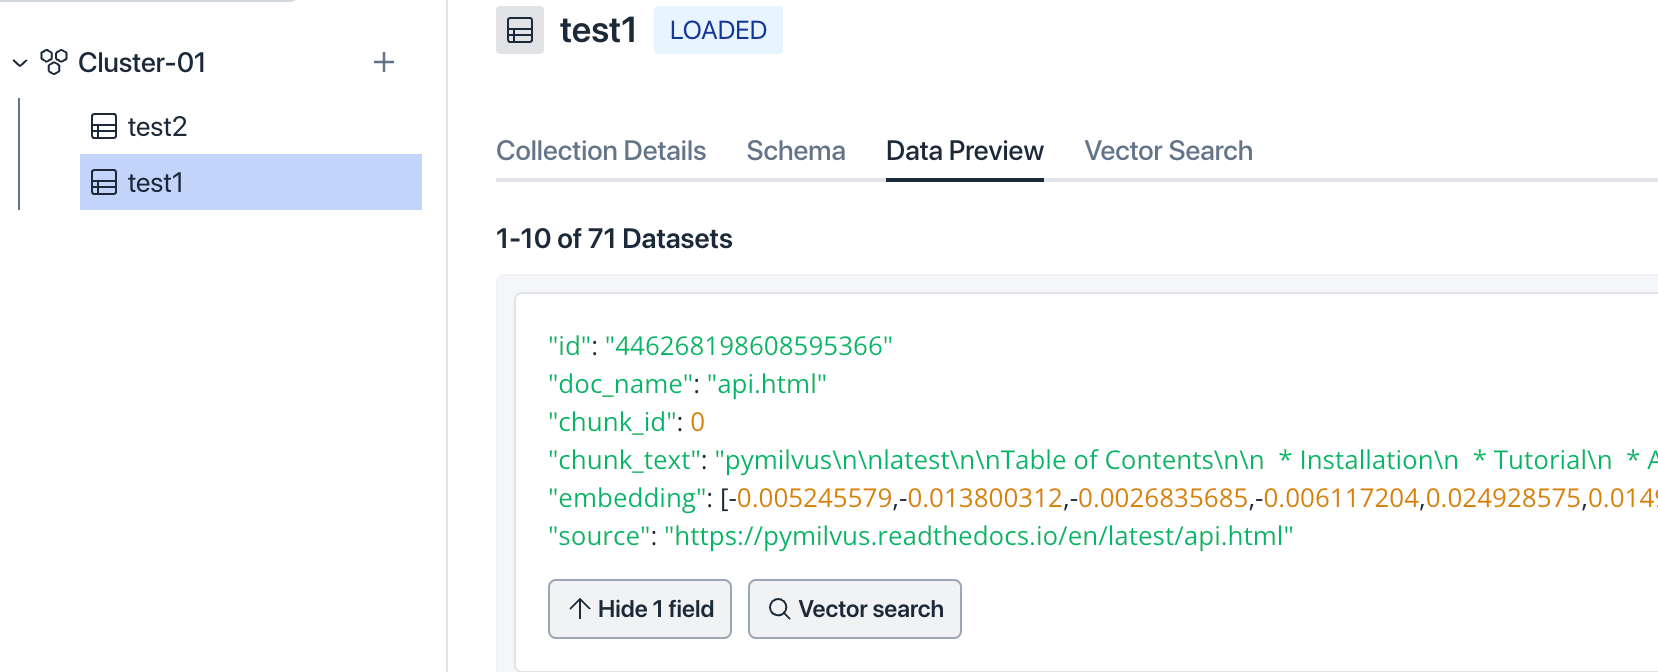
ウェブコンソールまたはAPIコールでクエリを実行します。
ステップ2.ウェブコンソールで検索する
Actions "の下にあるパイプライン "Search"を探し、Runアイコンをクリックします。
UIで質問を入力し、"実行"をクリックします。
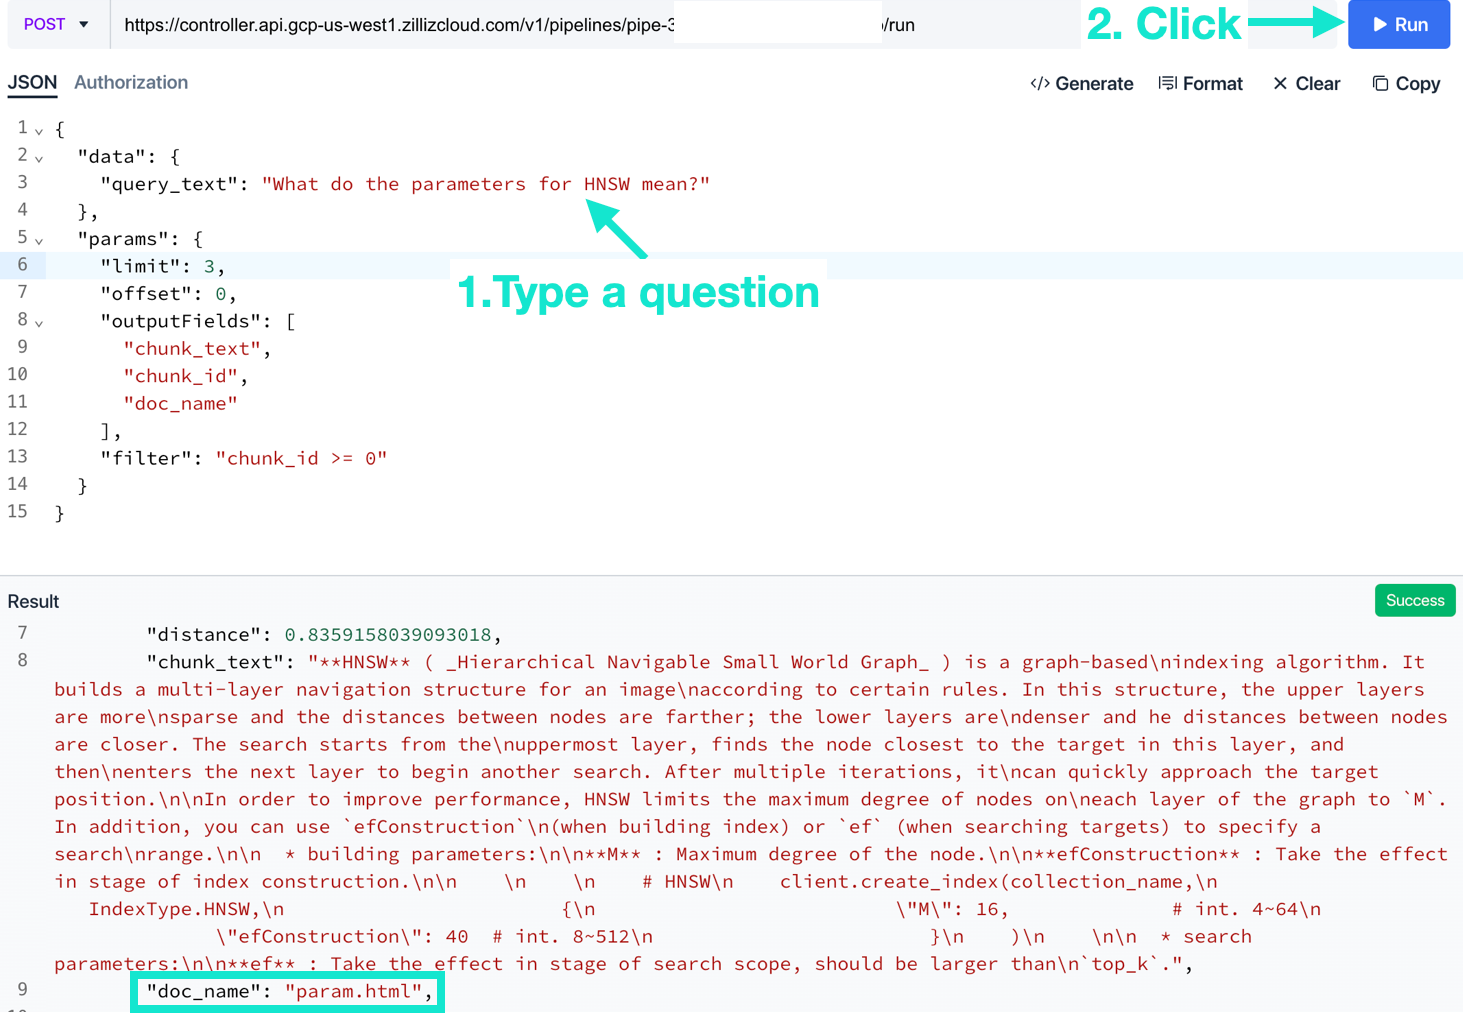
ブーリアン式を使用して「フィルター」を編集します。検索結果にフィルターが適用されたことが確認できるはずです。
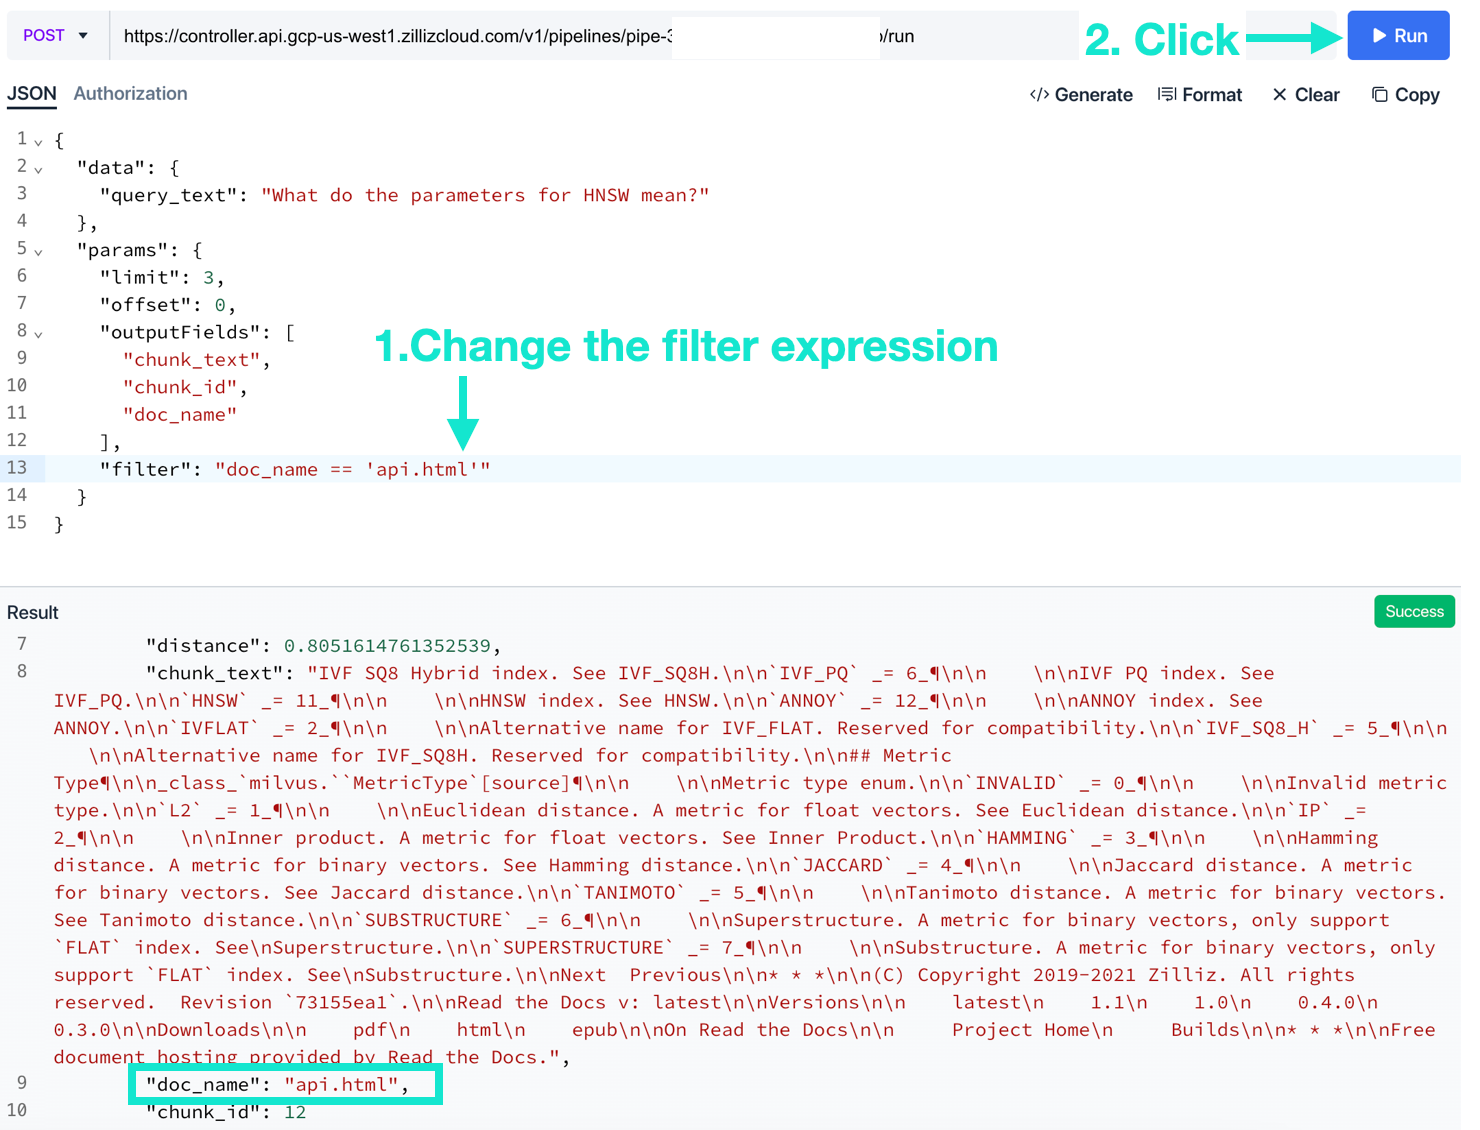
以上である!boolean式](https://milvus.io/docs/boolean.md)を使えば、非構造化データの埋め込みベクトル以外のフィールドをフィルタリングして検索することができます。埋め込みベクトルフィールドは、PipelinesのベクトルインデックスAUTOINDEXを使って検索されます。
また、Pipelinesでは埋め込みベクトルは正規化され、IPと余弦距離 メトリクスが等価に動作します。Pipelinesのデフォルトの埋め込みモデルはbge-large-en-v1.5です。
ステップ3.API経由での検索
APIコールを使って検索することもできる (Pythonコードはこのノートブックにあります; Cell#27までスクロールダウンしてください。)
必要なものは2つ。
Zilliz APIトークン
パイプラインID
APIトークンはクラスタのメイン画面から取得できます。
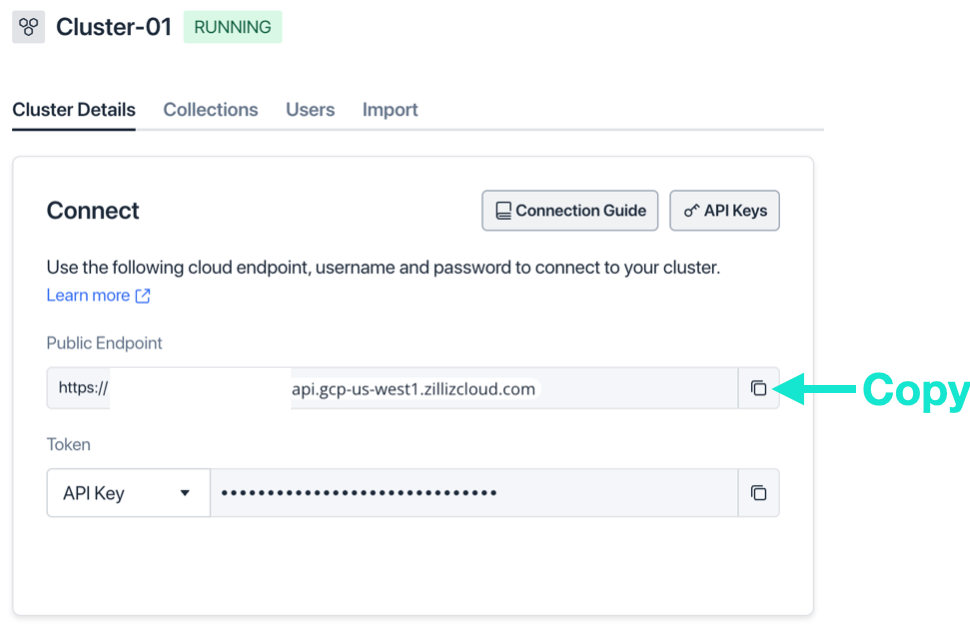
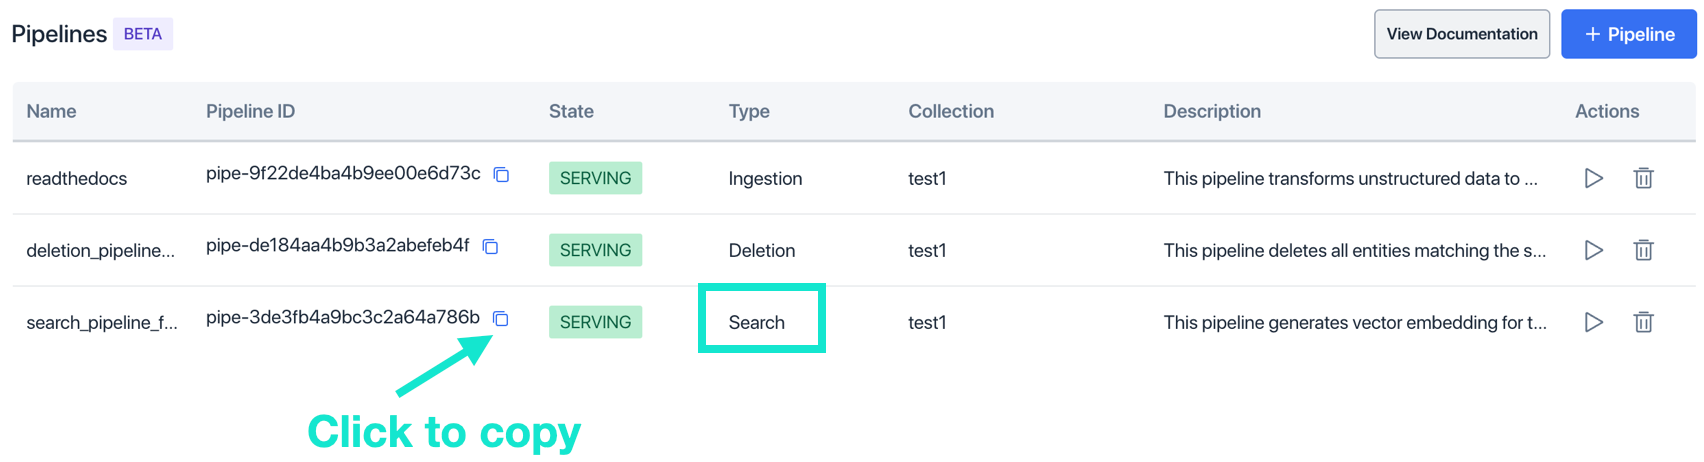
パイプラインIDを取得するには、パイプラインの "Search"を見つけ、"Pipeline-ID"列を探し、コピーアイコンをクリックします。**APIコールのURLにパイプラインIDを貼り付けます。
インポート リクエスト, json


url = "https://controller.api.gcp-us-west1.zillizcloud.com/v1/pipelines/pipe-xxxx/run"
ヘッダー = {
    "Content-Type":"application/json"、
    "Authorization": f "ベアラ{TOKEN}"、
}
data = {
    "data":{
        "query_text":サンプル質問
    },
    "params":{
        "limit":TOP_K、
        "オフセット":0,
      # これらのフィールドのいずれかをフィルター式で使用することができる。
        "outputFields":["chunk_text", "chunk_id", "doc_name", "source"]、
        "filter":"doc_name == 'param.html'"
    }
}


# POSTリクエストを送信する
response = requests.post(url, headers=headers, json=data)
以上です!これで、API経由でZilliz Cloudのフィルタ検索を実行する方法を学びました。
まとめ
SQLデータベースでデータを結合してSQLクエリを実行するように、メタデータフィルタリングによりMilvusやZilliz Cloudでベクトル検索とスカラー検索のハイブリッド検索を行うことができます。スカラーフィールドまたは主キーフィールドをフィルタリングする論理式を指定することで、特定の条件で検索を制限することができます。埋め込みベクトル以外の任意のフィールドをフィルタ式に使用し、ベクトルインデックスを使用して埋め込みベクトルフィールドを検索することができます。MilvusまたはZilliz Cloudは、検索コマンドにフィルタ式を指定すると、自動的に両方の処理を行います。
このデモのコード](https://github.com/milvus-io/bootcamp/blob/master/bootcamp/RAG/readthedocs_zilliz_langchain.ipynb)はこのノートブックのCell#27までスクロールしてください。試してみてください。
読み続けて
Introducing Zilliz Cloud Global Cluster: Region-Level Resilience for Mission-Critical AI
Zilliz Cloud Global Cluster delivers multi-region resilience, automatic failover, and fast global AI search with built-in security and compliance.
What is the K-Nearest Neighbors (KNN) Algorithm in Machine Learning?
KNN is a supervised machine learning technique and algorithm for classification and regression. This post is the ultimate guide to KNN.
DeepSeek Always Busy? Deploy It Locally with Milvus in Just 10 Minutes—No More Waiting!
Learn how to set up DeepSeek-R1 on your local machine using Ollama, AnythingLLM, and Milvus in just 10 minutes. Bypass busy servers and enhance AI responses with custom data.