




ミルバス接続を始める
Milvusは、非構造化データを埋め込んでAIアプリケーションを構築するためのオープンソースのベクトルデータベースです。使い始めるために必要なものはすべて組み込まれており、ローカルマシンまたはZillizクラウドで動作します(ノートブックZilliz Free Tierに接続するを参照)。
Milvusには4つのSDKがあります:Java、Python、React、Rubyです。以下では、Pythonの手順を紹介する。
Milvusサーバをインストールし、起動する。
pip install milvus pymilvus #pymilvus は python sdk です。

from milvus import default_server
default_server.start()
注意: Zillizに接続している場合は、Milvusのインストールを省略してコンソールからクラスタを起動することができます。
2.## Milvus クライアントの取得 (接続)
from pymilvus import connections

connections.connect(
   host='127.0.0.1'、
   port=default_server.listen_port)
注: ローカルホストではなく、Zilliz Cloud上で動作するサーバーレスMilvusに接続するには、コンソールからエンドポイントのuriとtokenを取得する必要があります。
from pymilvus import connections

ENDPOINT="https://endpoint.api.region.zillizcloud.com:443"
connections.connect(
   uri=ENDPOINT、
   token=TOKEN)
3.## コレクションを作成する コレクションはデータベースのテーブルのように考えることができます。コレクションにはエンベッディング、ドキュメント、その他のメタデータが格納されます。
コレクションには、スキーマとインデックスが関連付けられます。
インデックスはベクトル検索アルゴリズムとベクトル類似度メトリックを使用して構築される。Milvusのデフォルトを使用することができます。 しかし、最適なパフォーマンスを得るためには、パラメータを設定する必要があります。検索インデックスとパラメータの選択はデータによって異なります。検索インデックスの選択についてはこちらのベストプラクティスガイドを参照してください。このノートでは、パラメータの変更方法を示します。
from pymilvus import (
   FieldSchema, DataType、
   コレクションスキーマ, コレクション)

## 1.最小限の拡張可能なスキーマを定義する。
fields = [
   FieldSchema("pk", DataType.INT64, is_primary=True, auto_id=True)、
   FieldSchema("vector", DataType.FLOAT_VECTOR, dim=768)、
]
schema = CollectionSchema(
   fields、
   enable_dynamic_field=True、
)

## 2.コレクションを作成する。
mc = Collection("my_collection_name", schema)

## 3.コレクションにインデックスを付ける。
mc.create_index(
   field_name="vector"、
   index_params={
       "index_type":"AUTOINDEX"、
       "Metric_type":"COSINE"、
       }
4.## データをMilvusに挿入する すでに非構造化データから埋め込みデータを生成している場合は、それを読み込むことができます。
入力データはpandas dataframeまたは辞書のリストです。ベクトル埋め込みが含まれていなければなりません。残りのフィールドはオプションです:元のテキストチャンクとメタデータフィールドです。
from pymilvus import connections

## 1.入力データはpandas dataframeかdictsのリスト。
data_rows = [].
data_rows.extend([
   {"vector": np.random.randn(768).tolist()、
    "text":"これは文書です、
    "source":"source_url_1"}、
   {"vector": np.random.randn(768).tolist()、
    "text":"これは別の文書です、
    "source":「source_url_2"}、
])

## 2.milvusにデータを挿入する。
mc.insert(data_rows)
mc.flush()
5.## コレクションをクエリする データベースにロードされた非構造化データを埋め込むために使用されたのと同じモデルを使用して、質問を埋め込む必要があります。Milvusのデフォルト検索パラメータ**を使用して、質問埋め込みを使用してコレクションをクエリできます。同じベストプラクティスが、最適なパフォーマンスを得るための正しい検索インデックスの選択にも適用されます。
以下では、Milvusはtop_k = 3最も類似した結果を返します。また、オリジナルのテキストチャンクとメタデータが返されることに注目してください。これはgrounding(幻覚を減らすために、生成されたテキストを事実に基づいた情報にすること)に役立ちます。
## 1.埋め込んだ質問に対する答えを検索する。
mc.load()
results = mc.search(
   data=encoder(["my_question_1"])、
   anns_field="vector"、
   output_fields-["text", "source"], #オプションのリターンフィールド
   limit=3、
   param={}, #milvusのデフォルトを使用する場合はパラメータは不要です。
)

## 2.答えを見る
for n, hits in enumerate(results):
   print(f"{n} 番目の結果:")
   for hit in hits:
      print(hit)
次のブログでは、LangChainとMilvusを使ってチャットボットを作る方法を紹介します。ご期待ください。
MilvusとZillizを始めるためのその他のリソース
ベクターデータベース101ブログシリーズ](https://zilliz.com/learn/what-is-vector-database)
ユースケースに適したベクターデータベースを見つけるためのベンチマーク](https://zilliz.com/learn/open-source-vector-database-benchmarking-your-way)
Zilliz統合ハブ](https://zilliz.com/product/integrations)
GPTCacheを使った100倍速いレスポンスとコスト削減](https://zilliz.com/blog/building-llm-apps-100x-faster-responses-drastic-cost-reduction-using-gptcache)
NVIDIA MerlinとMilvusを使用したレコメンダーワークフロー](https://zilliz.com/blog/efficient-vector-similarity-search-recommender-workflows-using-milvus-nvidia-merlin)
リアルタイムAIのためのKafkaコネクタ](https://zilliz.com/blog/announce-confluent-kafka-connector-for-Milvus-and-Zilliz-unlock-power-of-real-time-ai)
読み続けて
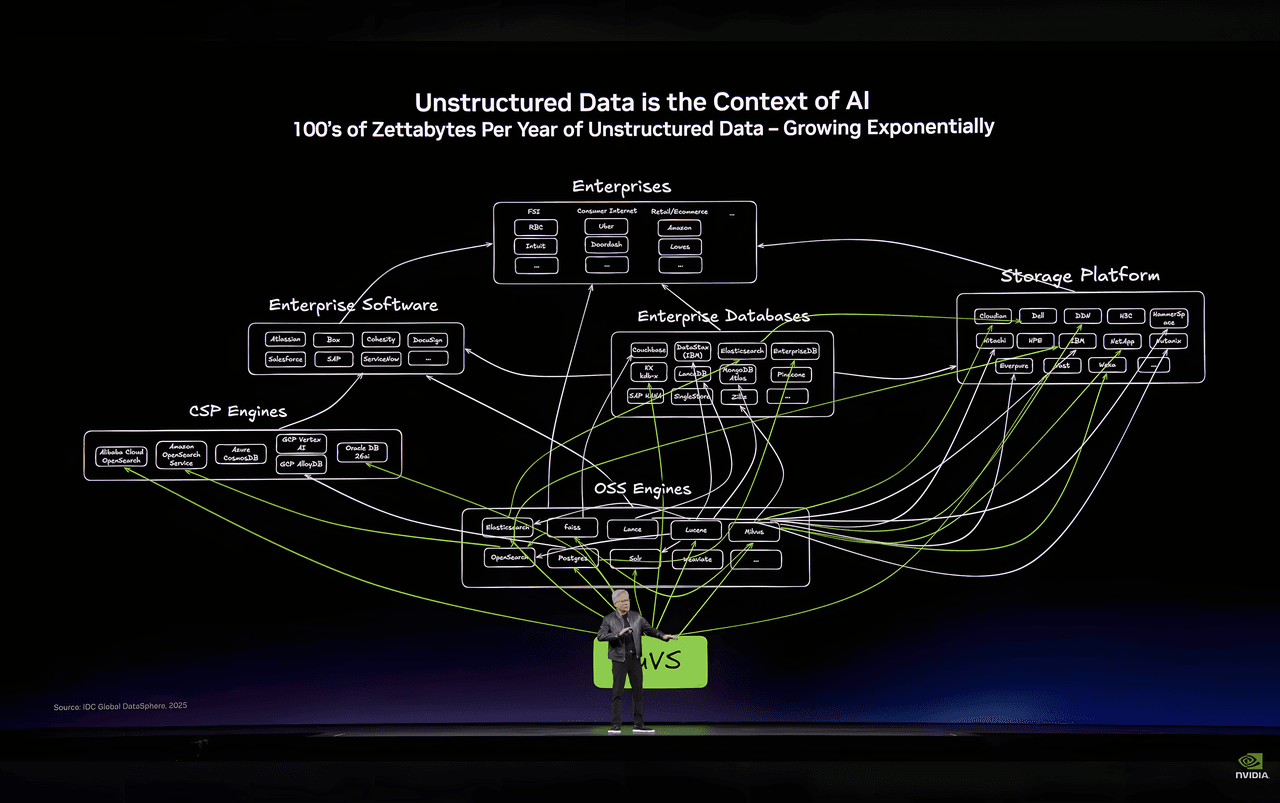
How Zilliz Ended Up at the Center of NVIDIA’s Unstructured Data Story at GTC 2026
If unstructured data is the context of AI, then the ceiling of AI applications will be set not just by models, but by how mature the infrastructure for unstructured data becomes.
Zilliz Cloud BYOC Now Available Across AWS, GCP, and Azure
Zilliz Cloud BYOC is now generally available on all three major clouds. Deploy fully managed vector search in your own AWS, GCP, or Azure account — your data never leaves your VPC.
Introducing DeepSearcher: A Local Open Source Deep Research
In contrast to OpenAI’s Deep Research, this example ran locally, using only open-source models and tools like Milvus and LangChain.