




Milvusの行レベルRBACによるきめ細かなアクセス制御の実現
なぜ現代のデータシステムではアクセス制御が重要なのか
アクセス・コントロールは、特に企業にとって、現代のデータ管理における最も差し迫った課題の一つである。組織が成長するにつれ、特に複数の部門や役割が存在する環境では、強固なセキュリティとシームレスなアクセスの両方が重要になります。アクセス制御が特に重要な2つの例を見てみましょう。
ヘルスケアプライバシーとコラボレーションのバランス
ヘルスケア分野では、医療従事者間のコラボレーションを促進しながら、患者のプライバシーを保護する必要があります。正確な診断と治療計画を立てるために、患者の医療記録に完全にアクセスする必要がある医師を想像してみてください。しかし、その医師は、自分が治療していない患者の記録にアクセスできるべきではありません。このニーズを満たすには、きめ細かなアクセス制御が不可欠であり、権限を与えられた医療スタッフだけが患者の機密データを閲覧できるようにします。このレベルの制御は、組織がプライバシーを保護しながら、HIPAAのような厳しい規制に準拠するのに役立ちます。
ファイナンス機密データの保護
金融業界もアクセス・コントロールに関しては同様の課題に直面している。銀行や金融機関は大量の機密データ-口座詳細、取引履歴、クレジットスコアなど-を扱っている。このデータはしばしばベクトルに変換され、不正検知、リスク分析、パーソナライズされた顧客体験のためにMilvusのようなベクトルデータベースに保存されます。適切なアクセス制御を行わないと、機密データが権限のない第三者に漏洩し、財務上および法律上の重大な結果を招く可能性がある。
例えば、顧客管理者は自分の顧客の口座データにしかアクセスできない。リスク管理チームが必要とする広範なアクセスも、悪用を防ぐために注意深く監視し、制限することができる。
Milvus行レベルRBAC:きめ細かなアクセス制御ソリューション
役割ベースのアクセス制御(RBAC)は、組織内でのユーザーの役割に基づいてリソースへのアクセスを許可するセキュリティモデルです。ロールが権限を定義し、ユーザーがその権限を継承することで、アクセス権の安全かつ効率的な管理を実現します。
Milvus**は、スケールのために構築されたオープンソースの高性能ベクトル・データベースである。検索拡張生成(RAG)](https://zilliz.com/learn/Retrieval-Augmented-Generation)、セマンティック検索エンジン、推薦システム、チャットボットなどのモデルAIアプリケーションの構築に最適です。Milvusは、ビットマップインデキシングを使用して行レベルのアクセス制御を可能にするパーミッションモデルに基づく、きめ細かなRBACソリューションを提供します。この機能により、ユーザ役割と権限に基づいて、特定のMilvusリソースへのアクセスと権限を制御することができます。現在、Milvus RBACはPythonとJavaでのみ利用可能です。
Milvus RBACにはいくつかの利点があります:
スピードと効率性: 大規模なデータセットのパーミッションを高速にクエリすることができます。
柔軟性:**役割や責任が進化しても適応し、パーミッションが最新の状態に保たれます。
RBAC の基礎
役割と権限
ロール**:各ロールには特定の権限セットが割り当てられています。
パーミッション:Permission:Milvus内のデータ接続(テーブル)内の個々の行に対するアクセス権(特定のデータの読み取り、書き込み、削除など)を指定します。
ビットマップインデックスビルディング
ビットマップインデックスはこのアクセス制御機構の基礎となるものです:
各ロールは、アクセス可能な行を示すビットマップに関連付けられています。
ビットマップの長さは接続の行数と一致します:
ある位置の1は、そのロールがその行にアクセスできることを意味します。
0**はアクセスがないことを意味します。
ビットマップインデックスの使用法
権限の付与**:ロールに行へのアクセス権を与えるには、ロールのビットマップの対応するビットを 1 に設定します。
権限のチェック:ロールが特定の行にアクセスできるかどうかを確認するには、ビットマップの対応するビットが1**であるかどうかを確認するだけです。
例えば、企業知識を格納するコレクションAという接続(テーブル)があるとします。各行はdoc_idとそれに関連する知識ベースkb_idで識別されるコンテンツを表しています。
| 行ID|PK|データ|doc_id|kb_id|役割 | ------ | -- | ------ | ------- | ------ | ----- | | 1|0|データA|1|1|role1 | 2|1|データB|1|1|role1
| 4|3|データD|2|1|role1|データD | 5|4|データE|3|2|role2|(ロール2
役割は以下のように定義される:
役割1**:1行目、2行目、3行目、4行目にアクセスできます(
kb_id = 1)。ロール2**:行5(
kb_id = 2)にアクセスできる:5行目(kb_id = 2)にアクセスできる。
クエリ操作
ユーザがデータを照会する場合、そのロールのビットマップと照会条件が組み合わされ、アクセス権限のある行がフィルタリングされます。例えば、ロール1を持つユーザが "すべてのデータ "をクエリした場合、そのビットマップ11110は1~4行目(データA、データB、データC、データD)を返します。
権限の更新
ロールのアクセス権を追加または削除するには、ロールのビットマップの対応するビットを更新するだけです。例えば、ビットを1に設定するとアクセスが許可され、0に設定するとアクセスが取り消されます。
利点と考慮事項
効率性**:ビットマップ操作は高速で、大きなデータセットのパーミッション管理に適している。
低いストレージ・オーバーヘッド**:ビットマップは、数百万行のデータセットであっても、最小限のストレージしか消費しません。
柔軟性**:ビットマップインデックスは複雑なクエリ条件や組み合わせをサポートし、様々なユースケースに高度に適応します。
Milvus行レベルRBACのデモンストレーション
このセクションでは、Milvusが大企業の様々な知識ベースへのアクセスをどのように管理しているかをデモします。
ユースケース複数の知識ベースを持つエンタープライズRAG
ある大企業では、Milvusを利用したRAGアプリケーションのために、異なる部門が別々のナレッジベース(公開ベースもあれば機密ベースもある)を保持していることがよくあります。これらのナレッジベースにまたがるパーミッションを効果的に管理するために、私たちはエンティティまたはドキュメントに基づくロールベースのアクセス制御(RBAC)を実装します。例えば、スーパー管理者ロール(admin)がアクセスを監督し、CEO、財務、営業、開発者といった特定のビジネスユニットのロールが追加され、それぞれが異なるデータセットにアクセスできる。
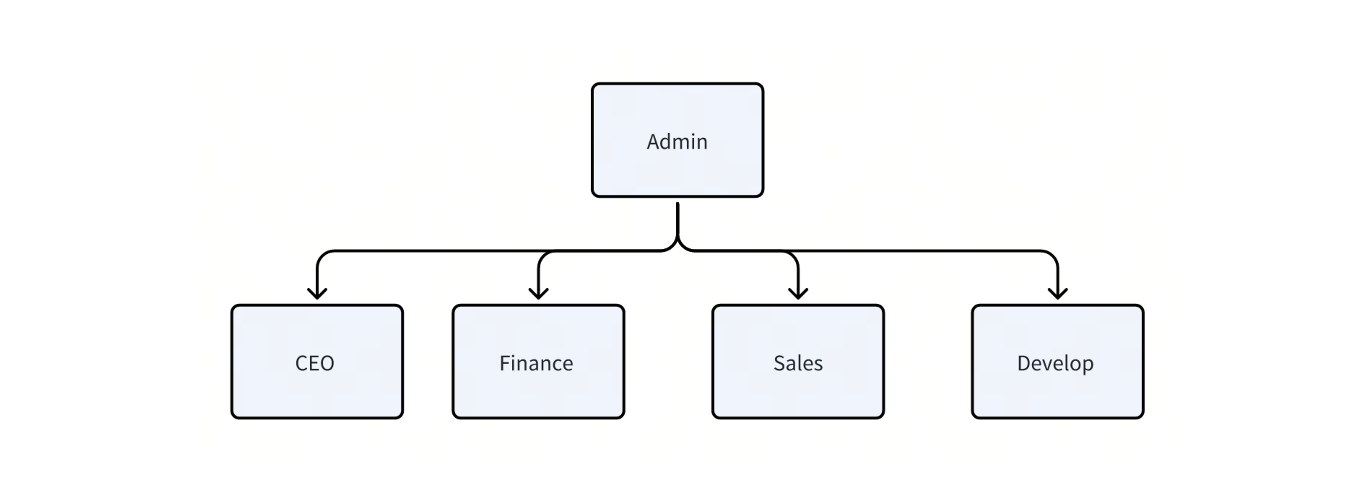
図:大企業におけるさまざまなロールのアクセス制御
権限カラムの定義
アクセスを管理するために、Milvusではパーミッションデータを配列カラムに格納します。このカラムはどのロールがどのデータ行にアクセスできるかを定義します。このパーミッションカラムのfield_nameはカスタマイズ可能であり、配列のサイズはユーザの必要に応じて調整することができます。このカラムにはBITMAPインデックスが作成され、権限チェックを効率的に行うことができます。
以下は、このセットアップがコードでどのように行われるかである:
# 1.Milvusクライアントをセットアップする
クライアント = MilvusClient(
    uri=CLUSTER_ENDPOINT
)

# 2.コレクションを作成する
schema = MilvusClient.create_schema(
    auto_id=False、
    enable_dynamic_field=False、
)

# スキーマの定義
schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True)
schema.add_field(field_name="data", datatype=DataType.VARCHAR, max_length=100)
schema.add_field(field_name="vector", datatype=DataType.FLOAT_VECTOR, dim=128)

# セキュリティ・カラムの追加
schema.add_field(field_name="security_group", datatype=DataType.ARRAY、
                 element_type=DataType.VARCHAR, max_capacity=10, max_length=100)

index_params = MilvusClient.prepare_index_params()
index_params.add_index(
    フィールド名="vector"、
    index_type="IVF_FLAT"、
    metric_type="L2"、
    params={"nlist":1024}
)

# セキュリティ・カラム用のビットマップ・インデックスを作成する。
index_params.add_index(field_name="security_group"、
                       index_type="BITMAP")

# 6. コレクションの作成
client.create_collection(
    コレクション名="test_collection"、
    schema=schema、
    index_params=index_params
)
書き込み許可
新しいデータを挿入する際には、各行にアクセスできるロールを指定して権限を割り当てます。これは、security_groupカラムに対応するロールを記述することで行うことができます。
以下にその例を示します:
data =[]
data.append({
        "id": random.randint(0, 100000)、
        "vector":[ random.uniform(-1, 1) for _ in range(128) ]、
        "data":"data" + str(random.randint(0,100000))、
       # ceoロールは読むことができる
      "security_group":["ceo"]。
})

data.append({
        "id": random.randint(0, 100000)、
        "vector":[ random.uniform(-1, 1) for _ in range(128) ]、
        "data":"data" + str(random.randint(0,100000))、
        # ファイナンス・ロールは読むことができる
       "security_group":security_group": ["finance"].
})

data.append({
        "id": random.randint(0, 100000)、
        "vector":[ random.uniform(-1, 1) for _ in range(128) ]、
        "data":"data" + str(random.randint(0,100000))、
        # 営業と開発者の両方が読むことができる
      「security_group":セキュリティ・グループ": ["sales", "finance]
})

res = client.insert(collection_name="test_collection", data=data)
クエリー許可
検索やクエリ操作を行う場合、ユーザーの特定のロールがアクセスできるデータのみを表示するように結果を制限することが不可欠です。ユーザの許可されたロール以外のデータは、クエリ結果から非表示になります。この方法を以下に示します:
ロールの権限に基づくデータの照会」を参照してください。
以下の例では、array_contains()関数を使用して、ロール固有の権限に基づいてデータをフィルタリングしています。それぞれのクエリは、与えられたロールが見ることを許可されているデータのみを取得します。
res = client.query(
    コレクション名="test_collection"、
  # CEOロールにのみ表示されるクエリデータ
   filter='array_contains(security_group, "ceo")'、
    output_fields=["id", "data", "security_group"]、
)
print("ceo role read:")
print(res)

res = client.query(
    collection_name="test_collection"、
   # Salesロールにのみ見えるデータをクエリする
   filter='array_contains(security_group, "sales")'、
    output_fields=["id", "data", "security_group"]、
)
print("セールス・ロールを読み込みました:")
print(res)

res = client.query(
    collection_name="test_collection"、
    # Developerロールにのみ表示されるクエリデータ
    filter='array_contains(security_group, "develop")'、
    output_fields=["id", "data", "security_group"]、
)
print("developer role read:")
print(res)

res = client.query(
    collection_name="test_collection"、
  # DeveloperロールまたはCEOロールのどちらかが閲覧可能なデータをクエリする
   filter='array_contains_any(security_group, ["develop", "ceo"])'、
    output_fields=["id", "data", "security_group"]、
)
print("developer or ceo role read:")
print(res)
出力の例を以下に示す:
ceo role read:
データ[
"{'security_group':'security_group': ['ceo'], 'id':3443, 'data': 'data35077'}"、
"{'security_group':'security_group': ['ceo'], 'id':12181, 'data': 'data99090'}"、
"{'security_group':['ceo']、'id':16551, 'data': 'data74619'}"、
"{'security_group':['ceo'], 'id': 24466, 'data': 'data1373'}", ...
販売ロールの読み取り:
データ:[
"{'data': 'data75305', 'security_group':'data': 'data75305', 'security_group': ['sales'], 'id': 9122}"、
"{'data': 'data61054', 'security_group':'data': 'data61054', 'security_group': ['sales'], 'id': 20087}"、
"{'data': 'data47948', 'security_group':'data': 'data47948', 'security_group': ['sales', 'develop'], 'id': 21726}"、
"{'data': 'data8596', 'security_group':['sales'], 'id':40090}", ...
開発者ロールの読み取り:
データ:[
"{'data': 'data1515', 'security_group':'data': 'data1515', 'security_group': ['develop'], 'id':6429}",
"{'data': 'data47031', 'security_group':'data': 'data47031', 'security_group': ['develop'], 'id':10953}",
"{'data': 'data47948', 'security_group':'data': 'data47948', 'security_group': ['sales', 'develop'], 'id': 21726}"、
"{'data': 'data86894', 'security_group':['develop'], 'id':56980}"], ...
developerまたはceoのロールを読み込む:
データ:[
"{'data': 'data35077', 'security_group':['ceo']、'id':3443}",
 "{'data': 'data1515', 'security_group':'data': 'data1515', 'security_group': ['develop'], 'id':6429}",
 "{'data': 'data47031', 'security_group':'data': 'data47031', 'security_group': ['develop'], 'id':10953}",
 "{'data': 'data99090', 'security_group':'security_group': ['ceo'], 'id':12181}", ...
このアプローチでは、各ロールが許可されていないデータを隠しつつ、閲覧許可されているデータを正確に見ることができます。また、複数のロールを security_group 配列にスタックすることもでき、柔軟で効率的な権限管理を行うことができます。
**ロールベースアクセスによるカスタムフィルタ
データを照会する際に、ユーザがカスタムフィルタを適用する必要がある場合があります。これらのフィルタをロールベースアクセスと組み合わせることで、検索を絞り込むことができます。ロールベースのアクセス制御とカスタムフィルタ条件を適用することで、ユーザがロールと特定のクエリ条件の両方に基づいて、閲覧を許可されたデータのみを取得できるようにすることができます。
例えば
res = client.query(
    コレクション名="test_collection"、
   # 営業ロールは "pk in [1, 3, 5]" というフィルタでデータをクエリします。
   filter='pk in [1, 3, 5] && array_contains(security_group, "sales")'、
    output_fields=["id", "data", "security_group"]、
)

res = client.query(
    collection_name="test_collection"、
   # 開発者ロールは、"pk > 10 "というフィルタでデータをクエリします。
   filter='pk > 10 && array_contains(security_group, "develop")'、
    output_fields=["id", "data", "security_group"]、
)
これらの例では、クエリはロールベースのパーミッションをチェックするだけでなく、([1, 3, 5]の中のpkやpk > 10のような)追加のフィルタを適用して、特定の条件に基づいて結果を絞り込んでいる。このような柔軟性により、ユーザーはデータアクセスを厳密に制御しながら、非常に的を絞ったクエリを作成することができる。
更新権限
特定のデータ行に対して特定のロールにアクセス権を付与したり、そのアクセス権を削除したりと、パーミッションを変更する必要がある場合があります。Milvusの upsert APIを使用すると、データ行に関連付けられたパーミッションを更新することができます。
このAPIを使って、特定の行のパーミッションを変更する方法を説明しよう。
例データ行のパーミッションの更新
行のパーミッションを更新するには、security_groupフィールドを調整するだけです。この例では、以前は "finance "ロールにしかアクセスできなかった行に "sales "ロールを追加します。
upsert_row_update = {
        "id":101,
        "vector": upsert_vector、
        "data": upsert_data、
        # 役割を更新する
       "security_group":[財務」、「販売」]。
}
res = client.upsert(
    コレクション名="test_collection"、
    data=upsert_row_update)
結果
アップサートを行う前の pk = 101 の行は以下のようになっていた:
pk = 101:
データデータ: [" {'id':101,
'data': 'data63309'、
'vector':[0.38069534, 0.15088418, -0.6266929, -0.6038463, 0.2516377...],
'security_group':[金融'],"].

アップサート後
データを["{'id':101,
'data': 'data63309'、
'vector':[0.38069534, 0.15088418, -0.6266929, -0.6038463, 0.2516377...],
'security_group':[ファイナンス', 'セールス']}"].
配列の security_group カラムとビットマップインデックスのフィルタリングを使用することで、行レベルの読み取りアクセス制御のための強固な基盤を確立し、クエリ中にパーミッションを効果的に管理できるようになりました。この方法は、強力なパフォーマンスとアクセス権のきめ細かな制御を実現します。管理者は、データの挿入や更新の際にパーミッションを注意深く管理し、テーブルを作成する際には、十分に考え抜かれたパーミッション戦略を保証しなければなりません。
結論
きめ細かなアクセス制御の実装は、特に医療や金融のような機密情報を扱う業界にとって、最新のデータ管理の重要な要素である。Milvusは行レベルのRBAC(ロールベースアクセスコントロール)を提供しており、データアクセスを正確かつ効率的に管理するための堅牢なソリューションである。
このアプローチはセキュリティを強化するだけでなく、進化するビジネスニーズに柔軟性を提供し、役割や責任の変化に応じてアクセスポリシーが適応できることを保証します。Milvusの強力なツールと柔軟なアクセス許可モデルにより、企業は、適切な人々へのシームレスなアクセスを提供しながら、規制要件を満たす高度に安全でスケーラブルなデータシステムを構築することができます。
さらにダイナミックな権限管理と継承のために、MilvusのフルマネージドサービスであるZilliz Cloudは、さらにきめ細かい権限機能を備えています。これらの機能強化は、管理効率を向上させるだけでなく、より高い柔軟性を提供し、より幅広いビジネス要件への対応を容易にします。Zilliz Cloud RBACの詳細については、ドキュメントをご覧ください。
続きを読む
ベクターデータベースとは何か、どのように機能するのか](https://zilliz.com/learn/what-is-vector-database)
MilvusでAIアプリを作る: チュートリアルとノートブック](https://zilliz.com/learn/milvus-notebooks)
あなたのGenAIアプリのためのトップパフォーマンスAIモデル|Zilliz](https://zilliz.com/ai-models)
データの保護:ベクターデータベースシステムにおけるセキュリティとプライバシー](https://zilliz.com/learn/safeguarding-data-security-and-privacy-in-vector-database-systems)
オープンソースMilvusからZilliz Cloudへ移行する5つの理由](https://zilliz.com/blog/top-5-reasons-to-migrate-milvus-to-zilliz-cloud)
読み続けて
Zilliz Cloud On-Demand Compute: Pay Only for What You Use
The customer case behind Zilliz Cloud On-Demand: how a $10K vector search bill came down to under $500, and the engineering changes that made it possible.
Introducing Zilliz CLI and Agent Skills for Zilliz Cloud
Manage your vector database from your terminal or AI coding agent. Zilliz CLI and Agent Skills work with Claude Code, Cursor, Codex, and Copilot.
Zilliz Cloud Update: Tiered Storage, Business Critical Plan, Cross-Region Backup, and Pricing Changes
This release offers a rebuilt tiered storage with lower costs, a new Business Critical plan for enhanced security, and pricing updates, among other features.