




LangServe、LangGraph、MilvusによるインテリジェントRAGアプリケーションの構築
このブログ記事は、私が以前書いたLangGraphとLlama 3によるローカル・エージェントRAGの続編です。
このブログポストでは、LangChainエコシステムの2つの強力なツールであるLangServeとLangGraphを使ってアプリケーションを構築する方法を探ります。また、ベクターデータベースとしてMilvusを使用します。FastAPIアプリケーションのセットアップ、LangServeとLangGraphの設定、そして効率的なデータ検索のためのMilvusの使い方を紹介します。
ビデオチュートリアルに沿って
.学習内容
LangServeとLangGraphを使ったFastAPIアプリケーションのセットアップ。
Milvusをベクター保存と検索のために統合する。
LangGraphを使ったLLMエージェントの構築
前提条件
始める前に、以下の依存関係がインストールされていることを確認してください:
Python 3.9+
Docker
FastAPIとDockerの基礎知識
LangServeとMilvusの紹介
LangServeは、FastAPIの拡張機能で、LangChainを利用したダイナミックで強力なエンドポイントの作成を効率化するように設計されています。APIエンドポイントとして公開できる複雑な処理ワークフローを定義することができます。
LangGraph - Langchainの拡張で、ステップをグラフのエッジやノードとしてモデル化することで、LLMを使ったロバストでステートフルなマルチアクタアプリケーションを構築することを目的としています。
Milvusは、スケールのために構築された高性能なオープンソースのベクトルデータベースです。Milvus Liteは、Milvusの軽量でローカルなバージョンで、DockerやKubernetesを必要とせずに個人のデバイス上で実行することができます。
LangGraphによるツール呼び出しエージェントの構築
前回のブログ記事](https://zilliz.com/blog/local-agentic-rag-with-langraph-and-llama3)では、LangGraphがツール・コールを可能にすることで、言語モデルの機能を大幅に強化できることを説明しました。ここでは、そのようなエージェントをLangServeで構築し、Dockerを使って様々なインフラにデプロイする方法を紹介します。
エージェントRAG入門
エージェントは、言語モデルをアクションを決定し、実行し、結果を評価する強力な推論エンジンに変換することができます。このプロセスはAgentic RAG (Retrieval Augmented Generation) として知られている。エージェントは以下のことができる:
ウェブ検索の実行
電子メールの閲覧
検索された文書について自己反省や自己採点を行う
ユーザー定義関数の実行
その他...
セットアップ
1.LangGraph:LLMを使ってステートフルなアプリケーションを構築するためのLangChainの拡張で、ステップと決定をモデル化するためにグラフを使います。
2.Ollama & Llama 3**:Ollamaは、Llama 3のようなオープンソースの言語モデルをローカルで実行することを可能にし、オフラインでの使用とより大きなコントロールを可能にします。
3.Milvus Lite:Milvusのローカル版で、効率的なベクトルの保存と検索が可能。
LangServeとMilvusの使い方
LangServeでは複雑な処理ワークフローをAPIエンドポイントとして公開することができます。ここでは、関数 analyze_text の例を示します。ここでは、FastAPIアプリにエンドポイント /analyze を追加し、クエリを実行できるようにします。
1.**FastAPI アプリケーションを定義します。
インポート uvicorn

from fastapi import FastAPI
from pydantic import BaseModel
from langchain_core.runnables import RunnableLambda
from langserve import add_routes


# リクエストボディのPydanticモデルを定義する
class QuestionRequest(BaseModel):
    question: str

fastapi_app = FastAPI()

# テキスト分析のためにLangServeルートを定義する
fastapi_app.post("/analyze")
async def analyze_text(request: QuestionRequest):
    # テキスト分析をシミュレートする(実際のLangServeロジックに置き換える)
    entities = ["entity1", "entity2"].
    processed_data = f "処理されたエンティティ:{エンティティ}"
    return {"entities": entities, "processed_data": processed_data}.
add_routes(fastapi_app, RunnableLambda(analyze_text))

if __name__ == "__main__":
    uvicorn.run(fastapi_app, host="0.0.0.0", port=5001)
2.**ワークフロー管理にLangGraphを統合する。
LangGraphを使って、Llama3を搭載したカスタムRAGエージェントを構築することができます。このエージェントは、ユーザからの問い合わせを最適な検索方法にルーティングしたり、回答の質を向上させるために自己修正を行ったりすることができます。LangGraphについてのブログ](https://zilliz.com/blog/local-agentic-rag-with-langraph-and-llama3)をご覧ください。
3.効率的なデータ検索のためのMilvusの活用:.
Milvusを統合し、ベクトルデータを効率的に保存・検索します。このステップにより、関連情報への迅速なアクセスが可能になり、アプリケーションのパフォーマンスが向上します。
from langchain_core.documents import ドキュメント

def load_and_split_documents(urls: list[str]) -> list[Document]:
    docs = [WebBaseLoader(url).load() for url in urls] ドキュメントをロードします。
    docs_list = [item for sublist in docs for item in sublist] docs_list = [item for sublist in docs for item in sublist
    text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(chunk_size=250, chunk_overlap=0)
    return text_splitter.split_documents(docs_list)

def add_documents_to_milvus(doc_splits: list[Document], embedding_model:embeddings, connection_args:any):
    vectorstore = Milvus.from_documents(documents=doc_splits, collection_name="rag_milvus", embedding=embedding_model, connection_args=connection_args)
    return vectorstore.as_retriever()

urls = [
"https://lilianweng.github.io/posts/2023-06-23-agent/"、
"https://lilianweng.github.io/posts/2023-03-15-prompt-engineering/"、
"https://lilianweng.github.io/posts/2023-10-25-adv-attack-llm/"、
]

doc_splits = load_and_split_documents(urls)
embedding_model = HuggingFaceEmbeddings()
connection_args = {"uri":"./milvus_rag.db"}.
retriever = add_documents_to_milvus(doc_splits, embedding_model, connection_args)

#エージェントが必要に応じて呼び出す関数です。
def retrieve(state: Dict[str, Any]) -> Dict[str, Any]:
    print("---RETRIEVE---")
    question = state["question"]
    documents = retriever.invoke(質問)
    return {"documents":[doc.page_content for doc in documents], "question": question}.
私のGitHubにあるコードを自由にチェックしてください。
結論
このブログポストでは、LangServe、LangGraph、Llama 3、Milvusを使ったエージェントを使ったRAGシステムの構築方法を紹介しました。これらのエージェントは、プランニング、メモリ、ツールの使用状況を取り込むことでLLMの機能を強化し、よりロバストで有益なレスポンスをもたらします。LangServeを統合することで、これらの洗練されたワークフローをAPIエンドポイントとして公開することができ、インテリジェントなアプリケーションの構築とデプロイが容易になります。
もしこのブログ記事を楽しんでいただけたなら、Githubで私たちに星を与え、Discordに参加して、あなたの経験をコミュニティと共有することをご検討ください。
読み続けて
A Few Notes from Databricks Data + AI Summit 2026: Why the Data Layer Matters Again
James Luan shares notes from Databricks Data + AI Summit 2026 on why production AI is pushing the data layer back to the center of infrastructure.
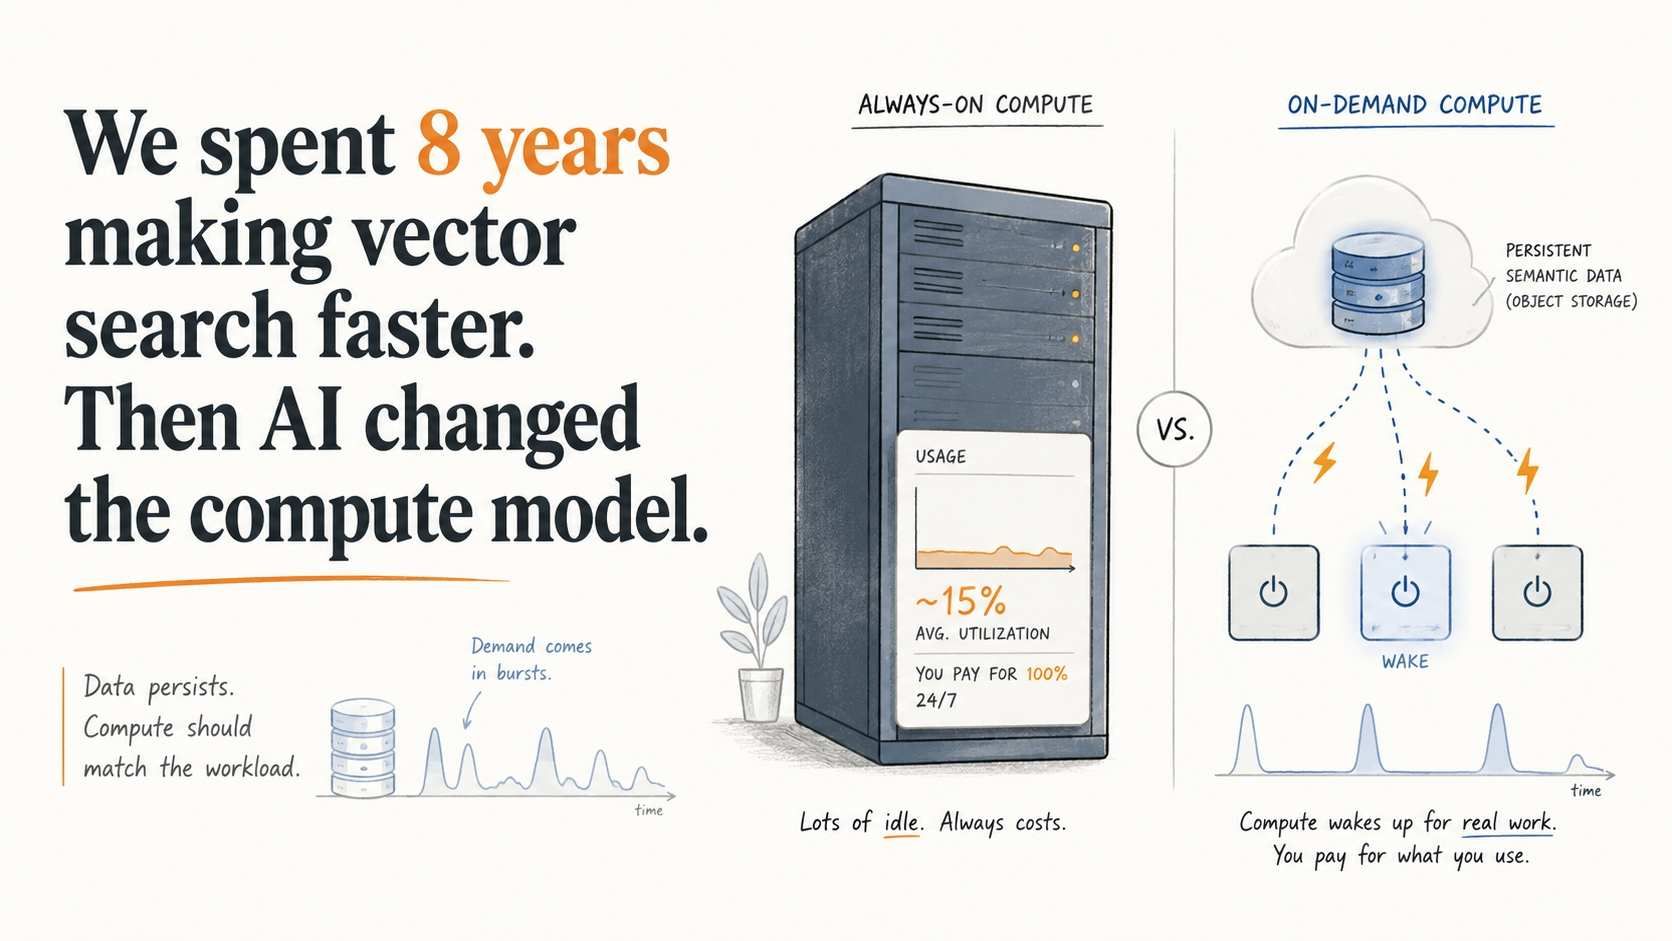
We spent 8 years making vector databases faster. Then we stopped.
Rarely queried embeddings still need to stay searchable. See how Vector Lakebase enables on-demand vector search without always-on compute costs.
Cosmos World Foundation Model Platform for Physical AI
NVIDIA's Cosmos platform enables safe, digital twin training of GenAI models for physical applications, overcoming data scarcity and safety challenges.