




Video AIとは?
Video AIとは?
TL;DR
Video AIは、データの連続フレームを処理して動き、活動、時間的パターンを理解することで、動画コンテンツを分析し洞察を抽出する人工知能の専門分野です。静止画像を処理するImage AIとは異なり、Video AIは重要な時間の次元を取り入れることで、動的なコンテンツを解釈し、時間の経過とともに展開する複雑なパターンを認識できます。
はじめに
TikTokやYouTubeをスクロールしていて、探していた動画を瞬時に見つけられる場面を想像してみてください。スマート防犯カメラは今や顔を検出し、住宅所有者に即座に通知します。Augmented Reality (AR)アプリでは、家具がリビングルームにどのように収まるかをリアルタイムで確認できます。こうした進歩はVideo AIによって実現されています。
動画は2025年までに全インターネットトラフィックの82%を占めると予測されています。この膨大な動画データの流入を分析・管理するには高度な技術が必要であり、Video AIは不可欠なものとなっています。Video AIがImage AIと異なる主な理由は、時間の次元にあります。Image AIが静止画像を分析する一方で、Video AIは時間の経過に伴うフレームのシーケンスを処理し、動きや時間的パターンを捉えます。この複雑さにより、動的なコンテンツを解釈するための高度なアルゴリズムの使用が必要になります。
自動運転車からスポーツ分析、Netflixのレコメンデーションまで、さまざまな業界がVideo AIを活用して周囲の環境から洞察を得ています。それは、私たちが世界を見て理解する方法を変えつつあります。しかし、それは正確には何であり、どのように機能するのでしょうか?
この記事では、動画データの基本原則とそれに関連する課題、そしてVideo AIとImage AIの違いを、時間ベースの分析の複雑さに焦点を当てて紹介します。業界全体における主要なユースケースについて学び、自動化された動画インサイトへのニーズが高まっている理由を理解できます。
Image AIからVideo AIへ:飛躍を理解する
動画コンテンツが増加するにつれて、AIは静止画像を超えて、時間の経過に伴う動きやイベントを理解する必要があります。この移行は新たな課題をもたらし、効果的な分析のために高度な技術を必要とします。
時間的次元と複雑さ
単一フレームを処理するImage AIとは異なり、Video AIは動きと文脈を捉えるためにシーケンスを分析しなければなりません。画像内の人物を特定することは簡単ですが、その人物が歩いているのか、走っているのか、転倒しているのかを認識するには、複数のフレームにわたる変化を追跡する必要があります。この追加された複雑さには、3D畳み込みやtransformersなど、空間的特徴と時間的特徴の両方を処理する特殊なモデルが必要です。フレームレート、モーションブラー、連続性のばらつきに対応することにより、動画分析は静止画像認識よりも困難になります。
動画データの増加
YouTube、TikTok、Instagram Reelsのようなプラットフォームは大量の動画コンテンツを生み出しており、YouTubeだけでも毎分360時間以上の動画がアップロードされています。企業もCCTV監視などの動画ソースに大きく依存しており、毎日ペタバイト規模の映像が生成されるため、手作業での確認は現実的ではありません。AIは今やリアルタイム監視、video search、自動化された洞察に不可欠であり、Video AIは業界全体で重要なツールとなっています。
一般的なVideo AIのユースケース
Video AIは、自動化を可能にし、洞察を強化し、ユーザー体験を向上させることで、業界を再形成しています。最も影響力のある応用例には以下があります。
監視とセキュリティ: AIは侵入者、異常、不審な動きをリアルタイムで検出し、公共および民間のセキュリティを向上させます。
スポーツとエンターテインメント: コーチやアナリストはAIを使用して試合映像を分析し、選手を追跡し、ハイライトリールを自動生成します。
拡張現実(AR): AIはジェスチャー認識、オブジェクト追跡、リアルタイムのオーバーレイを可能にし、ゲーム、ショッピング、インタラクティブ体験を強化します。
コンテンツ制作: AIは動画編集、シーン分割、スマートクロッピングを自動化し、クリエイターやメディア企業の制作を効率化します。
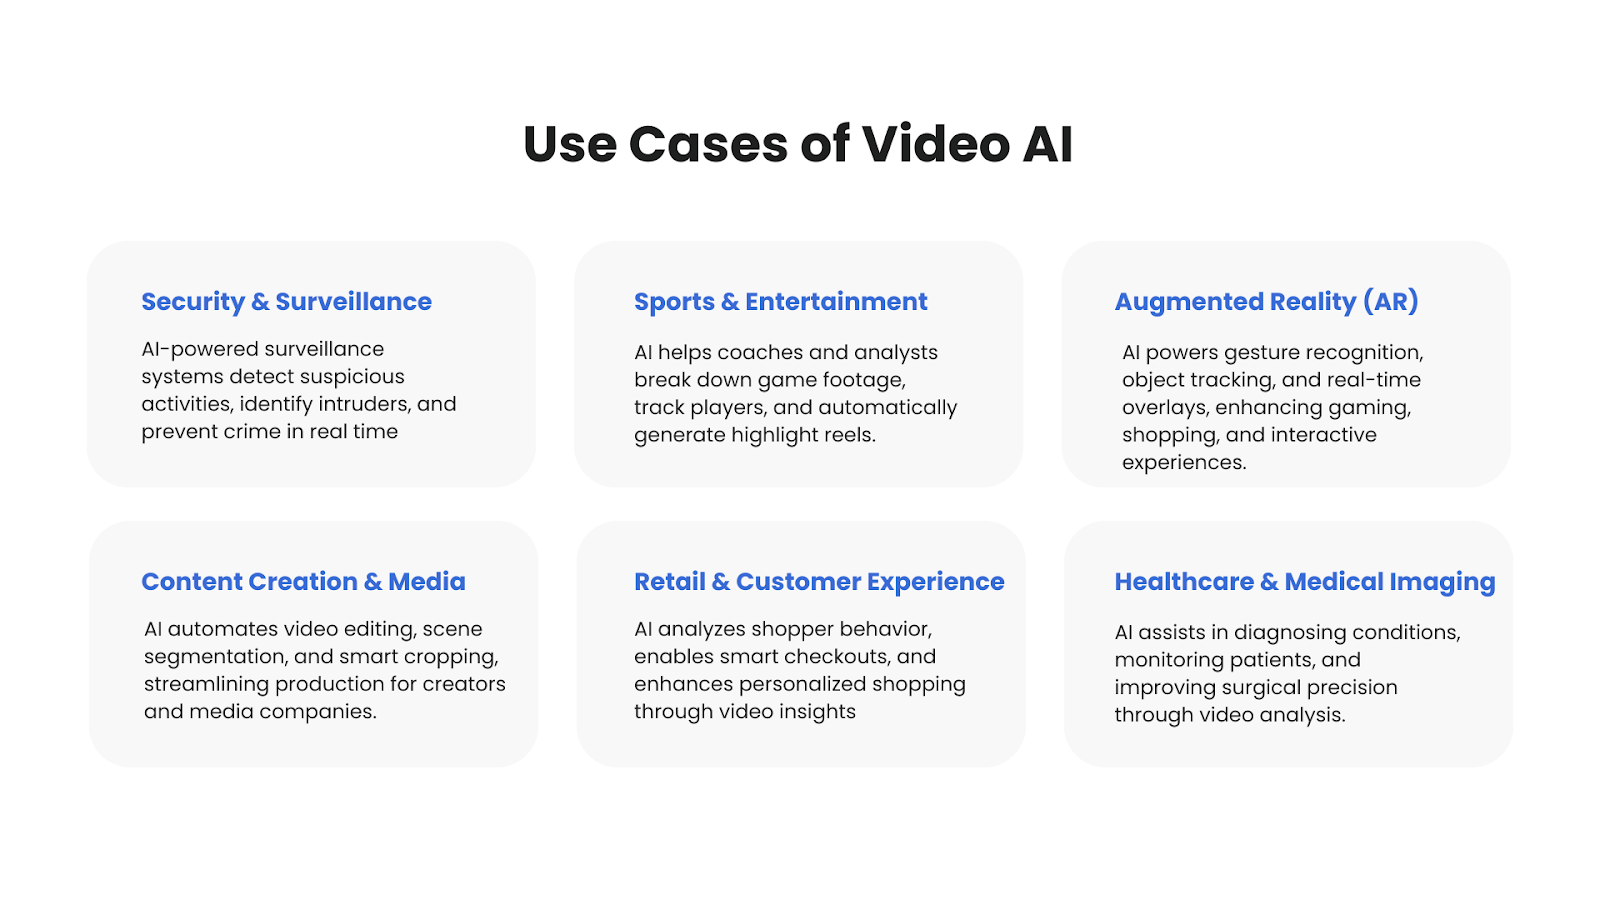 図1. 動画AIのユースケース
動画AIの中核概念
動画AIは、時間情報、埋め込み表現、高度な追跡手法を取り入れています。AIモデルは、動きを理解し、活動を認識し、時間の経過に伴ってオブジェクトを検出できなければなりません。このセクションでは、現代の動画AIを支える主要な技術概念について説明します。
時間モデリング
各フレームが独立している画像とは異なり、動画は連続した流れを形成する連続フレームで構成されます。行動認識や動画要約のようなタスクでは、空間的特徴(オブジェクトの詳細)と時間的特徴(時間の経過に伴う動き)を捉えることが重要です。
時間情報を扱うための3つの主要なアプローチを以下に示します。
CNN + RNNアプローチ: 初期の動画AIモデルは、フレームベースの特徴抽出に2D 畳み込みニューラルネットワーク(CNN)を使用し、時間的依存関係をモデル化するためにリカレントニューラルネットワーク(RNN)または長短期記憶(LSTM)を組み合わせていました。これらの手法は長距離依存関係の扱いに苦労し、逐次処理を必要としました。勾配消失問題のため、スケーラブルではありませんでした。
3D畳み込み: 3D Convolution(C3D)やInflated 3D(I3D)のようなニューラルネットワークは、空間的特徴と時間的特徴を同時に抽出します。これらのモデルは、幅、高さ、時間にわたって3Dカーネルを適用し、動画内の動きのパターンを理解できるようにします。
動画AI向けTransformer: 近年、Transformerは動画理解の方法を完全に変えました。TimeSformerやMultiscale Vision Transformers(MViT)のようなモデルは、自己注意メカニズムを使用して、空間的依存関係と時間的依存関係の両方を効率的に分析します。これらのアーキテクチャはRNNよりもスケールしやすく、行動認識や動画分類で最先端の成果を達成しています。
動画埋め込み
動画AIでは、検索、類似性比較、分類のようなタスクのために、動画クリップをコンパクトな数値形式で表現することがよく求められます。ここで動画埋め込みが役立ちます。
動画埋め込みを生成するために、いくつかの深層学習アーキテクチャが使用されています。
SlowFast Networks: このモデルは2つの経路で構成されています。一方は空間的詳細を捉えるために低いフレームレートで動作し、もう一方は動きのダイナミクスを捉えるために高いフレームレートで動作します。
MoViNet(Mobile Video Networks): ストリーミング動画処理に最適化された効率的な畳み込みニューラルネットワークのファミリーで、低遅延で長い動画シーケンスを処理するように設計されています。
TimeSformer: 空間次元と時間次元の両方にわたって自己注意を適用するTransformerベースのモデルで、3D畳み込みを必要とせずに動画理解を可能にします。
これらのモデルは生の動画フレームを処理し、重要な動きとコンテンツの特徴を捉える固定長の埋め込みを生成します。
動画データのサイズを考えると、埋め込みは高速検索のためにベクトルデータベースに保存されることがよくあります。これは、コンテンツベースの動画検索、動画重複排除、推薦システムのようなアプリケーションで役立ちます。
行動・活動認識
物体検出を超えて、Video AI は時間の経過に伴う動きのパターンを分析することで、行動を認識しなければなりません。行動認識は、複数のフレームにわたる一連の動きを識別することを含みます。たとえば、人が走っているのか、座っているのか、コーヒーをこぼしているのかを区別するには、単一の画像に頼るのではなく、姿勢や動きの変化を追跡する必要があります。行動認識のための堅牢なモデルのトレーニングは、多様な人間の活動をカバーする何千ものラベル付き動画クリップを含む Kinetics や ActivityNet のような、大規模で適切にアノテーションされたデータセットに依存します。
動画物体検出と追跡
動画における物体検出は、物体が動き、外観が変化し、時間の経過とともに遮蔽される可能性があるため、画像の場合よりも複雑です。YOLO v12 や Detectron2 のような最新モデルは、各フレーム内の物体を検出し、リアルタイムのバウンディングボックスを生成します。しかし、フレーム間で物体の同一性を維持するために、DeepSORT や ByteTrack のような追跡モデルが、時間の経過に伴う検出結果を関連付けます。これは、自動運転、スポーツ分析、セキュリティ監視などのアプリケーションにとって極めて重要であり、一貫した物体追跡によって正確な分析と意思決定が可能になります。
Video AI システムに不可欠なアーキテクチャコンポーネント
効率的な Video AI システムを構築するには、強力な機能が必要です。大規模な動画データセットを扱うには、最適化されたパイプライン、リアルタイムのモデル高速化、スケーラブルなインデックス作成手法が求められます。
データパイプラインと前処理
生の動画ファイルは、多くの場合、AI で直接処理するには大きすぎます。前処理は、重要な特徴を保持しながら計算負荷を軽減するのに役立ちます。
チャンク化とフレーム抽出: 動画全体を処理する代わりに、AI モデルはより小さなクリップを分析したり、関連するセクションに焦点を当てるためにキーフレームを抽出したりします。
解像度とフレームレートの低減: 解像度(例: 4K から 720p)やフレームレート(例: 60 FPS から 30 FPS)を下げることで推論は高速化されますが、精度低下とのバランスを取る必要があります。
正規化と圧縮: 色、明るさ、アスペクト比を標準化することで動画ソース間の一貫性を確保し、H.264 や H.265 のような圧縮技術は、過度な品質低下なしにストレージを管理するのに役立ちます。
モデル推論と高速化
動画データをリアルタイムで処理するには、高い計算能力が必要です。AI モデルは、精度を損なうことなく高速推論向けに最適化されなければなりません。
GPU 高速化: 最新の Video AI モデルは、並列処理のために GPU(例: NVIDIA TensorRT、CUDA)を活用し、推論時間を大幅に短縮します。
バッチ処理: フレームを個別に分析するのではなく、モデルはバッチを同時に処理し、効率を向上させます。
モデル量子化とプルーニング: モデルを 32 ビット浮動小数点からより低い精度(例: INT8)へ変換することで、メモリ使用量を削減し、最小限の精度トレードオフで推論を高速化します。
エッジコンピューティング: エッジデバイス(例: セキュリティカメラ、AR ヘッドセット)上で AI モデルを実行するには、最小限のレイテンシが求められ、クラウドへの依存なしにリアルタイム処理を可能にします。
ストレージとインデックス作成
動画インサイトの効率的な保存と取得は非常に重要です。従来のリレーショナルデータベースは非構造化動画データの扱いに苦慮するため、代替ソリューションの必要性が生じます。生の動画を保存する代わりに、埋め込みモデルが動画埋め込みを生成し、それらは高速な類似検索のために ベクトルデータベース に保存、インデックス化、取得されます。これらの埋め込みにより、コンテンツベースの動画検索、異常検知、推薦システムが可能になります。
ベクトルデータベース: 最新の Video AI の基盤
先ほど説明したように、動画AIシステムは大量の高次元ベクトル埋め込みを生成し、従来のデータベースでは効率的に扱うことが困難です。Zilliz や Milvus のようなベクトルデータベースは、これらの特定の課題に対応するために専用設計されています。
動画AIにベクトルデータベースが不可欠な理由
効率的な類似性検索: 動画埋め込みは数百から数千の次元を含むことが多く、従来のインデックス手法では効果的に機能しません。ベクトルデータベースは、近似最近傍(ANN)検索のような専用アルゴリズムを実装しており、数十億のベクトルをミリ秒単位でクエリできるため、リアルタイムの動画検索と取得が可能になります。
時系列パターン認識: 動画では、時間の経過に伴うパターンを理解する必要があります。ベクトルデータベースは、異なる時間セグメントからの埋め込みを保存してクエリできるため、AIシステムは時間とともに展開するアクション、シーン、イベントのような複雑なパターンを検出できます。
増大する動画データに対応したスケール: 動画コンテンツがインターネットトラフィックを引き続き支配する中、システムには水平スケーリングが求められます。Milvus のようなベクトルデータベースは分散アーキテクチャを備えており、組織はクエリ速度や精度を損なうことなく動画処理能力を拡張できます。
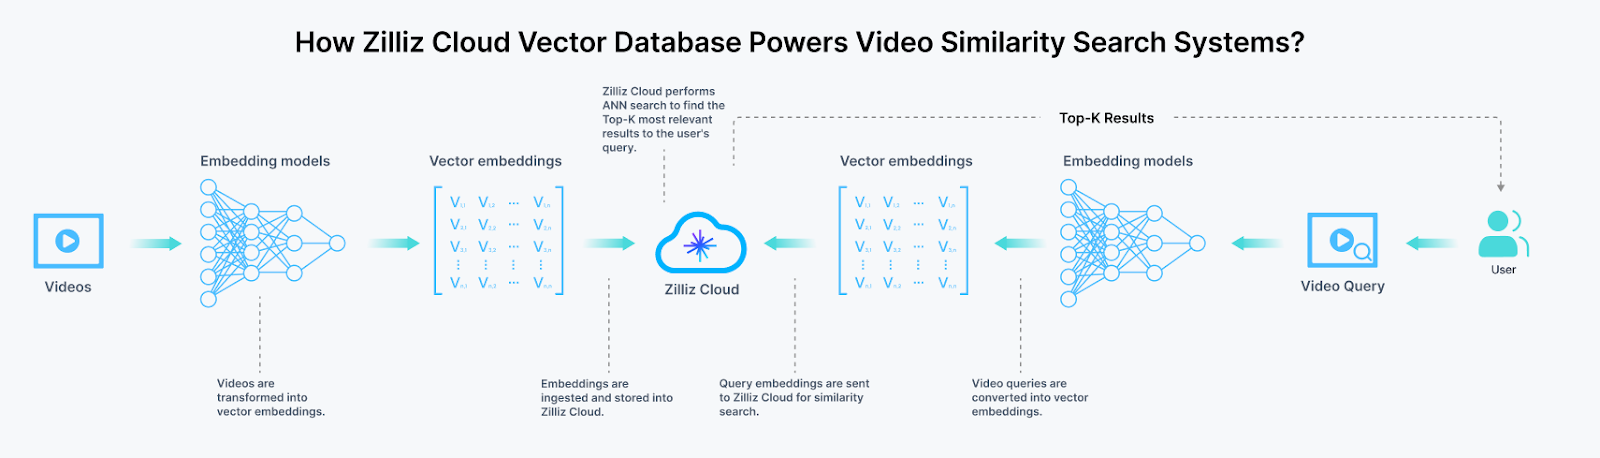 図2. Zilliz による動画埋め込みと検索 | 出典
ベクトルデータベースによって実現される主要な動画AIアプリケーション
コンテンツベースの動画検索: 手動のタグや説明に頼ることなく、視覚的に類似した動画や動画内の特定の瞬間を見つけます。これにより、次のようなユースケースが可能になります。
重複またはほぼ重複するコンテンツの検出
類似した視覚的構図を持つシーンの発見
動画ライブラリ全体から特定のアクションやオブジェクトを検索
リアルタイム動画分析: ライブ動画ストリームを処理し、既存のデータベースと即座に比較します。
不審な活動をリアルタイムで特定できるセキュリティシステム
選手の動きや戦術を追跡するスポーツ分析プラットフォーム
顧客ジャーニーマッピングと行動分析のための小売分析
マルチモーダル動画理解: 動画埋め込みをテキスト、音声、その他のメタデータと統一されたベクトル空間で組み合わせます。
自然言語クエリを使用して動画を検索
視覚コンテンツと話された言葉の両方に基づいて動画を検索
コンテキストを認識した動画推薦システムを作成
Milvus による動画AIの実装
Milvus は、高次元ベクトル埋め込みを扱うために専用設計されたオープンソースのベクトルデータベースです。以下を通じて、スケーラブルな動画AIアプリケーションを構築するために必要なインフラストラクチャを提供します。
動画埋め込み向けに最適化されたインデックス: SlowFast、TimeSformer、MoViNet のような一般的な動画埋め込みモデル向けに調整された専用インデックスアルゴリズム。
ハイブリッド検索機能: メタデータフィルタリングと類似性検索を組み合わせ、セマンティックコンテンツと従来の属性の両方に基づいて結果を絞り込みます。
ストリーミングパイプライン統合: 人気の動画処理フレームワークとシームレスに接続し、複数のソースからの継続的なデータ取り込みを処理します。
さらに詳しくは、このドキュメントをご覧ください。
実践的な実装: Milvus で動画検索システムを構築する
これは、Milvus で動画検索システムを構築するための簡単なコードスニペットです。Milvus に詳しくない場合は、詳細について そのクイックスタートドキュメント をご覧ください。
from pymilvus import MilvusClient
import numpy as np
# Connect to Milvus
client = MilvusClient(uri="http://localhost:19530")
collection_name = "video_action_recognition"
# Create the collection (quick setup — index is auto-created)
if not client.has_collection(collection_name):
    client.create_collection(
        collection_name=collection_name,
        dimension=512,             # Vector dimension
        metric_type="L2",          # Similarity metric
        description="Embeddings for video action recognition",
        auto_id=True               # Milvus will auto-generate primary keys
    )
# Insert video embeddings and metadata
def insert_video_data(video_embeddings, metadata):
    entities = []
    for i, embedding in enumerate(video_embeddings):
        entities.append({
            "embedding": embedding,
            "timestamp": metadata[i]["timestamp"],
            "video_id": metadata[i]["video_id"],
            "frame_number": metadata[i]["frame_number"],
            "action_label": metadata[i]["action_label"]
        })
    client.insert(collection_name=collection_name, data=entities)
# Search for similar actions
def search_similar_actions(query_embedding, top_k=5):
    client.load_collection(collection_name)  #  load before search
    search_results = client.search(
        collection_name=collection_name,
        data=[query_embedding],
        limit=top_k,
        output_fields=["video_id", "timestamp", "action_label"],
        search_params={"metric_type": "L2", "params": {"ef": 100}}
    )
    return search_results
課題と考慮事項
急速に進歩しているにもかかわらず、動画AIはデータ品質、スケーラビリティ、倫理的懸念に関連するいくつかの課題に直面しています。これらの要因は、モデルの性能、デプロイの実現可能性、責任あるAIの導入に影響します。
データ品質とラベリング
正確な動画AIモデルをトレーニングするには、大規模で適切にラベル付けされたデータセットが必要ですが、動画へのアノテーションは画像のラベリングよりもはるかに複雑です。
クリップレベル vs. フレームレベルのラベル: 単一のラベルを必要とする画像とは異なり、動画では動きとコンテキストを捉えるためにフレーム全体にわたるアノテーションが必要です。これにより、アノテーションの時間とコストが増加します。
手動ラベリングのコスト: 高品質なラベルには人間のアノテーターが必要であり、特に大規模データセットでは、そのプロセスは高コストで時間がかかります。
合成ラベルと弱いラベル: 研究者は合成データ(AI生成ラベル)や弱教師あり学習(部分的にラベル付けされたデータの使用)を模索しています。これらの手法は有望ですが、精度を確保するためには依然として検証が必要です。
スケーラビリティとリアルタイム要件
動画データを大規模に扱うには、速度や精度を損なうことなく大量の連続ストリームを処理できる堅牢なインフラストラクチャが必要です。
リアルタイム処理: 自動運転、監視、ライブ動画分析などのアプリケーションでは、動画をリアルタイムで処理できるAIモデルが必要です。これには、最適化された推論パイプラインとエッジコンピューティングが求められます。
精度とレイテンシのバランス: 高解像度の動画は精度を向上させますが、推論を遅くします。開発者は、特に安全性が重要なタスクにおいて、処理速度とモデル精度のバランスを取る必要があります。
マルチカメラのスケーラビリティ: 企業でのユースケースでは、スマートシティや小売分析に見られるように、数百の動画フィードが関わることがよくあります。同時ストリームを効率的に処理できるように動画AIをスケールさせることは、依然として大きな課題です。
倫理とプライバシーに関する懸念
動画AIは、特に監視や顔認識アプリケーションにおいて、重大なプライバシーおよび倫理上の問題を引き起こします。
監視と顔認識をめぐる論争: AIを活用した監視はセキュリティを向上させる可能性がありますが、大規模監視、バイアス、潜在的な悪用に関する懸念を生じさせます。一部の政府は、プライバシー侵害を理由に顔認識を制限しています。
データプライバシー規制: 動画データを扱う際には、GDPR(General Data Protection Regulation)やCCPA(California Consumer Privacy Act)のような法律への準拠が不可欠です。これらは、データの保存、アクセス、ユーザーの同意に関する厳格なポリシーを求めています。
動画AIにおけるバイアス: バイアスのあるデータセットで学習したモデルは、特に顔検出、行動認識、セキュリティ用途において、不公平な結果を生み出す可能性があります。倫理的なAI開発には、多様な学習データとバイアス軽減技術の確保が重要です。
結論
動画AIは、機械が視覚データを理解し分析する方法を変革しています。画像AIとは異なり、時間的次元を取り入れるため、より複雑である一方、監視、スポーツ分析、AR、コンテンツ推薦などの用途においてより強力です。
MilvusやZilliz Cloudのようなベクトルデータベースは、スケーラブルで高性能な動画AIアプリケーションを構築するために不可欠なインフラを提供します。高次元の動画埋め込みの効率的な保存、インデックス作成、検索を可能にすることで、ベクトルデータベースはリアルタイム動画検索、推薦システム、複雑な分析を大規模に実装することを可能にします。
しかし、責任あるAIの導入を確実にするには、データラベリング、リアルタイム処理、倫理的懸念といった課題に対処する必要があります。動画データが増え続けるにつれ、AIモデルとインフラの進歩により、業界全体でさらに高度なアプリケーションが実現されるでしょう。
動画AIとベクトルデータベース技術を統合する組織は、より高速な検索機能、より正確な推薦、そして動画コンテンツの指数関数的な増加に合わせて拡張できる分析という、重要な競争優位性を獲得します。この強力な組み合わせは、増大する視覚データの津波から意味を引き出せる次世代の動画インテリジェンスシステムの基盤になりつつあります。