




Kling AIがMilvus上で100億+スケール、10,000+ QPSのベクトル検索を実行する方法
10B+
最大の単一本番クラスターにおけるベクトル
10,000+ QPS
ピーク時のスループット、書き込みとクエリを同時に
10,000+ 次元
ベクトルごとの次元数、旧エンジンの4,096の上限を超える
中断ゼロ
単一AZ障害でも検索と書き込みは稼働し続ける
Kling AIについて
Kling AIは、224の国と地域で1億人以上のユーザーを擁するAI画像・動画生成モデルです。これは、世界最大級のショート動画・ライブ配信プラットフォームの1つも運営し、1日あたり4億人以上のアクティブユーザーを抱えるKuaishouの一部です。
 Kling AIで作成された画像
Kling AIとその親会社の他の製品は、Milvus上に構築された1つの共有プラットフォーム上でベクトル検索を実行しています。これは、単なるキーワードではなく意味に基づいてコンテンツを照合・取得する幅広いシステムにサービスを提供しています。アップロードの安全性とリスクのスクリーニング、公開済み動画と重複する動画の検出、マルチモーダル検索とセマンティック検索の強化、そしてRAGとエージェント機能のグラウンディングです。その最大の単一クラスターは100億以上のベクトルを保持しています。
課題
AIによって製品はキーワードマッチングの限界を超え、ベクトル検索が本番環境での要件となりました。チームは当初、Elasticsearchに近似最近傍インデックスを拡張して対応しましたが、特にワークロードが数百億ベクトルに達するにつれて、長くは追いつきませんでした。この規模になると、3つの制約が重大なブロッカーとなりました。
読み取りと書き込みが同じマシンを奪い合っていました。 リスク管理とコンテンツ安全性は、オンラインクエリに応答しながら新しいベクトルを継続的に取り込みます。Elasticsearchでは、書き込みとクエリが同じノードを共有するため、大量の同時負荷がかかると、セーフティシステムが安定を必要とするまさにそのときに、クエリのレイテンシが急上昇し、ジッターが発生しました。
ストレージとコンピュートは分離して拡張できませんでした。 Elasticsearchはこの2つを結びつけているため、数百億ベクトルに拡張するには、どちらか一方だけがボトルネックである場合でも、ノード、メモリ、CPUをすべて連動して追加する必要がありました。コスト曲線とスケジューリングの複雑さの両方が、データ自体よりも速く増大しました。
ベクトル次元の厳しい上限。 Elasticsearchはベクトルを4,096次元に制限しており、新しい埋め込みモデルがすでに生成する次元数には及ばなかったのです。実際には、この検索エンジンの制限が、チームが採用できる埋め込みモデルを制限していました。
Milvusを選んだ理由
Kling AIのデータベースチームは、これら3つの制限に直接対処できる専用設計のベクトルエンジンを必要としていました。市場のベクトル検索ベンダーを社内で評価した後、データベースチームはさまざまなAIユースケースをサポートするためにMilvusを選択しました。Milvusが提供するものは以下のとおりです。
ベクトルネイティブで分離されたアーキテクチャ。 クエリ、書き込み、インデックス構築、調整はそれぞれ独立したコンポーネントとして実行され、ストレージはコンピュートから分離されています。
数十億ベクトルでもミリ秒単位の取得。 検索がユーザーや安全性の判断の前に位置する場合、そこで重要となるのはこの数値です。
複数のインデックスタイプにより、各チームが独自のトレードオフを調整できます。 HNSW、IVF、DiskANNは、SQ8やRaBitQなどの量子化スキームと並んで提供され、数万次元までのベクトル次元をサポートします。10,000 QPSを提供するチームも、厳しいメモリ予算でよりはるかに大規模なコーパスを検索するチームも、再現率、レイテンシ、メモリ、コストの曲線上でそれぞれのポイントを選択できます。
1つのエンジンの背後に完全な機能セット。 チームが必要としていたのはトップKルックアップだけではありません。スカラーフィルタリング、全文検索とセマンティック検索、ハイブリッド検索、集約です。Milvusはこれらすべてをカバーしており、そうでなければ複数のシステムにまたがるシナリオを1つのAPIの背後にまとめています。
オープンソースであり、大企業が基盤として構築できるコミュニティ。 MilvusはApache 2.0ライセンスの下で提供され、大規模で活発なコミュニティに支えられています。GitHubスター46,000以上、エンタープライズユーザー10,000以上、ダウンロード数1億以上です。
ソリューション
Kling AIとそのグループの他の製品の背後にあるプラットフォームは、Milvus 2.5および2.6を実行し、リスク管理とコンテンツセーフティ、ビデオ重複排除、RAGとナレッジベース、エージェントメモリ、レコメンデーションとユーザープロファイリング、マルチモーダルおよびクロスモーダル検索など、幅広いユースケースを提供しています。エンベディングは64次元から10,000次元超まであり、最大の単一クラスターは100億以上のベクトルを保持し、ピークトラフィックは10,000 QPSを超えます。
これらのワークロードにはそれぞれ大きく異なるニーズがあります。毎秒最大の検索数が必要なものもあれば、1つのクエリでベクトル検索、キーワード検索、フィルター検索を組み合わせるものもあり、厳格な時間制限内に応答しなければならないものもあります。多くはライブ検索に応えながら新しいデータを絶えず取り込み、そのすべてが稼働し続ける必要があります。以下のハイライトは、Milvusとチーム自身のエンジニアリングがこれらの要求にどのように応えているかを示しています。
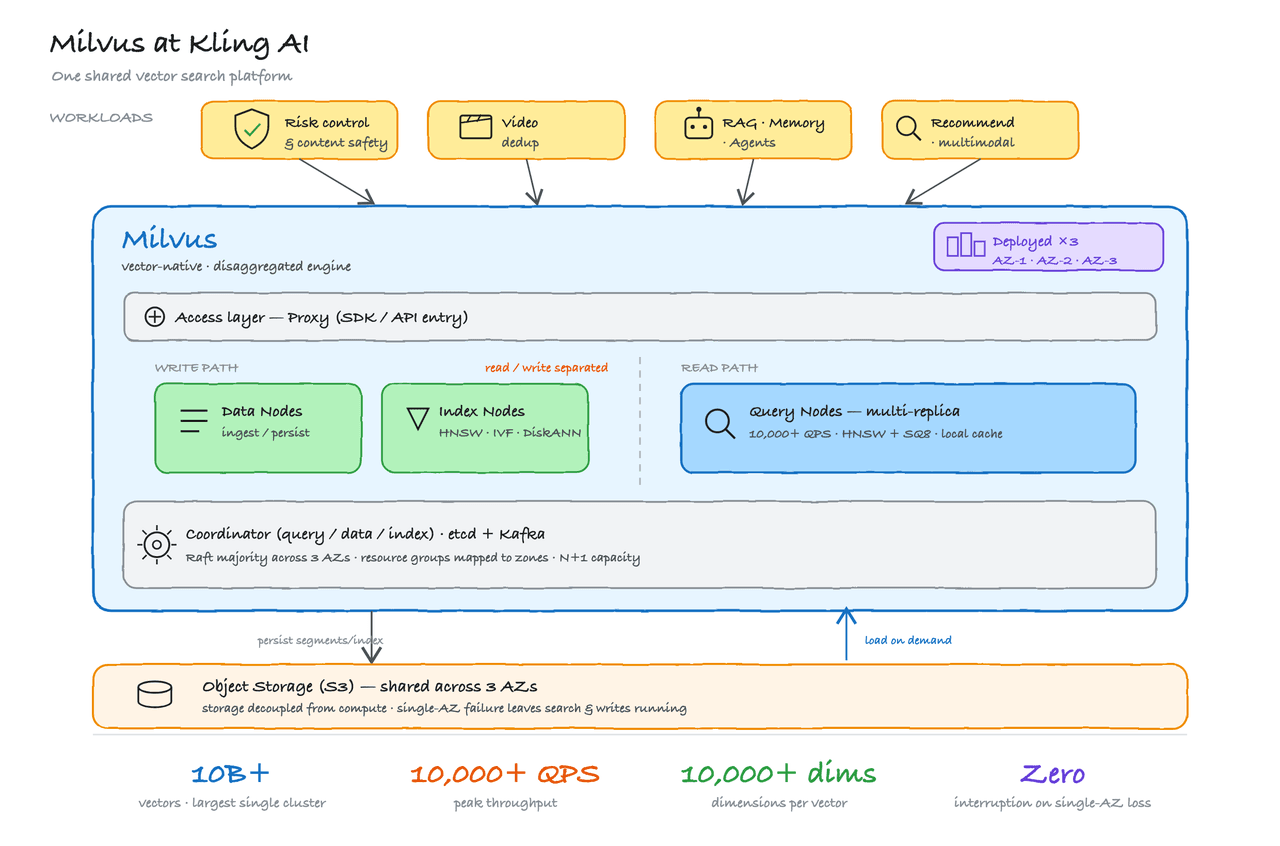
リスク管理とコンテンツセーフティ:数十億のベクトルに対する10,000+ QPSの読み書き分離
新しいコンテンツは単一のクラスターに24時間書き込まれ、到着するとほぼ即座に検索可能でなければならず、その間も検索は絶え間なく流入し続けます。Milvusは書き込みと検索を別々のノードで実行するため、新しいコンテンツの急増によって検索が遅くなることはありません。グラフベースのインデックスであるHNSWは各検索を高速に保ちます。SQ8圧縮は各ベクトルを約4分の1のサイズに削減するため、数十億のベクトルを手頃なコストでメモリに格納できます。また、複数のレプリカがクエリ負荷を分担します。10,000+ QPSを達成するには、このスケールに合わせたMilvusのチューニングも必要でした。主にMilvusのデータチャンクのサイズをチームのマシンに合わせ、異なるゾーンのレプリカ間で負荷を分散させました。Milvus 2.6では、そのチューニングの一部が製品に組み込まれています。
ビデオ重複排除:100億+ベクトルにわたるリアルタイムHNSW検索
アップロードされたビデオはフレームにサンプリングされ、各フレームがエンベディングされ、100億以上のベクトルのコレクションがリアルタイムで検索されて、再アップロードや、タイトルやタグでは見つけられない改変コピー(透かしの差し替えやミラーリングされた画像など)を検出します。重複排除はプラットフォームの2大ベクトルワークロードの1つです。新しいビデオが絶えずストリーミングされ、コレクションは毎秒5,000〜10,000+件の検索に応答し、24時間稼働し続ける必要があります。MilvusはHNSWでこれを処理し、ビデオはほとんどの場合更新ではなく追加されるため、インデックスが書き換えられることはほとんどなく、高速な状態が維持されます。
全社サービス:Milvus Operatorによる100+クラスターの自動化
グループ全体のチームにサービスを提供するということは、Milvusを単一のクラスターとしてではなく、フリートとして実行することを意味します。チームはMilvus Operator上にそのフリートを構築しました。これにより、プロビジョニング、スケーリング、ローリングアップグレード、設定変更が自動化され、新しい本番クラスターが数分で準備できます。モニタリングはMilvus自身のオープンソースのGrafanaダッシュボードに基づいており、Apache SeaTunnelがクラスター間および旧エンジンからのデータ移動を行います。チームはまた、LLMベースのキャパシティプランニングエージェントを追加しました。これは、チームのベクトル数、QPS、予算を推奨クラスターサイズとインデックスに変換し、大規模なローンチ前にDBAがレビューします。
データセンター障害:Milvusリソースグループによる3-AZ復旧
プラットフォームは同じ都市内の3つのデータセンター(アベイラビリティゾーン)にまたがって実行されるため、データセンター全体が失われても検索も書き込みも停止しません。Milvusのアーキテクチャがその多くを担っています。ほとんどのMilvusサービスは独自のデータを保持しないため、どのコピーでも別のコピーの代わりを務めることができます。チームは3つのデータセンターすべてにコピーを実行し、1つが停止しても残りが継続します。クエリノードは例外です。各クエリノードがデータの一部をキャッシュするため、Milvusのリソースグループが、すべてのデータセンターに検索可能なデータの完全なレプリカを保持することでこれらを処理します。チームは、他の2つのデータセンターがコアトラフィックを処理できるよう十分な予備容量を追加し、Milvusの背後にあるメタデータストアとメッセージキューも3つすべてで実行しています。
結果と利点
本番環境で数百億のベクトルを処理。 Milvus は Kling AI とその親会社の最大級のワークロードを支えています。これにはリスク管理、コンテンツ安全性、動画の重複排除が含まれます。最大の単一クラスターは、400 以上のクエリノードにわたって 100 億以上のベクトルを保持しています。
数十億のベクトルに対してピーク時 10,000 以上の QPS を達成し、書き込みと検索を同時に実行。 Milvus は書き込みと検索を分離しているため、新しいコンテンツの急増によって検索が遅くなることはありません - これが、Kling AI が以前のエンジンから移行した理由となった問題です。
100 以上の本番クラスターを、全社向けサービスとして運用。構築に要した期間は 1 年未満です。新しいクラスターは数分で準備でき、プラットフォームはアラート SLA 99% を維持しています。
最大 10,000 次元以上のエンベディングに対応。 従来の上限 4,096 をはるかに超えます。チームは、モデルが生成する任意の次元(64 以上)を、ベクトルインフラを変更せずに利用できます。
データセンター障害時の中断ゼロ。 Milvus は同じ都市内の 3 つのデータセンターにまたがって実行され、それぞれに検索可能なデータの完全なレプリカを持つため、1 つが失われても検索も書き込みも停止しません。
必要な場所にのみ容量を拡張。 ストレージとコンピュートは個別にスケールするため、チームは実際に不足しているリソースだけを追加できます。また、圧縮またはディスクベースのインデックス(SQ8、DiskANN)により、ワークロードが許せばメモリコストを削減できます。
全体として、Milvus は Kling AI とそのグループ内の他の製品にとって中核となるベクトル検索エンジンとなり、リスク管理や重複排除から RAG やエージェントに至るまで、さまざまなワークロードを支えています。新しいチームがベクトル検索を必要とする場合、単に Milvus クラスターをリクエストするだけで済みます。
次のステップ
Kling AI チームは、Milvus をさらに安定的かつコスト効率よく運用し、グループ全体のより多くのシナリオに拡張することを目指しています。Milvus 3.0 のアーキテクチャを追跡し、アップグレードによる利点を測定し、本番環境への段階的な移行を計画しています。また、3.0 で導入される lakebase 機能も探索しており、S3 外部テーブルを使用してコールドデータを階層化し、オフラインデータを再利用し、ベクトルのライフサイクル全体を管理します。さらに、Milvus コミュニティとの連携を深め、本番環境での学びをフィードバックやコントリビューションに変える計画です。
産業
エンターテイメント