Comment Kling AI exécute la recherche vectorielle sur Milvus à une échelle de plus de 10 milliards et plus de 10 000 QPS
10B+
Vecteurs dans le plus grand cluster de production unique
10,000+ QPS
Débit de pointe, écritures et requêtes simultanées
10 000+ dimensions
Dimensions par vecteur, au-delà de la limite de 4 096 de l'ancien moteur.
Zéro interruption
La défaillance d'une seule AZ laisse la recherche et les écritures en fonctionnement.
À propos de Kling AI
Kling AI est un modèle d’IA de génération d’images et de vidéos avec plus de 100 millions d’utilisateurs dans 224 pays et régions. Il fait partie de Kuaishou, qui exploite également l’une des plus grandes plateformes de vidéos courtes et de diffusion en direct au monde, avec plus de 400 millions d’utilisateurs actifs quotidiens.
 Image créée via Kling AI
Kling AI et les autres produits de sa société mère exécutent la recherche vectorielle sur une plateforme partagée construite sur Milvus. Elle sert un large éventail de systèmes qui mettent en correspondance et récupèrent du contenu par le sens plutôt que par de simples mots-clés : le filtrage des contenus téléversés pour la sécurité et les risques, la détection des vidéos qui dupliquent des vidéos déjà publiées, l’alimentation de la recherche multimodale et sémantique, et l’ancrage des fonctionnalités RAG et agent. Son plus grand cluster unique contient plus de 10 milliards de vecteurs.
Le défi
L’IA a poussé les produits au-delà de ce que la correspondance par mots-clés pouvait faire, et la récupération vectorielle est devenue une exigence de production. L’équipe y a d’abord répondu en étendant Elasticsearch avec une indexation approximative des plus proches voisins, mais cela n’a pas pu suivre longtemps, surtout à mesure que la charge de travail grimpait vers des dizaines de milliards de vecteurs. À cette échelle, trois limites sont devenues de véritables blocages.
Les lectures et les écritures se disputaient les mêmes machines. Le contrôle des risques et la sécurité du contenu intègrent en continu de nouveaux vecteurs tout en servant des requêtes en ligne en même temps. Dans Elasticsearch, les écritures et les requêtes partagent les mêmes nœuds ; ainsi, sous une forte charge concurrente, la latence des requêtes a connu des pics et des variations précisément lorsque les systèmes de sécurité avaient besoin qu’elle reste stable.
Le stockage et le calcul ne pouvaient pas évoluer séparément. Elasticsearch lie les deux ensemble, donc passer à des dizaines de milliards de vecteurs impliquait d’ajouter des nœuds entiers, de la mémoire et du CPU au même rythme, même lorsqu’un seul était le goulot d’étranglement. La courbe des coûts et la complexité de l’ordonnancement augmentaient plus vite que les données elles-mêmes.
Un plafond strict sur les dimensions des vecteurs. Elasticsearch limitait les vecteurs à 4 096 dimensions, en deçà de ce que les modèles d’embedding plus récents produisaient déjà. En pratique, le moteur de recherche limitait les modèles d’embedding que les équipes pouvaient adopter.
Pourquoi Milvus
L’équipe base de données de Kling AI avait besoin d’un moteur vectoriel conçu spécialement pour répondre directement à ces trois limites. Après une évaluation interne des fournisseurs de recherche vectorielle du marché, l’équipe base de données a choisi Milvus pour prendre en charge ses divers cas d’usage d’IA, car Milvus propose :
Une architecture native-vectorielle et désagrégée. Les requêtes, les écritures, la construction-d’index et la coordination fonctionnent comme des composants distincts, avec le stockage dissocié du calcul.
Une récupération en millisecondes, même avec des milliards de vecteurs. Lorsque la récupération se trouve devant un utilisateur ou une décision de sécurité, c’est ce chiffre qui compte.
Plusieurs types d’index, afin que chaque équipe ajuste son propre compromis. HNSW, IVF et DiskANN côtoient des schémas de quantification tels que SQ8 et RaBitQ, avec la prise en charge de dimensions vectorielles allant jusqu’à des dizaines de milliers. Une équipe servant 10 000 QPS et une équipe recherchant un corpus bien plus vaste avec un budget mémoire serré peuvent chacune choisir leur propre point sur la courbe rappel, latence, mémoire et coût.
Un ensemble complet de fonctionnalités derrière un seul moteur. L’équipe avait besoin de plus que des recherches top-K : filtrage scalaire, recherche plein-texte et sémantique, recherche hybride et agrégation. Milvus couvre tout cela, de sorte que des scénarios qui s’étaleraient autrement sur plusieurs systèmes se trouvent derrière une seule API.
Open source, avec une communauté sur laquelle une grande entreprise peut s’appuyer. Milvus est sous licence Apache 2.0 et soutenu par une communauté vaste et active : 46 000+ étoiles GitHub, 10 000+ utilisateurs d’entreprise et 100 M+ de téléchargements.
La solution
La plateforme derrière Kling AI et les autres produits de son groupe exploite Milvus 2.5 et 2.6 et couvre un large éventail de cas d’usage, notamment le contrôle des risques et la sécurité des contenus, la déduplication vidéo, le RAG et les bases de connaissances, la mémoire des agents, la recommandation et le profilage des utilisateurs, ainsi que la recherche multimodale et intermodale. Les embeddings vont de 64 à plus de 10 000 dimensions, le plus grand cluster unique contient plus de 10 milliards de vecteurs et le trafic de pointe dépasse 10 000 QPS.
Ces charges de travail ont des besoins très différents. Certaines ont besoin du plus grand nombre de recherches par seconde, d’autres combinent recherche vectorielle, par mots-clés et par filtres dans une seule requête, et d’autres encore doivent répondre dans une limite de temps stricte. Beaucoup intègrent de nouvelles données sans interruption tout en servant des recherches en direct, et toutes doivent rester disponibles. Les points saillants ci-dessous montrent comment Milvus et l’ingénierie propre à l’équipe répondent à ces exigences.
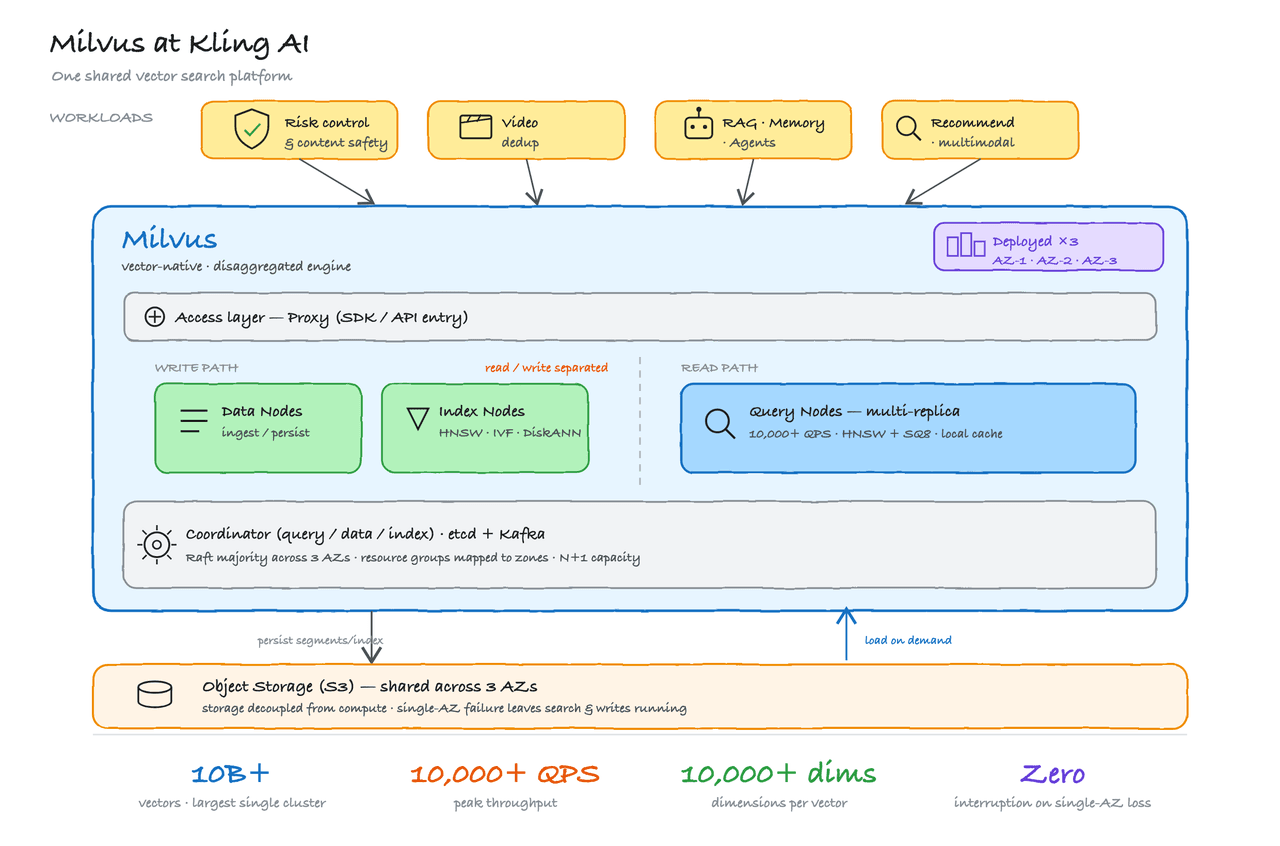
Contrôle des risques et sécurité des contenus : séparation lecture/écriture à 10 000+ QPS sur des milliards de vecteurs
De nouveaux contenus sont écrits dans un cluster unique 24 heures sur 24 et doivent être recherchables presque dès leur arrivée, tandis que les recherches continuent d’affluer. Milvus exécute les écritures et les recherches sur des nœuds distincts, de sorte qu’un pic de nouveaux contenus ne ralentit pas les recherches. HNSW, un index basé sur un graphe, maintient la rapidité de chaque recherche ; la compression SQ8 réduit chaque vecteur à environ un quart de sa taille, ce qui permet de stocker des milliards de vecteurs en mémoire à un coût abordable ; et plusieurs réplicas se partagent la charge des requêtes. Atteindre 10 000+ QPS a aussi nécessité de régler Milvus pour cette échelle, principalement en alignant la taille des chunks de données de Milvus sur les machines de l’équipe et en équilibrant la charge entre les réplicas de différentes zones. Depuis, Milvus 2.6 a intégré une partie de ce réglage au produit.
Déduplication vidéo : recherche HNSW en temps réel sur 10 Md+ vecteurs
Les vidéos téléversées sont échantillonnées en images, chaque image est transformée en embedding, et une collection de plus de 10 milliards de vecteurs est interrogée en temps réel pour repérer les re-téléversements et les copies manipulées, comme un filigrane remplacé ou une image mise en miroir, que les titres et les tags ne détectent pas. La déduplication est l’une des deux plus grosses charges de travail vectorielles de la plateforme : de nouvelles vidéos affluent en permanence, la collection répond à 5 000 à 10 000+ recherches par seconde, et elle doit rester disponible 24 heures sur 24. Milvus l’exécute avec HNSW, et comme les vidéos sont presque toujours ajoutées plutôt que mises à jour, l’index doit rarement être réécrit et reste rapide.
Service à l’échelle de l’entreprise : 100+ clusters automatisés avec le Milvus Operator
Servir les équipes de tout le groupe signifie exploiter Milvus comme une flotte, et non comme un cluster unique. L’équipe a bâti cette flotte sur le Milvus Operator, qui automatise le provisionnement, la mise à l’échelle, les mises à niveau progressives et les changements de configuration, de sorte qu’un nouveau cluster de production est prêt en quelques minutes. La supervision s’appuie sur les tableaux de bord Grafana open-source de Milvus, et Apache SeaTunnel déplace les données entre les clusters et hors de l’ancien moteur. L’équipe a aussi ajouté un agent de planification de capacité basé sur un LLM qui transforme le nombre de vecteurs, le QPS et le budget d’une équipe en une taille de cluster et un index recommandés, que les DBA examinent avant les grands lancements.
Panne de datacenter : reprise sur trois AZ avec les groupes de ressources Milvus
La plateforme est déployée sur trois datacenters (zones de disponibilité) d’une même ville, de sorte que la perte d’un datacenter entier n’arrête ni les recherches ni les écritures. L’architecture de Milvus fait une grande partie du travail. La plupart des services Milvus ne conservent aucune donnée propre, donc n’importe quelle copie peut prendre le relais d’une autre ; l’équipe exécute des copies dans les trois datacenters, et si l’un tombe, les autres continuent. Les nœuds de requête font exception, puisque chacun met en cache une partie des données, et les groupes de ressources Milvus les gèrent en conservant une réplique complète des données interrogeables dans chaque datacenter. L’équipe a ajouté suffisamment de capacité de réserve pour que les deux autres datacenters prennent en charge le trafic critique, et exploite également, dans les trois, le stockage de métadonnées et la file de messages derrière Milvus.
Résultats & Avantages
Des dizaines de milliards de vecteurs en production. Milvus fait tourner les charges de travail les plus importantes de Kling AI et de sa société mère, notamment le contrôle des risques, la sécurité des contenus et la déduplication vidéo. Le plus grand cluster unique contient 10B+ vecteurs répartis sur 400+ nœuds de requête.
10,000+ QPS au pic sur des milliards de vecteurs, avec des écritures et des recherches exécutées simultanément. Comme Milvus sépare l’écriture de la recherche, un afflux de nouveaux contenus ne ralentit plus les recherches - le problème qui a poussé Kling AI à abandonner son moteur précédent.
100+ clusters de production, exploités comme un service à l’échelle de l’entreprise, déployés en moins d’un an. Un nouveau cluster est prêt en quelques minutes, et la plateforme respecte un SLA d’alerte de 99%.
Des embeddings jusqu’à 10,000+ dimensions, bien au-delà de l’ancienne limite de 4,096. Les équipes utilisent la dimension que produisent leurs modèles, à partir de 64, sans modifier leur infrastructure vectorielle.
Zéro interruption en cas de défaillance d’un centre de données. Milvus s’exécute sur trois centres de données de la même ville, avec une réplique complète des données interrogeables dans chacun, de sorte que la perte de l’un n’arrête ni la recherche ni les écritures.
La capacité n’augmente que là où c’est nécessaire. Le stockage et le calcul évoluent séparément, de sorte que l’équipe n’ajoute que la ressource qui lui manque réellement, et les index compressés ou sur disque (SQ8, DiskANN) réduisent les coûts mémoire lorsque la charge de travail le permet.
Globalement, Milvus est devenu le moteur central de recherche vectorielle pour Kling AI et les autres produits de son groupe, couvrant des charges de travail allant du contrôle des risques et de la déduplication au RAG et aux agents. Lorsqu’une nouvelle équipe a besoin de recherche vectorielle, elle demande simplement un cluster Milvus.
Prochaines étapes
L’équipe Kling AI vise à exploiter Milvus de manière encore plus stable et plus rentable, et à l’étendre à davantage de scénarios dans tout le groupe. Elle suit l’architecture de Milvus 3.0, mesure les gains de la mise à niveau et planifie un chemin progressif vers la production. Elle explore également les capacités lakebase qui arrivent avec 3.0, en utilisant des tables externes S3 pour hiérarchiser les données froides, réutiliser les données hors ligne et gérer l’ensemble du cycle de vie de ses vecteurs. Et elle prévoit d’approfondir son travail avec la communauté Milvus, en transformant ce qu’elle apprend en production en retours et contributions.
Contenu
Cas d'usage
Secteur d'activité
Divertissement