




Как Kling AI выполняет векторный поиск на Milvus в масштабе 10B+ и при 10 000+ QPS
10 млрд+
Векторы в крупнейшем едином производственном кластере
10,000+ запросов в секунду
Пиковая пропускная способность, запись и запросы одновременно
10,000+ измерений
Размерность вектора сверх старого ограничения движка в 4 096
Ноль прерываний
Отказ одной зоны доступности (AZ) оставляет поиск и запись работающими
О Kling AI
Kling AI — это модель генерации изображений и видео с помощью ИИ, которой пользуются более 100 миллионов пользователей в 224 странах и регионах. Она входит в состав Kuaishou, который также управляет одной из крупнейших в мире платформ для коротких видео и прямых эфиров с более чем 400 миллионами ежедневно активных пользователей.
 Изображение, созданное с помощью Kling AI
Kling AI и другие продукты материнской компании осуществляют векторный поиск на одной общей платформе, построенной на Milvus. Она обслуживает широкий спектр систем, которые сопоставляют и извлекают контент по смыслу, а не только по ключевым словам: проверка загрузок на безопасность и риски, обнаружение видео, дублирующих уже опубликованные, поддержка мультимодального и семантического поиска, а также основа для функций RAG и агентов. Самый крупный отдельный кластер содержит более 10 миллиардов векторов.
Задача
ИИ вывел продукты за пределы возможностей поиска по ключевым словам, и векторный поиск стал производственным требованием. Изначально команда закрывала эту потребность, расширяя Elasticsearch с помощью индексации приблизительных ближайших соседей, но этого хватало ненадолго, особенно когда нагрузка выросла до десятков миллиардов векторов. При таком масштабе три ограничения стали жёсткими блокерами.
Чтение и запись боролись за одни и те же машины. Контроль рисков и безопасность контента непрерывно загружают новые векторы, одновременно обслуживая онлайн-запросы. В Elasticsearch записи и запросы используют одни и те же узлы, поэтому при высокой конкурентной нагрузке задержка запросов резко возрастала и колебалась именно тогда, когда системам безопасности требовалась стабильность.
Хранилище и вычисления нельзя было масштабировать раздельно. Elasticsearch связывает их вместе, поэтому рост до десятков миллиардов векторов означал добавление целых узлов, памяти и CPU синхронно, даже когда узким местом был только один из них. И кривая затрат, и сложность планирования росли быстрее, чем сами данные.
Жёсткий предел размерности векторов. Elasticsearch ограничивал векторы 4 096 измерениями, что было меньше того, что уже выдавали новые модели эмбеддингов. На практике поисковый движок ограничивал выбор моделей эмбеддингов, которые команды могли внедрять.
Почему Milvus
Команде баз данных Kling AI нужен был специализированный векторный движок, который напрямую решал бы эти три ограничения. После внутренней оценки вендоров векторного поиска на рынке команда баз данных выбрала Milvus для поддержки своих различных сценариев использования ИИ, потому что Milvus предоставляет:
Векторно-нативная раздельная архитектура. Запросы, запись, построение индексов и координация работают как отдельные компоненты, при этом хранилище отделено от вычислений.
Поиск за миллисекунды даже при миллиардах векторов. Когда поиск стоит перед пользователем или решением системы безопасности, именно эта цифра имеет значение.
Несколько типов индексов, чтобы каждая команда настраивала свой компромисс. HNSW, IVF и DiskANN работают вместе со схемами квантования, такими как SQ8 и RaBitQ, с поддержкой размерности векторов в десятки тысяч. Команда, обслуживающая 10 000 QPS, и команда, ищущая по значительно большему корпусу в условиях ограниченной памяти, могут выбрать свою точку на кривой полноты, задержки, памяти и стоимости.
Полный набор функций за одним движком. Команде нужно было больше, чем поиск top-K: скалярная фильтрация, полнотекстовый и семантический поиск, гибридный поиск и агрегация. Milvus покрывает всё это, поэтому сценарии, которые иначе потребовали бы нескольких систем, работают через один API.
Открытый исходный код с сообществом, на которое может опереться крупная компания. Milvus распространяется под лицензией Apache 2.0 и поддерживается большим активным сообществом: более 46 000 звёзд на GitHub, более 10 000 корпоративных пользователей и более 100 миллионов загрузок.
Решение
The platform behind Kling AI and the other products in its group runs Milvus 2.5 and 2.6 and serves a wide range of use cases, including risk control and content safety, video deduplication, RAG and knowledge bases, agent memory, recommendation and user profiling, and multimodal and cross-modal search. Embeddings range from 64 to over 10,000 dimensions, the largest single cluster holds more than 10 billion vectors, and peak traffic exceeds 10,000 QPS.
Those workloads have very different needs. Some need the most searches per second, some combine vector, keyword, and filter search in one query, and some must answer within a strict time limit. Many take in new data nonstop while serving live searches, and all of them have to stay up. The highlights below show how Milvus and the team’s own engineering meet those demands.
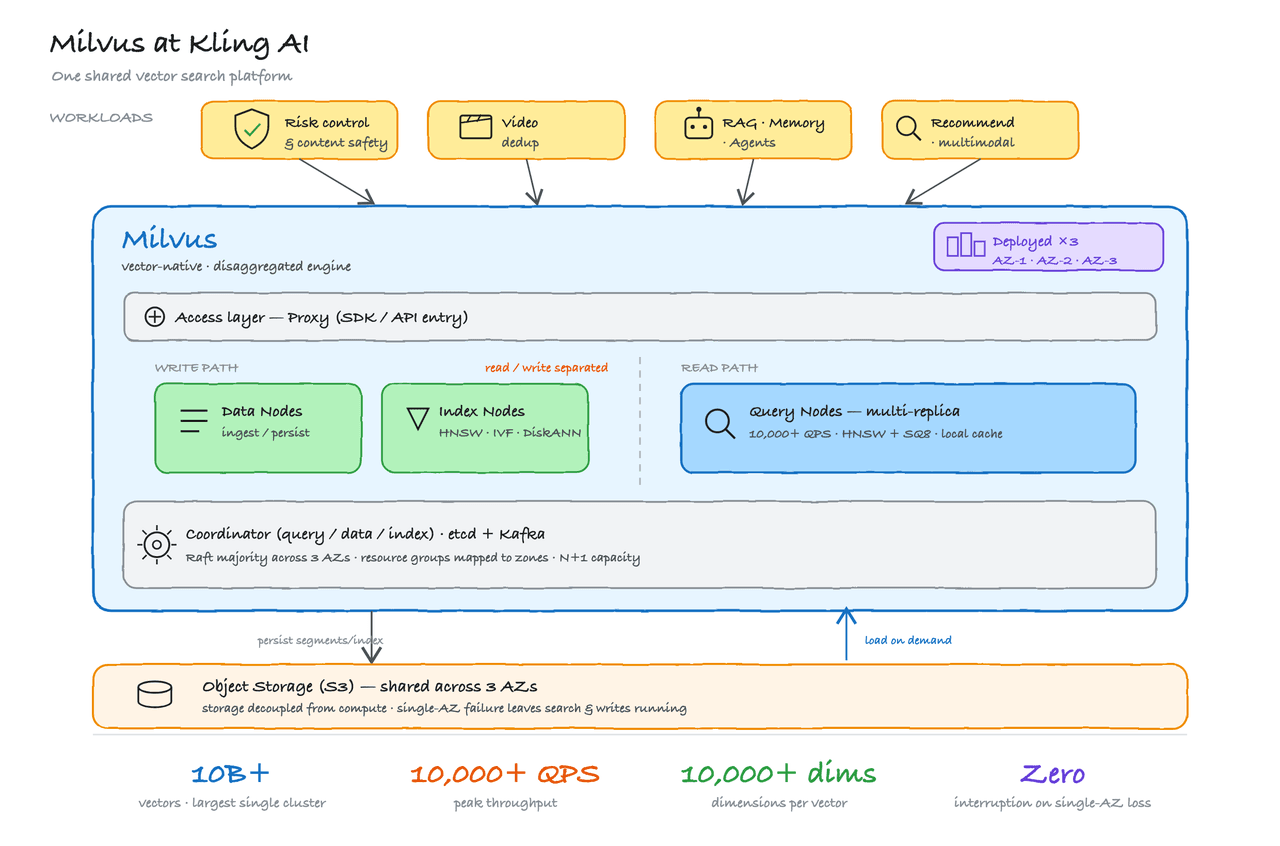
Risk control and content safety: read/write separation at 10,000+ QPS on billions of vectors
New content is written into a single cluster around the clock and must be searchable almost as soon as it lands, while searches keep pouring in. Milvus runs writes and searches on separate nodes, so a surge of new content doesn’t slow searches down. HNSW, a graph-based index, keeps each search fast; SQ8 compression cuts each vector to about a quarter of its size, so billions fit in memory affordably; and several replicas share the query load. Reaching 10,000+ QPS also took tuning Milvus for this scale, mainly matching the size of Milvus’s data chunks to the team’s machines and balancing load across replicas in different zones. Milvus 2.6 has since built part of that tuning into the product.
Video deduplication: real-time HNSW search across 10B+ vectors
Uploaded video is sampled into frames, each frame is embedded, and a collection of more than 10 billion vectors is searched in real time to catch reuploads and manipulated copies, such as a swapped watermark or a mirrored picture, that titles and tags miss. Deduplication is one of the platform’s two largest vector workloads: new videos stream in constantly, the collection answers 5,000 to 10,000+ searches per second, and it has to stay up around the clock. Milvus serves it with HNSW, and because videos are almost always added rather than updated, the index rarely needs rewriting and stays fast.
Company-wide service: 100+ clusters automated with the Milvus Operator
Serving teams across the group means running Milvus as a fleet, not a single cluster. The team built that fleet on the Milvus Operator, which automates provisioning, scaling, rolling upgrades, and configuration changes, so a new production cluster is ready in minutes. Monitoring builds on Milvus’s own open-source Grafana dashboards, and Apache SeaTunnel moves data between clusters and off the old engine. The team also added an LLM-based capacity-planning agent that turns a team’s vector count, QPS, and budget into a recommended cluster size and index, which DBAs review before large launches.
Datacenter outage: three-AZ recovery on Milvus resource groups
The platform runs across three datacenters (availability zones) in the same city, so losing an entire datacenter stops neither search nor writes. Milvus’s architecture does much of the work. Most Milvus services keep no data of their own, so any copy can take over from another; the team runs copies in all three datacenters, and if one goes down, the others carry on. The query nodes are the exception, since each caches part of the data, and Milvus’s resource groups handle them by keeping a full replica of the searchable data in every datacenter. The team added enough spare capacity for the other two datacenters to carry core traffic, and runs the metadata store and message queue behind Milvus in all three as well.
Results & Benefits
Десятки миллиардов векторов в продакшене. Milvus обслуживает крупнейшие рабочие нагрузки Kling AI и её материнской компании, включая риск-контроль, безопасность контента и дедупликацию видео. Крупнейший отдельный кластер хранит более 10B+ векторов на более чем 400+ узлах запросов.
Более 10 000+ QPS в пике на миллиардах векторов при одновременном выполнении записей и поиска. Поскольку Milvus разделяет запись и поиск, поток нового контента больше не замедляет поиск — именно эта проблема заставила Kling AI отказаться от предыдущего движка.
Более 100 продакшен-кластеров, работающих как общекорпоративный сервис, развёрнутых менее чем за год. Новый кластер готов за минуты, а платформа поддерживает SLA по алертингу на уровне 99%.
Эмбеддинги размерностью до 10 000+ измерений, что значительно превышает прежний лимит в 4 096. Команды используют любую размерность, которую выдают их модели, начиная с 64, не меняя свою векторную инфраструктуру.
Ноль прерываний при отказе дата-центра. Milvus работает в трёх дата-центрах в одном городе, причём в каждом есть полная реплика данных, доступных для поиска, поэтому потеря одного не останавливает ни поиск, ни запись.
Ёмкость растёт только там, где это нужно. Хранение и вычисления масштабируются отдельно, поэтому команда добавляет только тот ресурс, которого ей действительно не хватает, а сжатые или дисковые индексы (SQ8, DiskANN) снижают затраты на память там, где это позволяет рабочая нагрузка.
В целом Milvus стала ключевым движком векторного поиска для Kling AI и других продуктов её группы, обслуживая рабочие нагрузки от риск-контроля и дедупликации до RAG и агентов. Когда новой команде нужен векторный поиск, она просто запрашивает кластер Milvus.
Что дальше
Команда Kling AI намерена сделать работу Milvus ещё более стабильной и экономически эффективной, а также расширить её применение на большее число сценариев в рамках группы. Она отслеживает архитектуру Milvus 3.0, измеряет выгоду от обновления и намечает постепенный путь к продакшену. Она также изучает возможности lakebase, появляющиеся в версии 3.0, используя внешние таблицы S3 для многоуровневого хранения холодных данных, повторного использования офлайн-данных и управления полным жизненным циклом своих векторов. И она планирует углубить работу с сообществом Milvus, превращая полученные в продакшене знания в обратную связь и вклад.
Пример использования
Отрасль
Развлечения