Cómo Kling AI ejecuta búsqueda vectorial en Milvus a escala de más de 10 mil millones y más de 10,000 QPS
10B+
Vectores en el clúster de producción individual más grande
10,000+ QPS
Rendimiento máximo, escrituras y consultas a la vez
más de 10,000 dimensiones
Dimensiones por vector, superando el límite de 4,096 del motor anterior
Cero interrupción.
La falla de una sola zona de disponibilidad mantiene la búsqueda y las escrituras en ejecución.
Acerca de Kling AI
Kling AI es un modelo de generación de imágenes y videos con IA con más de 100 millones de usuarios en 224 países y regiones. Forma parte de Kuaishou, que también opera una de las plataformas de video corto y transmisión en vivo más grandes del mundo, con más de 400 millones de usuarios activos diarios.
 Imagen creada mediante Kling AI
Kling AI y los otros productos de su empresa matriz ejecutan la búsqueda vectorial en una plataforma compartida construida sobre Milvus. Sirve a una amplia gama de sistemas que relacionan y recuperan contenido por significado en lugar de solo palabras clave: examinando cargas para seguridad y riesgo, detectando videos duplicados de los ya publicados, impulsando la búsqueda multimodal y semántica, y fundamentando funciones de RAG y agentes. Su clúster individual más grande contiene más de 10 mil millones de vectores.
El desafío
La IA llevó a los productos más allá de lo que podía lograr la coincidencia de palabras clave, y la recuperación vectorial se convirtió en un requisito de producción. El equipo inicialmente lo resolvió ampliando Elasticsearch con indexación aproximada de vecinos más cercanos, pero eso no pudo mantenerse por mucho tiempo, especialmente cuando la carga de trabajo se acercó a decenas de miles de millones de vectores. A esa escala, tres limitaciones se convirtieron en obstáculos difíciles.
Las lecturas y escrituras competían por las mismas máquinas. El control de riesgos y la seguridad de contenido ingieren nuevos vectores continuamente mientras atienden consultas en línea al mismo tiempo. En Elasticsearch, las escrituras y las consultas comparten los mismos nodos, por lo que bajo una carga concurrente intensa, la latencia de las consultas aumentaba y fluctuaba justo cuando los sistemas de seguridad la necesitaban estable.
El almacenamiento y el cómputo no podían escalar por separado. Elasticsearch une ambos, por lo que crecer hasta decenas de miles de millones de vectores significaba añadir nodos completos, memoria y CPU de forma coordinada, incluso cuando solo uno era el cuello de botella. Tanto la curva de costos como la complejidad de la planificación crecieron más rápido que los propios datos.
Un límite duro en las dimensiones de los vectores. Elasticsearch limitaba los vectores a 4,096 dimensiones, por debajo de lo que ya producían los modelos de incrustación más nuevos. En la práctica, el motor de búsqueda limitaba qué modelos de incrustación podían adoptar los equipos.
Por qué Milvus
El equipo de base de datos de Kling AI necesitaba un motor vectorial creado específicamente que abordara directamente esas tres limitaciones. Tras una evaluación interna de los proveedores de búsqueda vectorial en el mercado, el equipo de base de datos eligió Milvus para respaldar sus diversos casos de uso de IA, porque Milvus ofrece:
Una arquitectura nativa de vectores y desagregada. La consulta, la escritura, la construcción de índices y la coordinación se ejecutan como componentes separados, con el almacenamiento desacoplado del cómputo.
Recuperación en milisegundos, incluso con miles de millones de vectores. Cuando la recuperación se sitúa frente a un usuario o una decisión de seguridad, ese es el número que importa.
Múltiples tipos de índice, para que cada equipo ajuste su propia compensación. HNSW, IVF y DiskANN se complementan con esquemas de cuantización como SQ8 y RaBitQ, con soporte para dimensiones vectoriales de decenas de miles. Un equipo que atiende 10,000 QPS y un equipo que busca en un corpus mucho más grande con un presupuesto de memoria ajustado pueden elegir cada uno su propio punto en la curva de recall, latencia, memoria y costo.
Un conjunto de características completo detrás de un solo motor. El equipo necesitaba más que búsquedas top-K: filtrado escalar, búsqueda de texto completo y semántica, búsqueda híbrida y agregación. Milvus cubre todo eso, por lo que los escenarios que de otro modo abarcarían varios sistemas se encuentran detrás de una sola API.
Código abierto, con una comunidad sobre la que una gran empresa puede construir. Milvus está bajo la licencia Apache 2.0 y cuenta con el respaldo de una comunidad grande y activa: 46,000+ estrellas en GitHub, 10,000+ usuarios empresariales y 100M+ descargas.
La solución
La plataforma detrás de Kling AI y los demás productos de su grupo ejecuta Milvus 2.5 y 2.6 y cubre una amplia gama de casos de uso, incluidos control de riesgos y seguridad de contenido, deduplicación de video, RAG y bases de conocimiento, memoria de agentes, recomendación y perfilado de usuarios, y búsqueda multimodal y entre modalidades. Los embeddings van de 64 a más de 10,000 dimensiones, el clúster individual más grande contiene más de 10 mil millones de vectores y el tráfico máximo supera las 10,000 QPS.
Esas cargas de trabajo tienen necesidades muy diferentes. Algunas necesitan la mayor cantidad de búsquedas por segundo, otras combinan búsqueda vectorial, por palabras clave y con filtros en una sola consulta, y algunas deben responder dentro de un límite de tiempo estricto. Muchas ingieren nuevos datos sin parar mientras atienden búsquedas en vivo, y todas deben permanecer operativas. Los aspectos destacados a continuación muestran cómo Milvus y la ingeniería del propio equipo satisfacen esas demandas.
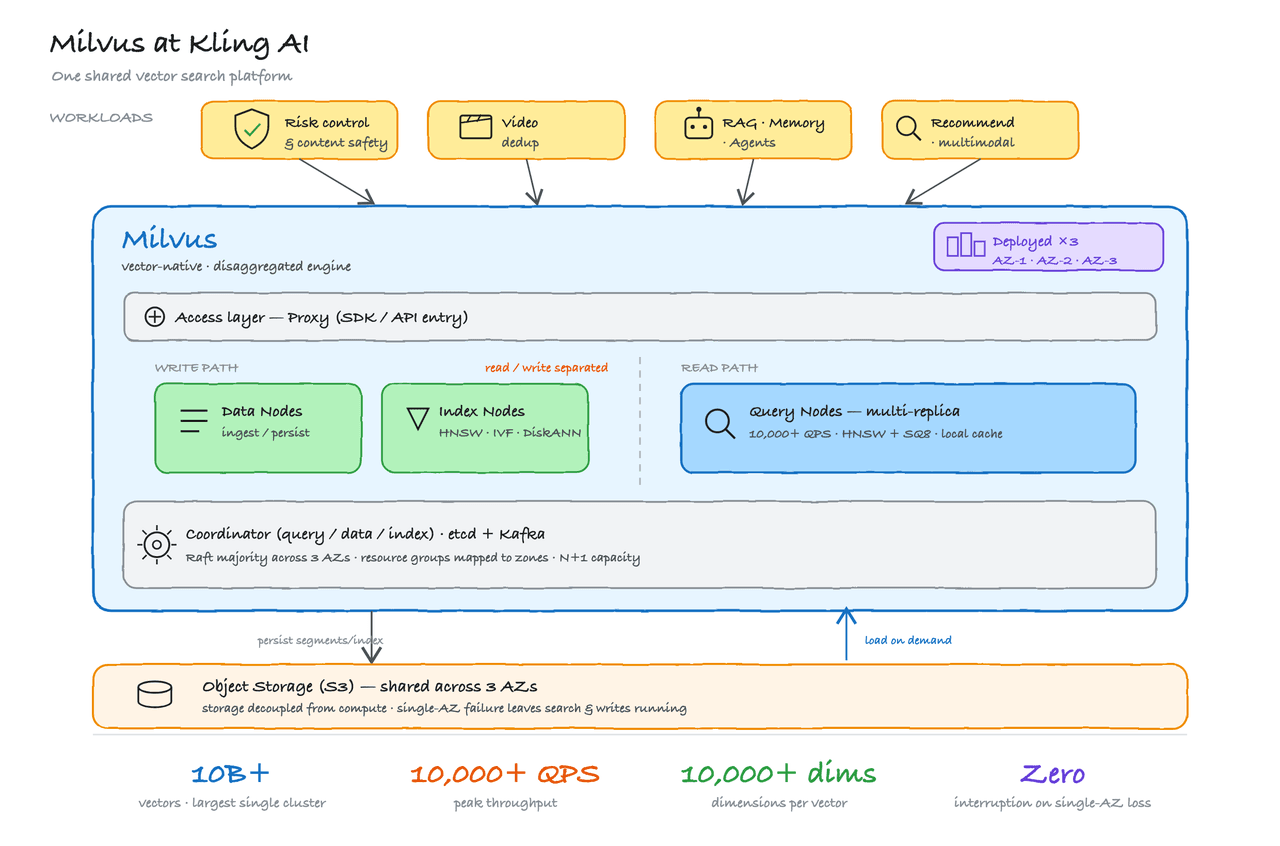
Control de riesgos y seguridad de contenido: separación de lectura/escritura a 10,000+ QPS sobre miles de millones de vectores
El contenido nuevo se escribe en un solo clúster durante todo el día y debe poder buscarse casi tan pronto como llega, mientras las búsquedas siguen entrando sin cesar. Milvus ejecuta escrituras y búsquedas en nodos separados, por lo que una oleada de contenido nuevo no ralentiza las búsquedas. HNSW, un índice basado en grafos, mantiene la rapidez de cada búsqueda; la compresión SQ8 reduce cada vector a aproximadamente una cuarta parte de su tamaño, de modo que miles de millones caben en memoria de manera asequible; y varias réplicas comparten la carga de consultas. Alcanzar las 10,000+ QPS también requirió ajustar Milvus a esta escala, principalmente hacer coincidir el tamaño de los fragmentos de datos de Milvus con las máquinas del equipo y equilibrar la carga entre réplicas en diferentes zonas. Desde entonces, Milvus 2.6 ha incorporado parte de ese ajuste al producto.
Deduplicación de video: búsqueda HNSW en tiempo real sobre 10B+ vectores
El video subido se muestrea en fotogramas, cada fotograma se convierte en un embedding y se busca en tiempo real en una colección de más de 10 mil millones de vectores para detectar re-subidas y copias manipuladas, como una marca de agua intercambiada o una imagen reflejada, que los títulos y las etiquetas no detectan. La deduplicación es una de las dos mayores cargas de trabajo vectoriales de la plataforma: los videos nuevos llegan en streaming de forma constante, la colección responde de 5,000 a 10,000+ búsquedas por segundo y debe permanecer activa las 24 horas. Milvus la atiende con HNSW y, dado que los videos casi siempre se agregan en lugar de actualizarse, el índice rara vez necesita reescribirse y se mantiene rápido.
Servicio para toda la empresa: 100+ clústeres automatizados con el Milvus Operator
Atender a los equipos de todo el grupo significa ejecutar Milvus como una flota, no como un solo clúster. El equipo construyó esa flota sobre el Milvus Operator, que automatiza el aprovisionamiento, el escalado, las actualizaciones progresivas y los cambios de configuración, de modo que un nuevo clúster de producción esté listo en minutos. La monitorización se basa en los paneles de Grafana de código abierto de Milvus, y Apache SeaTunnel mueve datos entre clústeres y fuera del motor anterior. El equipo también añadió un agente de planificación de capacidad basado en LLM que convierte el número de vectores, las QPS y el presupuesto de un equipo en un tamaño de clúster e índice recomendados, que los DBA revisan antes de los lanzamientos importantes.
Corte del centro de datos: recuperación en tres-AZ con los grupos de recursos de Milvus
La plataforma opera en tres centros de datos (zonas de disponibilidad) de la misma ciudad, por lo que perder un centro de datos completo no detiene ni las búsquedas ni las escrituras. La arquitectura de Milvus hace gran parte del trabajo. La mayoría de los servicios de Milvus no conservan datos propios, por lo que cualquier copia puede tomar el relevo de otra; el equipo ejecuta copias en los tres centros de datos y, si uno cae, los demás continúan. Los nodos de consulta son la excepción, ya que cada uno almacena en caché parte de los datos, y los grupos de recursos de Milvus los gestionan manteniendo una réplica completa de los datos buscables en cada centro de datos. El equipo añadió capacidad de reserva suficiente para que los otros dos centros de datos soporten el tráfico principal, y también ejecuta el almacén de metadatos y la cola de mensajes que hay detrás de Milvus en los tres centros de datos.
Resultados y Beneficios
Decenas de miles de millones de vectores en producción. Milvus ejecuta las cargas de trabajo más grandes de Kling AI y de su empresa matriz, incluidos el control de riesgos, la seguridad de contenido y la deduplicación de videos. El clúster individual más grande alberga más de 10 mil millones de vectores distribuidos en más de 400 nodos de consulta.
Más de 10 000 QPS en los picos sobre miles de millones de vectores, con escrituras y búsquedas ejecutándose simultáneamente. Dado que Milvus separa la escritura de la búsqueda, una avalancha de contenido nuevo ya no ralentiza las búsquedas: el problema que llevó a Kling AI a abandonar su motor anterior.
Más de 100 clústeres de producción, operados como un servicio para toda la empresa, creados en menos de un año. Un clúster nuevo está listo en minutos y la plataforma mantiene un SLA de alertas del 99 %.
Embeddings de más de 10 000 dimensiones, muy por encima del antiguo límite de 4096. Los equipos usan cualquier dimensión que produzcan sus modelos, desde 64 en adelante, sin cambiar su infraestructura de vectores.
Cero interrupciones cuando falla un centro de datos. Milvus se ejecuta en tres centros de datos de la misma ciudad, con una réplica completa de los datos buscables en cada uno, por lo que perder uno no detiene ni la búsqueda ni la escritura.
La capacidad crece solo donde se necesita. El almacenamiento y el cómputo escalan por separado, de modo que el equipo añade únicamente el recurso que realmente le falta, y los índices comprimidos o basados en disco (SQ8, DiskANN) reducen los costos de memoria cuando la carga de trabajo lo permite.
En general, Milvus se ha convertido en el motor de búsqueda vectorial principal de Kling AI y de los demás productos de su grupo, atendiendo cargas de trabajo que van desde el control de riesgos y la deduplicación hasta RAG y agentes. Cuando un nuevo equipo necesita búsqueda vectorial, simplemente solicita un clúster de Milvus.
Lo que sigue
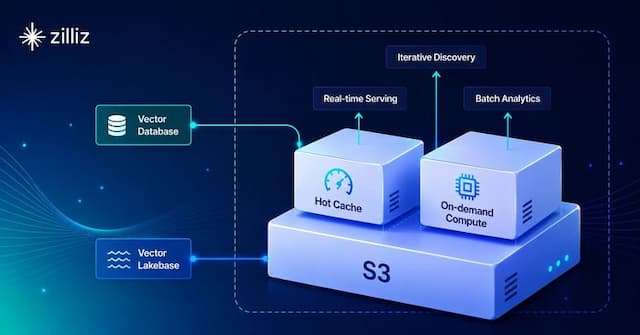
El equipo de Kling AI pretende ejecutar Milvus de manera aún más estable y rentable, y extenderlo a más escenarios en todo el grupo. Está dando seguimiento a la arquitectura de Milvus 3.0, midiendo los beneficios de la actualización y trazando un camino gradual hacia la producción. También está explorando las capacidades de lakebase que llegarán con 3.0, usando tablas externas de S3 para mover datos fríos a niveles inferiores, reutilizar datos fuera de línea y gestionar el ciclo de vida completo de sus vectores. Y planea profundizar su trabajo con la comunidad de Milvus, convirtiendo lo que aprende en producción en retroalimentación y contribuciones.