




Milvusストレージ・システムの概要と、そのパフォーマンスを評価し最適化するテクニック
Milvus](https://zilliz.com/what-is-milvus)の探索へようこそ。Milvusは、その素晴らしい水平スケーラビリティと電光石火のパフォーマンスで知られるオープンソースのベクトルデータベースです。Milvusの核となるのは堅牢なストレージシステムであり、信頼性の高いデータの永続化と保存のための重要な基盤です。このシステムは、メタ・ストレージ、ログ・ブローカー、オブジェクト・ストレージといういくつかの重要なコンポーネントから構成されている。
このガイドでは、Milvusのアーキテクチャを掘り下げ、主要なストレージコンポーネントを分解し、それらのパフォーマンスを評価するための効果的なテクニックを探ります。
Milvusアーキテクチャの概要
Milvusは、ストレージとコンピューティングの分離を保証し、コンピューティングノードの水平スケーラビリティをサポートする分散型アーキテクチャを採用している。このセットアップは、アクセスレイヤー、コーディネータサービス、ワーカーノード、ストレージの4つの主要なレイヤーで構成され、それぞれが独立してスケーラブルでディザスタリカバリに最適化されている。
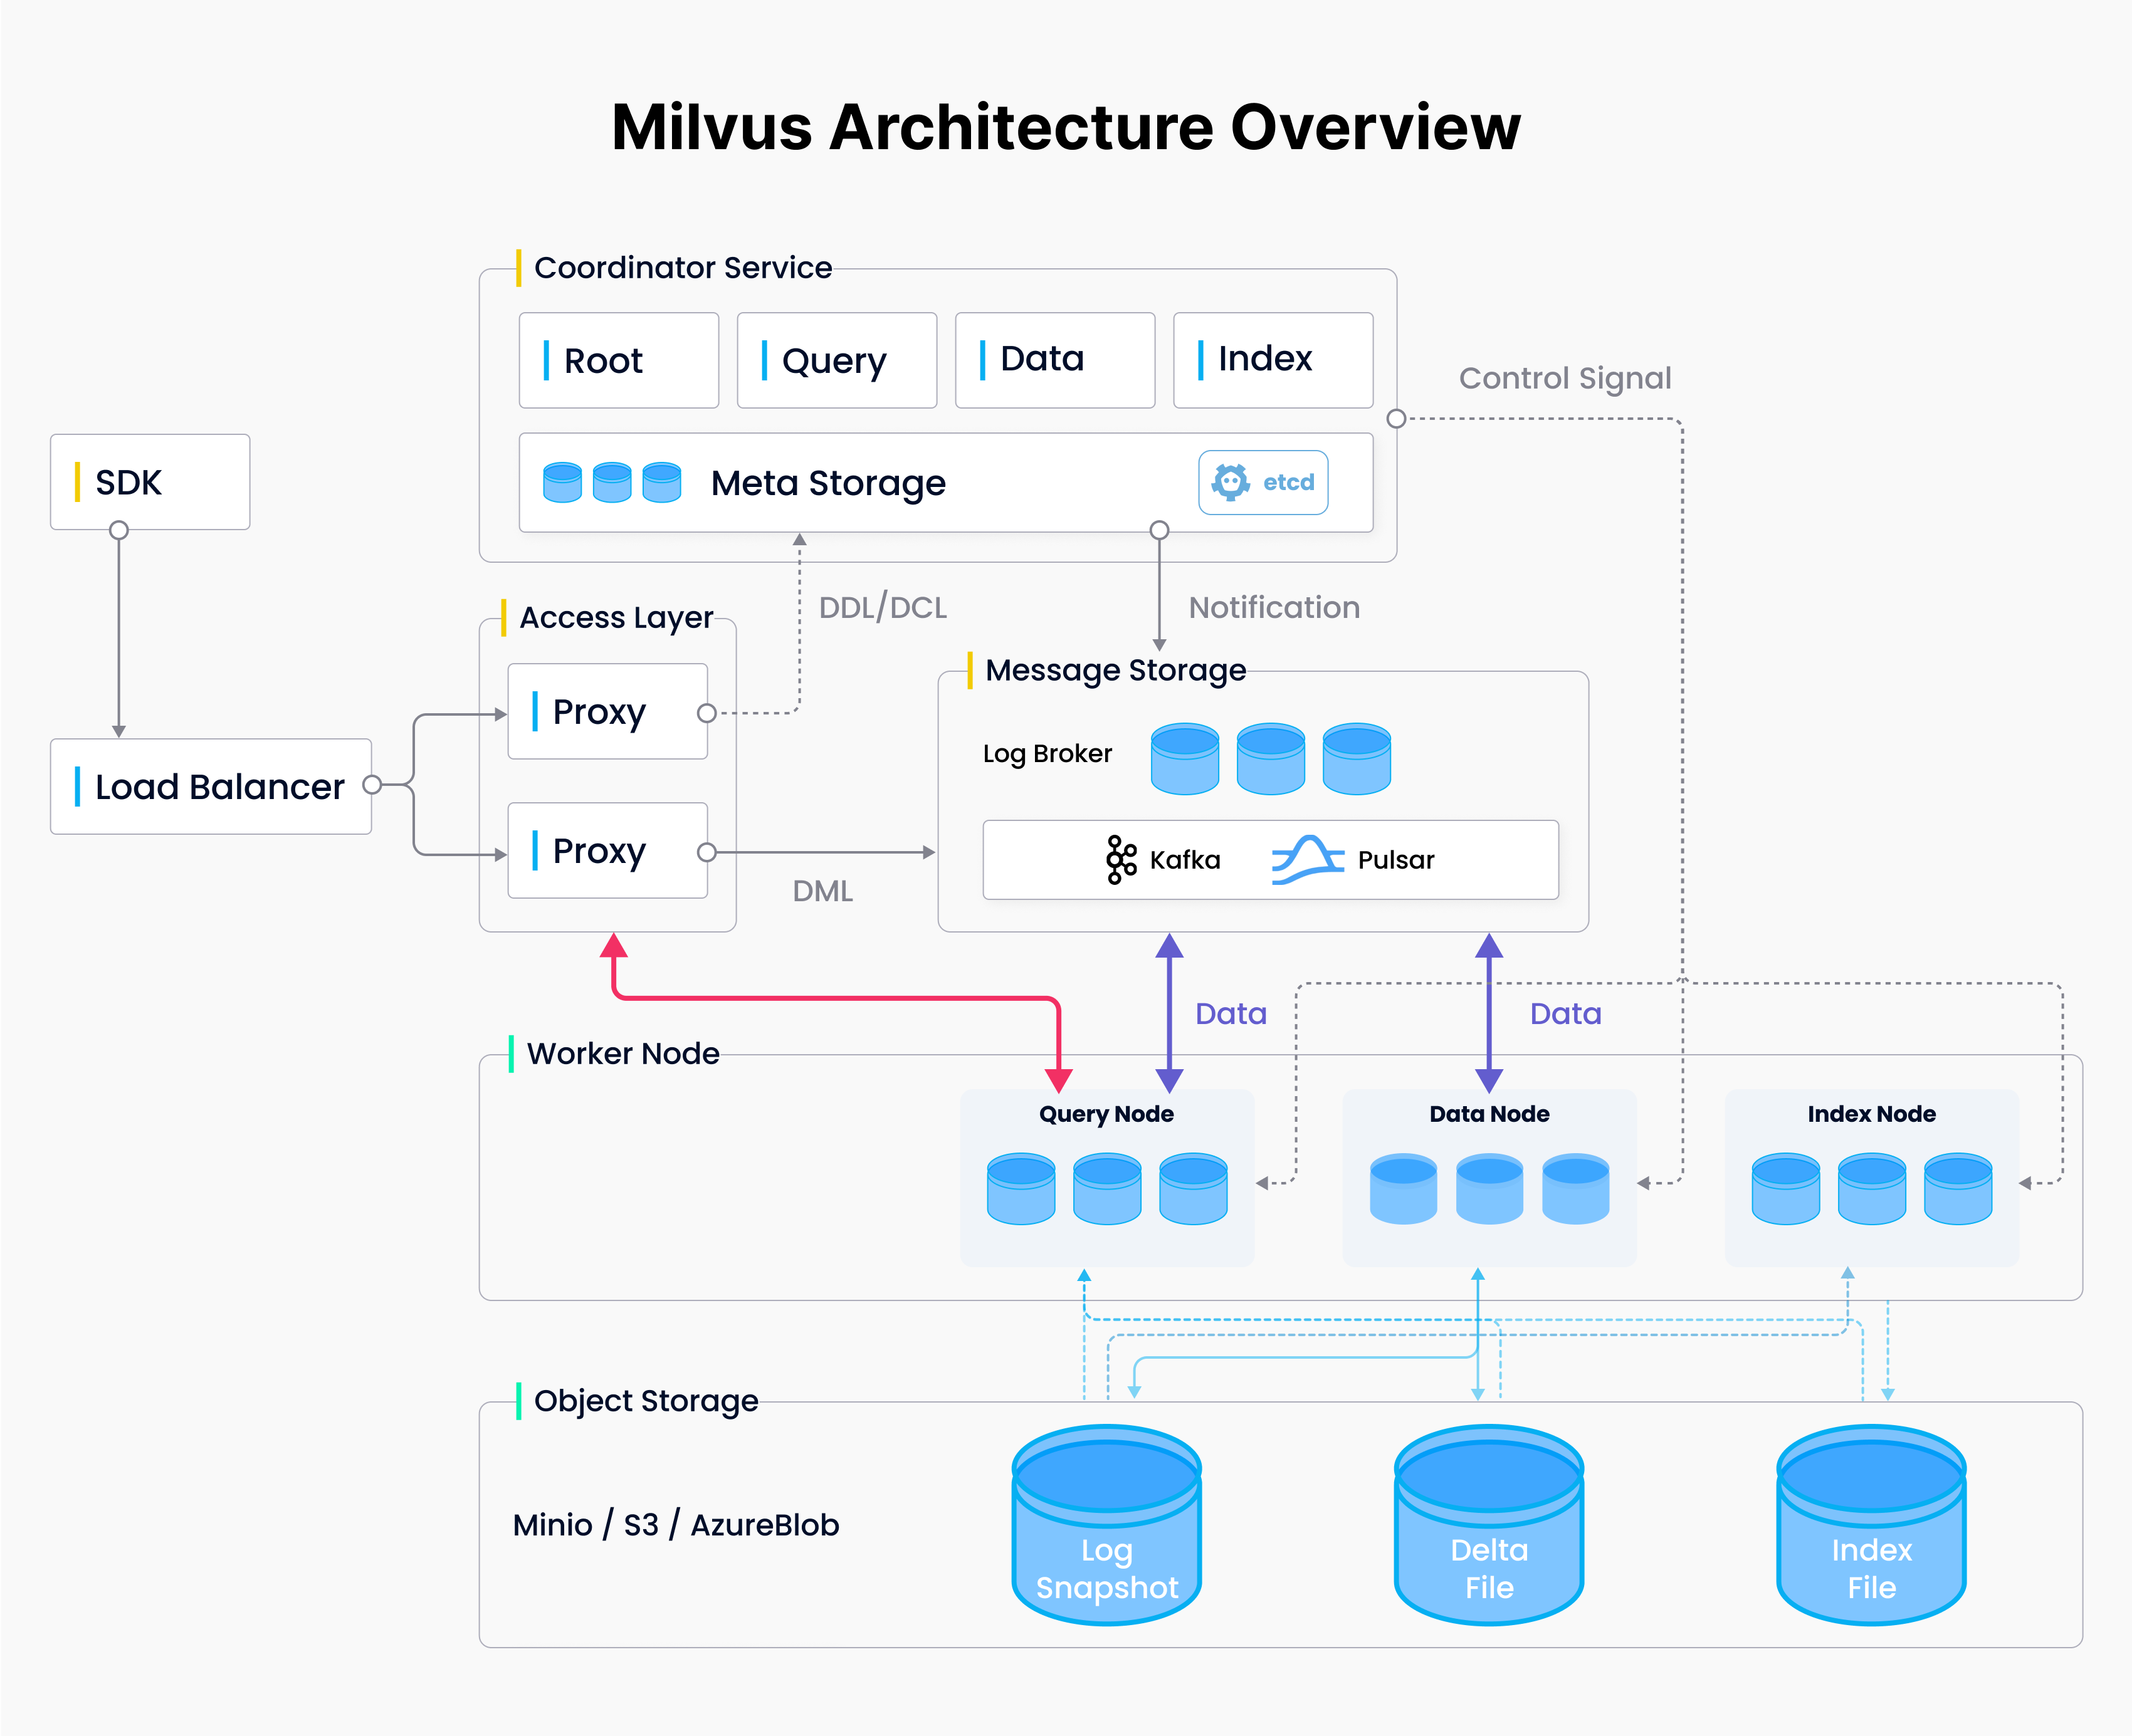 Milvusアーキテクチャ概要.png
アクセス層:**このフロントエンド層は、ユーザーリクエストを処理し、レスポンスを最適化するステートレスプロキシで構成され、システムの主要なユーザーインターフェイスとして機能する。
コーディネータ層:** システムの中央コマンドとして動作するコーディネータサービスは、ワーカーノード間のタスク分散、クラスタトポロジー、ロードバランシング、データ管理を管理します。
ワーカー・ノード: **コーディネーター・サービスの指示の下、データ操作言語(DML)コマンドを処理する実行ノードです。
ストレージ:** データ永続化の基本となるこのレイヤーには、メタ・ストレージ、ログ・ブローカー、オブジェクト・ストレージが含まれ、データの整合性と可用性を確保する。
Milvusストレージコンポーネント
Milvusはデータの完全性と可用性を確保するために3つの主要なストレージコンポーネントを使用します:**メタストレージ、オブジェクトストレージ、ログブローカーです。
メタ・ストレージ
Milvusのメタストレージは、コレクションスキーマ、ノードステータス、メッセージ消費チェックポイントなどのメタデータスナップショットを保存します。高可用性、強力な一貫性、およびトランザクションサポートの必要性を考慮し、Milvusはメタストレージソリューションとしてetcdを利用しています。etcdは堅牢な分散キーバリューストアであり、Milvus内の分散システムにとって極めて重要である。etcd**は、メタデータの保存と並行して、サービスの登録やヘルスチェックなどのタスクを処理します。
オブジェクトストレージ
Milvusのオブジェクトストレージは、ログのスナップショットファイル、スカラーデータおよびベクトルデータのインデックスファイル、および中間クエリ結果のストレージを処理します。Milvusでは、オブジェクトストレージとしてMinIOを統合しています。これは、その高いパフォーマンスとKubernetesとの互換性により、AWS S3やAzure Blob Storageのようなクラウド環境でのシームレスな運用を容易にしています。
ログブローカー
Milvusのログブローカーは、再生機能を持つpub-subシステムを採用しています。ストリーミングデータの永続化、信頼性の高い非同期クエリの実行、イベント通知、クエリ結果の返送に不可欠です。また、ワーカーノードがシステムダウンから復旧する際の増分データの整合性も保証します。デプロイメントによって、Milvusは異なるログブローカツールを使用します。Milvus ClusterセットアップではPulsarまたはKafkaを使用し、Milvusスタンドアロン版では通常RocksDBを使用します。
Milvusストレージの性能評価と最適化方法
ストレージのパフォーマンスを常に評価し、改善することは極めて重要である。
Etcd:Milvusのメタデータ・ストア
Etcdは分散システム用に設計された堅牢な分散キーバリューストアです。Milvusでは、etcdはコレクションスキーマ、ノードステータス、メッセージ消費チェックポイントなどの重要なデータを格納するメタデータストアです。
ディスクの書き込みレイテンシはetcdのパフォーマンスにとって非常に重要です。ディスクの速度が遅いとリクエストのレイテンシが大幅に増加し、システムの安定性が損なわれる恐れがあります。遅いディスク速度はリクエストの待ち時間を大幅に増加させ、システムの安定性を危険にさらす。本番環境で最適なパフォーマンスを得るには、少なくとも 500 のシーケンシャル IOPS (1 秒あたりの入出力操作) を維持することを推奨し、fdatasync の持続時間の 99% が 10 ミリ秒未満であることを保証する。etcdは通常、中程度のディスク帯域幅しか要求しないが、この帯域幅を増加させることでリカバリ時間を大幅に短縮できる。そのため、本番環境では最低 100MB/s のディスク帯域幅を推奨する。
お使いのストレージソリューションがこれらの基準を満たしているかどうかを確認するには、ディスクベンチマークツールであるFioを使用してパフォーマンス評価を行うことを検討してください。以下は、Fioを使用してストレージ性能を評価する方法のガイドです。
まず、Fioがシステムにインストールされていることを確認します。次に、ストレージがマウントされているディレクトリをtest-data ディレクトリとして指定して、以下のコマンドを実行します。このディレクトリはストレージ接続ポイントの下にあるはずです。
fio --rw=write --ioengine=sync --fdatasync=1 --directory=test-data --size=22m --bs=2300 --name=mytest
結果を調べて、fdatasync の継続時間の 99% が 10ms 未満であり、書き込み IOPS が 500 以上であることを確認する。これらの条件が満たされていれば、ストレージの性能は十分である。
以下は出力結果の例である:
ジョブ: 1 (f=1):[W(1)][100.0%][w=1771KiB/s][w=788 IOPS][eta 00m:00s].
mytest: (groupid=0, jobs=1): err= 0: pid=703: Mon Jul 25 08:36:48 2022
 書き込み:IOPS=967, BW=2173KiB/s (2225kB/s)(220MiB/103664msec); 0ゾーンリセット
   clat (nsec): min=1903, max=29662k, avg=287307.76, stdev=492386.04
    緯度(nsec):最小値=1981、最大値=29662k、平均値=287583.67、標準偏差=492438.10
   クラットのパーセンタイル(usec):
    | 1.00th=[[3]、5.00th=[[4]、10.00th=[[4]、20.00th=[[5]、
    | 30.00th=[ 6], 40.00th=[ 9], 50.00th=[ 233], 60.00th=[ 343]、
    | 70.00位=[ 437], 80.00位=[ 553], 90.00位=[ 701], 95.00位=[ 742]、
    | 99.00位=[ 1172], 99.50位=[ 2114], 99.90位=[ 6390], 99.95位=[ 8455]、
    | 99.99th=[15533]である。
  bw ( KiB/s) : min= 1630, max= 2484, per=100.00%, avg=2174.66, stdev=193.65, samples=207
  iops : 最小値726、最大値1106、平均値968.37、標準偏差86.19、サンプル数207
 lat (usec) : 2=0.03%, 4=16.49%, 10=27.68%, 20=3.21%, 50=0.71
 lat (usec) : 100=0.27%, 250=2.65%, 500=24.64%, 750=20.40%, 1000=2.57
 lat(msec):2=0.82%、4=0.30%、10=0.18%、20=0.03%、50=0.01
 fsync/fdatasync/sync_file_range:
   同期(usec):最小値309、最大値21848、平均値741.93、標準偏差489.64
   同期パーセンタイル(usec):
    | 1.00th=["392"]、5.00th=["437"]、10.00th=["474"]、20.00th=["529"]、
    | 30.00位=[ 578], 40.00位=[ 619], 50.00位=[ 660], 60.00位=[ 709]、
    | 70.00位=[ 742], 80.00位=[ 791], 90.00位=[ 988], 95.00位=[ 1369]、
    | 99.00位=[ 2442], 99.50位=[ 3523], 99.90位=[ 6915], 99.95位=[ 8586]、
    | 99.99th=[11994]である。
クラウド環境でMilvusクラスタを展開する場合、etcd用のブロックストレージの適切なタイプを選択することは、ディスク性能に敏感であるため非常に重要です。クラウド・プロバイダーは様々なブロック・ストレージ・オプションを提供しており、それぞれが異なるワークロードに適した明確な性能特性を持っています。
以下は、さまざまなクラウドプロバイダが推奨するボリュームタイプとパフォーマンスメトリクスです。
| クラウド・プロバイダー** | ボリューム・タイプ | サイズ | IOPS | P99シンク |
| AWS | gp3 | 20Gi | 660 | 4.3ms |
| GCP|pd-ssd|20Gi|1262|1.3ms||です。 | ||||
| Azure|PremiumV2|20Gi|705|2.6ms | ||||
| アリユン|cloud_essd|20Gi|1137|3.5ms||。 |
Fioを使用して、選択したブロックストレージがMilvus展開内でetcdを最適に機能させるために必要なパフォーマンスベンチマークを満たしていることを確認することもできます。
MinIO:Milvusオブジェクトストレージツール
MinIOは、クラウドネイティブなワークロード向けに最適化された、高性能なKubernetesネイティブなオブジェクトストレージソリューションです。MilvusはMinIOを利用して、ログのスナップショットファイル、スカラーデータとベクトルデータのインデックスファイル、中間クエリ結果を保存します。
MinIOのようなオブジェクトストレージのパフォーマンスは、主にIOPSではなくI/Oスループットで評価される。この指標は、コレクションのロード、インデックスの構築、データの挿入など、Milvusの様々な操作に大きく影響します。ネットワーク帯域幅、Linuxカーネルのパフォーマンスチューニング、個々のディスクドライブのパフォーマンスなど、多くの要因がMinIOのスループットパフォーマンスに影響します。ディスク性能は特に重要です。
ddコマンドを使用して、単一ドライブのパフォーマンスを測定できます。DDは、あるファイルから別のファイルへデータをビット単位でコピーするUnixツールである。各読み取りと書き込みのブロックサイズを制御するためのさまざまなオプションが用意されている。
以下の例では、16MBのブロック・サイズで1台のNVMeドライブをテストする場合、64カウントのO_DIRECTオプションを使用すると、ドライブ1台あたり毎秒2GBを超える書き込み性能が発生する。
$ dd if=/dev/zero of=/mnt/drive/test bs=16M count=64 oflag=direct
64+0レコードイン
64+0レコード出力
1073741824 バイト (1.1 GB, 1.0 GiB) コピー、0.443096 秒、2.4 GB/s
同じ例で、1台のNVMeドライブを16MBのブロックサイズでテストした場合、64カウントのO_DIRECTオプションを使用すると、1ドライブあたり毎秒5GBを超える読み取りパフォーマンスが発生します。
$ dd of=/dev/null if=/mnt/drive/test bs=16M count=64 iflag=direct
64+0レコード入り
64+0レコード出力
1073741824 バイト (1.1 GB, 1.0 GiB) コピー、0.187263 秒、5.7 GB/s
ディスクドライブの読み取りおよび書き込み性能が高いほど、MinIOの全体的なスループット性能が向上します。最適な結果を得るには、MinIOセットアップのストレージディスクとしてSSDまたはNVMeタイプのドライブを使用することをお勧めします。これらのドライブは、MinIOの操作の高スループット要件を効果的にサポートすることができる。MinIOストレージにSAN/NASアプライアンスを使用することは避ける。このようなセットアップでは、システムの効率と応答性を低下させる可能性のある並行性の問題やパフォーマンスのボトルネックが発生することがよくあります。
Pulsar/Kafka:Milvusログ・ブローカー・ツール
上述したように、Milvusは特定の導入モードに合わせて異なるログ・ブローカー・ツールを使用します。MilvusクラスタのセットアップではPulsarまたはKafkaを使用し、Milvusスタンドアロン版では通常RocksDBを使用します。
PulsarとKafkaはどちらも、永続的メッセージ・ストレージをサポートし、メッセージ・コンシューマに高いスループットを提供するよう設計されています。これらの性能は、シーケンシャルなディスクI/O操作に依存しているため、使用するディスク・ストレージのタイプに決定的に依存します。
Pulsarにとって、データの完全性と耐久性を保証するBookKeeperのジャーナル・ファイルには高性能ディスクが不可欠であり、低遅延SSDはこの目的にとって非常に有益です。Pulsar LedgersとKafkaの両方が、ファイル・システム・キャッシュを活用し、HDDとSSDで良好なパフォーマンスを発揮するよう、ディスク効率に最適化されています。しかし、待ち時間の影響を受けやすいアプリケーションや大規模な展開には、SSDが性能面で大きなメリットをもたらします。
パフォーマンスを最適化するには、PulsarとKafkaに複数のディスク・デバイスを使用します。特にPulsarについては、ジャーナルと一般ストレージに別々のディスクを使用することで、ブッキーは書き込み操作のレイテンシを読み込み操作から切り離すことができます。最適なレイテンシを確保するため、データ、アプリケーション・ログ、その他のOSファイルシステムのアクティビティの保存に同じドライブを使用しないでください。これらのドライブは、RAIDを使用して1つのボリュームとして構成することも、各ドライブをフォーマットして独自のディレクトリとしてマウントすることもできる。ネットワーク・アタッチド・ストレージ(NAS)は、パフォーマンスが遅く、レイテンシが高く変動しやすく、単一障害点となる可能性があるため、避けるべきである。
まとめ
Milvusストレージシステムの徹底的な調査により、そのアーキテクチャとコンポーネントに関する包括的な洞察が得られた。Milvusの3つの主要なストレージコンポーネント(メタ・ストレージ、オブジェクト・ストレージ、ログ・ブローカー)を解剖し、それらのパフォーマンスを評価し、強化するための戦略を提供します。
 Fendy Feng
 is the Technical Marketing Writer at Zilliz. She has extensive experience developing and enhancing the impact of open-source projects in various global markets by producing high-quality, tailored content. Before joining Zilliz, Fendy worked as a Content Strategist at PingCAP, a fast-growing E-Series startup renowned for its open-source distributed SQL database.
 Jay Zhu
 is the Senior Software Engineer and tech leader of the DevOps & Infrastructure team at Zilliz. He specializes in DevOps, cloud-native technologies, and Kubernetes projects. Additionally, Jay is actively involved in developing and maintaining various open-source projects, including Milvus, Milvus-helm, and Milvus-operator.
読み続けて
Top 10 Context Engineering Techniques You Should Know for Production RAG
A practical guide to context engineering for production LLM systems, covering RAG, context processing, memory, agents, and multimodal context.

How to Build an Enterprise-Ready RAG Pipeline on AWS with Bedrock, Zilliz Cloud, and LangChain
Build production-ready enterprise RAG with AWS Bedrock, Nova models, Zilliz Cloud, and LangChain. Complete tutorial with deployable code.

The Real Bottlenecks in Autonomous Driving — And How AI Infrastructure Can Solve Them
Autonomous driving faces a data bottleneck. Learn how AI-native vector databases like Zilliz solve scale, cost, and insight challenges across AV pipelines.