Как без проблем перенести ваши данные в Milvus: подробное руководство
Milvus — это надежная векторная база данных с открытым исходным кодом для поиска по сходству, которая может хранить, обрабатывать и извлекать миллиарды и даже триллионы векторных данных с минимальной задержкой. Она также обладает высокой масштабируемостью, надежностью, является облачно-нативной и функционально богатой. Последний релиз Milvus представляет еще больше интересных функций и улучшений, включая поддержку GPU для более чем 10-кратного ускорения производительности и MMap для увеличения емкости хранения на одной машине.
По состоянию на сентябрь 2023 года Milvus получил почти 23 000 звезд на GitHub и имеет десятки тысяч пользователей из различных отраслей с разными потребностями. Он становится еще более популярным по мере распространения технологий генеративного ИИ, таких как ChatGPT. Это важный компонент различных AI-стеков, особенно фреймворка retrieval augmented generation, который решает проблему галлюцинаций больших языковых моделей.
Чтобы удовлетворить растущий спрос со стороны новых пользователей, которые хотят перейти на Milvus, и существующих пользователей, желающих обновиться до последних версий Milvus, мы разработали Milvus Migration. В этом блоге мы рассмотрим функции Milvus Migration и покажем, как быстро перенести ваши данные в Milvus из Milvus 1.x, FAISS, Elasticsearch 7.0 и более поздних версий.
Milvus Migration, мощный инструмент миграции данных
Milvus Migration — это инструмент миграции данных, написанный на Go. Он позволяет пользователям беспрепятственно переносить данные из старых версий Milvus (1.x), FAISS, а также Elasticsearch 7.0 и более поздних версий в версии Milvus 2.x.
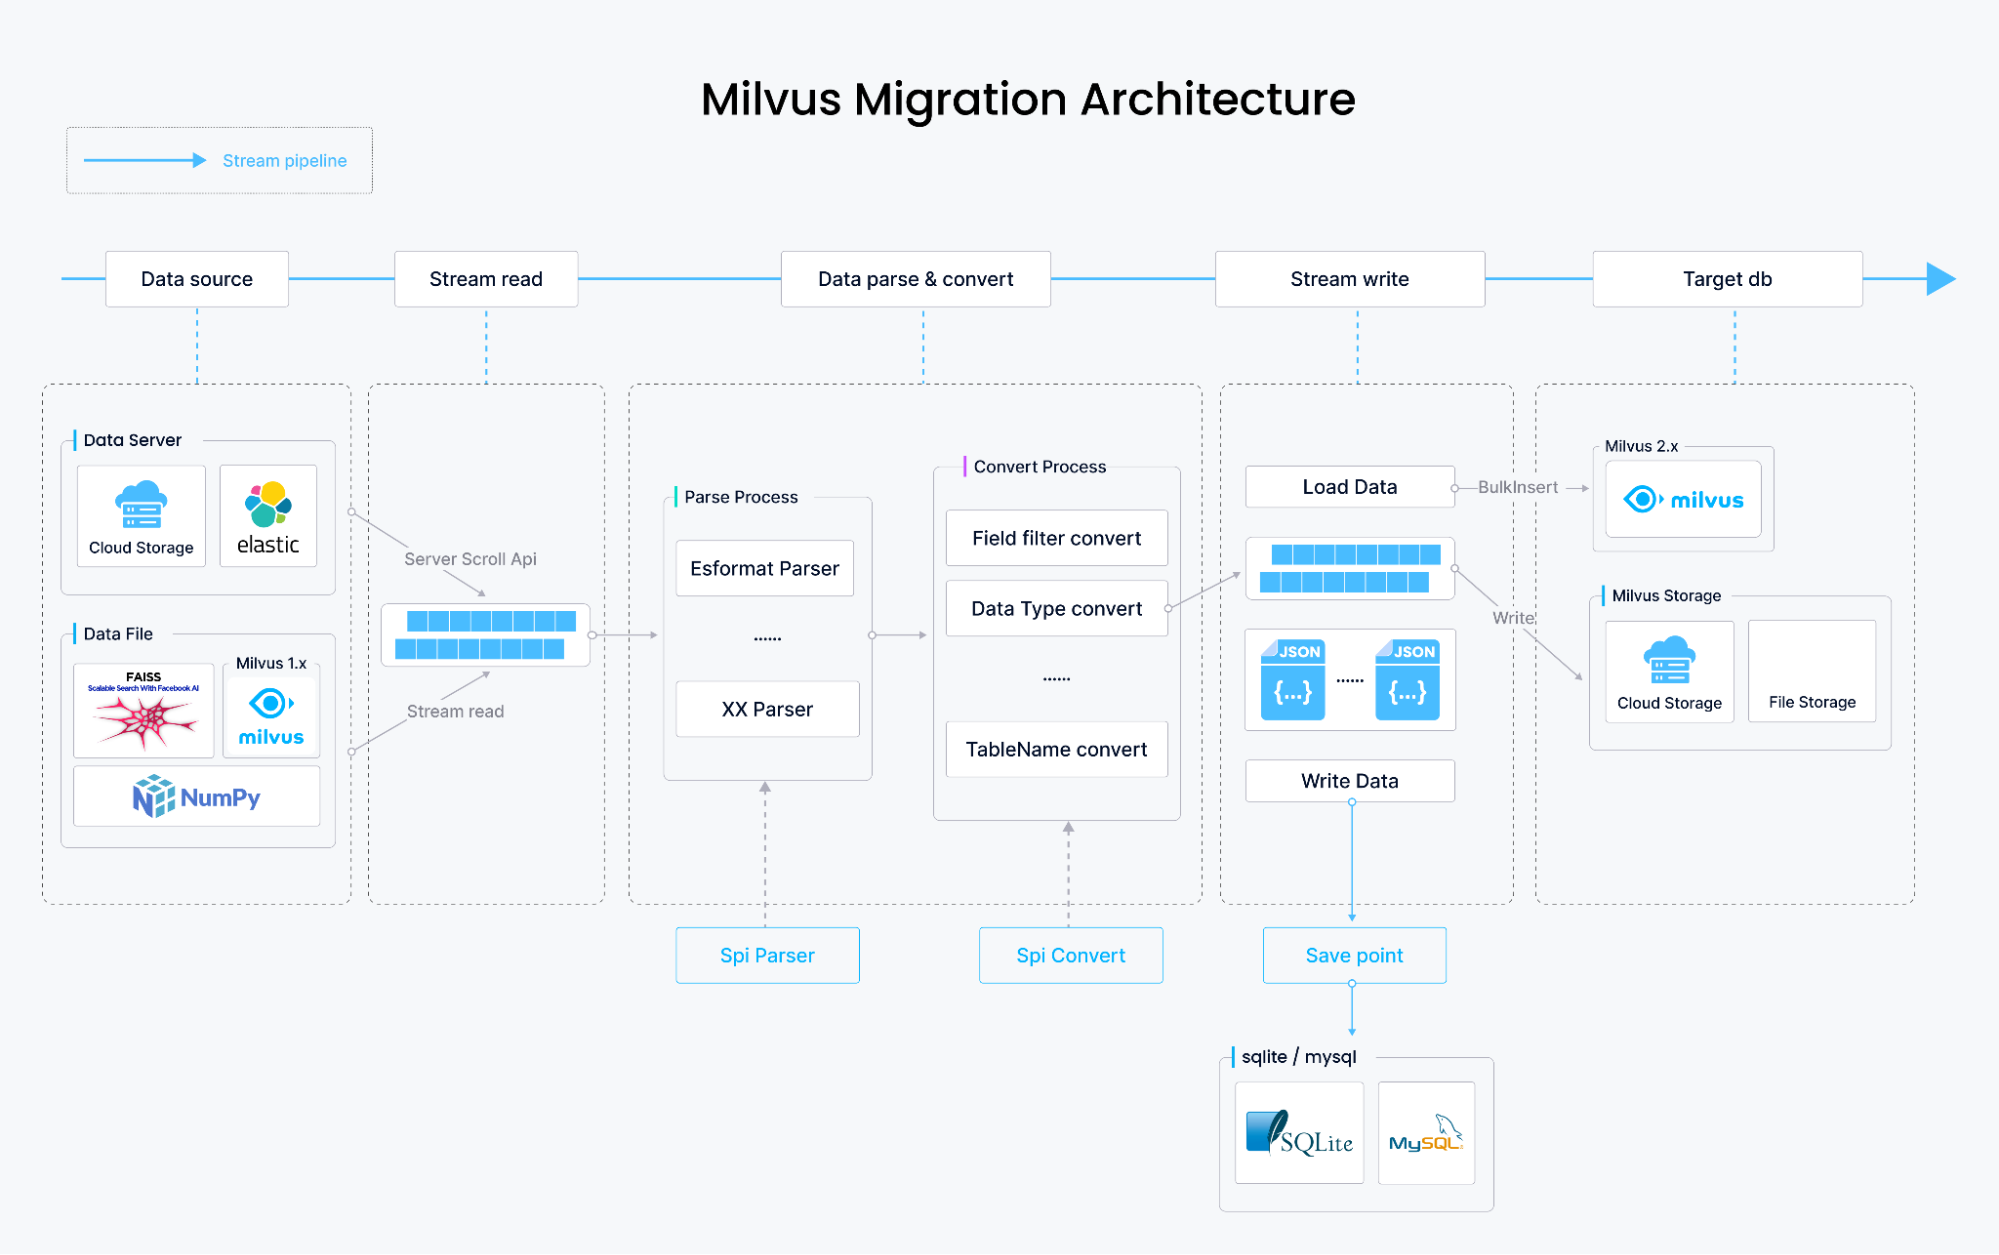
Диаграмма ниже показывает, как мы построили Milvus Migration и как он работает.
Как Milvus Migration переносит данные
Из Milvus 1.x и FAISS в Milvus 2.x
Миграция данных из Milvus 1.x и FAISS включает разбор содержимого исходных файлов данных, преобразование их в формат хранения данных Milvus 2.x и запись данных с помощью bulkInsert из Milvus SDK. Весь этот процесс является потоковым, теоретически ограничен только дисковым пространством и сохраняет файлы данных на вашем локальном диске, S3, OSS, GCP или Minio.
Из Elasticsearch в Milvus 2.x
При миграции данных Elasticsearch извлечение данных отличается. Данные получают не из файлов, а последовательно извлекают с помощью scroll API Elasticsearch. Затем данные разбираются и преобразуются в формат хранения Milvus 2.x, после чего записываются с использованием bulkInsert. Помимо миграции векторов типа dense_vector, хранящихся в Elasticsearch, Milvus Migration также поддерживает миграцию других типов полей, включая long, integer, short, boolean, keyword, text и double.
Набор функций Milvus Migration
Milvus Migration упрощает процесс миграции благодаря своему мощному набору функций:
Поддерживаемые источники данных:
Milvus 1.x в Milvus 2.x
Elasticsearch 7.0 и более поздние версии в Milvus 2.x
FAISS в Milvus 2.x
Несколько режимов взаимодействия:
Интерфейс командной строки (CLI) с использованием фреймворка Cobra
Restful API со встроенным Swagger UI
Интеграция в качестве Go module в другие инструменты
Универсальная поддержка форматов файлов:
Локальные файлы
Amazon S3
Object Storage Service (OSS)
Google Cloud Platform (GCP)
Гибкая интеграция с Elasticsearch:
Миграция векторов типа
dense_vectorиз ElasticsearchПоддержка миграции других типов полей, таких как long, integer, short, boolean, keyword, text и double
Определения интерфейсов
Milvus Migration предоставляет следующие ключевые интерфейсы:
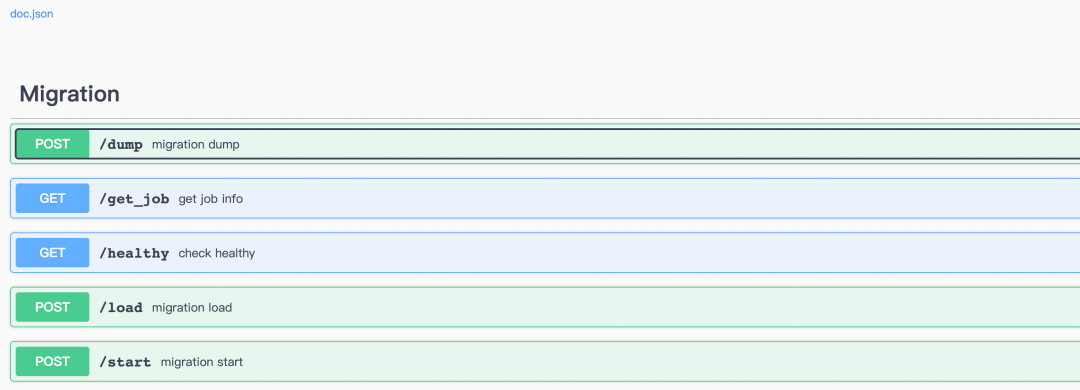
/start: Инициирует задание миграции (эквивалентно комбинации dump и load, в настоящее время поддерживает только миграцию ES)./dump: Инициирует задание dump (записывает исходные данные в целевой носитель хранения)./load: Инициирует задание load (записывает данные из целевого носителя хранения в Milvus 2.x)./get_job: Позволяет пользователям просматривать результаты выполнения задания. (Подробнее см. server.go проекта)
Далее в этом разделе используем несколько примеров данных, чтобы разобраться, как пользоваться Milvus Migration. Вы можете найти эти примеры здесь на GitHub.
Миграция из Elasticsearch в Milvus 2.x
- Подготовьте данные Elasticsearch
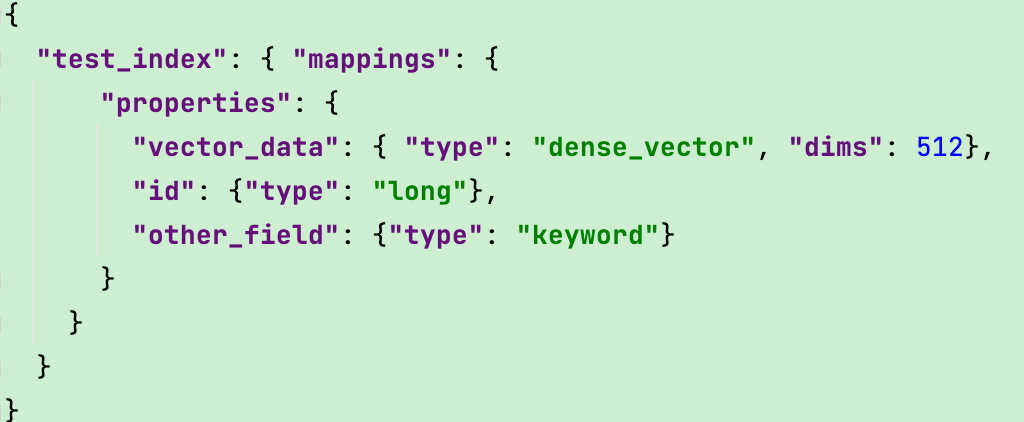
Чтобы мигрировать данные Elasticsearch, у вас уже должен быть настроен собственный сервер Elasticsearch. Векторные данные следует хранить в поле dense_vector и индексировать их вместе с другими полями. Сопоставления индекса показаны ниже.
- Скомпилируйте и соберите
Сначала загрузите исходный код Milvus Migration с GitHub. Затем выполните следующие команды, чтобы скомпилировать его.
go get
go build
На этом шаге будет создан исполняемый файл с именем milvus-migration.
- Настройте
migration.yaml
Перед началом миграции необходимо подготовить конфигурационный файл с именем migration.yaml, который включает информацию об источнике данных, целевом объекте и других соответствующих настройках. Вот пример конфигурации:
# Configuration for Elasticsearch to Milvus 2.x migration

dumper:
  worker:
    workMode: Elasticsearch
    reader:
      bufferSize: 2500
meta:
  mode: config
  index: test_index
  fields:
    - name: id
      pk: true
      type: long
    - name: other_field
      maxLen: 60
      type: keyword
    - name: data
      type: dense_vector
      dims: 512
  milvus:
      collection: "rename_index_test"
      closeDynamicField: false
      consistencyLevel: Eventually
      shardNum: 1

source:
  es:
    urls:
      - http://localhost:9200
    username: xxx
    password: xxx

target:
  mode: remote
  remote:
    outputDir: outputPath/migration/test1
    cloud: aws
    region: us-west-2
    bucket: xxx
    useIAM: true
    checkBucket: false
  milvus2x:
    endpoint: {yourMilvusAddress}:{port}
    username: ******
    password: ******
Более подробное объяснение конфигурационного файла см. на этой странице на GitHub.
- Выполните задание миграции
Теперь, когда вы настроили файл migration.yaml, вы можете запустить задачу миграции, выполнив следующую команду:
./milvus-migration start --config=/{YourConfigFilePath}/migration.yaml
Следите за выводом журнала. Когда вы увидите журналы, похожие на следующие, это означает, что миграция прошла успешно.
[task/load_base_task.go:94] ["[LoadTasker] Dec Task Processing-------------->"] [Count=0] [fileName=testfiles/output/zwh/migration/test_mul_field4/data_1_1.json] [taskId=442665677354739304][task/load_base_task.go:76] ["[LoadTasker] Progress Task --------------->"] [fileName=testfiles/output/zwh/migration/test_mul_field4/data_1_1.json] [taskId=442665677354739304][dbclient/cus_field_milvus2x.go:86] ["[Milvus2x] begin to ShowCollectionRows"][loader/cus_milvus2x_loader.go:66] ["[Loader] Static: "] [collection=test_mul_field4_rename1] [beforeCount=50000] [afterCount=100000] [increase=50000][loader/cus_milvus2x_loader.go:66] ["[Loader] Static Total"] ["Total Collections"=1] [beforeTotalCount=50000] [afterTotalCount=100000] [totalIncrease=50000][migration/es_starter.go:25] ["[Starter] migration ES to Milvus finish!!!"] [Cost=80.009174459][starter/starter.go:106] ["[Starter] Migration Success!"] [Cost=80.00928425][cleaner/remote_cleaner.go:27] ["[Remote Cleaner] Begin to clean files"] [bucket=a-bucket] [rootPath=testfiles/output/zwh/migration][cmd/start.go:32] ["[Cleaner] clean file success!"]
Помимо подхода с использованием командной строки, Milvus Migration также поддерживает миграцию с помощью Restful API.
Чтобы использовать Restful API, запустите API-сервер с помощью следующей команды:
./milvus-migration server run -p 8080
После запуска сервиса вы можете инициировать миграцию, вызвав API.
curl -XPOST http://localhost:8080/api/v1/start
Когда миграция завершится, вы можете использовать Attu, универсальный инструмент администрирования векторных баз данных, чтобы просмотреть общее количество успешно перенесенных строк и выполнить другие операции, связанные с коллекциями.
 Интерфейс Attu
Миграция с Milvus 1.x на Milvus 2.x
- Подготовьте данные Milvus 1.x
Чтобы помочь вам быстро ознакомиться с процессом миграции, мы поместили 10 000 записей тестовых данных Milvus 1.x в исходный код Milvus Migration. Однако в реальных случаях перед началом процесса миграции необходимо экспортировать собственный файл meta.json из вашего экземпляра Milvus 1.x.
- Вы можете экспортировать данные с помощью следующей команды.
./milvus-migration export -m "user:password@tcp(adderss)/milvus?charset=utf8mb4&parseTime=True&loc=Local" -o outputDir
Обязательно:
Замените заполнители вашими фактическими учетными данными MySQL.
Остановите сервер Milvus 1.x или приостановите запись данных перед выполнением этого экспорта.
Скопируйте папку Milvus
tablesи файлmeta.jsonв один и тот же каталог.
Примечание: Если вы используете Milvus 2.x в Zilliz Cloud (полностью управляемый сервис Milvus), вы можете начать миграцию с помощью Cloud Console.
- Скомпилируйте и соберите
Сначала загрузите исходный код Milvus Migration с GitHub. Затем выполните следующие команды, чтобы скомпилировать его.
go get
go build
На этом шаге будет создан исполняемый файл с именем milvus-migration.
- Настройте
migration.yaml
Подготовьте конфигурационный файл migration.yaml, указав сведения об источнике, целевом объекте и другие соответствующие настройки. Вот пример конфигурации:
# Configuration for Milvus 1.x to Milvus 2.x migration

dumper:
  worker:
    limit: 2
    workMode: milvus1x
    reader:
      bufferSize: 1024
    writer:
      bufferSize: 1024
loader:
  worker:
    limit: 16
meta:
  mode: local
  localFile: /outputDir/test/meta.json

source:
  mode: local
  local:
    tablesDir: /db/tables/

target:
  mode: remote
  remote:
    outputDir: "migration/test/xx"
    ak: xxxx
    sk: xxxx
    cloud: aws
    endpoint: 0.0.0.0:9000
    region: ap-southeast-1
    bucket: a-bucket
    useIAM: false
    useSSL: false
    checkBucket: true
  milvus2x:
    endpoint: localhost:19530
    username: xxxxx
    password: xxxxx
Более подробное объяснение конфигурационного файла см. на этой странице на GitHub.
- Выполните задание миграции
Вы должны выполнить команды dump и load отдельно, чтобы завершить миграцию. Эти команды преобразуют данные и импортируют их в Milvus 2.x.
Примечание: Вскоре мы упростим этот шаг и позволим пользователям завершать миграцию с помощью всего одной команды. Следите за обновлениями.
Команда Dump:
./milvus-migration dump --config=/{YourConfigFilePath}/migration.yaml
Команда Load:
./milvus-migration load --config=/{YourConfigFilePath}/migration.yaml
После миграции созданная коллекция в Milvus 2.x будет содержать два поля: id и data. Вы можете просмотреть более подробную информацию с помощью Attu, универсального инструмента администрирования векторных баз данных.
Миграция из FAISS в Milvus 2.x
- Подготовьте данные FAISS
Чтобы перенести данные Elasticsearch, у вас должны быть готовы собственные данные FAISS. Чтобы помочь вам быстро ознакомиться с процессом миграции, мы поместили некоторые тестовые данные FAISS в исходный код Milvus Migration.
- Скомпилируйте и соберите
Сначала скачайте исходный код Milvus Migration с GitHub. Затем выполните следующие команды, чтобы скомпилировать его.
go get
go build
Этот шаг создаст исполняемый файл с именем milvus-migration.
- Настройте
migration.yaml
Подготовьте конфигурационный файл migration.yaml для миграции FAISS, указав сведения об источнике, целевой системе и других соответствующих настройках. Вот пример конфигурации:
# Configuration for FAISS to Milvus 2.x migration

dumper:
  worker:
    limit: 2
    workMode: FAISS
    reader:
      bufferSize: 1024
    writer:
      bufferSize: 1024
loader:
  worker:
    limit: 2
source:
  mode: local
  local:
    FAISSFile: ./testfiles/FAISS/FAISS_ivf_flat.index

target:
  create:
    collection:
      name: test1w
      shardsNums: 2
      dim: 256
      metricType: L2
  mode: remote
  remote:
    outputDir: testfiles/output/
    cloud: aws
    endpoint: 0.0.0.0:9000
    region: ap-southeast-1
    bucket: a-bucket
    ak: minioadmin
    sk: minioadmin
    useIAM: false
    useSSL: false
    checkBucket: true
  milvus2x:
    endpoint: localhost:19530
    username: xxxxx
    password: xxxxx
Более подробное объяснение конфигурационного файла см. на этой странице на GitHub.
- Выполните задание миграции
Как и при миграции с Milvus 1.x на Milvus 2.x, миграция FAISS требует выполнения обеих команд: dump и load. Эти команды преобразуют данные и импортируют их в Milvus 2.x.
Примечание: Вскоре мы упростим этот шаг и позволим пользователям завершать миграцию с помощью всего одной команды. Следите за обновлениями.
Команда Dump:
./milvus-migration dump --config=/{YourConfigFilePath}/migration.yaml
Команда Load:
./milvus-migration load --config=/{YourConfigFilePath}/migration.yaml
Вы можете просмотреть более подробную информацию с помощью Attu, универсального инструмента администрирования векторных баз данных.
Следите за будущими планами миграции
В будущем мы будем поддерживать миграцию из большего числа источников данных и добавим больше функций миграции, включая:
Поддержку миграции из Redis в Milvus.
Поддержку миграции из MongoDB в Milvus.
Поддержку возобновляемой миграции.
Упрощение команд миграции путем объединения процессов dump и load в один.
Поддержку миграции из других популярных источников данных в Milvus.
Заключение
Milvus 2.3, последний выпуск Milvus, предлагает новые впечатляющие функции и улучшения производительности, которые отвечают растущим потребностям в управлении данными. Миграция ваших данных в Milvus 2.x может открыть доступ к этим преимуществам, а проект Milvus Migration делает процесс миграции упрощенным и легким. Попробуйте, и вы не будете разочарованы.
Примечание: Информация в этом блоге основана на состоянии проектов Milvus и Milvus Migration по состоянию на сентябрь 2023 года. Ознакомьтесь с официальной документацией Milvus, чтобы получить самую актуальную информацию и инструкции.
Читать далее
Zilliz Skills Breakdown: How AI Agents Master Vector Databases
Zilliz's Milvus Skill (pymilvus, 7 files) and Zilliz Cloud Skill (zilliz-cli, 14 modules) bring vector-DB dev and ops into one Claude Code session.
Zilliz Cloud Audit Logs Goes GA: Security, Compliance, and Transparency at Scale
Zilliz Cloud Audit Logs are now GA, giving enterprises real-time visibility, compliance-ready trails, and stronger security across AWS, GCP, and Azure.
Zilliz Cloud BYOC Upgrades: Bring Enterprise-Grade Security, Networking Isolation, and More
Discover how Zilliz Cloud BYOC brings enterprise-grade security, networking isolation, and infrastructure automation to vector database deployments in AWS