Apache Cassandra против TiDB: выбор правильной базы данных для ваших AI-приложений
С ростом числа приложений на основе ИИ и растущей потребностью в управлении огромными объемами неструктурированных данных векторный поиск стал необходимым для современных AI-приложений и сценариев использования, таких как рекомендации продуктов, обработка естественного языка (NLP) и анализ изображений. Два заметных варианта — Apache Cassandra и TiDB. Обе системы известны своей масштабируемостью, распределенными архитектурами и способностью управлять большими наборами данных. Однако они различаются во многих аспектах: от базовой архитектуры до того, как они реализуют функциональность векторного поиска.
В этой статье мы сравним Apache Cassandra и TiDB, чтобы помочь вам выбрать лучшее решение для ваших задач векторного поиска. Мы разберем их методологии поиска, возможности обработки данных, производительность, масштабируемость и другие различия. Начнем с понимания концепций векторного поиска и векторной базы данных, а также того, почему они важны в современных AI- и data-приложениях.
Что такое векторный поиск и векторная база данных?
Прежде чем представить и сравнить Apache Cassandra и TiDB, давайте сначала разберемся с концепциями векторного поиска и векторных баз данных.
Векторный поиск или поиск векторного сходства означает поиск точек данных, хранящихся в виде векторов (числовых представлений). Например, при работе с текстовыми данными слова или фразы преобразуются в векторные эмбеддинги, которые отражают их семантическое значение. Такой подход позволяет системе выполнять поиск по сходству, например выявлять текстовые фрагменты со схожими значениями или находить изображения, похожие на заданное изображение-запрос.
Векторная база данных предназначена для эффективного хранения и запроса многомерных векторов. Другими словами, векторные базы данных — это специализированные решения для выполнения векторного поиска. В отличие от традиционных реляционных баз данных, векторные базы данных обеспечивают работу AI-приложений, таких как рекомендательные системы, распознавание лиц и задачи обработки естественного языка (NLP), позволяя выполнять поиск по сходству, который сравнивает векторы для нахождения ближайших соседей или похожих элементов. Они также играют ключевую роль в Retrieval Augmented Generation (RAG) — технике, которая повышает производительность больших языковых моделей (LLMs), предоставляя внешние знания для уменьшения таких проблем, как AI-галлюцинации.
На рынке доступно множество типов векторных баз данных, включая:
- Специализированные векторные базы данных, такие как Milvus, Zilliz Cloud (полностью управляемый Milvus)
- Библиотеки векторного поиска, такие как Faiss и Annoy.
- Легковесные векторные базы данных, такие как Chroma и Milvus Lite.
- Традиционные базы данных с надстройками для векторного поиска, такие как TiDB и Apache Cassandra
Обзор Apache Cassandra
Apache Cassandra — это высокомасштабируемая распределенная NoSQL-база данных, предназначенная для обработки огромных объемов данных на обычном аппаратном обеспечении. Изначально разработанная Facebook, Cassandra известна своей способностью обеспечивать высокую доступность, отказоустойчивость и горизонтальную масштабируемость без единой точки отказа.
Ключевые функции и сильные стороны Apache Cassandra
- Децентрализованная архитектура: Каждый узел в кластере Cassandra равноправен, то есть мастер-узла нет. Это обеспечивает отличную отказоустойчивость и позволяет легко выполнять горизонтальное масштабирование.
- Линейная масштабируемость: По мере добавления новых узлов в кластер производительность растет линейно, что делает ее идеальной для приложений с быстро растущими наборами данных.
- Настраиваемая согласованность: Cassandra предлагает настраиваемую согласованность, позволяя разработчикам выбирать между согласованностью в конечном счете и строгой согласованностью в зависимости от потребностей приложения.
- Поддержка нагрузок с интенсивной записью: Cassandra отлично подходит для сценариев с частыми операциями записи, таких как ведение журналов или сбор данных с датчиков.
Векторный поиск в Apache Cassandra
Хотя Apache Cassandra изначально не спроектирована как векторная база данных, ее интеграция с DataStax и пользовательскими плагинами позволяет поддерживать функциональность векторного поиска. Эти интеграции позволяют Cassandra обрабатывать векторные эмбеддинги и выполнять поиск по сходству, особенно в сочетании с фреймворками машинного обучения.
Реализация векторного поиска в Cassandra обычно использует внешние библиотеки, а это означает, что для достижения оптимальной производительности векторного поиска могут потребоваться дополнительная настройка и кастомизация. Однако после настройки распределенная природа Cassandra позволяет эффективно выполнять крупномасштабный векторный поиск по множеству узлов.
Обзор TiDB
TiDB, разработанная PingCAP, — это распределенная SQL-база данных с открытым исходным кодом, которая предлагает возможности гибридной транзакционной и аналитической обработки (HTAP). TiDB совместима с MySQL, что упрощает ее внедрение для команд, уже знакомых с экосистемой MySQL.
Основные возможности и сильные стороны TiDB
- Распределенный SQL: TiDB предлагает горизонтальную масштабируемость, как у NoSQL-баз данных, сохраняя при этом реляционную модель SQL-баз данных. Это делает ее очень гибкой для обработки как транзакционных, так и аналитических нагрузок.
- HTAP-архитектура: TiDB может обрабатывать транзакционные (OLTP) и аналитические (OLAP) нагрузки в одной базе данных, снижая потребность в отдельных системах.
- Совместимость с MySQL: TiDB совместима с MySQL, что позволяет легко интегрировать ее в существующие среды, которые полагаются на MySQL, без значительных изменений в коде приложения.
- Автоматическое шардирование: TiDB автоматически шардирует данные по узлам, повышая производительность чтения и записи при сохранении строгой согласованности.
Векторный поиск в TiDB
TiDB поддерживает векторный поиск через интеграцию с внешними библиотеками и плагинами, что позволяет эффективно управлять векторизованными данными и выполнять запросы к ним. HTAP-архитектура TiDB полезна для выполнения векторного поиска наряду с транзакционными и аналитическими нагрузками, что делает ее универсальным вариантом для компаний, которым нужны такие возможности.
Включение функциональности векторного поиска в TiDB требует дополнительной настройки, но после ее выполнения система может обрабатывать крупномасштабные векторные запросы благодаря своей распределенной архитектуре. Совместимость с SQL также позволяет разработчикам сочетать векторный поиск с традиционными реляционными запросами, обеспечивая большую гибкость для сложных приложений.
Ключевые различия: Apache Cassandra и TiDB
Хотя и Apache Cassandra, и TiDB могут поддерживать векторный поиск, между ними существуют значительные различия в архитектурах, методологиях и функциональности. Ниже приведено сравнение по различным критически важным факторам:
1. Методология поиска
- Apache Cassandra: Векторный поиск в Cassandra обычно реализуется с помощью внешних плагинов, что может сделать процесс более ручным и потребовать дополнительной настройки. Однако после настройки распределенная природа Cassandra позволяет эффективно выполнять векторный поиск по большим наборам данных.
- TiDB: HTAP-архитектура TiDB позволяет обрабатывать векторный поиск как часть более широких возможностей по работе с нагрузками. Поддерживая как транзакционные, так и аналитические запросы, TiDB предлагает большую гибкость при сочетании векторного поиска с другими запросами.
2. Обработка данных
- Apache Cassandra: Специализируется на обработке неструктурированных или полуструктурированных данных благодаря своей гибкой схеме, что делает ее идеальной для приложений с высокой нагрузкой на запись.
- TiDB: Отлично справляется с управлением структурированными данными, но также обеспечивает гибкость при работе с полуструктурированными данными благодаря совместимости с SQL. Гибридная транзакционная и аналитическая архитектура позволяет использовать более интегрированный подход к обработке данных.
3. Масштабируемость и производительность
- Apache Cassandra: Известна своей линейной масштабируемостью и способностью обрабатывать огромные объемы данных на множестве узлов. Это отличный выбор для приложений, которым нужно быстро горизонтально масштабироваться.
- TiDB: Также обеспечивает горизонтальную масштабируемость, но ее производительность особенно хорошо масштабируется для рабочих нагрузок, требующих сочетания OLTP и OLAP. Для приложений, которым необходимо сбалансировать транзакционные запросы с аналитическими нагрузками, производительность TiDB может быть более предпочтительной.
4. Гибкость и настройка
- Apache Cassandra: Обеспечивает высокую гибкость в моделировании данных, позволяя разработчикам определять таблицы с различными схемами. Однако настройка векторного поиска требует дополнительной интеграции с внешними библиотеками.
- Благодаря совместимости с MySQL,** TiDB** более гибка в сочетании SQL-запросов с векторным поиском. Эта гибкость может определить, предпочитает ли ваша команда работать с реляционными базами данных, одновременно внедряя рабочие нагрузки на основе ИИ.
5. Интеграция и экосистема
- Apache Cassandra: Хорошо интегрируется с облачно-нативными приложениями и другими фреймворками больших данных, такими как Apache Kafka и Apache Spark. Предложение DataStax Enterprise добавляет больше возможностей корпоративного уровня, включая расширенные возможности векторного поиска.
- TiDB: Имеет тесную интеграцию с экосистемой MySQL, что упрощает внедрение для команд, уже использующих MySQL. TiDB также интегрируется с широким спектром инструментов визуализации и аналитики данных.
6. Простота использования
- Apache Cassandra: Требует более крутого обучения, особенно для команд, незнакомых с NoSQL-базами данных. Реализация функциональности векторного поиска может добавить сложности.
- TiDB: Проще внедрять для команд, уже знакомых с SQL-базами данных. Совместимость с MySQL снижает порог обучения и упрощает реализацию векторного поиска.
7. Соображения стоимости
- Apache Cassandra: Имеет открытый исходный код, но требует значительных инфраструктурных ресурсов при масштабировании. Управляемые сервисы Cassandra, такие как DataStax Astra, могут помочь снизить операционную нагрузку, но связаны с дополнительными затратами.
- TiDB: Также имеет открытый исходный код, но гибридная природа базы данных может привести к экономии затрат за счет снижения необходимости в отдельных системах OLTP и OLAP. TiDB Cloud предлагает управляемые сервисы, которые могут снизить операционные расходы, но могут увеличить общие затраты в зависимости от использования.
8. Функции безопасности
- Apache Cassandra: Предоставляет базовые функции безопасности, такие как аутентификация, управление доступом на основе ролей и шифрование данных. Однако более продвинутые возможности безопасности доступны через DataStax Enterprise.
- TiDB: Предлагает комплексные функции безопасности, включая шифрование, управление доступом и журналирование аудита. Для корпоративных сценариев использования возможности безопасности TiDB более надежны по сравнению с версией Cassandra с открытым исходным кодом.
Когда выбирать Apache Cassandra для векторного поиска
- Вам нужна сильно распределенная, отказоустойчивая база данных, способная обрабатывать крупномасштабные нагрузки с интенсивной записью.
- Вашему приложению требуется гибкое моделирование данных, и в некоторых случаях допустима eventual consistency.
- Вам комфортно настраивать векторный поиск через внешние библиотеки или плагины.
- Вы отдаете приоритет масштабируемости и отказоустойчивости, а не простоте использования и расширенным функциям поиска.
Когда выбирать TiDB для векторного поиска
- Вам нужна SQL-совместимая система, поддерживающая как транзакционные, так и аналитические рабочие нагрузки.
- Ваше приложение опирается на сочетание структурированных и полуструктурированных данных, и вы предпочитаете привычность SQL.
- Вам нужен более простой в реализации векторный поиск, который хорошо интегрируется с реляционными запросами.
- Вам требуется гибридная транзакционно-аналитическая база данных с высокой масштабируемостью для смешанных рабочих нагрузок.
Когда выбирать специализированную векторную базу данных?
Хотя и Apache Cassandra, и TiDB предлагают возможности векторного поиска, они не оптимизированы для крупномасштабных высокопроизводительных задач векторного поиска.
Если ваше приложение опирается на быстрый и точный поиск схожести по миллионам или миллиардам многомерных векторов, например для распознавания изображений, рекомендаций в электронной коммерции или задач NLP, специализированные векторные базы данных, такие как Milvus и Zilliz Cloud (управляемый Milvus), подходят лучше. Эти базы данных созданы для обработки векторных данных в масштабе, используя продвинутые алгоритмы Approximate Nearest Neighbor (ANN) (например, HNSW, IVF ) и предлагая расширенные возможности, такие как гибридный поиск (включая гибридный разреженный и плотный поиск, мультимодальный поиск, векторный поиск с фильтрацией по метаданным и гибридный плотный и полнотекстовый поиск), загрузку данных в реальном времени и распределенную масштабируемость для высокой производительности в динамических средах.
С другой стороны, системы общего назначения, такие как Apache Cassandra и TiDB, подходят, когда векторный поиск не является основным фокусом, а вы работаете со структурированными или полуструктурированными данными с меньшими наборами векторных данных или умеренными требованиями к производительности. Если вы уже используете эти системы и хотите избежать накладных расходов, связанных с внедрением новой инфраструктуры, плагины векторного поиска могут расширить их возможности и предоставить экономически эффективное решение для более простых задач векторного поиска меньшего масштаба.
Использование open-source VectorDBBench для самостоятельной оценки и сравнения векторных баз данных
VectorDBBench — это open-source инструмент для бенчмаркинга, разработанный для пользователей, которым требуются высокопроизводительные системы хранения и извлечения данных, особенно векторные базы данных. Этот инструмент позволяет пользователям тестировать и сравнивать производительность различных систем векторных баз данных, таких как Milvus и Zilliz Cloud (управляемый Milvus), используя собственные наборы данных, и определять наиболее подходящую систему для своих сценариев использования. Используя VectorDBBench, пользователи могут принимать обоснованные решения на основе фактической производительности векторных баз данных, а не полагаться на маркетинговые заявления или отдельные свидетельства.
VectorDBBench написан на Python и распространяется по open-source лицензии MIT, что означает, что любой может свободно использовать, изменять и распространять его. Инструмент активно поддерживается сообществом разработчиков, стремящихся улучшать его функции и производительность.
Загрузите VectorDBBench из его репозитория GitHub, чтобы воспроизвести наши результаты бенчмарка или получить результаты производительности на собственных наборах данных.
Быстро ознакомьтесь с производительностью основных векторных баз данных в *рейтинге VectorDBBench.
Прочитайте следующие блоги, чтобы узнать больше об оценке векторных баз данных.
Дополнительные ресурсы о VectorDB, GenAI и ML

Читать далее
Will Amazon S3 Vectors Kill Vector Databases—or Save Them?
AWS S3 Vectors aims for 90% cost savings for vector storage. But will it kill vectordbs like Milvus? A deep dive into costs, limits, and the future of tiered storage.
Zilliz Cloud Audit Logs Goes GA: Security, Compliance, and Transparency at Scale
Zilliz Cloud Audit Logs are now GA, giving enterprises real-time visibility, compliance-ready trails, and stronger security across AWS, GCP, and Azure.
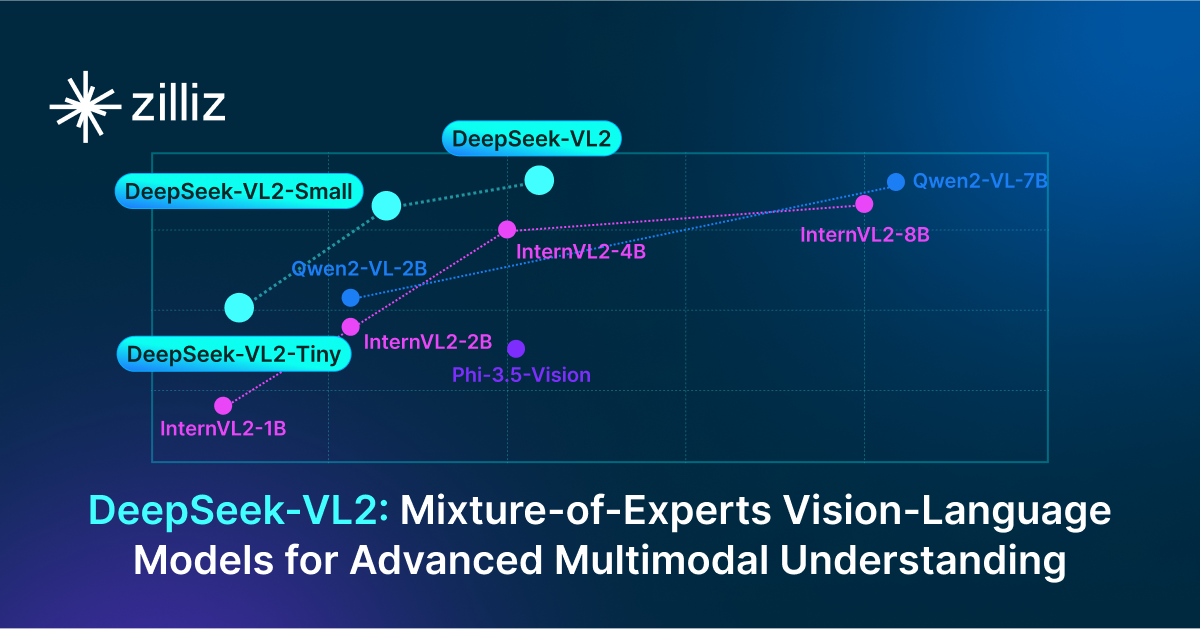
DeepSeek-VL2: Mixture-of-Experts Vision-Language Models for Advanced Multimodal Understanding
Explore DeepSeek-VL2, the open-source MoE vision-language model. Discover its architecture, efficient training pipeline, and top-tier performance.
The Definitive Guide to Choosing a Vector Database
Overwhelmed by all the options? Learn key features to look for & how to evaluate with your own data. Choose with confidence.