




AirbyteとZillizが語る、AIを成功させるためのデータエンジニアリングの重要性
*この記事は2024年10月17日にDBTAに掲載されたものを許可を得て再掲載したものです。
データの収集と活用を可能にすることは、企業規模のAIプロジェクトを成功裏にサポートする上で極めて重要である。データ統合からデータパイプライン、AIのパフォーマンス、データガバナンス、コンプライアンスなどに至るまで、データエンジニアリングのベストプラクティスを遵守することが、AIを活用した未来を実現する上でこれほど賢明なことはない。
DBTA_の最新ウェビナー「AIのためのデータエンジニアリング・ベストプラクティス」(https://www.dbta.com/Webinars/2076-Data-Engineering-Best-Practices-for-AI.htm)では、Airbyteのエンジニアリング・ディレクターであるブライアン・レナード氏と、Milvus、Zillizのプリンシパル・デベロッパー・アドボケイトであるティム・スパン氏が、効果的なAI利用の展開とスケーリングに関連する一般的な課題を、データエンジニアリングによってどのように解決できるかについて専門知識を提供した。
Leonard氏によると、オープンソースのデータムーブメント企業として、Airbyteは、2万人以上のデータおよびAIの専門家がマルチクラウド環境にわたって多様なデータを管理できるようにし、データをどこでも実行可能にする。AirbyteのAIユースケースについて、多くの企業はAirbyteプラットフォームを活用して、Google DriveやSalesforceなどの非構造化ソースからレコードを抽出し、そのデータをレイクハウスに移動することで、ファーストパーティデータをAIアプリにロードしている。
レナードは次に、AIデータ・パイプラインを詳しく見て、抽出から正規化、処理、利用までの道のりを検証した。パイプラインの各段階には、以下のプロセスが組み込まれている:
- 抽出:*** データの暗号化、PIIマスキング、プッシュダウン・フィルター、ファイル転送、パーミッション
- 正規化:** スキーマ正規化、データクリーニング、重複排除
- 処理:** エンリッチメント、要約、ユースケース最適化、ドキュメントチャンキング、埋め込み計算
- エンベッディングをベクトルデータベースMilvusのようなクエリ可能なデータストアに置く。
Spann氏は、Zilliz社のMilvusの利点について説明した。Milvusは、スケールのために構築された高性能なオープンソースのベクトルデータベースである。ベクトル検索は、AIの新しいパラダイムであるとスパン氏は指摘する。「今や、画像、テキスト、ビデオ、ドキュメントなど、あらゆるものがデータであり、ベクトル検索はそれを検索可能にする。実際、IDCは、2025年に新たに生成されるデータの90%が非構造化データになると予測しており、ベクトル検索の重要なニーズを反映している。
ベクトル・データベースは、RAGから分子類似性検索、不正・異常検知、マルチモーダル類似性検索など、様々なユースケースで検索を強力にサポートする。その核心は、非構造化データとそこから知識を抽出する能力であり、AIを成功に導くための基本である。
2017年以来、Zillizは組織が非構造化データを理解するのを支援してきた。Zillizは、高性能でスケーラブルかつ可用性の高い分散システムの開発で高い実績を持つ、アルゴリズムとデータベースのトップクラスのエンジニアチームによって構築され、ベクトル検索用に独自に調整されている。
その結果、Milvusはセットアップが簡単で機能豊富なベクトル・データベースとなり、弾力的なスケーリング、再利用可能なコード、広範な統合機能を提供し、強固で協力的なコミュニティに支えられている。スパンはその後、ウェビナーの視聴者にMilvusの運用方法を説明し、その構造や特徴などを詳しく説明した。
AI時代のデータエンジニアリングについて詳しく説明したウェビナーの全内容については、ウェビナーのアーカイブ版こちらをご覧ください。
読み続けて
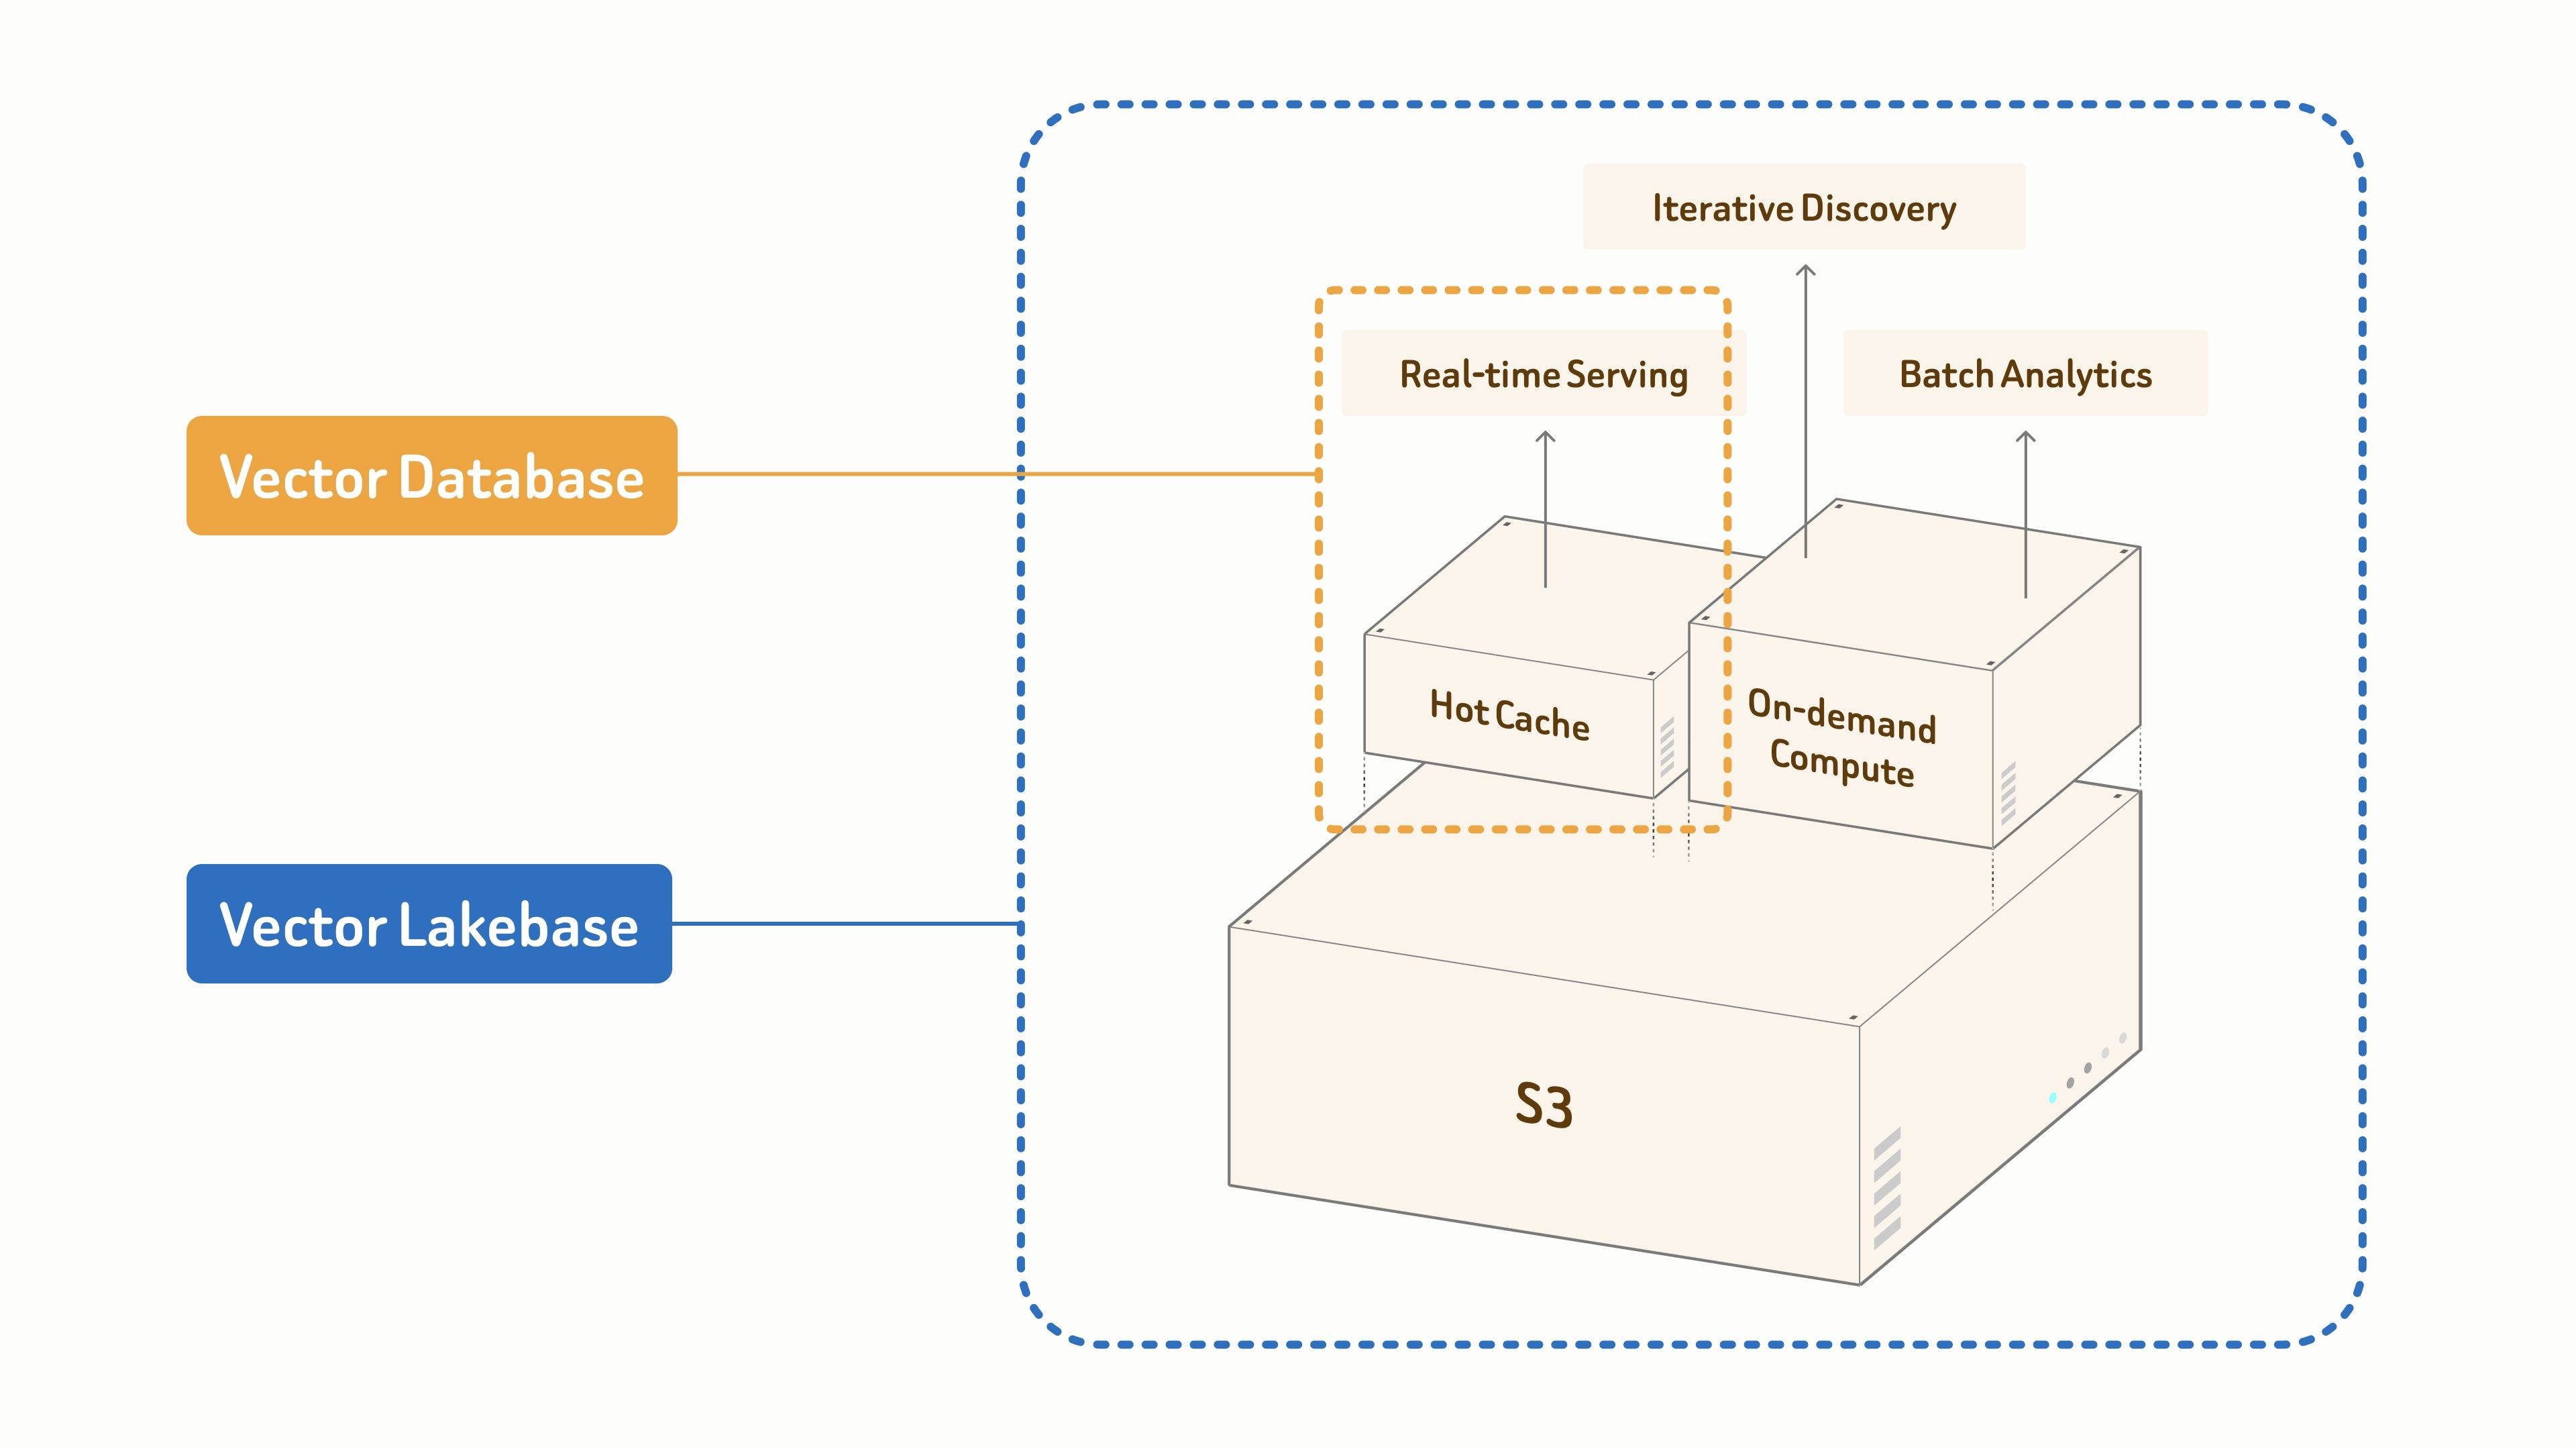
From Vector Database to Vector Lakebase
Zilliz offers a fully managed Vector Lakebase powered by Milvus, unifying real-time vector search, lake-scale discovery, and Al data operations.
Zilliz Cloud Update: Smarter Autoscaling for Cost Savings, Stronger Compliance with Audit Logs, and More
What's new in Zilliz Cloud? Smarter autoscaling with scale-down, audit logs GA, enhanced SSO, and Milvus 2.6 in Private Preview.
How to Calculate the Total Cost of Your RAG-Based Solutions
In this guide, we’ll break down the main components of RAG costs and show you how to calculate these expenses using the Zilliz RAG Cost Calculator,