




Tripo と Zilliz Cloud で 3D アセットのマルチモーダル検索を構築する
AI 3D生成により、アセット作成は大幅に高速化されました。 Tripoは、AI 3Dモデル生成ツールとして、チームがテキストプロンプト、画像、またはスケッチから3Dモデルを生成し、それらをゲーム開発、eコマース、マーケティング、コンセプトデザイン、社内クリエイティブパイプライン全体で活用できるようにします。
そのスピードは新たな問題を生みます。つまり、アセットが急速に積み上がっていくのです。
生成されたモデルが数個であれば手動で簡単に管理できます。しかし数千個となるとそうはいきません。デザイナーは、すでに存在するオブジェクトを再生成してしまうかもしれません。ゲームチームは、キャラクター、小道具、環境のバリエーションを把握しきれなくなるかもしれません。マーケティングチームは、キャンペーン向けにアセットを調整する時間よりも、使えるアセットを探す時間のほうを多く費やすかもしれません。
このチュートリアルでは、生成されたアセットを検索可能なカタログに変換する方法を示します。 Tripoは3D作成レイヤーであり、Zilliz Cloudは検索レイヤーです。Milvusの開発元が提供するフルマネージドのベクトルデータベースサービスで、埋め込みとメタデータを保存し、低レイテンシの類似検索をサポートし、ベクトル検索と構造化フィルターを組み合わせることができます。
このワークフローでは、各アセットレコードにレンダープレビュー、構造化メタデータ、1つのマルチモーダル埋め込みが含まれます。アセットがインデックス化されると、ユーザーはテキスト、画像、またはテキストと画像の組み合わせで検索できます。
作成するもの
このチュートリアルのライブラリでは、各3Dアセットを検索可能なカタログ項目として扱います。 3Dメッシュは、アセットパイプラインが保存している場所にそのまま残ります。検索可能なレコードには、アセットのレンダープレビュー、メタデータ、ストレージ参照、埋め込みが含まれます。
このデモでは、3種類のローカルデータを使用します。
| ローカルデータ | 含まれる内容 |
|---|---|
| milvus_dataset.csv | アセットごとのメタデータ:カテゴリ、スタイル、オブジェクトタイプ、色、ユースケース、ファイル名、プロジェクト情報 |
| milvus_render_images/ | Tripoアセットのレンダリング済みプレビュー。検索対象となり、返されるものです |
| milvus_input_images/ | 画像から3Dを生成するために使用された参照画像。メタデータおよび任意のクエリ参照として保存されます |
基本的なワークフローは次のとおりです。
Tripo生成の3Dアセット
        ↓
レンダープレビュー画像 + メタデータ
        ↓
マルチモーダル埋め込み
        ↓
Zilliz Cloudコレクション
        ↓
テキスト、画像、またはテキスト + 画像で検索
        ↓
一致したレンダー画像とメタデータを返す
この構成は、一般的なクリエイティブ検索パターンをサポートします。
- 青いファンタジーの剣のようなコンセプトで検索する。
- オブジェクトタイプ、スタイル、色、またはユースケースで検索する。
- 言葉だけでは曖昧すぎる場合に参照画像を使用する。
- 参照画像とテキストを組み合わせて結果を誘導する。
- カテゴリ、プロジェクト、オペレーター、スタイル、または生成モードなどの構造化フィールドでフィルターする。
その結果は、単にファイル名がわかりやすくなったフォルダーではありません。クエリ可能なアセットカタログです。
レンダープレビューとメタデータが重要な理由
3Dモデルを直接検索するのは簡単ではありません。 本番パイプラインでは、モデルには通常、いくつかの関連情報が付随します。
- 生成されたメッシュまたはソースファイル;
- 1つ以上のレンダープレビュー画像;
- 任意の入力画像または参照画像;
- キャプションまたはプロンプト;
- 生成されたタグ;
- プロジェクト、所有者、またはオペレーターのフィールド;
- スタイル、カテゴリ、色、オブジェクトタイプ、ユースケースのメタデータ;
- アセットを指し示すURLまたはストレージキー。
このチュートリアルでは、レンダープレビューを埋め込む視覚オブジェクトとして扱います。 レンダープレビューは、形状、素材、色、視覚的スタイルを、マルチモーダル埋め込みモデルが理解できる形式で捉えるため、うまく機能します。
レンダープレビューは埋め込みモデルが見るオブジェクトであるため、アセット品質は検索品質に直接影響します。 幾何学的忠実度(保持された形状、エッジ、装飾)は、モデルに構造的なシグナルを与えます。高解像度テクスチャ(明確な素材、忠実な色、表面のディテール)は、素材と色のシグナルを与えます。その両方がなければ、埋め込みは平坦化します。革のバッグとキャンバスのバッグがモデルには同じように見え、検索は役に立たなくなります。
メタデータは、第二の制御レイヤーを提供します。セマンティック検索を実行しながら、完全一致フィルターも適用できます。1つのアセットレコードは、次のようになります。
caption: 青い宝石が付いたファンタジーの剣
llm_object: 剣
llm_category: 武器
llm_style: ファンタジー
llm_color: 青, 銀
llm_use_case: ゲームアセット
generation_mode: image-to-3D
render_image_file: fantasy_sword.webp
input_image_file: sword_reference.webp
この組み合わせにより、ライブラリは実際のワークフローで役立つものになります。 たとえば、ゲームアーティストは女性キャラクターを検索し、結果セットをゲームアセットに限定できます。マーケターはリアルな革のバッグを探し、プロジェクトでフィルタリングできます。Eコマースチームは、正確なファイル名に頼らずに、カテゴリや素材で検索できます。
画像形式に関する注意
このデモでは、容量効率のためにレンダー画像と参照画像を.webpとして保存しています。埋め込みAPIは、モデルやプロバイダールートによっては、PNGまたはJPEG入力の方が安定する場合があります。画像入力エラーが発生する場合は、埋め込みの前にWebPプレビューをPNGまたはJPEGに変換してください。
このパイプラインで使用するツール
このチュートリアルでは、2つのシステムを接続します。1つは3Dアセットを作成するシステムで、もう1つはそれらを検索可能にするシステムです。
Tripo: 作成レイヤー
Tripo は、200億以上のパラメーターを持つモデル上に構築された AI 3Dモデルジェネレーター です。主力製品であるTripo Studioは、テキスト、画像、スケッチ入力から、メッシュの洗練、テクスチャ生成、リギング、アニメーション、エクスポートまで、アセット作成フロー全体を1つのワークスペースでカバーします。標準メッシュは2〜5秒で生成されます。これが、アセットライブラリが急速に成長し、このチュートリアルで構築する検索パイプラインを必要とする理由の一部です。
ここでは、特に次の3つの機能が重要です。
- Image-to-3D model generation は、複雑な形状、鋭いエッジ、装飾、表面の細部といった幾何構造を保持するため、生成されたモデルは入力参照に忠実なままになります。
- HD Model はその忠実度をさらに高め、クローズアップレンダリング、製品ビジュアライゼーション、3Dプリントに耐えるアセット向けに、最大200万面をサポートします。
- Texture Generation は、最大8K解像度で、忠実な色再現、明確な素材の区別(金属、革、布、木材)、摩耗跡、木目、マイクロテクスチャなどの細かな表面ディテールを追加します。
これらを組み合わせることで、各アセットには意味のあるマルチモーダル埋め込みを生成するのに十分な幾何的・素材的シグナルが備わります。ここで検索側が登場します。
Zilliz Cloud: 検索レイヤー
Zilliz Cloud は、最も広く採用されているオープンソースのベクトルデータベース(GitHubスター45,000以上、Dockerプル1億以上、本番環境で10,000以上の組織が利用)である Milvus の開発者によって構築された、フルマネージドの Vector Lakebase プラットフォームです。その中核には、1,000億規模でサブミリ秒検索を実現する本番グレードのベクトルデータベースがあります。このチュートリアルでは、次の3つを処理します。
- 埋め込みストレージ — 各アセットのマルチモーダルベクトルは、その構造化メタデータとともに単一のコレクション内に保存されます。
- 類似検索 — テキスト、画像、または組み合わせたクエリが同じベクトル空間に埋め込まれ、保存されたレンダープレビューと照合されます。
- フィルター付き検索 — カテゴリ、スタイル、ユースケース、またはプロジェクトによる完全一致フィルターを、1つのリクエストでセマンティック検索の上に重ねます。これにより、ベクトルの山が検索可能なカタログになります。
前提条件
始める前に、以下を準備してください。
- Zilliz Cloud のアカウントとクラスター。このチュートリアルには無料クラスターで十分です。サインアップし、クラスターを作成して、そのエンドポイントとトークンをコピーしてください。
- 以下で使用するマルチモーダル埋め込みモデル用の OpenRouter API キー。
- Python 3.10 以降。
- Milvus Python SDK。初めて使用する場合は、PyMilvus インストールガイドを参照してください。
- レンダリングプレビュー画像とメタデータを含む、Tripo で生成されたアセット一式。
- image-to-3D 生成に使用する任意の参照画像。
以下のサンプルコードでは tripo_rag.py という名前のスクリプトを想定していますが、同じロジックを独自の取り込みサービス、アセット管理バックエンド、または社内ツールに移すこともできます。
ステップ 1: Tripo で生成されたアセットデータを準備する
Tripo で生成されたアセットから始めます。各アセットについて、少なくとも 1 つのレンダリングプレビュー画像をエクスポートまたは保存してください。アセットが参照画像から作成された場合は、その参照画像も保持してください。これは、デバッグ、検索結果のプレビュー、または将来の検索モードの構築に役立つ場合があります。
メタデータ CSV の各行は 1 つのアセットを表す必要があります。最低限、以下を含めてください。
- 一意のアセット ID;
- レンダリングプレビュー画像のファイル名またはストレージキー;
- キャプションまたは生成プロンプト;
- 利用可能な場合は、カテゴリ、オブジェクト、スタイル、色、ユースケースのフィールド;
- チームでアクセス制御やワークスペースレベルのフィルタリングが必要な場合は、プロジェクトまたは所有者フィールド;
- 元のアセットの URL または保存場所。
より豊富なメタデータがあると、後でより良いフィルターを使用できます。ベクトルは、視覚的および意味的に類似したアセットを見つけるのに役立ちます。メタデータは、結果セットを現在のプロジェクトで実際に使用可能なアセットに絞り込むのに役立ちます。
ステップ 2: Zilliz Cloud Collection を作成する
コレクション内の各レコードは 1 つの Tripo アセットを表します。構造化フィールドはメタデータを保存します。multimodal_vector フィールドはレンダリングプレビューの埋め込みを保存します。
以下の例では、3072 次元ベクトルと COSINE 類似度を使用しています。使用する埋め込みモデルに合わせて次元数を維持してください。
schema = MilvusClient.create_schema(
    auto_id=False,
    enable_dynamic_field=False
)

schema.add_field("id", DataType.INT64, is_primary=True)
schema.add_field("project_id", DataType.VARCHAR, max_length=64)
schema.add_field("operator_id", DataType.VARCHAR, max_length=64)
schema.add_field("caption", DataType.VARCHAR, max_length=2048)
schema.add_field("llm_keyword", DataType.VARCHAR, max_length=512)
schema.add_field("llm_object", DataType.VARCHAR, max_length=512)
schema.add_field("llm_category", DataType.VARCHAR, max_length=128)
schema.add_field("llm_style", DataType.VARCHAR, max_length=128)
schema.add_field("llm_color", DataType.VARCHAR, max_length=256)
schema.add_field("llm_use_case", DataType.VARCHAR, max_length=128)
schema.add_field("generation_mode", DataType.VARCHAR, max_length=32)
schema.add_field("url", DataType.VARCHAR, max_length=512)
schema.add_field("input_image_file", DataType.VARCHAR, max_length=256)
schema.add_field("input_image_key", DataType.VARCHAR, max_length=512)
schema.add_field("render_image_file", DataType.VARCHAR, max_length=256)
schema.add_field("render_image_key", DataType.VARCHAR, max_length=512)
schema.add_field(VECTOR_FIELD, DataType.FLOAT_VECTOR, dim=VECTOR_DIM)
次に、ベクトルインデックスを作成します。
index_params = MilvusClient.prepare_index_params()

index_params.add_index(
    field_name=VECTOR_FIELD,
    index_type="AUTOINDEX",
    metric_type="COSINE",
)
スクリプトがセットアップをコマンドにラップしている場合は、以下を実行します。
python3 tripo_rag.py create-collection
コマンドが完了したら、Zilliz Cloud コンソールを開き、コレクション一覧を確認します。
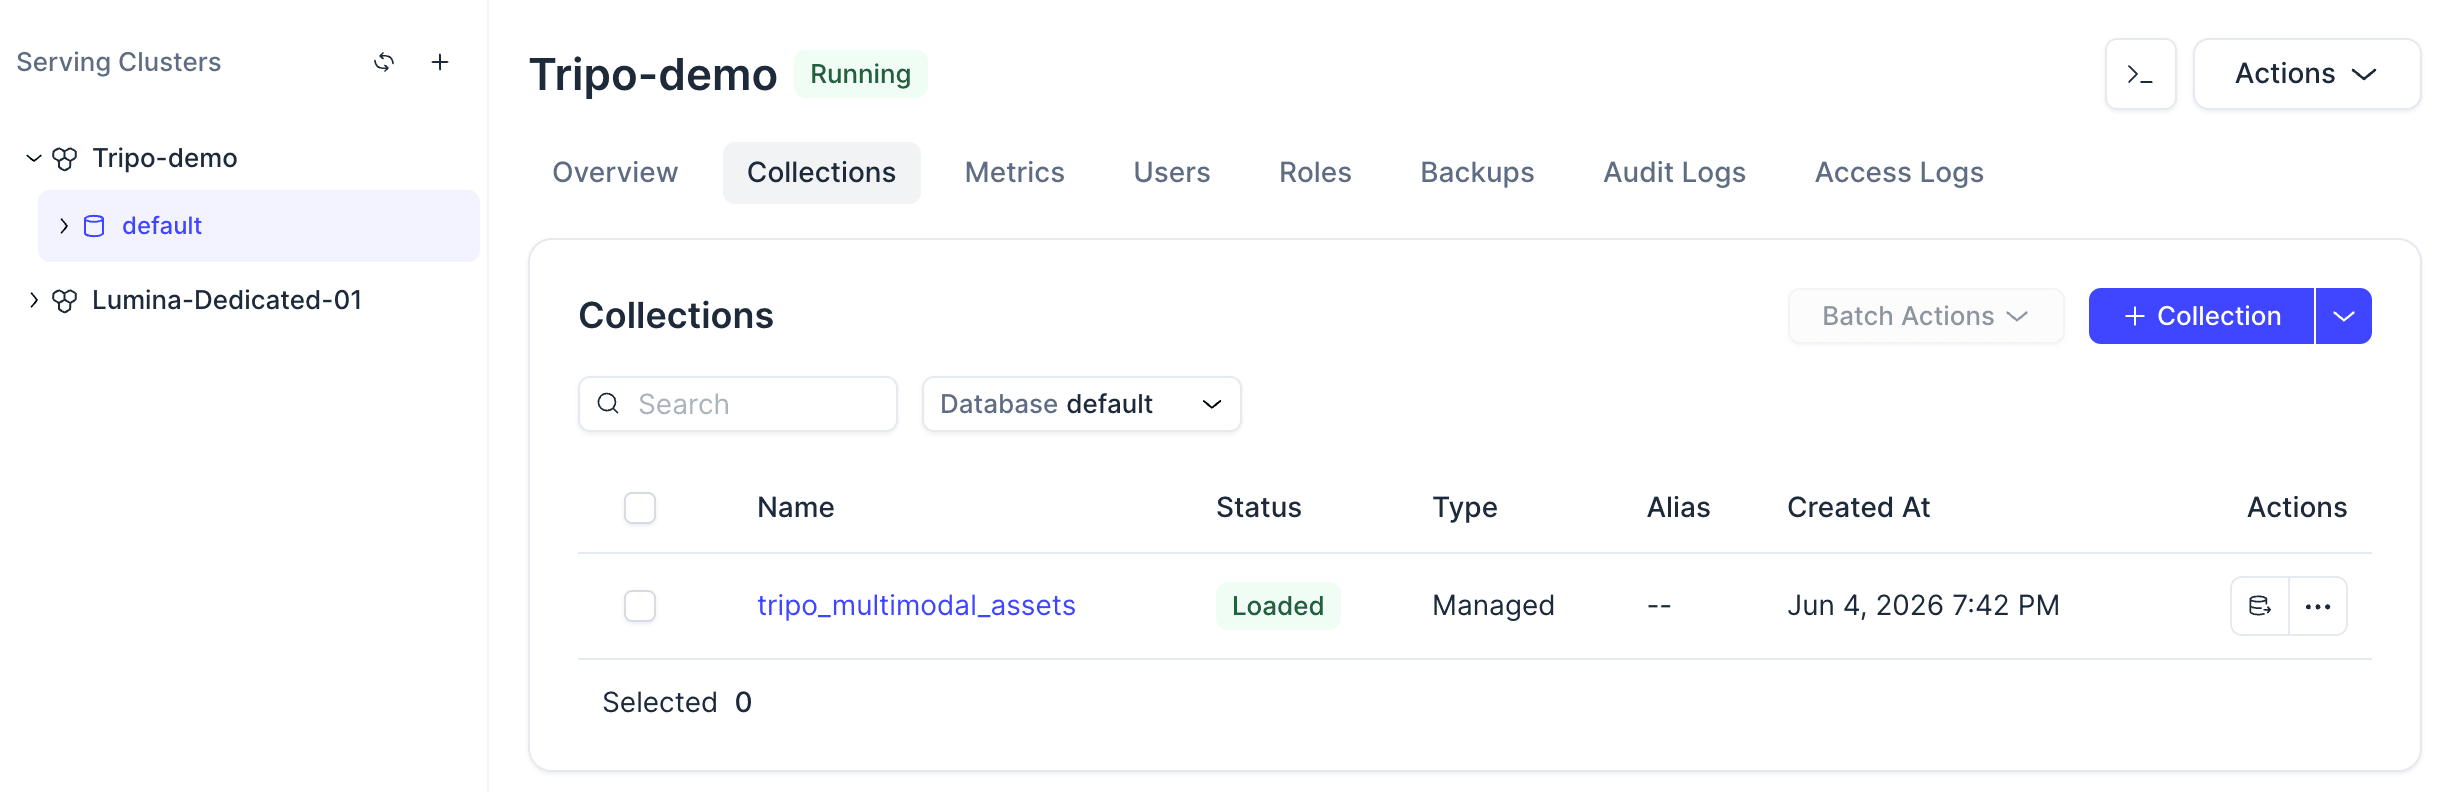
コレクションをクリックして、ステータス、スキーマ、ロード済みエンティティ、ベクトルフィールド構成を確認します。
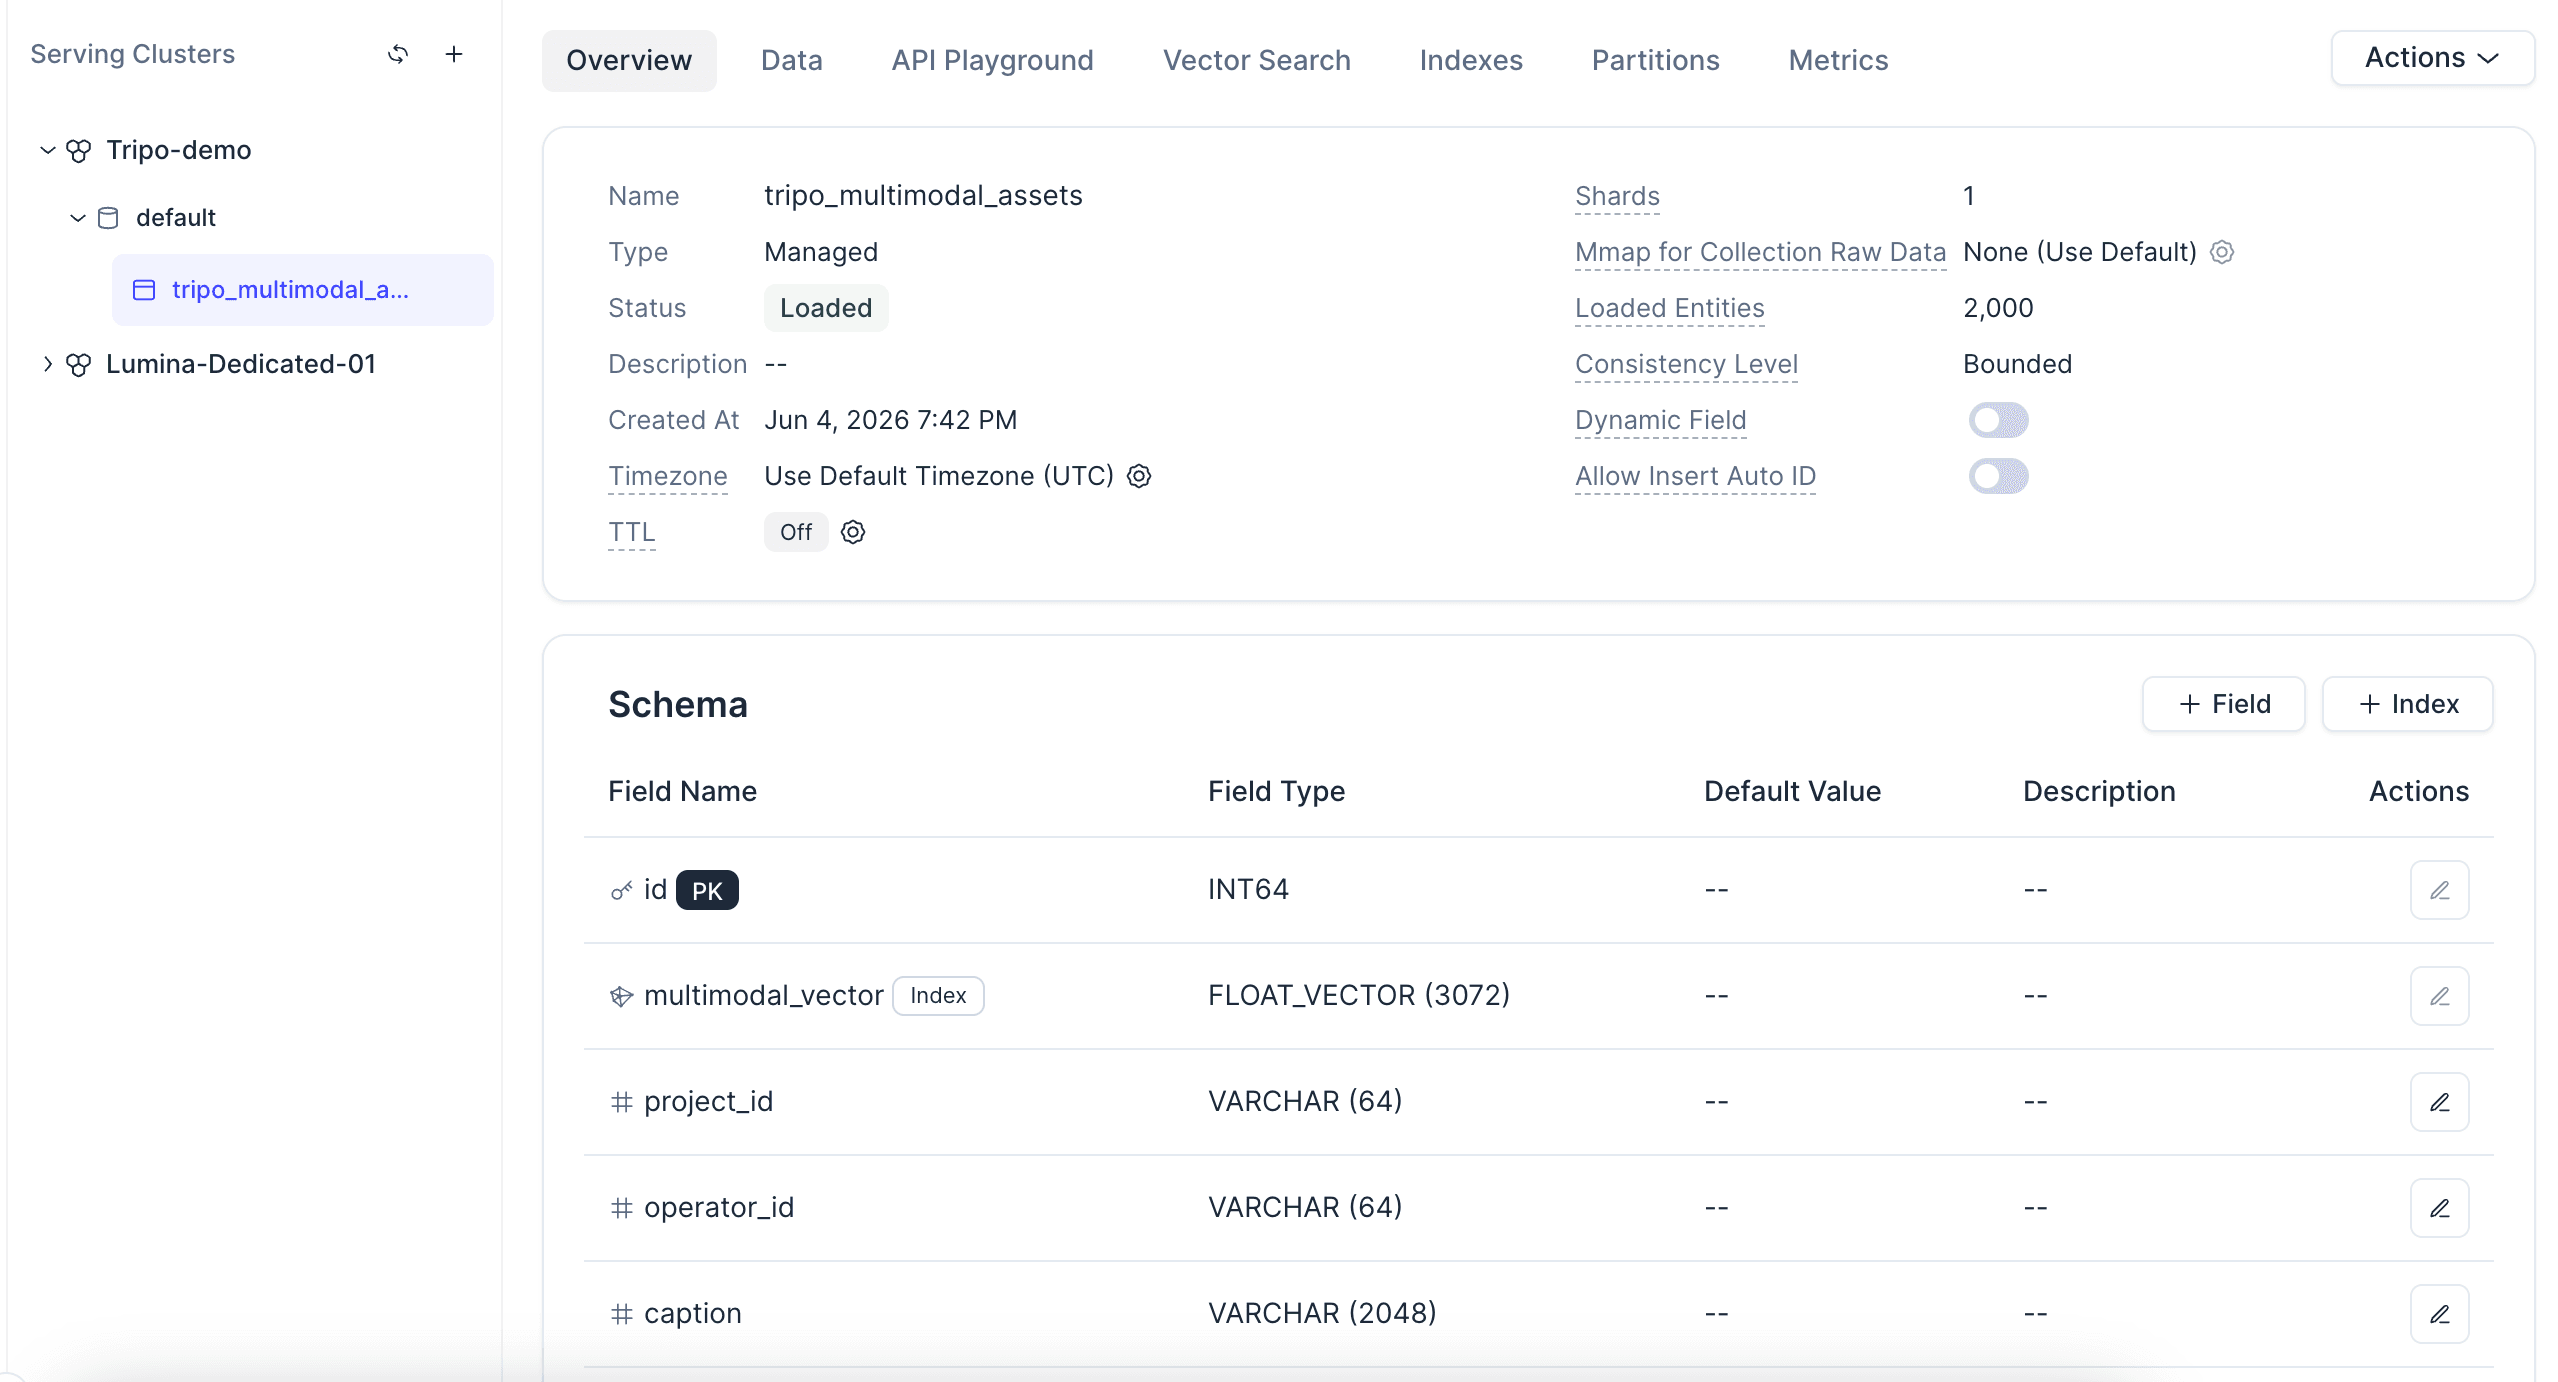
インデックスについての簡単なメモ: AUTOINDEX を使うと、データをインポートする前にインデックスパラメータを手動で調整する必要がないため、チュートリアルがシンプルになります。COSINE metric type は、次のステップで使用する正規化済み埋め込みに適合します。
ステップ 3: レンダリング画像のマルチモーダル埋め込みを生成する
次に、各レンダリングプレビューの埋め込みを生成します。
デモでは、OpenRouter を通じてプレビュー画像を埋め込みモデルに送信します。画像は base64 データ URL としてエンコードされ、返されたベクトルは Zilliz Cloud に挿入される前に L2 正規化されます。
def data_url_for_image(path: Path) -> str:
    mime_type = mimetypes.guess_type(path.name)[0] or "image/webp"
    data = base64.b64encode(path.read_bytes()).decode("ascii")
    return f"data:{mime_type};base64,{data}"

def embed_content(self, content: list[dict]) -> list[float]:
    body = {
        "model": "google/gemini-embedding-2-preview",
        "input": [{"content": content}],
        "encoding_format": "float",
    }

    response = requests.post(
        "https://openrouter.ai/api/v1/embeddings",
        headers=self._headers(),
        json=body,
        timeout=120,
    )

    vector = response.json()["data"][0]["embedding"]
    return l2_normalize(vector)

def embed_image(self, image_path: Path) -> list[float]:
    return self.embed_content(
        [
            {
                "type": "image_url",
                "image_url": {
                    "url": data_url_for_image(image_path)
                },
            }
        ]
    )
実際の取り込みパイプラインでは、埋め込みをキャッシュしてください。インポートのたびに外部の埋め込み API を呼び出すのは遅く、リトライによって繰り返しのテスト実行が高額になる可能性があります。
python3 tripo_rag.py build-cache
キャッシュがあると、インポート動作も決定論的になります。すべてのレンダリングプレビューを再埋め込みすることなく、コレクションを再構築したり、スキーマ変更をテストしたり、インポートを再実行したりできます。
ステップ 4: アセットレコードを Zilliz Cloud にインポートする
キャッシュの準備ができたら、各 CSV 行を Zilliz Cloud 用の 1 つのエンティティに変換します。
各エンティティには、構造化フィールドとキャッシュ済みのマルチモーダルベクトルを含める必要があります。
def row_to_entity(row_index: int, row: dict, cached_item: dict) -> dict:
    return {
        "id": row_index,
        "project_id": row.get("project_id", ""),
        "operator_id": row.get("operator_id", ""),
        "caption": row.get("caption", ""),
        "llm_keyword": row.get("llm_keyword", ""),
        "llm_object": row.get("llm_object", ""),
        "llm_category": row.get("llm_category", ""),
        "llm_style": row.get("llm_style", ""),
        "llm_color": row.get("llm_color", ""),
        "llm_use_case": row.get("llm_use_case", ""),
        "generation_mode": generation_mode(row),
        "url": row.get("url", ""),
        "input_image_file": row.get("input_image_file", ""),
        "input_image_key": row.get("input_image_key", ""),
        "render_image_file": row.get("render_image_file", ""),
        "render_image_key": row.get("render_image_key", ""),
        VECTOR_FIELD: cached_item[VECTOR_FIELD],
    }
次に、データセットをインポートし、コレクション統計を確認します。
python3 tripo_rag.py import-data
python3 tripo_rag.py stats
Zilliz Cloud コンソールで Data タブを開き、アセットレコードが挿入されたことを確認します。各エンティティについて、メタデータフィールド、レンダリング画像参照、ベクトルフィールドが表示されるはずです。
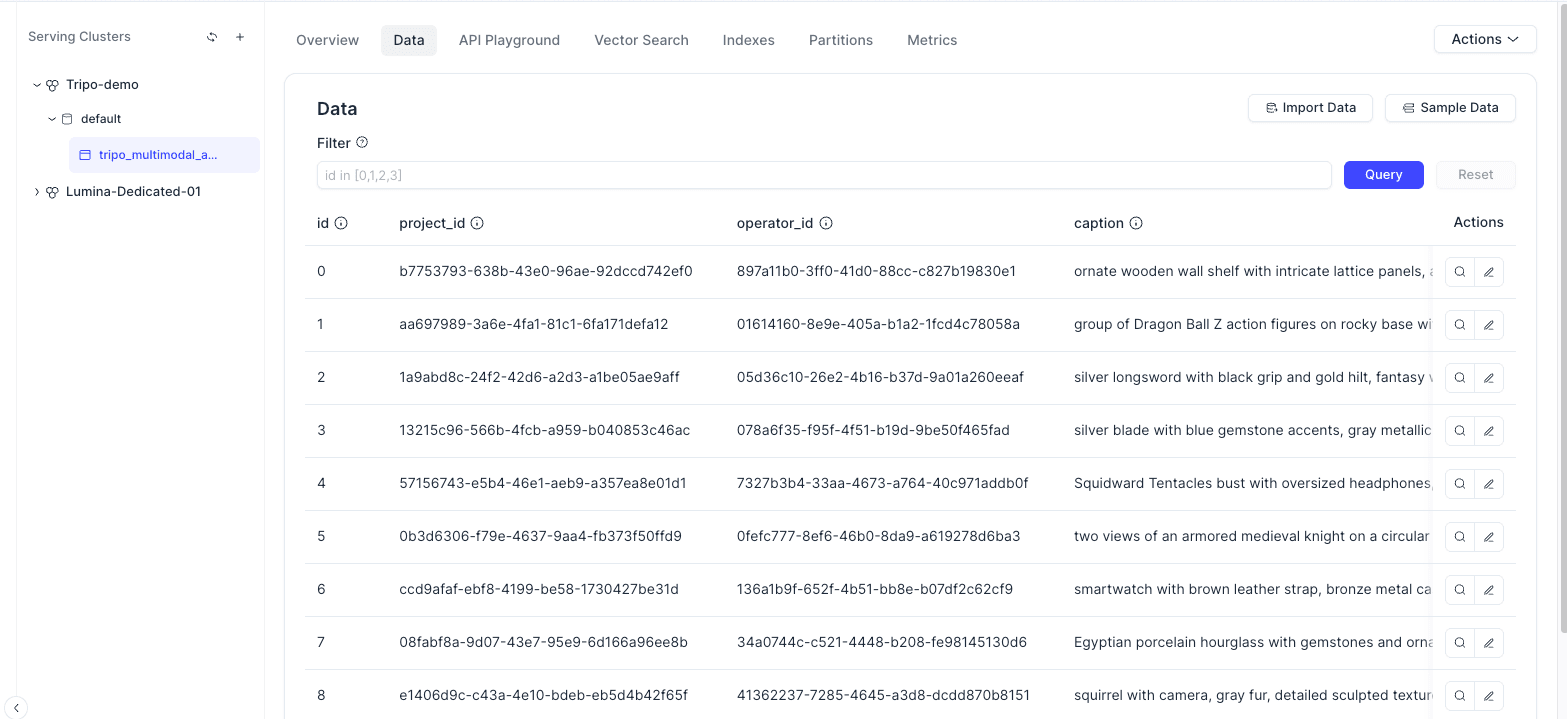
Tripo アセットは、ばらばらのローカルファイルではなく、ベクトルデータベース内の検索可能なエンティティになりました。
ステップ 5: テキスト、画像、またはその両方で検索する
検索は 3 つのモードで実行され、すべて同じマルチモーダルモデルを通じて、同じ multimodal_vector フィールドに対して行われます。
| モード | 使用する場面 | 例 |
|---|---|---|
| テキスト | 欲しいものを説明できる場合 | 青いファンタジーの剣 |
| 画像 | 参考画像があり、似たアセットが欲しい場合 | スタイライズされた盾のレンダーをアップロード |
| テキスト + 画像 | 意図と視覚的な手がかりの両方が欲しい場合 | 剣の画像 + 青い宝石付きのファンタジーの剣 |
クエリは、アセットのレンダープレビューと同じベクトル空間に埋め込まれます。その後、Zilliz Cloud がベクトルフィールドを検索し、メタデータ付きで最も近いアセットを返します。
def search(args) -> None:
    if not args.text and not args.image:
        raise SystemExit("Provide --text, --image, or both.")

    embedding_client = OpenRouterEmbeddingClient(
        require_env("OPENROUTER_API_KEY")
    )

    client = connect_client()

    if args.text and args.image:
        vector = embedding_client.embed_text_image(
            args.text,
            Path(args.image)
        )
    elif args.image:
        vector = embedding_client.embed_image(Path(args.image))
    else:
        vector = embedding_client.embed_text(args.text)

    results = client.search(
        collection_name=args.collection,
        data=[vector],
        anns_field=VECTOR_FIELD,
        filter=filter_expr(args),
        limit=args.top_k,
        output_fields=[
            "project_id",
            "caption",
            "llm_keyword",
            "llm_object",
            "llm_category",
            "llm_style",
            "llm_color",
            "llm_use_case",
            "generation_mode",
            "render_image_file",
            "render_image_key",
            "input_image_file",
            "url",
        ],
        search_params={"metric_type": "COSINE"},
    )

    for rank, hit in enumerate(results[0], start=1):
        entity = hit["entity"]
        print(
            json.dumps(
                {
                    "rank": rank,
                    "score": hit["distance"],
                    **entity,
                },
                ensure_ascii=False,
                indent=2,
            )
        )
各結果には類似度スコアとメタデータの両方が含まれるため、フロントエンドでは同じ結果カード内にプレビュー画像、キャプション、カテゴリ、スタイル、ユースケース、元のアセットURLを表示できます。
検索は純粋なベクトル類似度だけに限定されません。すべてのアセットが構造化メタデータを持っているため、1回のリクエストでセマンティッククエリにフィルターを追加できます。たとえば、female を検索しつつ、結果セットを llm_use_case == "game asset" に制限できます。これにより、コレクションはベクトルの山ではなく、実際のカタログになります。
例 1: ユースケースフィルター付きのテキスト検索
ゲームチームがキャラクターのようなアセットを必要としているとします。female を検索し、結果を game asset ユースケースに制限できます。
python3 tripo_rag.py search \
  --text "female" \
  --use-case "game asset" \
  --top-k 12
これにより、game-asset サブセットから最も近い一致アセットが返されます。ライブラリ全体を検索して、無関係な商品、環境、マーケティング用アセットを手動で無視するよりも便利です。
例 2: テキストと参考画像による検索
テキストだけでは、ビジュアル制作には範囲が広すぎることがよくあります。fantasy sword with blue gemstone のようなクエリは、システムに何が欲しいかを伝えますが、参考画像は形状、構図、視覚的方向性の基準になります。
python3 tripo_rag.py search \
  --text "fantasy sword with blue gemstone" \
  --image ./examples/sword_reference.png \
  --top-k 12
このモードは、クリエイターが視覚的な参考資料から始めつつ、いくつかの言葉で検索の方向性を調整したい場合に便利です。参考画像は視覚的類似性を担います。テキストは意図を絞り込みます。
実際のアセットパイプラインで可能になること
ライブラリが検索可能になると、チームは生成された3Dアセットを、再利用可能な本番用インベントリのように扱えるようになります。
ゲームチームは、プロジェクトをまたいで小道具やキャラクターのバリエーションを追跡できます。Eコマースチームは、商品に近いアセットをカテゴリ、素材、スタイル別に整理できます。マーケティングチームは、再利用可能なビジュアルの承認済みライブラリを維持できます。クリエイティブオペレーションチームは、フォルダ名に依存するのではなく、所有権、プロジェクトID、アセットURLを中心にレビューのワークフローを構築できます。
重要な変化はシンプルです。生成はアセットを作成しますが、検索はそのアセットを再利用可能にします。
まとめ
AI 3D生成により、手動のフォルダ構造では管理しきれないほど多くのアセットを簡単に作成できるようになります。次のボトルネックは検索です。適切なアセットを見つけ、それがどこから来たのかを理解し、適切なプロジェクトで再利用することです。
このチュートリアルでは、その問題を解決する1つの方法を示しました。Tripoでアセットを生成し、レンダープレビューとメタデータをZilliz Cloudに保存し、各プレビューをマルチモーダルモデルで埋め込み、テキスト、画像、またはその両方でコレクションを検索します。同じパターンは、ローカルデータセットで小さく始め、ライブラリの拡大に合わせて本番用アセットカタログへと成長させることができます。
これはZilliz Vector Lakebaseが目指す方向でもあります。マルチモーダルAIデータ、埋め込み、メタデータ、配信経路を1つの検索可能な基盤にまとめることで、チームは毎回データレイヤーを再構築することなく、生成から検索、再利用へと進めるようになります。
自分で試すには、Zilliz Cloudにサインアップし、無料クラスターを作成し、Tripoで少量のアセットを生成して、パイプラインをエンドツーエンドで実行してください。最初の検索結果が適切に見えたら、出力を社内のアセットブラウザやクリエイティブツールに接続します。
Tripoアセット例
以下のアセットは、このチュートリアルで説明した機能を使用してTripo Studioで生成されました。
8Kテクスチャ生成
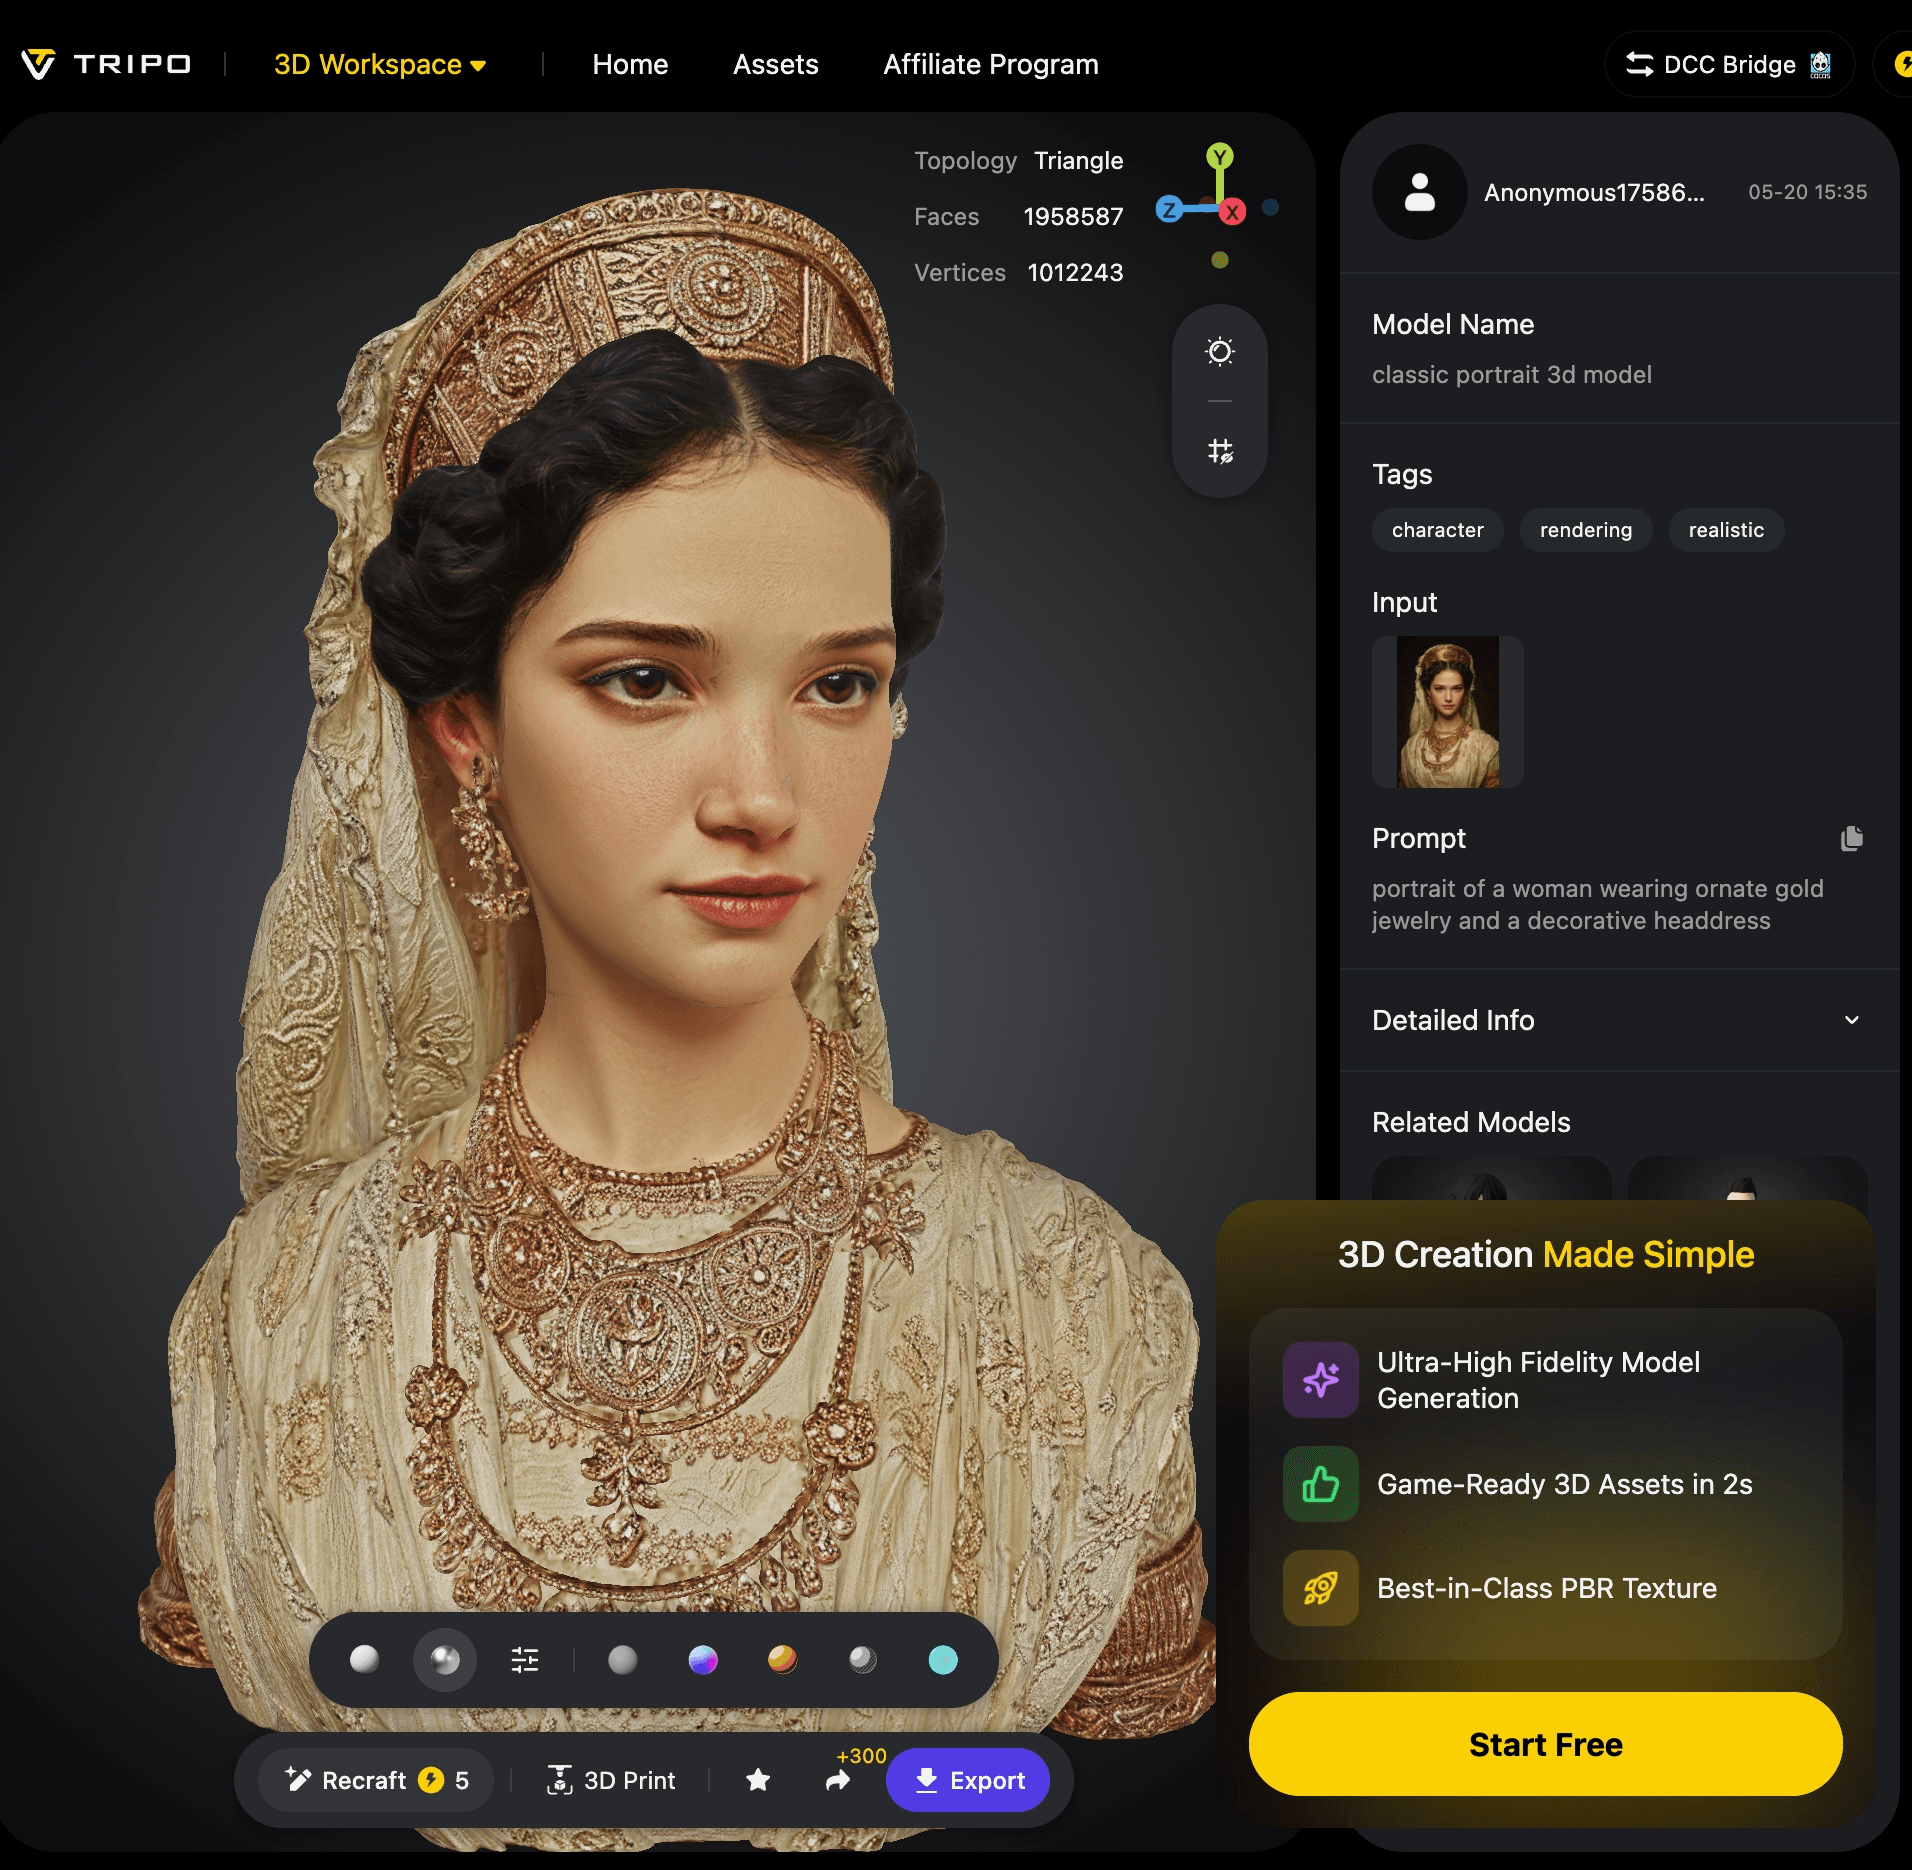
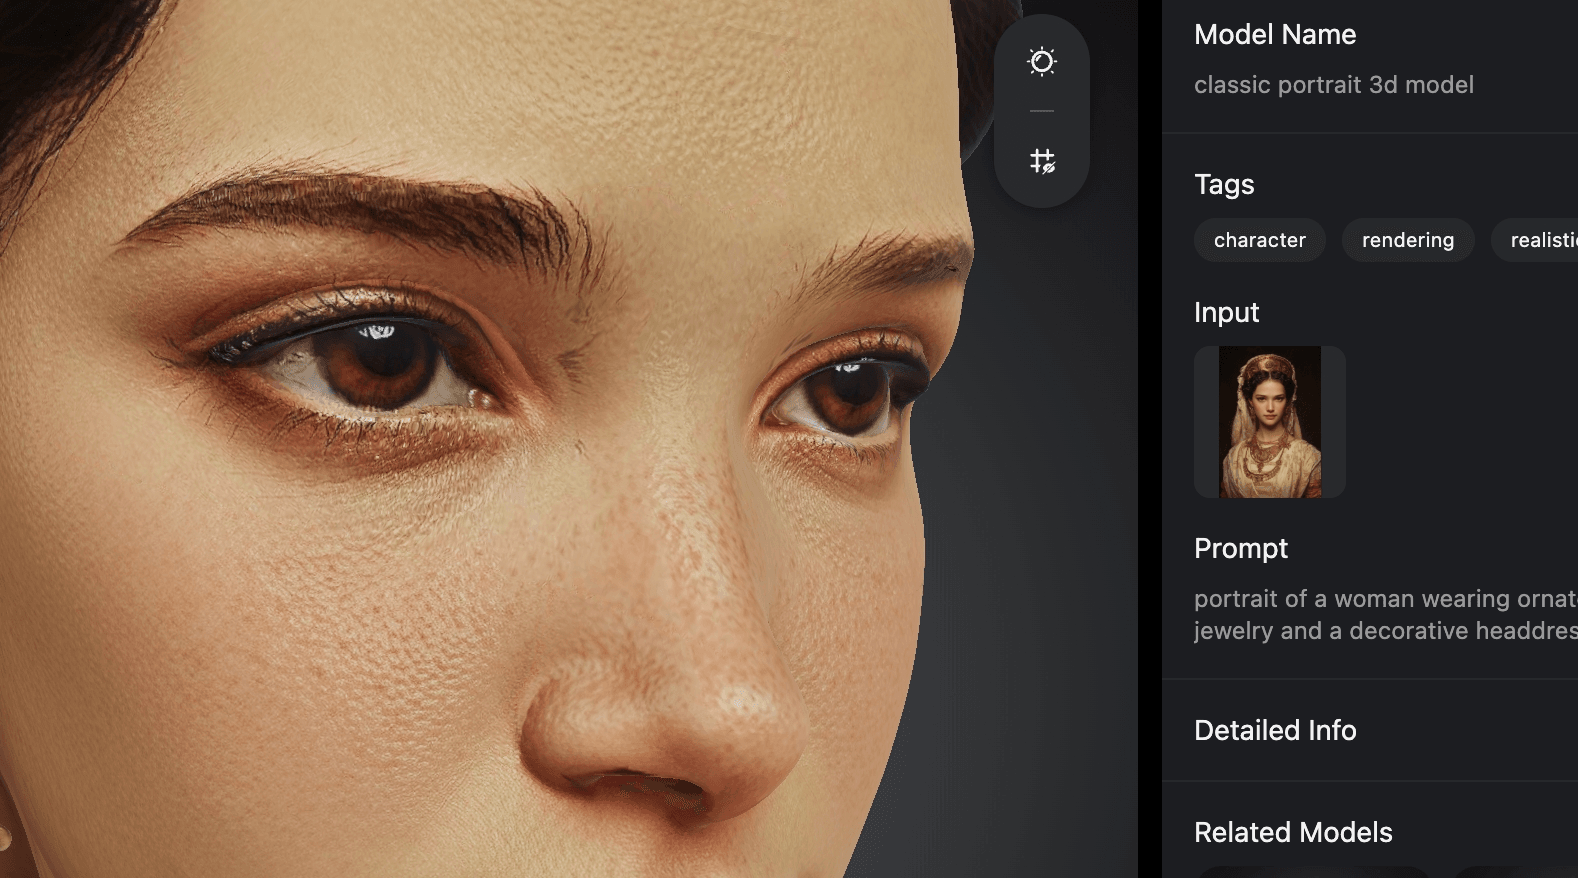
8Kテクスチャ生成は色の忠実度を維持し、金属、革、布、木材などの表面素材を、摩耗痕やマイクロテクスチャに至るまで識別します。
HDモデル
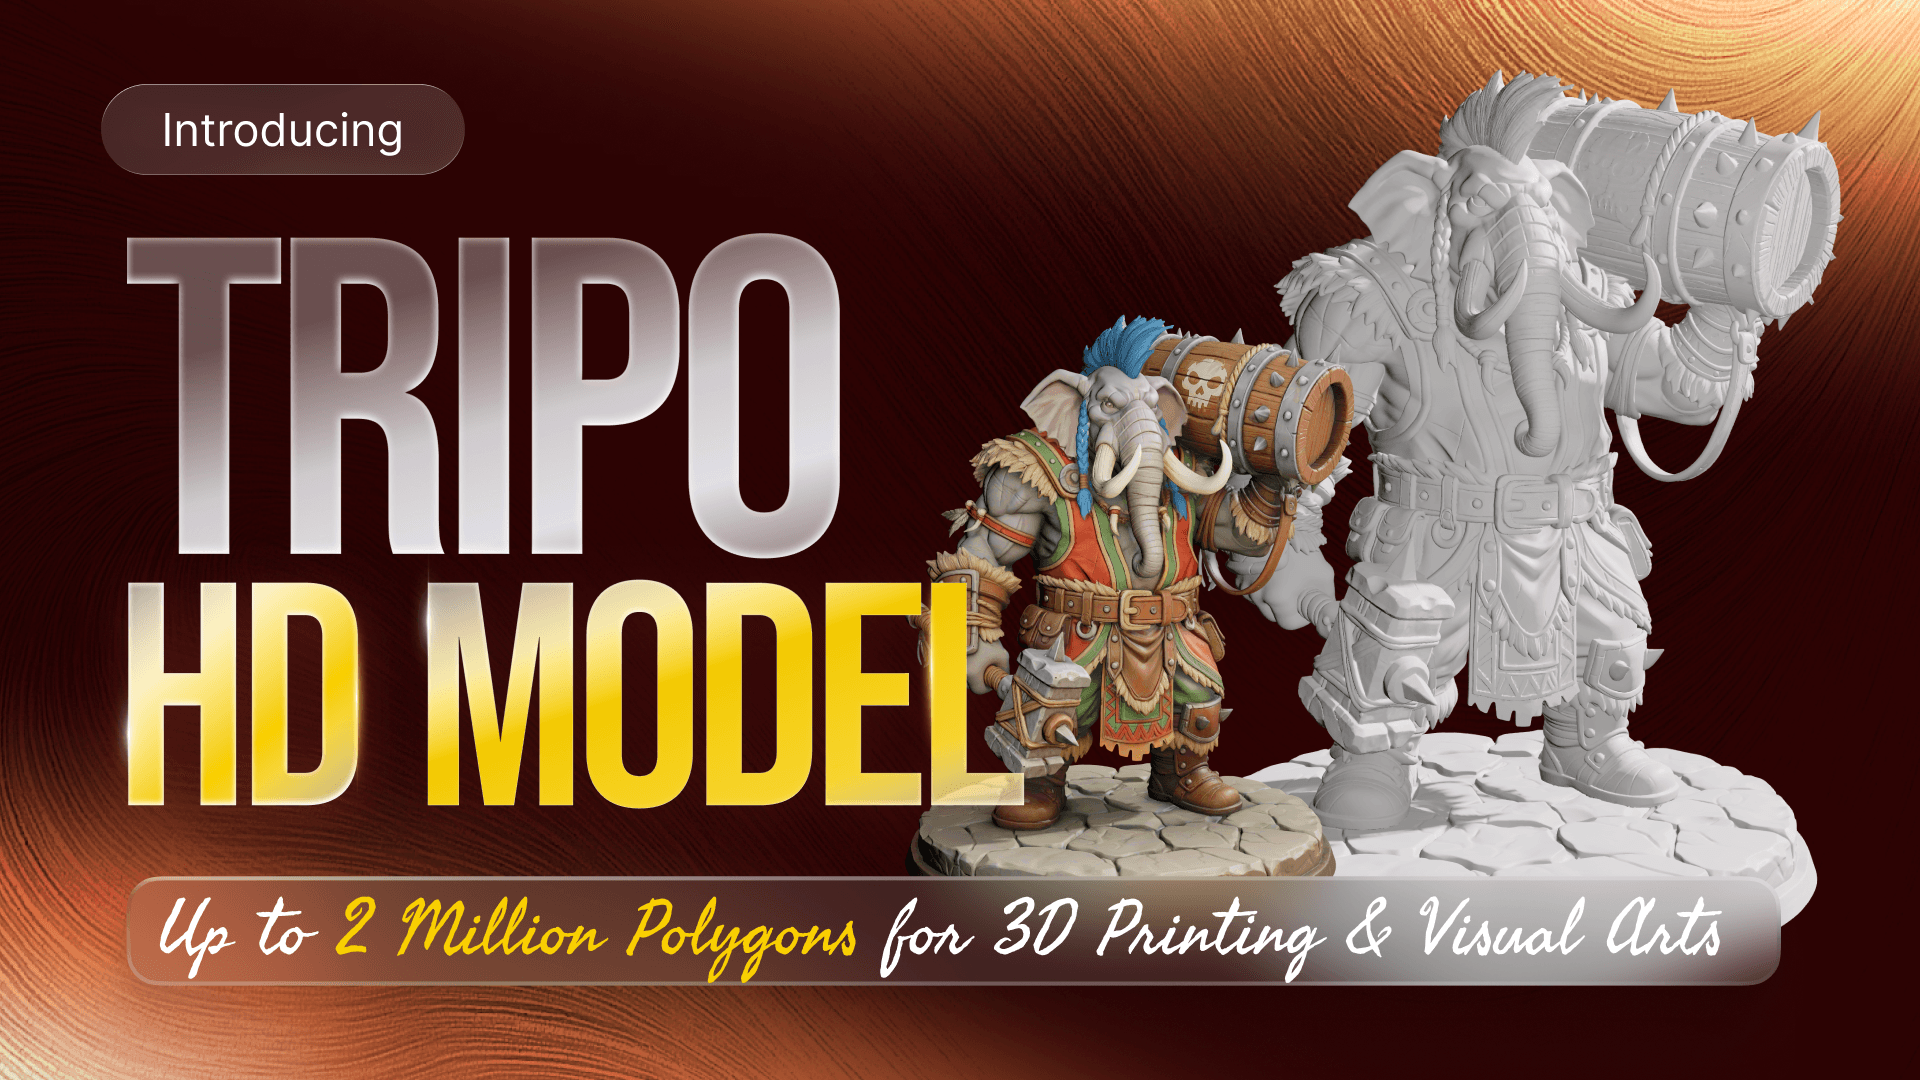
HD Modelは最大200万面をサポートし、レンダリング、可視化、3Dプリント向けに、複雑な形状、鋭いエッジ、細かな表面特徴を保持します。
読み続けて
Stop Building AI Data Infra for the Wrong Stage
Learn how AI data infrastructure should evolve from prototype to enterprise scale, and when Vector Lakebase becomes the right architecture for AI apps.
Zilliz Cloud Update: Smarter Autoscaling for Cost Savings, Stronger Compliance with Audit Logs, and More
What's new in Zilliz Cloud? Smarter autoscaling with scale-down, audit logs GA, enhanced SSO, and Milvus 2.6 in Private Preview.
Introducing DeepSearcher: A Local Open Source Deep Research
In contrast to OpenAI’s Deep Research, this example ran locally, using only open-source models and tools like Milvus and LangChain.