




Kubernetesでベクターデータベースを運用するための10のヒント
ベクトルデータベースは、類似性検索のために設計されており、レコメンデーションシステム、画像検索、AI駆動の検索のようなアプリケーションに不可欠です。Kubernetes上でベクトルデータベースを実行すると、スケーラビリティと自動化が可能になりますが、一貫したパフォーマンスを維持するには慎重な設定が必要です。ステートレスアプリケーションとは異なり、ベクトルデータベースは永続ストレージ、効率的なリソース管理、最適化されたクエリ実行に依存するため、デプロイはより複雑になります。
Kubernetesはワークロードを管理するためのツールを提供しますが、ベクトルデータベースを効率的に実行するには、単にデプロイするだけでは不十分です。ストレージ性能、オートスケーリング、セキュリティ、監視などの要素を適切に設定し、ボトルネックを防ぎ安定性を維持する必要があります。これらの最適化がなければ、リソース競合、非効率なインデックス作成、遅いクエリ実行によってパフォーマンスが低下する可能性があります。
この記事では、Kubernetes上でベクトルデータベースをデプロイおよび管理するためのベストプラクティスを解説します。これには、信頼性が高くスケーラブルなシステムを確保するのに役立つStatefulSetデプロイ、ストレージ設定、オートスケーリング戦略、セキュリティ対策、パフォーマンスチューニングが含まれます。
1. 信頼性の高いデプロイのためにStatefulSetを活用する
ベクトルデータベースには安定したネットワークIDと永続ストレージが必要なため、Kubernetes上でデプロイするにはStatefulSetが推奨される方法です。交換可能なPodを作成するDeploymentとは異なり、StatefulSetは各Podに固定IDを割り当て、Podが再起動または再スケジュールされてもデータが失われないようにします。この安定性は、一貫したPod名と永続ストレージに依存する分散データベースにとって不可欠です。
ベクトルデータベースは複数の相互接続されたサービスを伴うことが多いため、StatefulSetを使用すると、各データベースインスタンスは固有の識別子(pod-0、pod-1など)を保持し、別のノードに移動した場合でもストレージに再接続できます。この一貫性はクエリパフォーマンスの維持に役立ち、データ破損を防ぎます。
例:MilvusでStatefulSetを使用する
次のスニペットは、35Kを超えるGitHubスターを持つ主要なオープンソースベクトルデータベースであるMilvusが、依存関係に対してStatefulSetを手動で定義するのではなく、どのようにStatefulSetを使用しているかを示す簡略化された例です。Milvus Operatorは、必要な場所でStatefulSetを自動的に設定し、Milvus自体に対する直接的なStatefulSet定義を必要とせずに安定したデプロイを保証します。
apiVersion: milvus.io/v1beta1
kind: Milvus
metadata:
  name: milvus-cluster
spec:
  dependencies:
    storage:
      inCluster:
        values:
          mode: distributed
            replicaCount: 3  # Ensures MinIO runs as a StatefulSet for storage
この例では、MilvusリソースがMilvus Operatorに対して、分散MinIOを使用してストレージをデプロイするよう指示します。mode: distributedとreplicaCount: 3の設定により、高可用性と永続ストレージのためにMinIOが複数のレプリカで実行されます。Operatorは、手動のStatefulSet定義を必要とせずに、MinIOやその他の依存関係の基盤となるデプロイ設定を自動的に処理します。
StatefulSetが不可欠な理由
StatefulSetは、ベクトルデータベースのデプロイにおいて安定性、データ整合性、効率的なスケーリングを維持するのに役立ついくつかの利点を提供します。
安定したネットワークID: これにより、各Podがシームレスな内部通信のための予測可能なDNS名を持つことが保証されます。
永続ストレージ: Podが再起動してもボリュームクレームを保持し、データ損失を防ぎます。
制御されたスケーリングとアップグレード: 新しいレプリカが安定性を維持し、既存のデータがそのまま保たれることを保証します。
StatefulSetはベクターデータベースを実行するための強固な基盤を提供しますが、その有効性は適切に構成されたストレージに依存します。ここからは、パフォーマンスと信頼性のために永続ストレージを最適化する方法を見ていきましょう。
2. パフォーマンスのために永続ストレージを構成する
永続ストレージはベクターデータベースにおいて重要な役割を果たします。ベクターデータベースは大規模なデータセットを扱い、頻繁な読み取りおよび書き込み操作を実行するためです。適切なストレージ構成により、 インデックス作成、クエリ実行、データ取得が効率的になり、ボトルネックを最小限に抑えられます。Kubernetesは複数のストレージオプションを提供しているため、データベースのワークロードに基づいて、パフォーマンス、耐久性、スケーラビリティのバランスが取れたものを選択することが重要です。
適切なストレージバックエンドの選択
ベクターデータベースでは一般的に、オブジェクトストレージ、ブロックストレージ、分散ファイルシステムを組み合わせて使用し、それぞれがシステムの異なる部分に適しています。オブジェクトストレージ(例:MinIO、AWS S3)は、そのスケーラビリティにより、通常ベクトル埋め込みやインデックスの保存に使用されます。一方、ブロックストレージ(例:SSDベースのPersistentVolume)はメタデータやログにより適しています。ローカルSSDは最も低いレイテンシを提供しますが、ノード固有であるため、フェイルオーバーが複雑になります。ネットワーク接続ストレージ(NAS)はノード間で永続性を実現できますが、ネットワークレイテンシをもたらす可能性があります。これらのトレードオフを理解することで、高可用性と高速なクエリパフォーマンスを確保するストレージ戦略を設計しやすくなります。
永続ストレージに関する主な考慮事項
Kubernetes上でベクターデータベースのストレージを構成する際、特定の要素がパフォーマンスと信頼性に直接影響します。
ストレージクラスの選択: 低レイテンシアクセスを確保するために、SSDベースやプロビジョニング済みIOPSストレージなど、データベースワークロード向けに最適化されたストレージクラスを選択します。
読み取り/書き込みアクセス: 複数のノードが同じデータセットに対して読み取りと書き込みを行う必要がある場合、データベースストレージが同時アクセスを許可していることを確認します。
スナップショットとバックアップのサポート: 自動スナップショットをサポートするストレージバックエンドを使用し、障害や破損からの復旧を迅速化します。
Milvus向けにオブジェクトストレージを設定する場合は、そのプロセスを詳しく説明した専用ガイドがあります。 Milvus Operatorでオブジェクトストレージを構成する。
ストレージ効率はベクターデータベースのパフォーマンスに大きな役割を果たしますが、コンピュートリソースの管理も同様に重要です。次のヒントでは、安定的で応答性の高いシステムを維持するために、リソース要求と制限を最適化することに焦点を当てます。
3. リソース要求と制限を最適化する
CPUおよびメモリリソースを効果的に管理することは、Kubernetes上で稼働するベクターデータベースのパフォーマンスと安定性を維持するうえで不可欠です。リソース要求と制限を適切に設定することで、データベースPodがインデックス作成やクエリ実行などの操作を処理するために必要なリソースを確保しつつ、クラスター内の他のワークロードに影響を与えるほど過剰なリソースを消費することを防げます。
CPUとメモリ割り当てのバランス
ベクターデータベースは、特に大規模な類似検索を処理する場合、計算負荷が高くなります。パフォーマンスの問題を避けるには、適切な要求(最低限保証されるリソース)と制限(Podが消費できる最大リソース)を定義することが重要です。
リソース要求と制限に関する主な考慮事項
ベクターデータベースのリソース割り当てを構成する際は、以下を考慮してください。
CPUとメモリの要求を設定する: データベースPodが常に必要な最小リソースを確保できるように、要求を定義します。たとえば、インデックス作成ジョブを実行するPodには、少なくとも
4 CPUと16Giのメモリが必要になる場合があります。制限は慎重に使用する: 制限はPodが過剰なリソースを消費するのを防ぎますが、低すぎる値に設定するとスロットリングを引き起こす可能性があります。クエリ負荷の高いワークロードでは、厳格なCPU制限の設定を避けてください。応答時間が遅くなる可能性があります。
負荷に基づいて監視と調整を行う: リソースの必要量は、クエリ量やデータセットサイズに応じて変化します。Kubernetes の監視ツールを使用してパフォーマンスを追跡し、必要に応じてリソース設定を調整します。
たとえば、Milvus のようなベクトルデータベースをデプロイする場合、特定のデータセット特性に基づいてリソース要件を見積もるために Milvus Sizing Toolを利用できます。
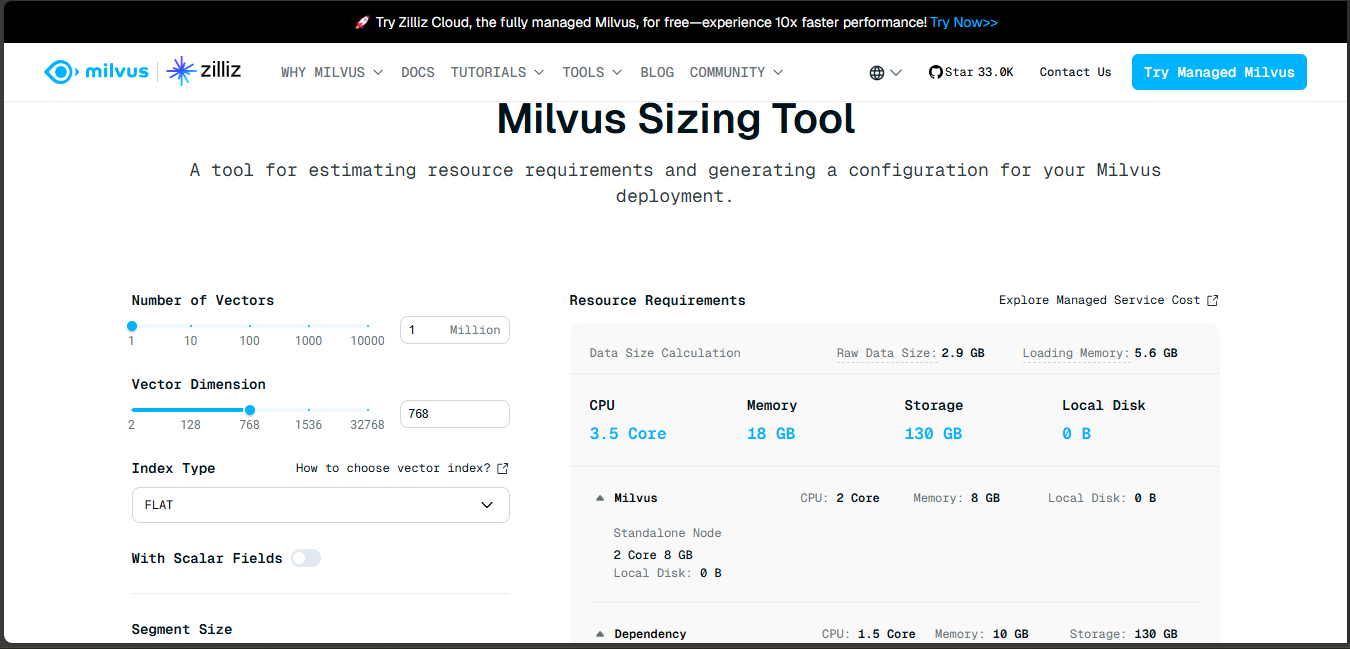 図- Milvus sizing tool
図: Milvus sizing tool
このツールでは、ベクトル数、ベクトル次元、インデックスタイプなどのパラメータを入力して、カスタマイズされた構成を生成でき、デプロイメントがワークロードに合わせて最適化されていることを保証します。
リソースリクエストと制限を慎重に設定することで、ベクトルデータベースのために安定した効率的な環境を維持し、変動するワークロード下で最適に動作するようにできます。
4. 効率的なリソース利用のためにオートスケーリングを実装する
ベクトルデータベースのワークロードは、クエリ量、インデックス作成ジョブ、データ取り込み率に応じて大きく変動する可能性があります。固定されたリソース割り当ては、リソースを浪費する過剰プロビジョニングや、パフォーマンスを低下させる過小プロビジョニングのいずれかにつながり、非効率な利用を招く場合があります。オートスケーリングは、リアルタイムの需要に基づいてリソースを動的に調整し、コストを最適化しながらデータベースの応答性を維持するのに役立ちます。
ベクトルデータベースのスケーリングアプローチ
Kubernetes におけるオートスケーリングは、データベースの構造に応じて、さまざまなレベルで適用できます。一般的に使用されるオートスケーリングメカニズムは次のとおりです。
Horizontal Pod Autoscaler (HPA): CPU、メモリ、またはカスタムメトリクスに基づいて Pod の数を調整します。たとえば、クエリトラフィックが増加した場合、追加の読み取りレプリカを自動的にプロビジョニングできます。
Vertical Pod Autoscaler (VPA): レプリカ数をスケーリングする代わりに、個々の Pod の CPU とメモリ割り当てを調整します。これは、より多くの計算能力を必要とするインデックス作成やクエリワークロードの最適化に役立ちます。
Cluster Autoscaler: リソース需要が利用可能な容量を超えた場合にワーカーノードをスケーリングすることで、新しい Pod をスケジュールできるようにします。
適切なオートスケーリングアプローチの選択は、データベースのワークロードによって異なります。たとえば、読み取りの多いワークロードでは HPA の恩恵を受けることが多い一方、計算集約型のインデックス作成タスクでは、必要に応じて CPU とメモリを動的に割り当てるために VPA が必要になる場合があります。
オートスケーリングに関する主な考慮事項
オートスケーリングは、過剰なスケーリングやパフォーマンスのボトルネックを避けるために慎重に構成する必要があります。次の要因は、パフォーマンスとリソース効率の最適なバランスを維持するのに役立ちます。
スケーリングトリガーを定義する: スケーリングをいつ行うべきかを判断するために、CPU、メモリ、またはクエリ応答時間などのカスタムメトリクスにしきい値を設定します。
パフォーマンスとコストのバランスを取る: オートスケーリングは、データベースがピーク負荷を処理できるようにしつつ、不要なコストにつながる過剰なスケーリングを防ぐ必要があります。
スケーリング動作をテストする: インデックス作成やクエリパフォーマンスの中断を防ぐために、データベースがオートスケーリングイベントにどのように反応するかを監視します。
動的スケーリングは、ベクトルデータベースが変化するワークロードを効率的に処理するのに役立ちますが、パフォーマンスの可視性を維持することも同様に重要です。監視とロギングは、データベースの健全性を追跡し、潜在的な問題を診断するうえで重要な役割を果たします。
5. 堅牢な監視とロギングを確保する
監視とロギングは、Kubernetes 上で実行されるベクトルデータベースのパフォーマンスと安定性を維持するために不可欠です。適切な可観測性がないと、クエリの遅延、リソースのボトルネック、ノード障害などの問題が見過ごされ、パフォーマンス低下やダウンタイムにつながる可能性があります。適切に構成された監視とロギングのセットアップにより、プロアクティブなトラブルシューティングと最適化が可能になります。
主要メトリクスの監視
ベクトルデータベースの健全性と効率を追跡するには、特定のパフォーマンス指標を監視する必要があります。
クエリレイテンシ: 結果の取得にかかる時間を測定します。レイテンシの増加は、リソースの飽和や非効率なインデックス作成を示している可能性があります。
リソース使用率(CPU、メモリ、I/O): CPU やメモリの使用率が高い場合は、デプロイメントの規模が不足していることを示唆する一方、使用率が低い場合は過剰なプロビジョニングを示している可能性があります。
ストレージパフォーマンス: 読み取り/書き込み速度と利用可能な容量を追跡し、低速なディスクや不十分なストレージによるパフォーマンス低下を防ぎます。
Pod と Node の健全性: データベース Pod が期待どおりに実行されていること、および頻繁な再起動や障害がないことを確認します。
これらのメトリクスを追跡することで、潜在的なパフォーマンスのボトルネックに関する洞察が得られ、さまざまなワークロード下でもデータベースの応答性を維持するのに役立ちます。ただし、監視だけでは十分ではありません。ログは、問題の診断や長期的なデータベースの動作の理解に、より深いコンテキストを提供します。
ロギングおよび監視ツールの実装
データベースのパフォーマンスを可視化するために、いくつかの Kubernetes ネイティブなツールが提供されています。Prometheus はデータベース Pod からパフォーマンスメトリクスを収集するために一般的に使用され、Grafana はダッシュボードを通じてリアルタイムの可視化を可能にします。ロギングには、Fluentd、Fluent Bit、または Loki のようなソリューションが複数の Pod からログを集約し、問題の診断を容易にします。さらに、Kubernetes のイベントとログを調査することで、クラッシュ、失敗したクエリ、または予期しないスケーリング動作のトラブルシューティングに役立ちます。これらのツールを組み合わせることで、パフォーマンス最適化とインシデント解決を支援する包括的な監視システムが構築されます。
適切な監視が整っていれば、データベース運用はより予測可能になりますが、データベース環境を保護することも同じくらい重要です。Kubernetes デプロイメントでセキュリティを確保するためのベストプラクティスを見てみましょう。
6. セキュリティのベストプラクティスを実装する
Kubernetes 環境内でベクトルデータベースを保護することは、機密データを保護し、システムの整合性を維持するために不可欠です。強力なセキュリティ戦略には、アクセス制御、ネットワークポリシー、シークレット管理に対処する複数のレイヤーが含まれます。これらの対策を適切に実装することで、不正アクセス、データ侵害、運用上の中断のリスクを低減できます。
アクセス制御
ロールベースアクセス制御(RBAC)は、ユーザーロールに基づいてシステムアクセスを制限するために不可欠です。ユーザーとサービスに必要な権限のみを割り当てることで、RBAC は最小権限の原則に従い、偶発的または悪意のある行為のリスクを低減します。マルチテナント環境では、異なるユーザーグループ間の不正アクセスを防ぐために、追加の分離メカニズムを実装する必要があります。
ネットワークポリシー
Pod とサービス間のネットワークトラフィックを制御することは、潜在的な脅威への露出を制限するために重要です。Kubernetes Network Policies により、管理者はコンポーネント間のトラフィックを許可または拒否するルールを定義できます。たとえば、特定のアプリケーション Pod のみがデータベースと通信できるようにアクセスを制限することで、不正なサービスや外部の脅威が接続できないようにします。さらに、Transport Layer Security(TLS)などの暗号化プロトコルを実装することで、転送中のデータを傍受や改ざんから保護できます。
シークレット管理
パスワード、APIキー、証明書などの機密情報を安全に管理することは極めて重要です。Kubernetes Secrets は、このデータを設定ファイル内で公開することなく保存・管理する方法を提供します。漏洩リスクを最小限に抑えるため、Secrets は暗号化し、定期的にローテーションし、厳格に管理する必要があります。Secrets へのアクセスを監査することで、不正な試行を追跡し、セキュリティポリシーへの準拠を確保できます。
これらのセキュリティベストプラクティスを統合することで、ベクトルデータベースを不正アクセスや脆弱性から保護し続けることができます。セキュリティは一度限りの設定ではなく、継続的な監視と改善を必要とする継続的なプロセスです。
7. 最適なパフォーマンスのための Pod のノードへの割り当て
Kubernetes における効率的な Pod 配置は、ベクトルデータベースのパフォーマンスと安定性に大きな影響を与える可能性があります。ベクトルデータベースは高速なディスクアクセス、メモリ集約型の計算、低レイテンシのネットワーク通信に依存するため、適切なスケジューリングにより、データベースインスタンスがそのワークロードに最適なノード上で実行されることが保証されます。Kubernetes は、クラスター内でデータベース Pod をどこに、どのようにスケジュールするかを制御するための複数の仕組みを提供しています。
Pod 配置の制御
Kubernetes では、管理者が node selectors、affinity/anti-affinity ルール、taints/tolerations を使用して Pod のスケジューリングに影響を与えることができます。
Node Selectors: ラベルに基づいて Pod を特定のノードに割り当てます。たとえば、
disktype=ssdのようなラベルを追加することで、ベクトルデータベースを高性能 SSD ストレージを備えたノードにスケジュールできます。Node Affinity: selectors よりも柔軟な制約を提供し、Pod が特定のノード属性を優先または必須とすることを可能にします。たとえば、ベクトル検索の高速化が必要な場合、データベース Pod を GPU ノードにスケジュールできます。
Pod Anti-Affinity: データベースのレプリカが異なるノードに分散されるようにし、可用性と耐障害性を向上させます。
Taints and Tolerations: 適切な toleration を持たない限り、Pod が特定のノード上で実行されるのを防ぎ、パフォーマンスが重要なワークロード向けに専用リソースを確保します。
これらのスケジューリング戦略を使用することで、パフォーマンス、可用性、リソース効率のバランスを取り、ベクトルデータベース Pod が最適な環境にデプロイされることを保証できます。ただし、適切な配置戦略の選択は、ワークロード要件やインフラストラクチャ上の制約にも依存します。
Pod スケジューリングにおける主な考慮事項
Pod 配置戦略を定義する際には、データベースが効率的に稼働し、回復性を維持できるように、いくつかの要素を考慮する必要があります。
Storage Performance: 可能な場合は、クエリレイテンシを削減し、インデックス作成速度を向上させるために、ローカル SSD を備えたノードに Pod を割り当てます。
Workload Isolation: リソースを大量に消費するアプリケーションが稼働しているノードでデータベース Pod が実行されないようにし、競合を防ぎます。
High Availability: ノード障害の影響を最小限に抑えるため、データベースレプリカを複数のノードに分散します。
Pod を適切にノードへ割り当てることで、ベクトルデータベースが効率的に動作するために必要なリソースを確保できます。スケジューリングはリソース使用率を最適化しますが、コンテナ環境を保護することで、データベースの信頼性をさらに強化できます。その方法を見てみましょう。
8. 安全なコンテナ設定
コンテナ化された環境が適切に保護されていることを確保することは、ベクトルデータベースを脆弱性や不正アクセスから守るために不可欠です。Kubernetes はクラスター レベルでセキュリティ制御を提供しますが、リスクを最小限に抑えるためには、個々のコンテナのセキュリティにも対処する必要があります。不十分なコンテナセキュリティは、データベースを権限昇格、データ侵害、コンテナエスケープ攻撃にさらす可能性があります。
データベースコンテナを保護するためのベストプラクティス
コンテナセキュリティには、権限の制限、ファイルシステムアクセスの制御、安全なイメージの使用が含まれます。以下の対策は、攻撃対象領域を減らし、全体的なセキュリティを向上させるのに役立ちます。
非Rootユーザーとして実行する: デフォルトでは、多くのコンテナがrootとして実行されるため、コンテナが侵害された場合に権限昇格のリスクが高まります。セキュリティコンテキストで
runAsNonRootおよびrunAsUserパラメータを設定することで、データベースプロセスが必要最小限の権限で実行されるようになります。読み取り専用ファイルシステムを使用する: 読み取り専用のルートファイルシステムを強制することで、システムファイルへの不正な変更を防ぎ、潜在的な脅威を封じ込めるのに役立ちます。
不要なLinuxケイパビリティを削除する: Kubernetesは、コンテナのプロセスから未使用のケイパビリティを削除する方法を提供し、悪用のリスクを低減します。
capabilities.drop: ["ALL"]を使用し、必要な権限のみを有効にすることで、セキュリティが強化されます。コンテナイメージを定期的にスキャンおよび更新する: データベースコンテナイメージを最新のセキュリティパッチで最新の状態に保つことで、既知の脆弱性が悪用されるのを防ぎます。さらに、最小限のベースイメージを使用することで、潜在的な攻撃ベクトルの数を減らせます。
コンテナセキュリティに関する主な考慮事項
セキュリティのベストプラクティスを適用することで、パフォーマンスと安定性を維持しながらベクトルデータベースを保護できます。ただし、セキュリティ設定はワークロード要件とコンプライアンスのニーズに基づいて調整する必要があります。
互換性を確保する: 一部のデータベースでは特定のシステムケイパビリティが必要なため、セキュリティ制限が重要な操作を妨げないようにする必要があります。
セキュリティイベントを監視する: Falco のようなランタイムセキュリティツールを実装して、データベースコンテナ内の疑わしいアクティビティを検出し、対応します。
ネットワークアクセスを制限する: コンテナセキュリティ設定とあわせてKubernetes Network Policiesを使用し、外部脅威への露出をさらに制限します。
コンテナ構成を保護することで、ベクトルデータベースは制御された環境内で稼働しながら、潜在的な攻撃に対する耐性を維持できます。コンテナセキュリティはリスクの低減に役立ちますが、強力なバックアップおよび災害復旧戦略を持つことも同様に重要です。
9. バックアップおよび災害復旧計画を確立する
ベクトルデータベースは、AIおよび検索アプリケーションに不可欠なインデックス化された埋め込みやメタデータを含む、大量の価値あるデータを保存します。堅牢なバックアップおよび災害復旧(DR)戦略がなければ、ハードウェアクラッシュ、誤削除、設定ミスなどの予期しない障害により、データ損失や長時間のダウンタイムが発生する可能性があります。十分に計画されたバックアップおよび復旧アプローチにより、データの耐久性とシステムの回復力が確保されます。
バックアップ戦略の主要コンポーネント
信頼性の高いバックアップ計画には、定期的なスナップショット、オフサイトストレージ、自動復旧手順を含める必要があります。以下のコンポーネントは、バックアップが有効かつアクセス可能な状態を維持するのに役立ちます。
自動スナップショット: Kubernetesネイティブのバックアップソリューションまたはデータベース固有のスナップショットツールを使用して、永続ボリュームの定期的なバックアップを取得します。クラウドプロバイダーは多くの場合、ストレージの迅速な復元を可能にするVolumeSnapshotsをサポートしています。
オフサイトおよびオブジェクトストレージバックアップ: オブジェクトストレージサービス(例: MinIO、S3)などのリモートロケーションにバックアップを保存することで、ローカルハードウェア障害やクラスター全体の問題に対する追加の保護が得られます。
ポイントインタイムリカバリ: 一部のベクトルデータベースは、Write-Ahead Logging(WAL)または増分バックアップをサポートしており、特定のタイムスタンプへの復旧を可能にします。これにより、破損や誤削除が発生した場合のデータ損失を最小限に抑えられます。
災害復旧に関する考慮事項
バックアップに加えて、災害復旧計画により、最小限のダウンタイムでデータベースを効率的に復元できるようになります。以下のベストプラクティスは回復力を向上させます。
リカバリ手順を定期的にテストする: バックアップは、正常に復元できて初めて有用です。復元プロセスを定期的にテストすることで、システムが期待どおりにリカバリできることを検証できます。
マルチゾーンまたはマルチリージョンクラスターでデプロイする: 可用性ゾーンまたはリージョンをまたいでデータベースレプリカを実行することで、リージョン障害時の耐障害性が向上します。
フェイルオーバーメカニズムを自動化する: データベースレプリカの自動フェイルオーバーを構成することで、プライマリノードに障害が発生した場合に、別のノードがシームレスに引き継ぐことを保証できます。
強力なバックアップとディザスタリカバリ戦略により、さまざまな障害シナリオにおいてデータが保護され、復旧可能な状態に保たれます。データ保護は不可欠ですが、データベース構成を最適化することで、パフォーマンスと効率がさらに向上します。
10. 最適なパフォーマンスのためにデータベースパラメータを微調整する
ベクトルデータベースを正しく構成することで、特に大規模なクエリやインデックス作成操作を処理する際に、効率的に動作することが保証されます。Kubernetes はリソース管理に柔軟性を提供しますが、クエリ速度、メモリ使用量、インデックス作成効率を最適化するには、データベース固有のチューニングが必要です。ワークロードパターンに基づいてパラメータを調整することで、全体的なパフォーマンスを大幅に向上させることができます。
最適化すべき主要領域
ベクトルデータベースのチューニングには、インデックス戦略、キャッシュ設定、クエリパフォーマンスパラメータの構成が含まれます。以下の最適化は、スムーズな運用を確保するのに役立ちます。
インデックス戦略: IVF、HNSW、DISKANN、または PQ ベースの手法など、適切なインデックスタイプを選択することは、検索精度と速度に影響します。たとえば、HNSW のような階層型インデックスは、より高速な最近傍探索を提供しますが、より多くのメモリを必要とします。
キャッシュとメモリ管理: キャッシュサイズを増やすことで、頻繁にアクセスされるベクトルをメモリ内に保持でき、ディスク読み取りを削減できます。データベースは多くの場合、メモリ使用量とクエリレイテンシのバランスを取るために、キャッシュ割り当てを微調整するパラメータを提供しています。
クエリの並列処理: 多くのベクトルデータベースは、複数の CPU コアを活用するために並列クエリ実行をサポートしています。スレッド割り当て設定を調整することで、計算リソースを最適に利用できます。
インデックス構築のためのバッチ処理: インデックス構築はリソースを大量に消費する場合があります。インデックス作成をバッチ単位またはオフピーク時間帯に実行することで、クラスターの安定性を維持しながら過剰なリソース消費を防げます。
パフォーマンスチューニングに関する考慮事項
データベースパラメータの最適化には、実際のワークロードに基づく継続的な監視と調整が必要です。以下の要素を考慮する必要があります。
クエリレイテンシを監視する: 応答時間を追跡して遅いクエリを特定し、それに応じてインデックスやキャッシュ設定を調整します。
精度と速度のバランスを取る: より高いリコール率には多くの場合、より多くの計算能力が必要です。インデックスパラメータを調整することで、ワークロードに適したトレードオフを見つけることができます。
データ増加に基づいて調整する: データセットが増大するにつれて、定期的なチューニングにより、時間が経っても一貫したパフォーマンスを維持できます。
データベース設定を微調整することで、ベクトルデータベースは高次元データ検索を大規模に処理できます。最適化されたデータベース構成と Kubernetes デプロイメントのベストプラクティスを組み合わせることで、組織は信頼性が高く高性能なベクトル検索アプリケーションを実現できます。
結論
Kubernetes 上でベクトルデータベースを実行するには、パフォーマンス、スケーラビリティ、セキュリティを最大化するための慎重な構成が必要です。StatefulSets による安定したデプロイメントの確保、パフォーマンスのための永続ストレージの構成、リソース割り当ての効果的な管理は、効率の維持に役立ちます。オートスケーリング、監視、セキュリティ対策はシステムの信頼性を確保し、バックアップとディザスタリカバリ計画はデータ損失から保護します。
ワークロードは時間とともに変化するため、継続的な監視と調整が不可欠です。これらのベストプラクティスを適用することで、Kubernetes 環境においてコスト効率とセキュリティを維持しながら、高性能でスケーラブルなベクトルデータベースを運用できます。
参考リソース
読み続けて
Notion's Vector Search Is Excellent. Their Next Problem Is Harder.
Notion solved vector search scaling in two years. The next bottleneck — offline context engineering, unified data, and the real-time/offline gap — is harder.
Introducing Zilliz Cloud Global Cluster: Region-Level Resilience for Mission-Critical AI
Zilliz Cloud Global Cluster delivers multi-region resilience, automatic failover, and fast global AI search with built-in security and compliance.
Why AI Databases Don't Need SQL
Whether you like it or not, here's the truth: SQL is destined for decline in the era of AI.
The Definitive Guide to Choosing a Vector Database
Overwhelmed by all the options? Learn key features to look for & how to evaluate with your own data. Choose with confidence.