




Миграция с S3 Vectors на Zilliz Cloud: раскрытие возможностей многоуровневого хранения
Неструктурированные данные теперь составляют почти 90% всех новых генерируемых данных. Бум ChatGPT сделал этот сдвиг еще более очевидным. С тех пор векторный поиск стал стандартным способом осмысления неструктурированных данных — обеспечивая работу GenAI-систем, таких как RAG-конвейеры, AI-агенты, рекомендательные движки и чат-боты.
Но векторный поиск не дешев. Он может требовать в 10–100 раз больше вычислительных ресурсов, чем NoSQL-нагрузка, особенно при неоптимизированных индексах, а в некоторых случаях он даже дороже, чем вызов LLM. Когда каждый запрос обращается к высокопроизводительному хранилищу и памяти, затраты могут расти быстрее, чем производительность.
AWS представила S3 Vectors, чтобы решить эту проблему, объединив векторный поиск с экономической эффективностью объектного хранилища. Это умная идея, но не без компромиссов: более высокая задержка, более низкий recall и ограниченная гибкость для крупномасштабных систем. Tiered Storage от Zilliz Cloud выбирает более сбалансированный путь. Он хранит весь ваш набор данных в объектном хранилище, используя локальные SSD и память каждого кластера как интеллектуальные кэши для ускорения запросов и доступа к данным.
В этом посте мы разберем, где S3 Vectors проявляет себя хорошо, а где не справляется, а затем покажем, как Tiered Storage от Zilliz Cloud решает эти ограничения. Вы также найдете короткое руководство по миграции ваших данных из S3 Vectors в Zilliz Cloud всего за несколько шагов.
S3 Vectors: дешево, но с явными ограничениями
Начнем с того, что работает. S3 Vectors дешев. Стоимость хранения составляет всего $0.06 за ГБ, что примерно в пять раз дешевле, чем у большинства serverless-векторных баз данных. В примерной нагрузке с 400 миллионами векторов и 10 миллионами запросов в месяц итоговый счет составляет около $1,200 в месяц — огромное снижение по сравнению с пятизначными счетами, которые вы обычно увидели бы в других местах. Для низконагруженных или терпимых к задержкам рабочих нагрузок с такой арифметикой трудно спорить.
У производительности есть границы: Компромиссы начинают проявляться, когда вы стремитесь к масштабу или отзывчивости:
Размер коллекции: Каждая таблица S3 хранит до 50 миллионов векторов, и существует глобальный лимит в 10,000 таблиц.
Задержка запросов: Ожидайте около 500 мс для коллекции из 1M векторов и 700 мс для 10M — приемлемо для фоновых задач, но не для приложений реального времени.
Пропускная способность: Вы получите задержку менее 200 мс до 200 QPS, но масштабироваться сверх этого непросто.
Скорость записи: Ограничена менее чем 2 МБ/с, что намного медленнее, чем у движков вроде Milvus, которые поддерживают запись на уровне ГБ/с. Плюс в том, что записи не блокируют чтения — но в целом он явно оптимизирован для статичных наборов данных с преобладанием чтения.
Точность и гибкость запросов: Recall обычно находится в диапазоне 85–90%, без настроек, позволяющих поднять его выше. Как только вы добавляете фильтры, recall может резко падать, иногда ниже 50%. В одном бенчмарке после удаления половины набора данных запрос Top-K=20 вернул только 15 результатов — явный признак того, что контроль точности ограничен.
Отсутствующие функции: S3 Vectors также пропускает несколько функций, которых разработчики часто ожидают в production-системах:
Запросы Top-K ограничены 30 результатами.
Строгие ограничения метаданных на запись.
Нет hybrid search, multi-tenancy, поддержки продвинутой фильтрации и многих других функций, готовых для enterprise.
S3 Vectors дешев и хорошо подходит для простых крупномасштабных задач поиска, где частота запросов низкая, а задержка не критична. Но когда рабочие нагрузки требуют поиска в реальном времени, гибридного retrieval или multi-tenant-архитектур, его простота быстро становится узким местом.
Zilliz Cloud Tiered Storage: экономично, быстро и готово к production
AWS объединила объектное хранилище с векторным поиском, чтобы снизить затраты. Zilliz Cloud развивает эту идею дальше с новым Tiered Storage, обеспечивая такую же экономическую эффективность и при этом реальную production-производительность.
Построенная на open-source Milvus, Zilliz Cloud — это полностью управляемая векторная база данных, предназначенная для крупномасштабных AI-нагрузок. Ее архитектура Tiered Storage хранит все векторные данные в объектном хранилище (например, AWS S3), используя локальные SSD и память каждого кластера как интеллектуальные кэши для ускорения запросов и доступа к данным. Результат: низкая стоимость S3 со скоростью и гибкостью выделенной векторной базы данных.
Под капотом Tiered Storage управляет тремя уровнями — Hot (память), Warm (SSD) и Cold (объектное хранилище):
Горячие данные остаются в памяти для мгновенного времени отклика.
Теплые данные находятся на локальных SSD, чтобы сбалансировать скорость и стоимость.
Холодные данные эффективно хранятся в объектном хранилище для долгосрочного хранения.
Система автоматически перемещает данные между уровнями на основе реальных паттернов запросов, поддерживая более 90% попаданий в кэш в производственном тестировании. На практике это означает, что большинство запросов обслуживаются напрямую из быстрых уровней — объединяя экономику объектного хранилища с отзывчивостью in-memory.
Практические сценарии использования Zilliz Cloud Tiered Storage
1. Крупномасштабные мультитенантные RAG/AI-приложения
Многие production AI-системы обслуживают миллионы тенантов, но лишь небольшая доля — обычно 1–5% — активна в каждый конкретный момент времени. Представьте AI-ассистентов для программирования, чат-приложения или copilots для клиентской поддержки.
С Tiered Storage Zilliz Cloud автоматически балансирует хранение на основе активности:
Около 95% данных неактивных тенантов остается в объектном хранилище, удерживая затраты на хранение близкими к уровню raw S3.
Активные 5% находятся в памяти или на SSD, обеспечивая извлечение с низкой задержкой во время текущих сессий.
2. Крупномасштабный низкочастотный анализ данных
Такие области, как автономное вождение, обучение моделей робототехники и разработка лекарств, генерируют наборы данных петабайтного масштаба — однако их запросные нагрузки часто невелики, от нескольких до нескольких сотен запросов в день. Для таких случаев постоянное хранение в памяти — избыточно.
Tiered Storage в Zilliz Cloud хранит холодные данные в объектном хранилище, кэшируя часто запрашиваемые образцы на более быстрых уровнях. Это снижает затраты на хранение до малой доли стоимости полностью in-memory систем, сохраняя пригодную задержку, позволяя исследовательским командам эффективно и доступно изучать огромные наборы данных — без изменения их рабочих процессов анализа.
Как перенести ваши данные из S3 Vectors в Zilliz Cloud
Теперь, когда Tiered Storage в Zilliz Cloud дает вам экономическую эффективность уровня S3 без компромиссов в производительности, следующий вопрос прост — как перенести ваши данные?
Рассмотрим простой пример. Предположим, вы сохранили 200 записей о книгах в регионе AWS us-west-2, в векторном индексе с именем books. Каждая запись содержит:
768-мерный вектор содержимого
Название книги как первичный ключ
Информация об авторе хранится в метаданных
Предварительные требования
Docker установлен и запущен.
Узел, на котором работает VTS, имеет доступ как к S3 Vectors, так и к Zilliz Cloud.
Ваш пользователь или роль IAM включает разрешение
s3vectors:ListVectors.
Проверка перед миграцией
Перед развертыванием VTS проверьте ваши данные S3 Vectors и доступ.
import boto3
import os

aws_access_key_id = os.getenv("AWS_ACCESS_KEY_ID")
aws_secret_access_key = os.getenv("AWS_SECRET_ACCESS_KEY")

s3vectors = boto3.client("s3vectors", region_name="us-west-2", aws_access_key_id=aws_access_key_id, aws_secret_access_key=aws_secret_access_key)

resp = s3vectors.list_vectors(vectorBucketName="vectors", indexName="books", returnMetadata=True, returnData=True)
for vector in resp["vectors"]:
    print(vector)
Вы должны увидеть 200 возвращенных записей.
{'key': 'First foot situation land bad.', 'data': {'float32': [0.7183347940444946……]}, 'metadata': {'author': 'Wendy Jones'}}
{'key': 'Face industry bit true.', 'data': {'float32': [0.9061349630355835……]}, 'metadata': {'author': 'Steven Smith'}}
{'key': 'Republican agreement probably home choose see.', 'data': {'float32': [0.26946496963500977……]}, 'metadata': {'author': 'Misty Lynch'}}
{'key': 'Before arrive design soon finally discuss.', 'data': {'float32': [0.35728317499160767……]}, 'metadata': {'author': 'Mark Johnson'}}
…………
Начало миграции
1.Загрузите последний образ VTS (версии 1.2.0 или выше):
docker pull zilliz/vector-transport-service:v1.2.0
2.Создайте файл конфигурации:
vim ./s3-vector_to_milvus.conf
3.Добавьте следующее содержимое (измените при необходимости):
env {
  execution.parallelism = 1
  job.mode = "BATCH"
}

source {
    S3Vector {
        region = "us-west-2"
        vector_bucket_name = "vector-bucket" # Name of your vector bucket
        index_name = "books"  # Name of your vector index
        ak = "ak" # aws_access_key_id
        sk = "sk" # aws_secret_access_key
    }
}

sink {
  Milvus {
      url="https://in01-***.<region>.zilliz.com.cn:19530"
      token="***"
      database="default"  # Target database
      batch_size=1  # Number of records per batch (larger batches are faster but use more memory)
    }
}
Сохраните файл.
4.Запустите контейнер VTS и смонтируйте ваш файл конфигурации:
docker run -v ./s3-vector_to_milvus.conf:/config/s3-vector_to_milvus.conf -it zilliz/vector-transport-service:v1.2.0 /bin/bash
5.Запустите процесс VTS внутри контейнера:
./bin/seatunnel.sh --config /config/s3-vector_to_milvus.conf -m local
Дождитесь завершения процесса. После завершения ваши данные будут успешно перенесены в Zilliz Cloud.
Проверка после миграции
После завершения миграции проверьте свои данные в Zilliz Cloud Console.
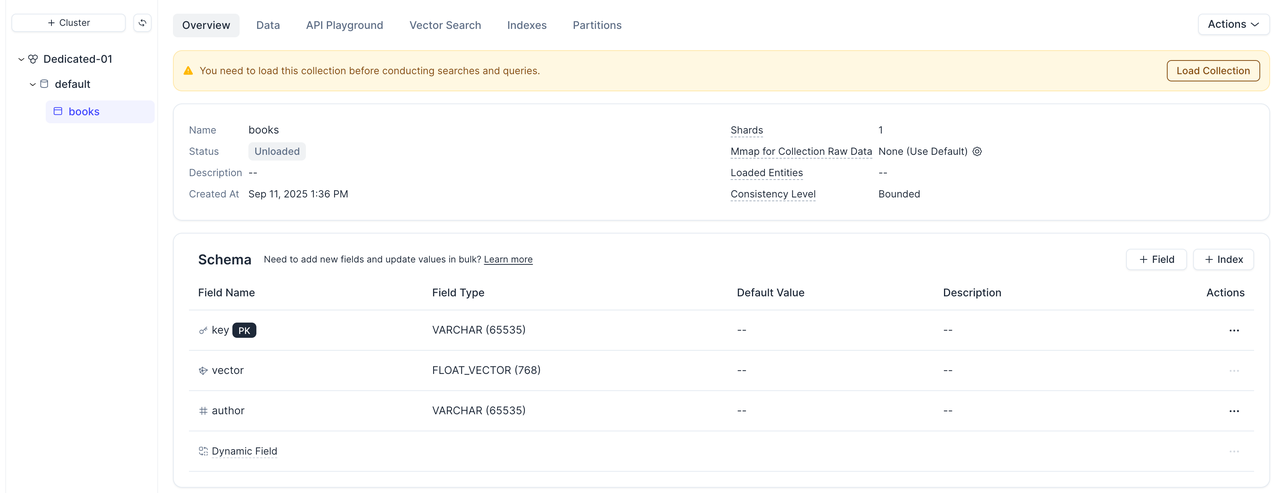
VTS автоматически обнаруживает поля метаданных и создает столбцы для каждого атрибута. Поле key используется как первичный ключ.
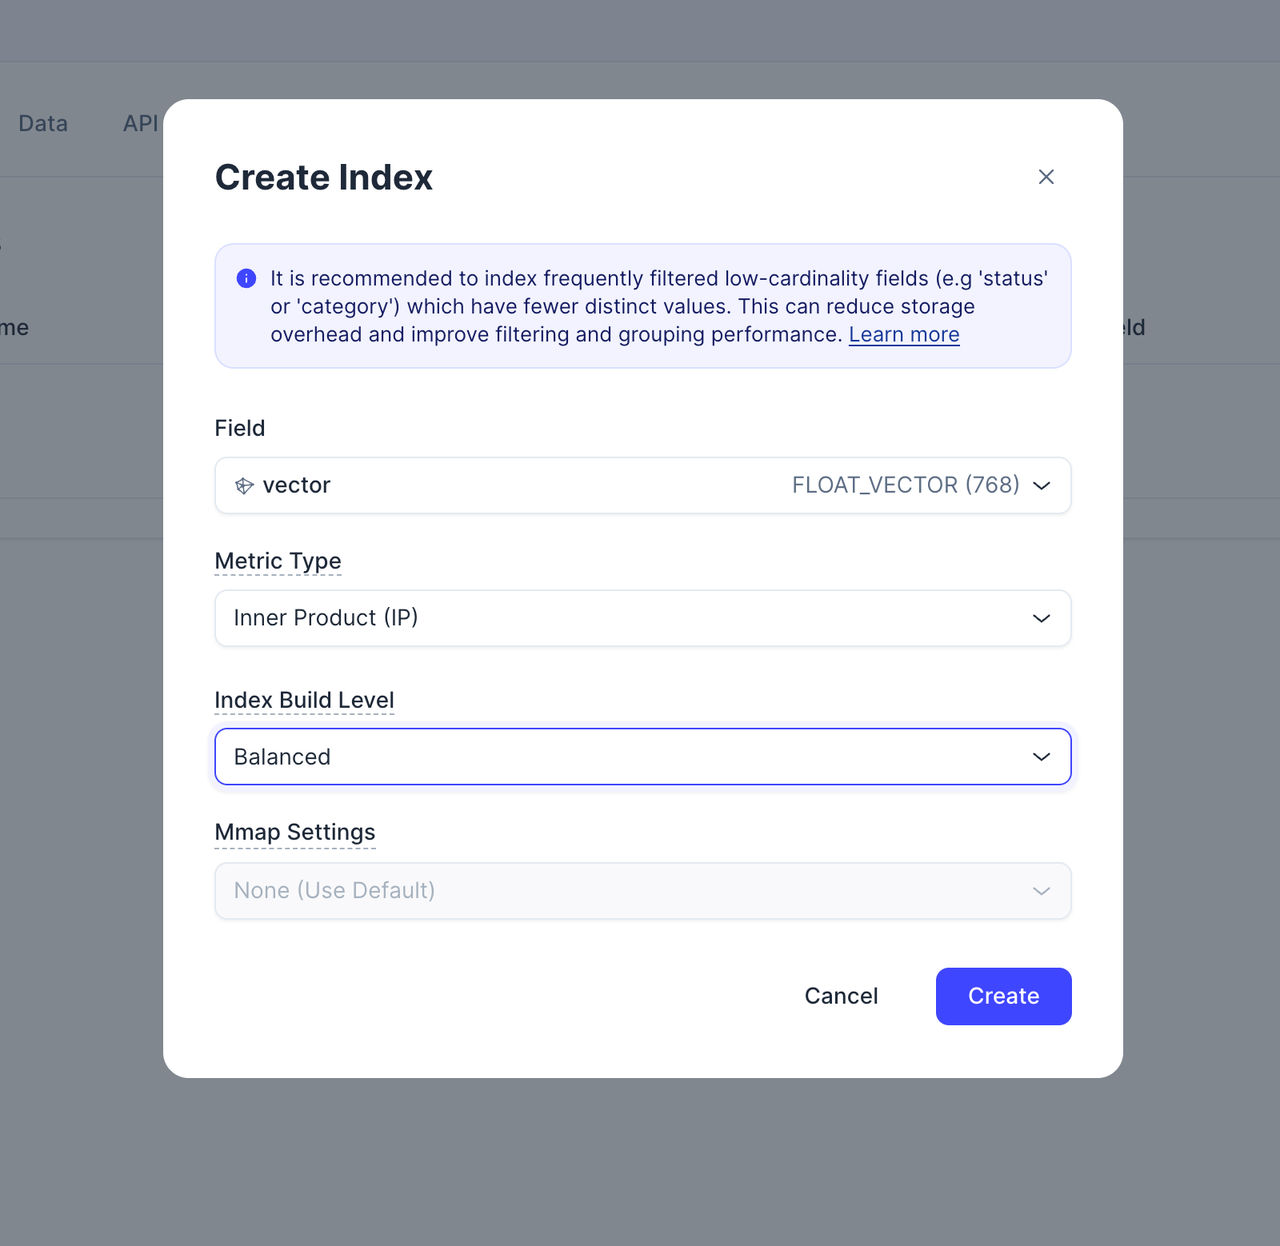
Создайте векторный индекс для векторного поля.
Выполните Load Collection для предварительного просмотра данных.
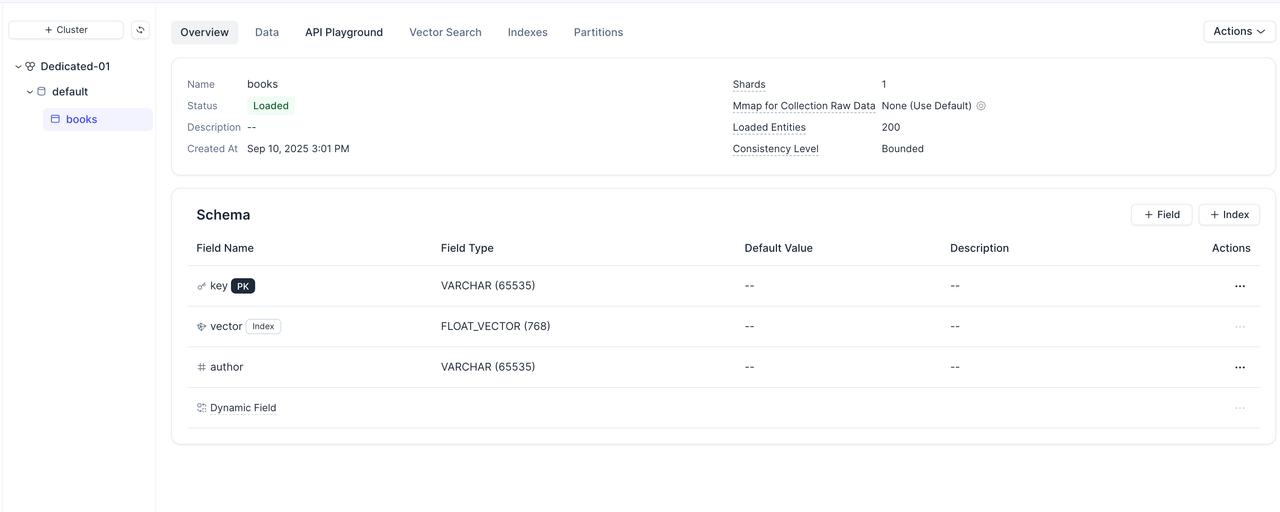
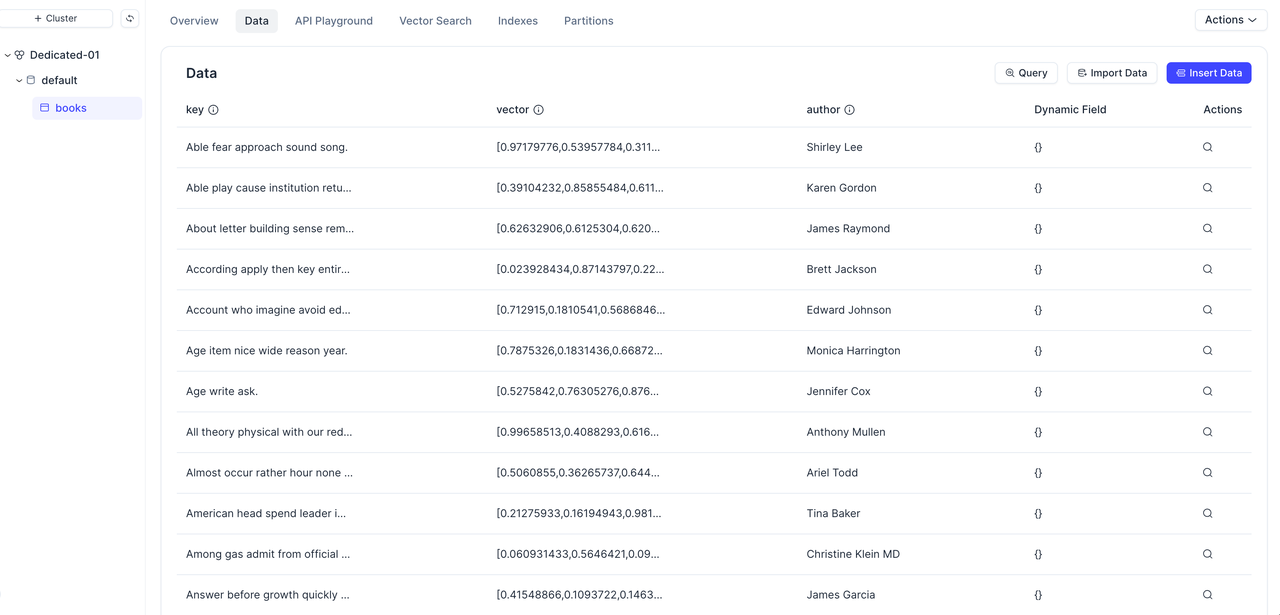
Вы должны увидеть, что количество записей и их содержимое точно совпадают с данными из S3 Vectors, что подтверждает успешную миграцию.
Подведение итогов
S3 Vectors снижает расходы, храня embeddings в объектном хранилище, — но ему не хватает производительности, полноты результатов и корпоративных функций. Zilliz Cloud развивает эту же идею дальше, сохраняя ценовое преимущество и добавляя скорость, гибкость и надежность, которые нужны реальным AI-приложениям.
Для разработчиков это означает, что больше не нужно выбирать между доступностью и производительностью. Вы можете масштабироваться до миллиардов векторов, обслуживать активные рабочие нагрузки из быстрых уровней и при этом экономично хранить холодные данные в объектном хранилище — все в рамках одной управляемой платформы.
Если вы сейчас используете S3 Vectors, миграция занимает всего несколько шагов, и вы сразу увидите преимущества в скорости запросов и простоте эксплуатации. Попробуйте, протестируйте на своих данных и посмотрите, как Zilliz Cloud меняет возможности крупномасштабного векторного поиска.
Попробуйте Zilliz Cloud сами
Всё ещё не уверены, подходит ли вам Zilliz Cloud? Зарегистрируйтесь бесплатно и получите $100 в виде кредитов, чтобы лично изучить ведущую в мире управляемую векторную базу данных.
Уже используете другую векторную базу данных? Zilliz Cloud поддерживает бесшовную миграцию из Pinecone, Qdrant, Elasticsearch, PostgreSQL, OpenSearch, Weaviate и даже локального Milvus — так что вы сможете перенести свои данные без лишних хлопот.
Если у вас в будущем возникнут вопросы о миграции, ознакомьтесь с нашей документацией или свяжитесь с нами — мы здесь, чтобы помочь вам получить максимум от Zilliz Cloud.
Читать далее
My Wife Wanted Dior. I Spent $600 on Claude Code to Vibe-Code a 2M-Line Database Instead.
Write tests, not code reviews. How a test-first workflow with 6 parallel Claude Code sessions turns a 2M-line C++ codebase into a daily shipping pipeline.
Zilliz Cloud Enterprise Vector Search Powers High-Performance AI on AWS
Zilliz Cloud on AWS powers secure, scalable, ultra-fast vector search for enterprise AI apps, with BYOC, sub-10ms latency, and zero-DevOps simplicity.
Vector Databases vs. Graph Databases
Use a vector database for AI-powered similarity search; use a graph database for complex relationship-based queries and network analysis.