Оценка мультимодальных RAG-систем с помощью Trulens
По мере того как мультимодальные архитектуры становятся всё более заметными в генеративном ИИ (GenAI), организации всё чаще создают решения с использованием мультимодальных моделей, таких как GPT-4V и Gemini Pro Vision. Эти модели предлагают ключевое преимущество: они могут семантически встраивать и интерпретировать различные типы данных — текст, изображения и многое другое, — что делает их более универсальными и эффективными, чем традиционные большие языковые модели (LLMs) в более широком спектре приложений.
Однако по мере роста интереса к мультимодальным моделям растут и проблемы обеспечения их надёжности и точности. Как и LLMs, мультимодальные модели склонны к «галлюцинациям», когда они выдают неверные или нерелевантные результаты — особенно при одновременной обработке разных типов входных данных. Мультимодальная генерация с дополнением извлечением (RAG) устраняет эти ограничения, обогащая модели релевантной контекстной информацией из внешних источников.
На Unstructured Data Meetup, организованном Zilliz, Джош Рейни, Developer Advocate в TruEra (теперь приобретённой Snowflake), поделился своими наблюдениями о проблемах и решениях при работе с мультимодальными фреймворками. Джош подчеркнул, как можно смягчать галлюцинации ИИ с помощью инструментов с открытым исходным кодом, таких как Trulens, и как интеграция векторной базы данных Milvus может повысить производительность мультимодальных RAG-систем.
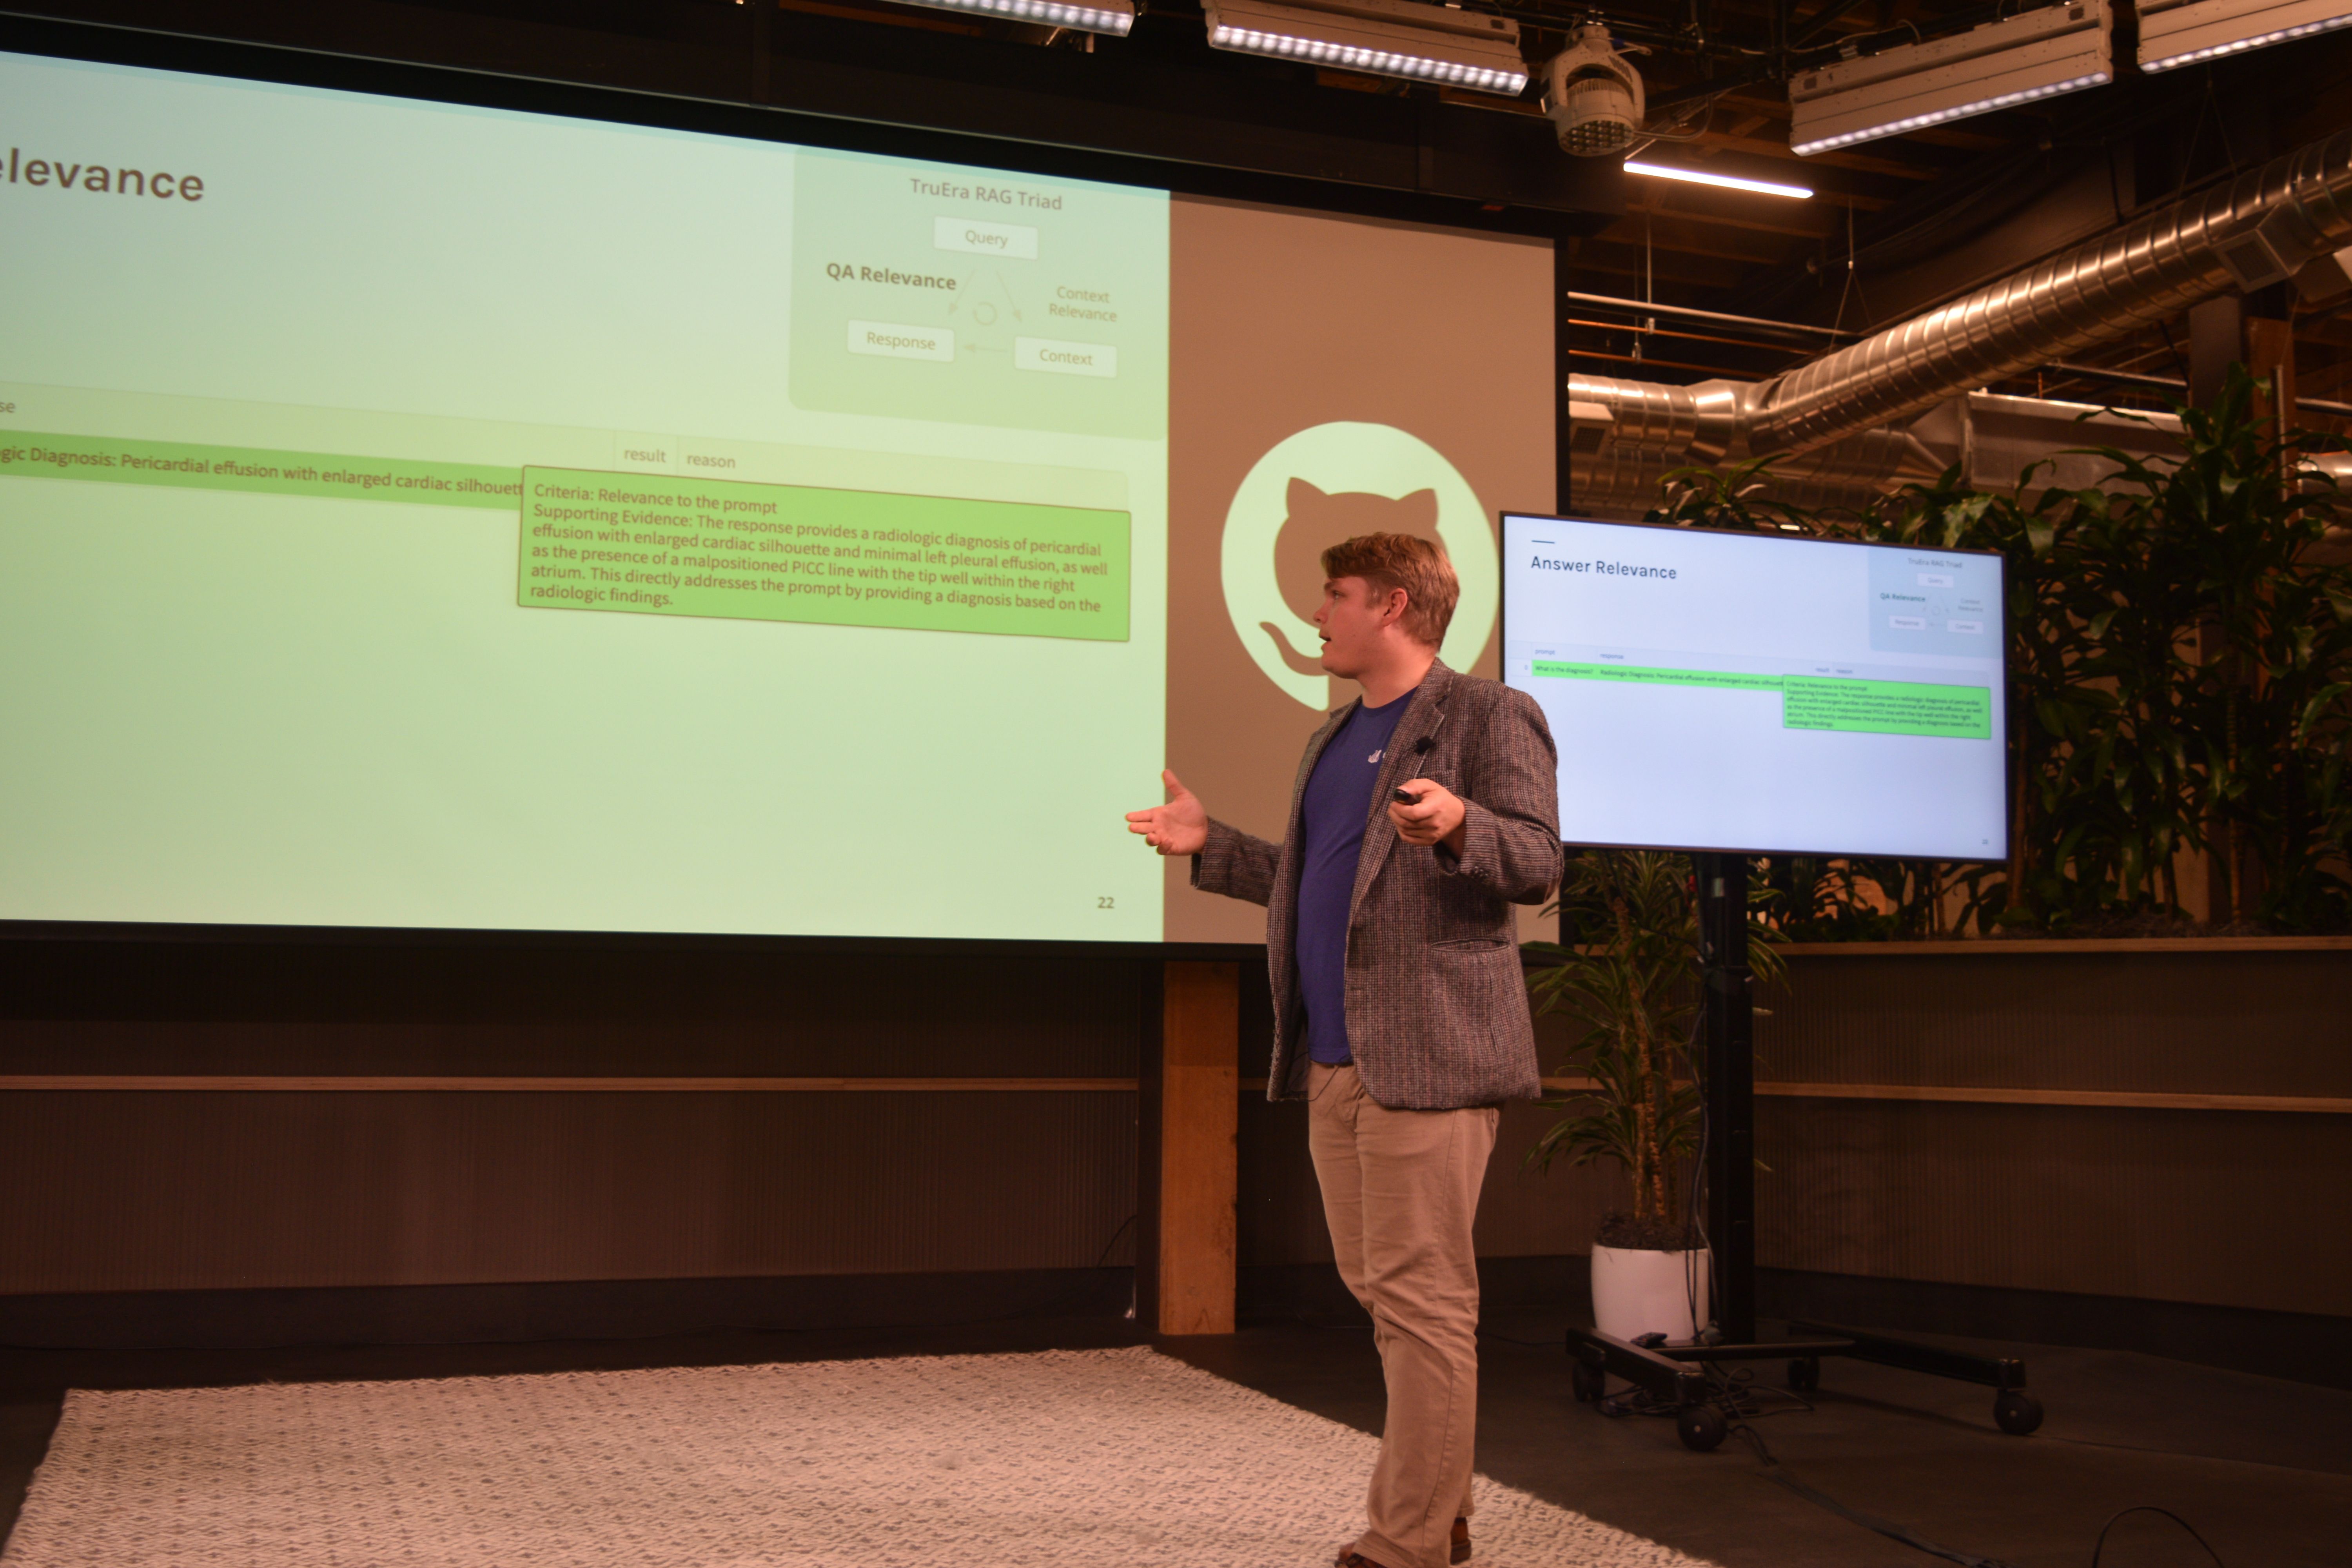 Джош Рейни выступает на ноябрьской встрече SF Unstructured Data Meetup
В этом блоге мы кратко изложим идеи Джоша и обсудим критически важную роль оценок (или "Evals") в улучшении мультимодальных RAG-систем, обеспечивая получение этими системами точных и релевантных результатов при работе со сложными данными. Вы также можете посмотреть полное выступление Джоша на YouTube, чтобы узнать больше.
Понимание мультимодальных моделей и MultiModal RAG
Мультимодальные модели — это модели машинного обучения, которые могут обрабатывать и интегрировать несколько типов данных или модальностей, таких как текст, изображения, аудио и видео. В отличие от традиционных языковых моделей, сосредоточенных на одном типе входных данных, мультимодальные модели объединяют информацию из различных источников, чтобы создавать более контекстуально точные результаты. Эта универсальность делает их особенно полезными в сценариях, где данные поступают в разных форматах. Например, мультимодальная модель может использовать изображение и текстовое описание, чтобы сгенерировать более точный ответ, чем модель, полагающаяся только на один тип входных данных.
Как и LLMs, мультимодальные модели оптимизированы для обобщения, что позволяет им реагировать на различные входные данные. Однако у этой оптимизации есть своя цена. Модели часто штрафуются за запоминание конкретных данных, что создаёт напряжение между гибкостью и точностью. Этот баланс становится сложным, когда задача включает перекрёстную проверку нескольких модальностей, например диагностику заболевания на основе текстовых симптомов и рентгеновских снимков.
Чтобы обеспечить эти модели общего назначения долговременной памятью, мы можем вынести конкретные «запомненные» знания во внешние ресурсы, например в векторное хранилище (например, Milvus). Этот метод известен как Multimodal RAG.
Системы Traditional RAG сосредоточены на извлечении релевантного текста для улучшения генеративного процесса LLMs, создавая более точные и персонализированные ответы. Multimodal RAG выходит за пределы текста, интегрируя дополнительные типы данных — изображения, аудио, видео и многое другое — в процесс извлечения и генерации с использованием мультимодальных моделей и векторных баз данных. Такой подход позволяет системам Multimodal RAG эффективнее выполнять задачи, требующие более глубокого понимания текстовых и нетекстовых входных данных.
Например, Multimodal RAG может извлекать релевантные изображения или видео в системах визуальных вопросов и ответов, чтобы генерировать более точные ответы. Аналогично, в задачах вроде создания подписей к изображениям или мультимодальных диалоговых систем способность объединять визуальные и текстовые данные гарантирует, что система предоставляет более контекстуально релевантные и точные результаты.
Используя взаимодополняющие преимущества мультимодальных моделей и продвинутых механизмов извлечения, Multimodal RAG предлагает мощное решение для обработки сложных данных разных форматов и генерации насыщенных, контекстно-ориентированных ответов в широком спектре приложений.
Как работает Multimodal RAG?
Теперь, когда мы представили концепцию Multimodal RAG, давайте рассмотрим, как работают эти системы. В качестве примера для иллюстрации процесса мы используем retrieval-augmented систему визуальных вопросов и ответов:
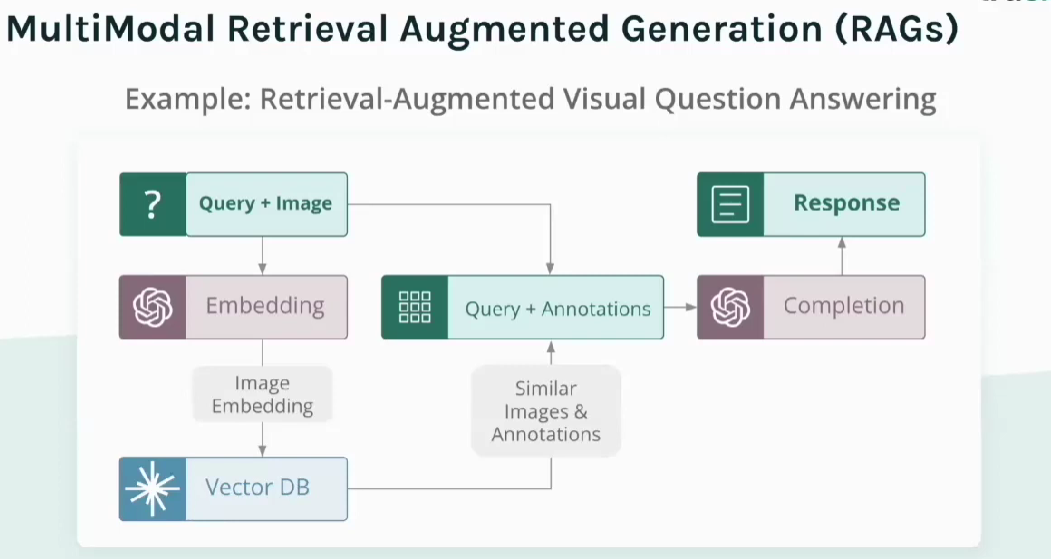 Рисунок — Как работает мультимодальная система RAG
Обработка мультимодального ввода: система RAG получает пользовательский запрос вместе с изображением.
Embedding: и изображение, и текстовый запрос преобразуются в векторные эмбеддинги с помощью мультимодальной embedding-модели. Эти эмбеддинги позволяют системе анализировать и сравнивать входные данные в разных модальностях (текст и изображение), делая ее способной понимать взаимосвязи между ними.
Извлечение из векторной базы данных: система использует эмбеддинги изображений для запроса к векторной базе данных, такой как Milvus или ее управляемая версия Zilliz Cloud, чтобы извлечь похожие изображения и связанные с ними аннотации или релевантные данные. Этот этап извлечения обогащает знания модели, предоставляя дополнительный контекст из реальных данных.
Completion: извлеченные данные (похожие изображения и их аннотации) объединяются с исходным входным запросом. Мультимодальная модель использует этот обогащенный контекст для генерации комплексного ответа или completion, который задействует как исходный ввод, так и извлеченную информацию.
Ответ: наконец, система генерирует точный ответ, интегрируя извлеченные внешние данные с исходным вводом. Это позволяет модели выдавать более контекстно-осведомленный, релевантный и точный ответ на запрос пользователя.
Благодаря включению внешних данных через извлечение системы Multimodal RAG выходят за пределы того, что модель знает внутренне, обеспечивая более точные и контекстуально релевантные результаты.
Необходимость систематических оценок
Несмотря на мощное сочетание мультимодальных моделей и систем извлечения, проблемы остаются. Хотя впечатляющие демо могут демонстрировать потенциал Multimodal RAG, превратить демо в надежное, готовое к промышленной эксплуатации приложение гораздо сложнее.
Ключ к преодолению этих вызовов — систематическая оценка. Такие оценки помогают выявлять слабые места, режимы отказа и области для улучшения в мультимодальных приложениях, позволяя разработчикам со временем дорабатывать и оптимизировать их. В области ИИ мы часто видим два типа команд:
Команды, которые создают впечатляющие прототипы, работающие примерно в 80% случаев.
Команды, которые успешно разворачивают эти системы в production, что является гораздо более сложной и требовательной задачей.
Для второй группы — тех, кто ориентирован на production, — систематическая итерация и оценка крайне важны, особенно в таких областях, как образование (тьюторы на основе LLM), клиентская поддержка (суммаризация расшифровок) и финансовые услуги (внутренние или клиентские чатботы), где надежность и точность имеют критическое значение.
Именно здесь инструменты оценки, часто называемые Evals, становятся незаменимыми. Инструменты оценки позволяют разработчикам отслеживать производительность, тестировать надежность и выявлять области для улучшения по мере итеративного движения к решению production-уровня. Популярные инструменты оценки включают Trulens, Ragas, LangFuse, OpenAI Evals, DeepEval, Phoenix и LangSmith.
В следующих разделах мы используем TruLens, инструмент оценки с открытым исходным кодом, в качестве примера, чтобы продемонстрировать, как систематические оценки могут применяться к мультимодальным RAG-системам.
Как TruLens помогает в оценке мультимодального RAG
Trulens — это инструмент с открытым исходным кодом для оценки больших языковых моделей (LLM) и мультимодальных RAG-приложений. Его сильная сторона заключается в способности мониторить, тестировать и отлаживать приложения, что делает его особенно полезным для выявления областей для улучшения и обеспечения надежности приложения.
После того как разработчики подключают свое приложение к TruLens, они могут журналировать записи и определять функции оценки, которые систематически оценивают производительность модели. Эти оценки крайне важны для обнаружения галлюцинаций, которые могут приводить к неточным или нерелевантным ответам, особенно в сложных мультимодальных RAG-системах.
В типичной RAG-системе необходимо оценивать три ключевых компонента:
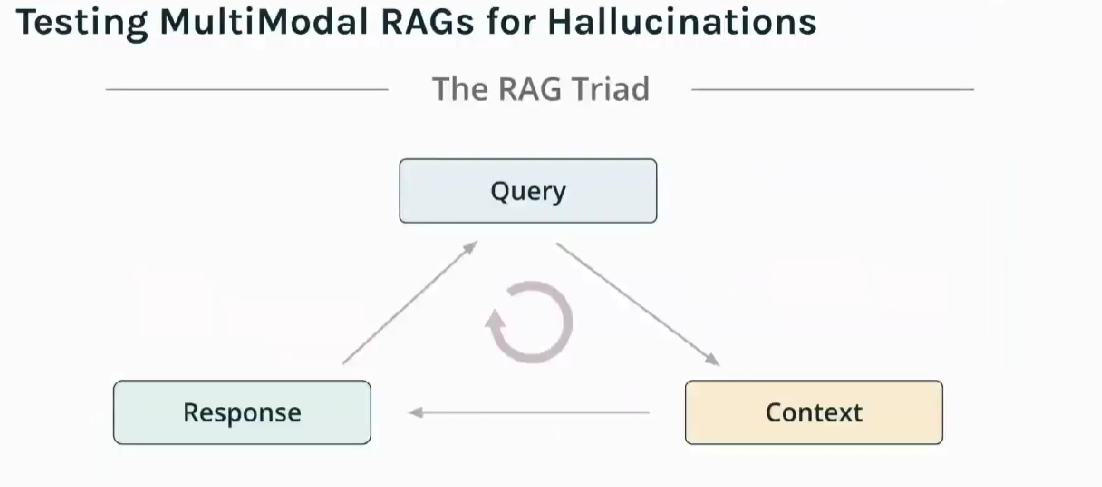 Рисунок — три столпа RAG (триада RAG)
Запрос: Пользователь отправляет запрос, который может быть в форме текста или сочетания текста и изображений.
Контекст: Система извлекает релевантную информацию, такую как изображения и текст, из векторной базы данных, чтобы предоставить контекст для модели.
Ответ: LLM или мультимодальная модель генерирует ответ на основе извлеченного контекста и исходного запроса.
Чтобы модель оставалась точной и надежной, оценки выполняются на каждом этапе для обнаружения галлюцинаций и анализа того, насколько хорошо работает система. Это часто называют триадой RAG, как показано на сопроводительной диаграмме.
Существует три критически важных типа оценок, позволяющих убедиться, что вывод системы заслуживает доверия:
Релевантность контекста: Проверяет, насколько тесно извлеченная информация (текст или изображения) соответствует исходному запросу. Является ли извлеченный контекст релевантным и полезным для рассматриваемого запроса?
Обоснованность: Обоснованность оценивает, поддерживает ли извлеченный контекст сгенерированный ответ. Опирается ли ответ на извлеченную информацию или генерирует неподтвержденные либо неверные данные?
Релевантность ответа: Измеряет полезность и точность ответа модели. Является ли ответ осмысленным и релевантным вопросу пользователя?
Интегрируя TruLens, разработчики могут непрерывно отслеживать и улучшать производительность своих мультимодальных RAG-систем, обеспечивая точность модели, ее опору на доказательства и контекстуальную релевантность при минимизации галлюцинаций.
Пошаговое руководство по внедрению и оценке RAG с помощью Trulens читайте в этом руководстве: Evaluations for Retrieval Augmented Generation: TruLens + Milvus.
Пример из реального мира: оценка RAG-системы визуальных вопросов и ответов
Чтобы лучше это понять, рассмотрим пример RAG-системы визуальных вопросов и ответов. В этой системе пользователь предоставляет как запрос, так и изображение. Модель генерирует embedding на основе изображения и ищет в векторной базе данных похожие изображения, которые затем сопоставляются с аннотациями для генерации итогового ответа.
На каждом этапе мы должны оценивать, релевантны ли извлеченные изображения исходному запросу, опирается ли ответ LLM на предоставленный контекст и релевантен ли итоговый ответ исходному вопросу. Если система извлекает нерелевантные изображения или генерирует неверные диагнозы, оценки помогут нам определить режим отказа и улучшить модель.
Одна команда, X-ray Insight, создала приложение во время хакатона, которое демонстрирует эти оценки в действии. Они собрали X-ray-изображения и аннотации (диагнозы), преобразовали изображения в image embeddings, загрузили эти embeddings вместе с метаданными (диагнозами) в векторную базу данных Milvus/Zilliz и использовали предоставленное пользователем изображение (которое также было преобразовано в embeddings), чтобы извлекать похожие случаи. Метаданные (например, диагнозы), связанные с этими изображениями, использовались для генерации итогового диагноза с помощью мультимодальной модели.
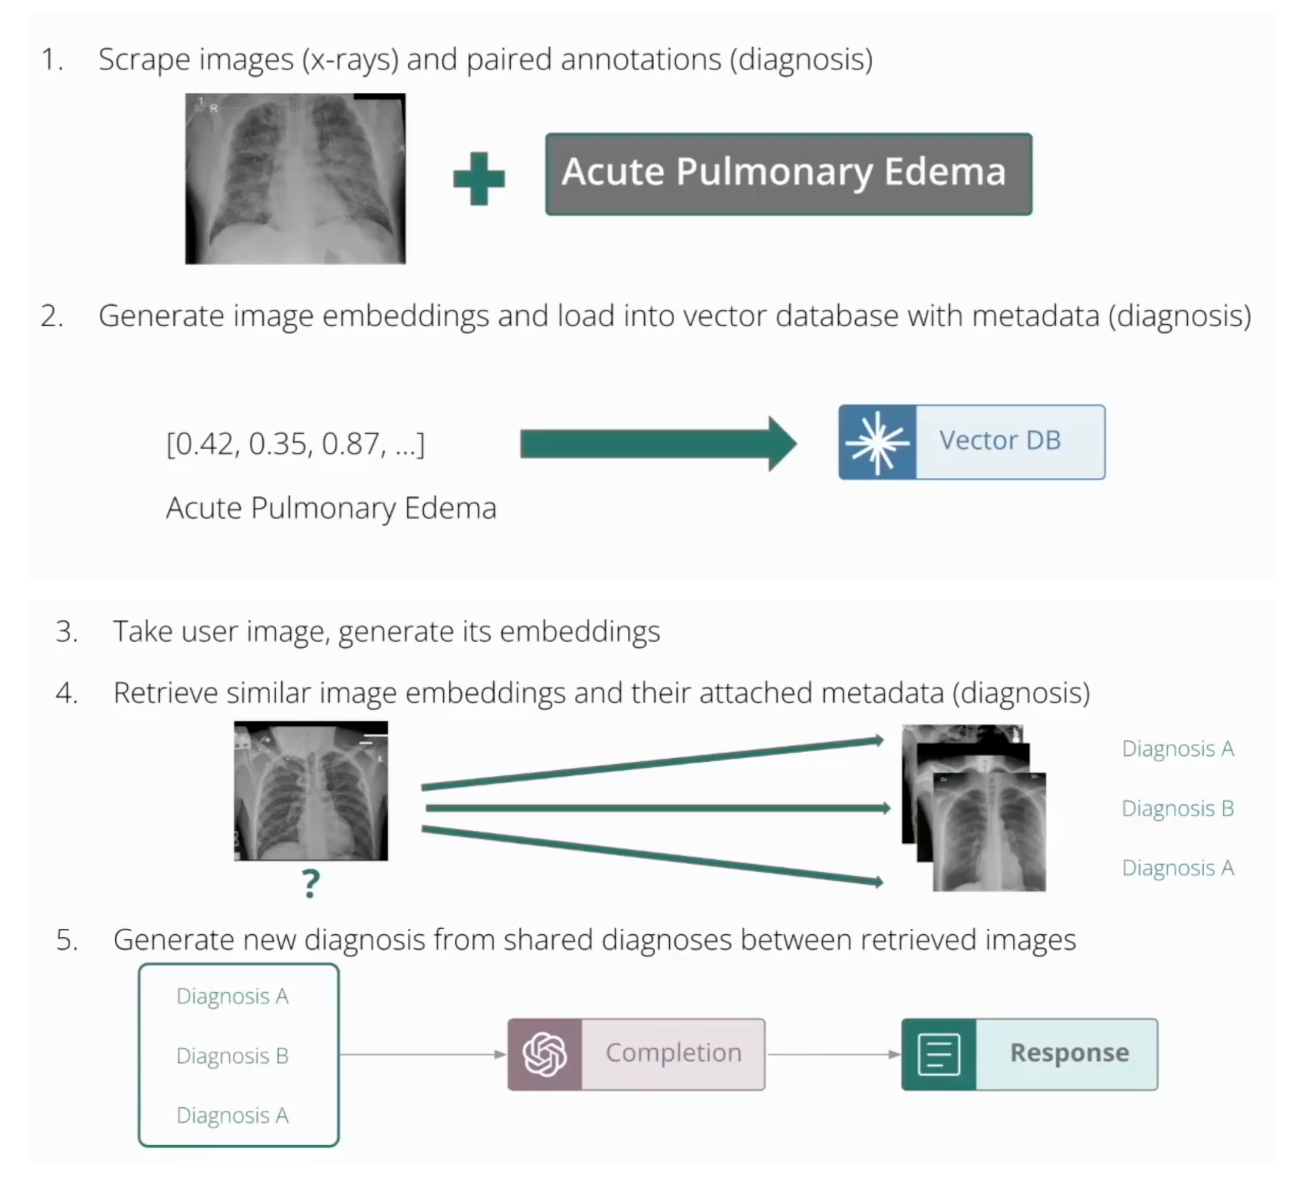 Рисунок: как работает система X-ray Insight
Используя TruLens, команда X-ray Insight смогла оценить производительность своей модели на нескольких этапах:
Генерация embeddings: предварительная обработка изображения, вычисление embedding (процесс, требующий значительного времени) и обеспечение качества embedding.
Извлечение случаев: поиск релевантных случаев в векторной базе данных на основе вычисленных embeddings.
Итоговый диагноз: генерация диагноза на основе заметок пациента и сравнение его с извлеченными данными.
После внедрения этих оценок TruLens позволяет команде анализировать общие признаки между диагнозами, выявлять режимы отказа и улучшать систему на основе полученных инсайтов.
Заключение
В целом, развертывание мультимодальных моделей и RAG-систем в продакшене требует большего, чем создание эффектного прототипа. Систематическая итерация через оценки, такие как релевантность контекста, groundedness и релевантность ответа, необходима для обеспечения надежности и точности этих моделей. Такие инструменты, как TruLens, предоставляют framework для отслеживания, тестирования и отладки этих приложений, помогая разработчикам совершенствовать свои модели и избегать hallucinations.
По мере того как мы продолжаем расширять границы возможностей мультимодальных моделей, оценки останутся краеугольным камнем процесса разработки. Они будут обеспечивать генерацию этими моделями вывода обоснованным и релевантным образом.
Дополнительные ресурсы

Читать далее
Notion's Vector Search Is Excellent. Their Next Problem Is Harder.
Notion solved vector search scaling in two years. The next bottleneck — offline context engineering, unified data, and the real-time/offline gap — is harder.
Smarter Autoscaling in Zilliz Cloud: Always Optimized for Every Workload
With the latest upgrade, Zilliz Cloud introduces smarter autoscaling—a fully automated, more streamlined, elastic resource management system.

How to Build an Enterprise-Ready RAG Pipeline on AWS with Bedrock, Zilliz Cloud, and LangChain
Build production-ready enterprise RAG with AWS Bedrock, Nova models, Zilliz Cloud, and LangChain. Complete tutorial with deployable code.