




ImageNetとは何か、そしてなぜコンピュータビジョンにとって重要なのか

ImageNetとは何か、そしてなぜコンピュータビジョンにとって重要なのか
研究論文用の画像を作成するために高度な生成AIツールを使用したり、サンフランシスコの自動運転タクシーに乗ったりするとき、これらの技術の進歩が、綿密にキュレーションされたデータセットであるImageNetのおかげであることに気づかないかもしれません。
ImageNetは、視覚的物体認識の研究を促進するために設計された、大規模で一般公開されている画像データベースです。1,400万枚を超える画像で構成されており、それぞれにWordNetの同義語セットに基づくラベルが注釈付けされています。これらの詳細な注釈は、画像の正確な識別と分類を保証するために重要であり、ImageNetをさまざまなコンピュータビジョンタスクにおけるディープラーニングモデルの訓練と評価のための貴重なリソースにしています。
ImageNetはカタログ化している画像を所有しているわけではありませんが、URLとサムネイルを提供し、研究目的でこれらの画像にアクセスしやすくしています。この広範でよく整理されたデータセットは、より精密で効果的な視覚認識システムの開発における基本的なツールとなっており、コンピュータビジョンの進歩に大きく貢献しています。
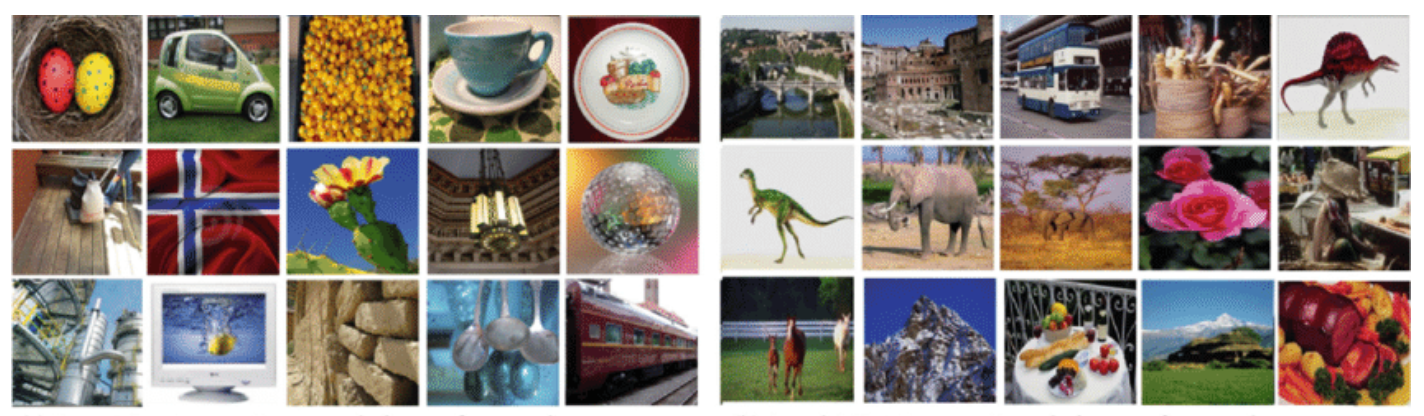 15枚の画像サンプル(各カテゴリから1枚の画像)を含むImageNet Synsets。b 10カテゴリから15枚のサンプル画像を示すCorel-1000データセット。
ImageNetとは何か?
ImageNetは、さまざまなコンピュータビジョンタスクを支援するために綿密に開発された、包括的で一般公開されている大規模画像データベースです。AI研究者のFei-Fei Liによって開始され、1,400万枚を超える画像を含み、それぞれがWordNet階層の検証ラベルに従って注釈付けされています。この構造化されたラベリングシステムは、物体を正確に識別するために不可欠であり、ImageNetを高度な視覚認識アルゴリズムを訓練するための基盤的リソースにしています。
このデータセットは、注釈付けプロセスにクラウドソーシングを採用しています。画像レベルの注釈は、ある物体クラスが存在するか存在しないかを示し、物体レベルの注釈は、物体の可視部分の周囲にバウンディングボックスを提供します。ImageNetは分類にWordNetスキーマの変種を利用しており、細粒度分類のために犬種の120カテゴリを含んでいます。2012年までに、ImageNetはMechanical Turkの最大の学術利用者となり、作業者は平均して1分あたり50枚の画像を識別していました。
基本的なラベルに加えて、100万枚を超える画像には詳細なバウンディングボックスが含まれており、物体を正確に識別し位置特定できるアルゴリズムの開発におけるデータセットの有用性を高めています。導入以来、ImageNetは画像分類と物体検出を大きく前進させ、自動運転車、医用画像、セキュリティシステムなどの産業における学術研究と実用的応用に影響を与えてきました。ImageNetは、視覚認識技術を評価するための重要なベンチマークであり続けています。
画像訓練データセットの必要性
画像分類アルゴリズムのトレーニングは非常に重要なタスクであり、大規模で適切にキュレーションされた画像データセットへのアクセスを必要とします。これらのデータセットは、アルゴリズムが実世界のアプリケーションで遭遇するデータの種類を綿密に模倣している必要があり、アルゴリズムの成功において重要な役割を果たします。アルゴリズムが認識し分類することを期待されるさまざまなカテゴリを表す、多様な画像を含んでいなければなりません。教師あり学習では、ラベル付きデータセットが不可欠です。各画像には、アルゴリズムがデータから学習するために必要な指針を提供する特定のラベルが付与されているためです。これらのラベルには、画像内に存在するオブジェクト、その位置、さらにはシーン内の他のオブジェクトとの関係に関する情報が含まれる場合があります。通常、データセットはトレーニングセットとテストセットという2つの主要なサブセットに分割されます。通常、データセット全体の約70%を占めるトレーニングデータセットは、アルゴリズムにパターンの認識方法と予測の行い方を教えるために使用されます。残りの30%のデータセットはテスト用に確保され、研究者がこれまで見たことのない画像に対するアルゴリズムの性能を評価できるようにします。このプロセスにより、アルゴリズムが新しいデータにうまく汎化し、実世界のシナリオで正確に機能することが保証されます。
アルゴリズムのトレーニングでの使用に加えて、画像データセットは、さまざまなコンピュータビジョンアルゴリズムを評価および比較するためのベンチマークとしての役割も果たします。研究者は、同じデータセットにさまざまなアルゴリズムを適用することで、画像分類、物体検出、画像セグメンテーションなどのタスクにおける性能を客観的に評価できます。このベンチマーキングプロセスは、さまざまなアプローチの強みと弱みを明らかにし、アルゴリズム設計の革新を促進するため、この分野の発展に不可欠です。たとえば医用画像処理では、CT画像やMRI画像などのスキャン画像から疾患を検出するアルゴリズムを評価するためにベンチマークデータセットが使用され、これらのアルゴリズムが臨床使用に求められる高い基準を満たすことを保証します。同様に、自動運転車では、歩行者、他の車両、交通標識などのオブジェクトを認識して対応するシステムのトレーニングとテストに画像データセットが使用され、より安全で信頼性の高い自動運転技術の開発に貢献しています。
ImageNetデータセットのダウンロードと前処理
ImageNetデータセットのダウンロードは、多大なディスク容量を必要とし、完了までに数日かかる場合がある、リソース集約型のプロセスです。データセットのサイズと複雑さを考慮すると、ダウンロードと展開を効率的に処理するために、十分な追加ストレージを備えた高性能なインスタンスを使用することが推奨されます。
プロセスを開始するには、ImageNetのWebサイトに登録し、利用規約に同意する必要があります。登録が完了すると、ダウンロードリンクにアクセスできます。ただし、データセットは複数の大きなファイルに分割されているため、そのサイズを考えると、標準的な「名前を付けて保存」方法では不十分です。代わりに、専用のダウンロードスクリプトが必要です。TensorFlowはそのリポジトリでこのようなスクリプトを提供しており、データセットファイルのダウンロードと整理を自動化することでプロセスを簡素化します。このスクリプトにより、データセットのすべての部分が正しくダウンロードされ、整理された方法で保存され、さらなる処理やモデルのトレーニングで使用できる状態になります。
深層畳み込みニューラルネットワークによる画像分類
画像分類はコンピュータビジョンの基礎的な技術であり、写真や動画内の主要なオブジェクトを識別し、分類することを可能にします。このプロセスは、画像を分析し、画像認識タスクを正確に実行するよう設計されたAIベースの深層学習モデルに大きく依存しています。
深層畳み込みニューラルネットワーク(CNN)は、現代の画像分類の基盤です。物体の外観、照明、背景の変化によってもたらされる課題にもかかわらず、物体認識の複雑さを扱うことに優れています。ImageNetのような大規模データセットでさえ豊富な訓練データを提供しますが、視覚データの多様性が非常に大きいため、画像分類の問題は本質的に複雑なままです。
しかし、CNNは画像の性質について正確な仮定を置くため、このタスクに特に適しています。統計の定常性とピクセル依存性の局所性という原則に基づいて動作し、画像内の空間的階層や局所パターンを効果的に捉えます。この能力により、CNNはさまざまな種類の画像に対して良好に汎化でき、さまざまな用途における画像分類の強力なツールとなっています。
コンピュータビジョンにおけるImageNetの応用
ImageNetデータセットは、画像分類、物体検出、画像処理、物体位置特定など、さまざまなCVタスクにわたる機械学習モデルの開発とテストのためのリソースです。注釈付き画像の膨大で多様なコレクションは、画像内の物体を正確に認識し分類できるモデルの訓練に重要な役割を果たします。
ResNet、AlexNet、VGGなど、いくつかの画期的なディープラーニングアーキテクチャは、その成功の一部をImageNetデータセットを用いて行われた広範なベンチマークと開発に負っています。画像分類に新たな標準を打ち立てたこれらのモデルはImageNetで訓練され、その後、顔認識から自動運転車に至るまで、数多くのCVアプリケーションの基盤となりました。
ImageNetの影響は、ディープラーニングの初期をはるかに超えて広がっており、CV分野を形作り続けています。その影響は画像理解と分類タスクの進化に明らかであり、新しいモデルやアルゴリズムの性能を評価するための主要なデータセットであり続けています。現代のAI研究と応用が進歩し続ける中で、コンピュータビジョン研究の礎としてのImageNetの遺産は存続し、イノベーションを推進し、視覚認識システムの精度と有効性を向上させています。
ImageNetを扱うためのベストプラクティス
ImageNetデータセットを扱う際には、効率性とデータセキュリティを確保するためにベストプラクティスに従うことが不可欠です。重要なステップの1つは、潜在的なデータ損失を防ぐためにデータセットをバックアップすることです。これはAWSを使用してデータセットをAmazon S3に保存することで容易に実現でき、信頼性と拡張性のあるバックアップソリューションを提供します。
データセットを新しいインスタンスにデプロイすることは簡単で、さまざまなインスタンス上での訓練とテストの環境構築を容易にします。大規模プロジェクトでは、スクリプト作成とスケーリング技術を使用してデータセットを複数のインスタンスにデプロイし、並列処理とより高速なモデル訓練を可能にできます。
結論
ImageNetはコンピュータビジョンにとって重要なリソースであり、WordNet階層を使用して注釈付けされた1,400万枚以上の画像の大規模コレクションを提供しています。Fei-Fei Liと彼女のチームによって作成されたこのデータセットには、画像レベルと物体レベルの両方の注釈が含まれており、ディープラーニングモデルの訓練とテストに不可欠です。詳細な注釈は、画像内の画像認識と位置特定の向上に役立ちます。
ImageNetの影響は研究の枠を超えて広がっています。自動運転車や医療画像などの実用的な応用で広く使用され、視覚認識技術の評価と強化に役立っています。多様で適切に構造化されたデータセットを提供することで、ImageNetはCVシステムの精度と有効性を向上させるための重要なツールであり続けています。
参考文献
Deng, J., Dong, W., Socher, R., Li-Jia, L., Li, K., & Fei-Fei, L. (2009). ImageNet: 大規模階層型画像データベース. IEEE Conference on Computer Vision and Pattern Recognition (CVPR).
Fellbaum, Christiane. "WordNetとWordnets." Keith Brownほか編『Encyclopedia of Language and Linguistics』第2版、665-670。Oxford: Elsevier, 2005. https://wordnet.princeton.edu/.