GLUEベンチマーク:汎用言語理解評価ガイド
GLUEベンチマーク:汎用言語理解評価ガイド
DL; DR
GLUE(General Language Understanding Evaluation)ベンチマークは、幅広い言語理解の課題におけるモデルの性能を評価するために設計された、9つの自然言語処理(NLP)タスクの集合です。これらのタスクには、テキスト含意、感情分析、文の類似性などが含まれます。これは、NLPモデルがテキストを理解し処理する能力を比較するための標準的なベンチマークとして機能します。GLUEは標準化された評価指標を備えた統一的なフレームワークを提供し、汎用言語モデルの進歩と評価における重要なリソースとなっています。
 GLUE Benchmark for LLMs.png
はじめに
機械が人間の言語を理解するとは、本当のところ何を意味するのでしょうか?AIアシスタントに複雑な記事を要約させたり、ツイートの皮肉を検出させたり、微妙なニュアンスを含む質問に答えさせたりする場面を想像してみてください。その成功をどのように測定すればよいのでしょうか?この課題は、自然言語処理(NLP)モデルの評価の中心にあります。
GLUEベンチマークは、音声認識、質問応答、テキスト要約など、多様で不可欠な自然言語タスクを処理するモデルの能力を評価するためのゴールドスタンダードです。AIモデルがどの程度うまく機能するかを評価し、苦手とする領域を特定します。GLUEは、主要な言語タスクを単一のセットにまとめることで、より強力で汎用性の高いNLPモデルの構築を支援し、言語技術の進歩を促進します。
このガイドでは、GLUEベンチマークと、NLPモデルの評価におけるその役割について理解できるようにします。
GLUEベンチマークとは?
General Language Understanding Evaluation(GLUE)ベンチマークは、さまざまな自然言語理解(NLU)タスクにわたってNLPモデルの性能を評価するための広範なリソース群です。感情分析、テキスト含意、言い換え生成など、さまざまな言語タスクにおいてモデルを体系的に評価します。
GLUEの主な目的は、多様な言語クエリを処理できる強力なモデルの開発を促進することです。またGLUEは、研究者が自らのNLPモデルを広く受け入れられている確立済みの標準と比較してベンチマークし、その強みと弱みを特定するための体系的なフレームワークも提供します。
GLUEは、スタイル、データ量、複雑さの多様なセットをカバーする9つの異なるタスクで構成されており、以下が含まれます。
単一文タスク: これらのタスクには、感情分析と言語的許容性が含まれます。たとえば、Corpus of Linguistic Acceptability(CoLA)は文の文法的許容性をテストし、Stanford Sentiment Treebank(SST-2)は映画レビューの感情を判定することに焦点を当てています。
類似性と言い換えタスク: これらのタスクでは、2つの文がどの程度似ているか、またはそれらが言い換えであるかどうかを評価します。代表的なデータセットには、Microsoft Research Paraphrase Corpus(MRPC)とSemantic Textual Similarity Benchmark(STS-B)があります。
推論タスク: これらのタスクでは、ある文が別の文から論理的に導かれるかどうかを判定します。たとえば、Multi-Genre Natural Language Inference(MNLI)データセットは、さまざまなドメインにわたって、仮説が前提から導かれるかどうかを評価します。
GLUEベンチマークは、構文、意味論、論理推論など、多くの言語的側面をテストします。難易度やデータ規模が異なるタスクを統合することで、GLUEはモデルに対し、1つのタスクやドメインだけに特化するのではなく、言語の一般的な理解を獲得するよう求めます。
GLUEの主な特徴
タスクの多様性: GLUEには、文の許容性、感情、言い換え、テキスト含意を理解することをモデルに求めるタスクが含まれており、NLU能力を総合的に評価できます。
標準化されたベンチマーク: GLUEは参照基準となり、研究者が異なるモデルを比較しやすくします。
マルチタスク・フォーカス: さまざまなタスク間で言語知識を共有するモデルを促進し、汎用性の高いNLPシステムの開発を後押しします。
診断スイート: GLUEには診断用テストセットも含まれており、研究者が論理的推論や常識理解など、さまざまなタスクへの対応におけるモデルの強みと弱みを把握できるようにします。
GLUEベンチマークはどのように機能するのか?
GLUEベンチマークの運用は、NLPモデルをさまざまなタスクでテストすることに基づいており、それぞれのタスクは言語理解の特定の側面を対象としています。こうしたタスクには、単一文分類、文ペア分類、テキスト関係を含む回帰タスクが含まれます。GLUEは、モデルが言語やタスクをまたいでどれだけ効果的に汎化できるかを評価するために、標準化されたタスクと指標を定義しています。
以下で説明するGLUEの指標は、モデルが望ましい性能基準をどれだけ満たしているかを評価するための重要な指標です。
GLUEで使用される指標
GLUEは、タスクに応じてモデル性能を評価するためにさまざまな指標を使用します。
正解率: MNLI、QNLI、および分類判断を必要とするその他のタスクで使用されます。
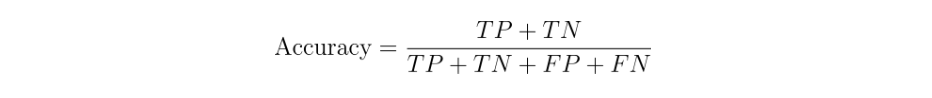 1.png
正解率は、すべての予測(陽性と陰性の両方)のうち、モデルが正しく分類した割合です。全体的な性能を測るわかりやすい尺度を提供します。
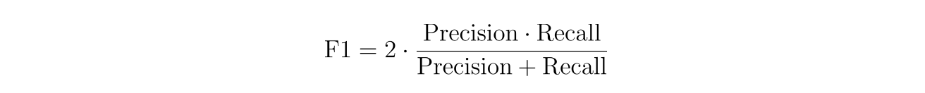
F1スコア: MRPCのようなクラス不均衡のあるタスクで使用され、適合率と再現率のバランスの取れた評価を提供します。F1スコアは適合率と再現率の調和平均であり、モデルを評価する際に偽陽性と偽陰性が考慮されるようにします。
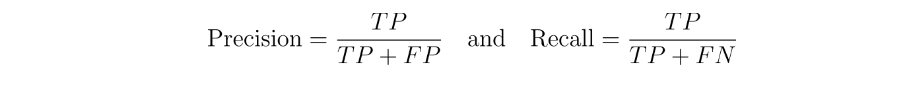 2.png
 3.png
F1スコアは適合率と再現率の調和平均であり、両方の指標のバランスを取った単一の尺度を提供します。適合率は、予測されたすべてのインスタンスのうち、実際に陽性である割合です。再現率は、すべての陽性インスタンスのうち、モデルが正しく識別した割合です。
相関係数: STS-Bのような回帰タスクでは、PearsonやSpearman correlationなどの指標が、予測スコアと実際のスコアの類似性を測定します。
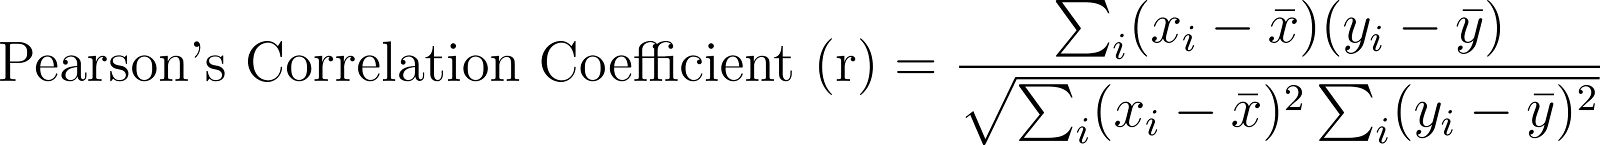 4.png
相関係数は、モデルの予測が真の値に連続的にどれだけ近く一致するかを測定します。これは、モデルが基礎となる関係をどれだけうまく捉えているかを示します。
Matthews相関係数: CoLAで特に使用されるこの指標は、特に不均衡なデータセットにおける二値分類の品質を評価します。Matthews相関係数は、真陽性・偽陽性・真陰性・偽陰性を考慮することで包括的な評価を提供し、クラス分布が不均一なデータセットでモデルを評価するのに適しています。
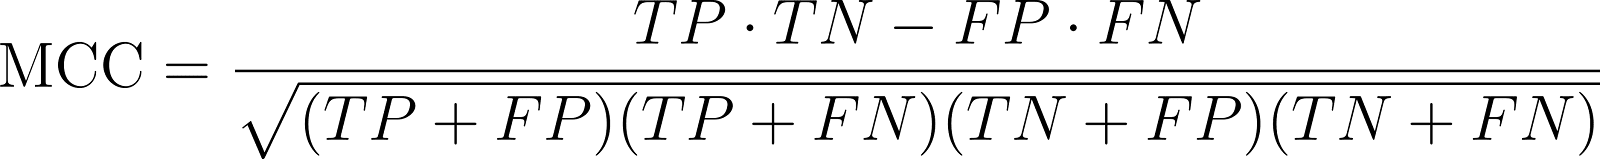 5.png
MCCは、真陽性・偽陽性・真陰性・偽陰性を考慮して二値分類性能をバランスよく評価し、特に不均衡なデータセットで有用です。
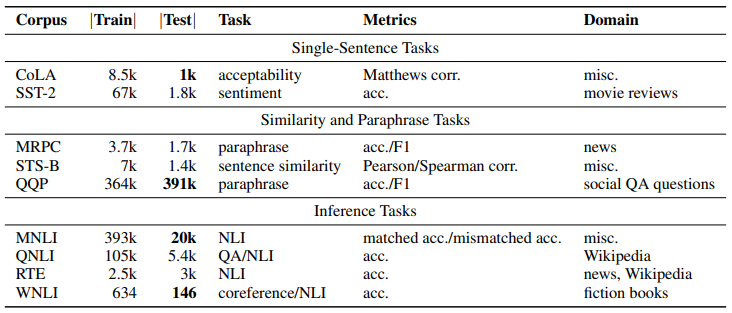 Summary of GLUE benchmark datasets, tasks, metrics, and domains..png
GLUEベンチマークのデータセット、タスク、指標、ドメインの概要。
この表は、GLUEデータセットを単一文、類似性/言い換え、推論タスクに分類し、例の数、タスクタイプ、指標、ドメインを示しています。自然言語理解モデルを評価するためのタスクの多様性を強調しています。
GLUEタスクの詳細概要
GLUEベンチマークは9つのタスクで構成されており、それぞれが単一文または文ペアの分類タスクです。以下では、9つの各タスクについて簡単に説明します。
1. CoLA (Corpus of Linguistic Acceptability)
CoLA は、与えられた文が文法的に許容可能かどうかをテストします。このタスクは、モデルが統語的な正しさを理解する能力を評価します。
| 入力 | 出力 | 評価指標 |
|---|---|---|
| 単一の文 | 許容可能または許容不可 | Matthews相関係数 |
例:
入力: "She running quickly."
出力: 許容不可
2. SST-2 (Stanford Sentiment Treebank)
SST-2 は、映画レビューの感情分析に焦点を当て、感情がポジティブかネガティブかを判定します。
| 入力 | 出力 | 評価指標 |
|---|---|---|
| 単一の文 | ポジティブまたはネガティブ | 正解率 |
例:
入力: "The movie was breathtaking and captivating."
出力: ポジティブ
3. MRPC (Microsoft Research Paraphrase Corpus)
MRPC は文のペアを扱い、モデルがそれらが意味的に同等かどうかを判定します。
| 入力 | 出力 | 評価指標 |
|---|---|---|
| 文ペア | 言い換えまたは言い換えでない | F1スコア |
例:
入力: "The car is fast." and "The vehicle moves quickly."
出力: 言い換え
4. MNLI (Multi-Genre Natural Language Inference)
前提と仮説が与えられ、このタスクは仮説が前提に基づいて真、偽、または未確定かを判定します。MNLI には、一致(ドメイン内)セクションと不一致(クロスドメイン)セクションの両方が含まれます。
| 入力 | 出力 | 評価指標 |
|---|---|---|
| 前提と仮説 | 含意、矛盾、または中立 | 正解率 |
例:
入力: Premise: "The cat is sleeping on the mat." Hypothesis: "The mat is occupied."
出力: 含意
5. STS-B (Semantic Textual Similarity Benchmark)
STS-B は、2つの文がどれほど類似しているかを、0から5までのスコアを用いて評価します。スコアが高いほど類似性が高いことを示します。
| 入力 | 出力 | 評価指標 |
|---|---|---|
| 文ペア | 類似度スコア (0-5) | PearsonおよびSpearman相関 |
例:
入力: "A boy is playing in the park." and "A child is playing outside."
出力: 4.5 (高い類似性)
6. QNLI (Question Natural Language Inference)
QNLI は、修正版のStanford Question Answering Dataset (SQuAD) です。このタスクは、与えられた文が質問に対する正しい答えを含んでいるかどうかを判定します。
| 入力 | 出力 | 評価指標 |
|---|---|---|
| 質問と文 | 回答可能または回答不可 | 正解率 |
例:
入力: Question: "Where do penguins live?" Sentence: "Penguins live in Antarctica."
出力: 回答可能
7. RTE (Recognizing Textual Entailment)
RTE は、複数のテキスト含意チャレンジのデータを組み合わせ、与えられた仮説がテキストから論理的に推論できるかどうかを判定します。
| 入力 | 出力 | 指標 |
|---|---|---|
| 前提と仮説 | 含意または非含意 | 正解率 |
例:
入力: 前提: "彼女はペットの猫を飼っている。" 仮説: "彼女は動物を飼っている。"
出力: 含意
8. WNLI (Winograd Schema NLI)
WNLI は、曖昧な代名詞の先行詞をモデルが判断する必要がある読解タスクです。
| 入力 | 出力 | 指標 |
|---|---|---|
| 曖昧な代名詞を含む文 | 正しい先行詞 | 正解率 |
例:
入力: "トロフィーはスーツケースに入らなかった。なぜなら、それが大きすぎたからだ。" ("それ" は何を指しますか?)
出力: トロフィー
9. QQP (Quora Question Pairs)
QQP は、Quora で尋ねられた2つの質問が同じ意図を持つかどうかを判断することを含みます。
| 入力 | 出力 | 指標 |
|---|---|---|
| 質問ペア | 重複または非重複 | F1スコア |
例:
入力: "Pythonを学ぶにはどうすればよいですか?" と "Pythonプログラミングを学ぶ最良の方法は何ですか?"
出力: 重複
実装例
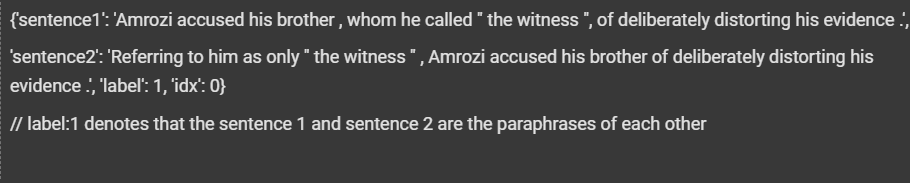
一般的なフレームワークを使用して GLUE タスクを読み込む方法の例を以下に示します:
from datasets import load_dataset

dataset = load_dataset("glue", "mrpc")
print(dataset["train"][0])
このスニペットは、HuggingFace Datasets ライブラリを使用して GLUE から MRPC データセットを読み込み、開発者がこれらのタスクで簡単に実験を開始できるようにします。HuggingFace により、実務者はモデルのトレーニング、評価、ファインチューニングのために GLUE データセットへ迅速にアクセスして活用することが容易になりました。
実装例の出力
比較: GLUE vs. SQuAD
GLUE ベンチマークは、SQuAD のような古いベンチマークと比較して、NLP モデルを評価するためのより包括的なアプローチを提供します。以下の比較は、その違いを示し、GLUE が以前の制限をどのように改善し、モデルの一般的な能力をよりよく理解できるようにするかを示しています。
多様性と範囲
SQuAD: 質問応答タスクに狭く焦点を当てており、モデルが情報を取得して理解する能力について貴重な洞察を提供しましたが、より広範な言語能力を評価することはできませんでした。
GLUE: 感情分析、言い換え、言語的容認性など、さまざまな言語理解スキルでモデルをテストするための多様なタスクが含まれています。この多様性は、現実世界のマルチタスク用途に向けてモデルを評価するうえでの GLUE の強みを示しています。
転移学習の促進
SQuAD: SQuAD は質問応答タスクのみに焦点を当てており、モデルが他のタスクに適用できるスキルを学習することを促さないため、知識を効果的に転移する能力が制限されます。
GLUE: 限られたトレーニングデータを持つ多様なタスクを提供することで転移学習を支援し、モデルがタスク間で知識を共有できるようにします。このアプローチは、複数のタスクで高い性能を発揮する BERT や GPT のような事前学習済みモデルとうまく機能します。
堅牢なモデル開発の促進
SQuAD: SQuAD 向けに最適化されたモデルは、QA データセットの特定のパターンに過剰適合することが多く、未知のタスクやデータセットでの性能が制限されます。
GLUE: さまざまなタスクとデータセットを含んでおり、モデルがより広範な言語スキルを身につけ、現実世界の状況でより良く機能するのに役立ちます。
現実世界での適用可能性
SQuAD: QA システムの評価には優れていますが、実用的で多機能なユースケースにおけるモデルの性能を評価するための広がりに欠けています。
GLUE: 汎用的な言語理解についてモデルをテストするように設計されており、単一のモデルがチャットボット、感情分析器、要約器などのさまざまなタスクを処理しなければならない実世界のアプリケーションにより適しています。
| Feature | GLUE | SQuAD |
|---|---|---|
| Task Diversity | 感情、含意、言い換えを含む複数のタスク | 質問応答のみに焦点を当てる |
| Number of Tasks | 9 | 1 |
| Evaluation Metrics | Accuracy、F1、Correlation、MCC | Exact Match、F1 Score |
| Scope | 汎用NLU | 情報検索とQA |
| Applications | 幅広いNLPタスク | QAシステム |
| Generalization Focus | マルチタスク学習を促進 | QA固有の能力に焦点を当てる |
比較: GLUE vs. SuperGLUE
SuperGLUEは、Super General Language Understanding Evaluationの略で、NLPモデルが幅広い複雑な言語理解タスクをどれだけうまく処理できるかをテストするために作成されたベンチマークです。本質的には、基準を引き上げるように設計されたGLUEのアップグレード版です。GLUEがより単純なタスクに焦点を当てている一方で、SuperGLUEには、より深い推論、常識知識、文脈理解を必要とする、より高度な課題が含まれています。
SuperGLUEは、実世界の言語理解を反映した、はるかに難しいタスクを導入することで、GLUEを改善しています。
| Features | GLUE | SuperGLUE |
|---|---|---|
| Task Complexity | 基本的な言語タスク(例:感情分析) | 推論と常識を必要とする複雑なタスク |
| Dataset Saturation | 性能が人間レベルに近づいている | モデル改善の余地が十分にある |
| Reasoning Requirement | 必要な推論は最小限 | 高度な推論と推測が必要 |
| Task Diversity | 主に文分類と類似性タスク | QA、共参照、読解を含む |
| Real-World Application | 実世界の反映は限定的 | 実世界の言語課題を模倣するように設計されたタスク |
GLUEの利点と課題
GLUEベンチマークは、NLPの研究開発に大きな影響を与え、モデル評価に機会と障壁の両方を提供してきました。
利点
標準化された評価: GLUEはNLPモデルを評価するための共通フレームワークを提供し、新しいモデル同士のベンチマークを容易にします。たとえば、研究者はSST-2のような特定のタスクにおける自分たちのモデルの性能を比較し、競合と比べてどの程度優れているかを確認できます。
汎化を促進: 幅広いタスクを含めることで、GLUEはモデルが1つのタスクだけに特化するのではなく、さまざまなNLUシナリオ全体でうまく汎化することを促します。多様な言語タスクが必要とされる実世界のアプリケーションでうまく機能するモデルを構築するために不可欠です。
タスクの多様性: GLUE に含まれる幅広いタスクにより、モデルは感情分析からテキスト含意まで、さまざまな言語能力について評価されます。たとえば、言い換え検出と含意タスクの両方を評価することで、文同士の関係に対するモデルの理解を評価できます。
研究の推進: GLUE は、NLP における転移学習とマルチタスク学習の進展を促進するうえで重要な役割を果たしてきました。モデル評価の標準を設定することで、GLUE は BERT や GPT のような、より高性能で汎用的な言語モデルの開発を促してきました。
使いやすさ: Hugging Face Datasets などの前処理済みデータセットやツールが利用できるため、研究者は実験に GLUE を簡単に使用できます。そのアクセス性により、新しいモデルを評価する際の参入障壁が低くなります。
性能ベンチマーキング: GLUE leaderboard は、NLP における最先端モデルを比較するための公開プラットフォームを提供します。この透明性は、研究者がモデル性能の限界に挑戦する動機となり、コミュニティ内の協力を促進します。
課題
タスクのバイアス: GLUE 内の一部のタスクには固有のバイアスがあり、モデルが言語を本当に理解するのではなく、意図しないパターンを学習してしまうことがあります。たとえば、モデルは根底にある意味関係を理解するのではなく、データセット固有の癖を利用する可能性があります。
データの不均衡: GLUE のいくつかのタスクには不均衡なデータセットがあり、モデルの学習プロセスや性能を歪める可能性があります。たとえば、データセット内であるクラスが過剰に表現されている場合、モデルはそのクラスに偏り、誤解を招く精度スコアにつながる可能性があります。
実世界での適用可能性: 高いベンチマークスコアの達成に焦点を当てることが、必ずしも実世界での性能に結びつくとは限りません。GLUE で高い性能を示すモデルでも、より多くのばらつきやノイズを含む実世界のデータには苦戦する可能性があります。
モデルの飽和: トップモデルがベンチマークを飽和させるにつれて、GLUE は最高性能のモデル同士を区別するうえで有用性が低下します。たとえば、最近の多くのモデルは特定の GLUE タスクでほぼ完全なスコアを達成しており、意味のある改善を特定するためにベンチマークを利用することが難しくなっています。
計算負荷の高さ: すべての GLUE タスクでモデルを実行するには計算コストが高くなる可能性があり、リソースが限られた小規模な研究グループにとっては困難です。高性能計算インフラにアクセスできない人々にとって、参加とイノベーションの障壁となります。
ベンチマークへの過学習: GLUE は NLP モデルを評価するための広く使われている標準であるため、モデルが全体的な言語理解を真に向上させるのではなく、GLUE タスクで良い性能を出すことに特化して設計されるリスクがあります。これは、モデルがベンチマークでは優れた性能を示しても、新しい未見のデータに適用された際に苦戦し、実世界のアプリケーションにおける有用性が制限される可能性があることを意味します。
GLUE のユースケースとツール
GLUE は、感情分析から言い換え、言語的推論まで、多くのユースケースにわたって NLP モデルを評価するための中心的な尺度です。Hugging Face や TensorFlow などのさまざまな GLUE データセットやツールが、自然言語理解におけるモデル性能のファインチューニングとテストに使用されています。
ユースケース
マルチタスク学習のベンチマーク: GLUE の設計は、感情分析や言語的許容性など、多くの異なるタスクでモデルが同時に良好に機能することを促します。たとえば、GLUE で学習されたモデルは、顧客レビューの分析と文法の修正の両方に対応でき、その汎用性を示す可能性があります。
きめ細かな言語理解の評価: GLUEには、類似した文における微妙な意味の違いを検出するなど、詳細な言語スキルをテストするタスクが含まれています(例:“He finished the report” vs. “He completed the report”)。これにより、モデルが言語のニュアンスを本当に理解していることを確認するうえで価値があります。
教育および研究目的: GLUEは、NLUモデルの教育や実験のために学術界で広く使用されています。学生や研究者は、GLUEデータセットを活用してNLPモデルの構築、ファインチューニング、評価を実践できるため、非常に価値の高い教育ツールとなっています。
実世界のNLPシステム評価: 企業は、実世界のシナリオで展開するNLPシステムの堅牢性を評価するためにGLUEを使用します。たとえば、チャットボットプロバイダーは、自社システムがさまざまな言語入力を処理し、異なる会話トピック全体で精度を維持できることを確認するためにGLUEを使用する場合があります。
ドメイン固有モデルのチューニング: GLUEは、特定の業界やアプリケーション向けにモデルをファインチューニングするための基盤として使用できます。たとえば、金融セクターの企業は、モデルを金融文書に特化してファインチューニングする前に、その適応性を確認するための予備的なベンチマークとしてGLUEタスクを使用する場合があります。
セマンティック検索アプリケーション: GLUEタスクは、テキスト含意や類似性の理解が重要となるセマンティック検索システムの構築などのユースケースに関連付けることができます。これらのモデルはその後、Milvusのようなツールで使用され、単にキーワードを一致させるのではなく、検索クエリに対して最も意味のある一致を迅速に見つけることができます。これにより、より正確で有用な検索結果が得られます。
ツール
Hugging Face Datasets: トレーニングと評価のためにGLUEタスクへ簡単にアクセスできます。Hugging Faceライブラリには、GLUEデータセットをさまざまなNLPワークフローに統合するための豊富なドキュメントとサポートがあり、実験を簡素化します。
TensorFlow Datasets: GLUE datasetsが含まれており、TensorFlowベースのワークフローとシームレスに統合できます。TensorFlowユーザーは、これらのデータセットを活用してモデルを効率的にトレーニングおよび評価し、GLUEベンチマークとの互換性を確保できます。
FAQs
- GLUEベンチマークとは何ですか?
GLUEは、感情分析、言い換え、テキスト含意などの課題でNLPモデルをテストするために設計された9つのタスクセットです。これにより、モデルがさまざまな言語問題を効果的に処理できることを確認できます。
- なぜGLUEは重要なのですか?
GLUEは、NLPモデルを比較するための標準的な方法を提供し、言語理解の改善を促進し、より優れた汎用性の高いモデルの作成を促します。
- GLUEデータセットはどのように使用できますか?
Hugging FaceやTensorFlowのようなプラットフォームを使用すると、GLUEタスクを簡単に読み込むことができます。たとえば、Hugging Faceでは、シンプルなPythonコマンドでGLUEタスクをインポートできます。
- GLUEはNLP研究にどのように役立ちますか?
GLUEは複数のタスクでモデルを評価し、研究者が異なる言語問題全体で汎化し学習する能力をテストするのに役立ちます。
- GLUEスコアはどのように計算されますか?
GLUEスコアは、すべてのGLUEタスクにわたるモデルの性能を1つの数値に統合し、その全体的な言語理解能力を表します。たとえば、モデルがSST-2(感情分析)やMRPC(言い換え検出)のようなタスクで良好な性能を示す場合、GLUEスコアはその成功を要約します。