




データベースの非正規化:包括的ガイド
データベースの非正規化:包括的ガイド
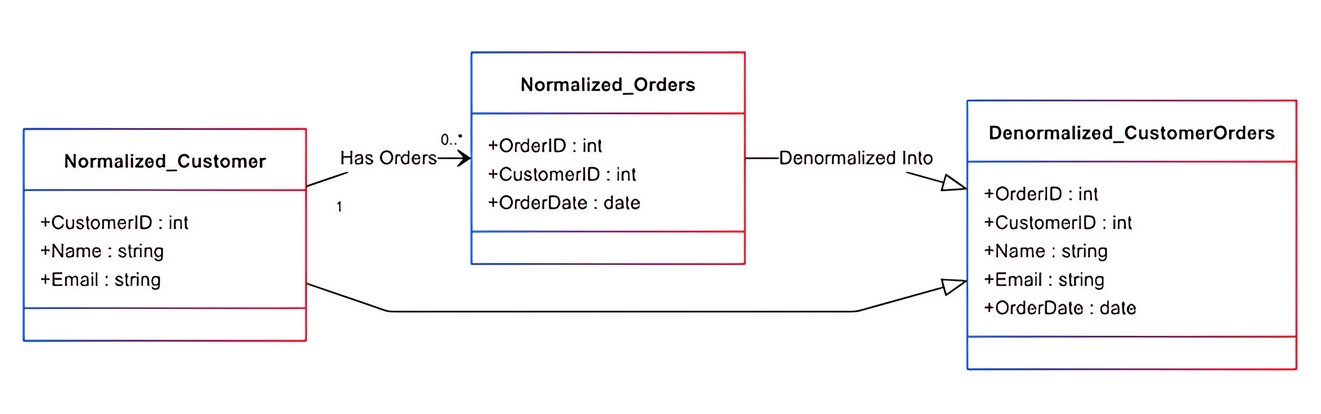
図1:データベースの非正規化のイラスト
大量の情報を扱っている場合でも、あるデータベースが他のデータベースよりも高速にクエリを処理できるのはなぜでしょうか?その答えは、データベースのインデックス作成、クエリ最適化、およびストレージアーキテクチャにあります。高速なデータ取得は、パフォーマンス、ユーザー体験、全体的な有効性を向上させるため、非常に重要です。
従来のデータベース正規化は、明確に定義された関係を持つテーブルにデータを整理することで、データの整合性を維持します。正規化はデータの正確性を向上させる一方で、多くの結合を使用するシステムではパフォーマンスのボトルネックを引き起こしがちです。テーブルと結合が多くなるほど、データの取得が難しくなり、アプリケーションの応答性が低下します。
データベースのパフォーマンスを最適化するために使用される手法の一つが非正規化です。非正規化は、読み取りが多い負荷を最適化するために、データベースに冗長データを導入します。これにより、複雑な結合の必要性が減り、クエリのパフォーマンスが向上します。
このガイドでは、データベース非正規化の概念を説明し、正規化と比較し、その利点について論じます。また、データベースの非正規化が有益なユースケースや、企業がそれを実装する際に直面する可能性のある課題についても明らかにします。
データベースの非正規化とは?
データベースの非正規化は、以前に正規化されたスキーマに重複データを追加する最適化手法です。この手法は、クエリを簡素化し、結合の数を減らすことで、読み取りパフォーマンスを向上させます。
正規化されたデータベースは、さまざまなテーブル間でデータを取得するために複数の結合を必要とするため、大規模なデータセットを扱う際に遅くなります。非正規化の手法は、書き込み操作よりも読み取り操作を実行するシステムで有用です。
たとえば、正規化されたデータベースに、顧客、注文、製品の3つの別々のテーブルが含まれているとします。製品の詳細を含む顧客の注文履歴を取得するには、データベースが複数のテーブルを結合し、顧客、注文、製品からのデータを組み合わせる必要があります。非正規化されたスキーマでは、製品詳細などの関連データを1つのテーブルに統合し、結合を最小限に抑えて読み取りパフォーマンスを向上させます。
ただし、読み取り操作のパフォーマンス向上には、書き込み操作のコストが伴います。データベースが冗長な情報を維持する必要があるため、一貫したデータ更新はより複雑になります。
仕組み
非正規化プロセスは、クエリとデータ取得の速度およびパフォーマンスを向上させるために、再構成によって正規化されたデータベースを変換します。正規化プロセスがデータの一貫性を維持しながら重複を排除する一方で、非正規化はアプリケーションの読み取り操作を特に強化するために重複データを追加します。
リアルタイムレポート、高速クエリ、分析を必要とするデータベースでは、この手法が広く採用されています。以下では、非正規化のアプローチと、それらがデータベースの有効性に与える影響について説明します。
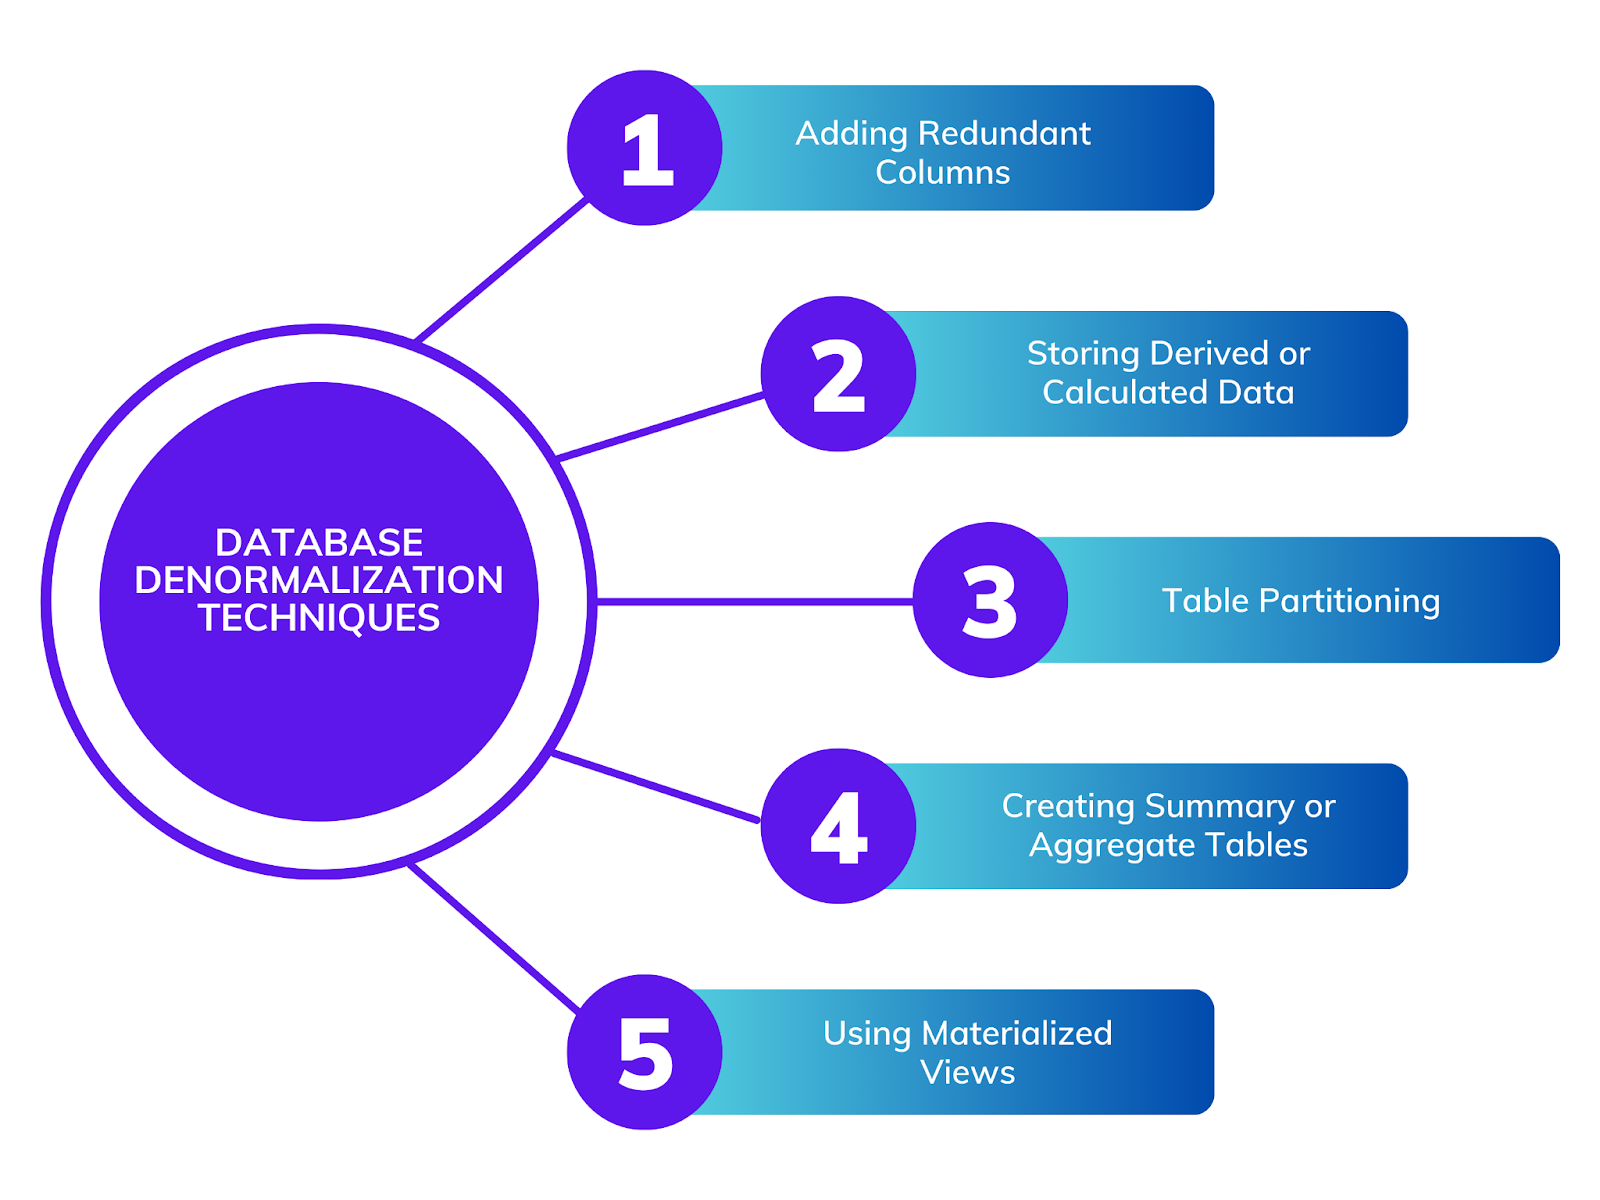 データベースの非正規化アプローチ
図2:データベースの非正規化アプローチ
冗長列の追加
冗長列の追加は、非正規化のシンプルで標準的な方法です。これは、結合操作を減らすために、複数の場所にデータを追加することを含みます。たとえば、データベースの注文テーブルには、顧客テーブルに接続するIDという名前の外部キーがあります。顧客テーブルには、氏名、ID、連絡先情報など、各顧客に関する重要な詳細が含まれています。
顧客の注文詳細を分析する際、顧客データを抽出するために結合操作が必要になります。テーブルの結合は特にコストが高く、全体的なパフォーマンスを低下させる可能性があります。顧客情報が注文テーブルに保存されていれば、結合の必要がなくなり、効率的なデータ取得につながります。
この方法はクエリの速度を大幅に向上させますが、データ冗長性のコストを増加させます。顧客データが変更された場合、一貫性を保つためにすべての冗長コピーを更新する必要があります。そのため、更新やトリガーを通じてパフォーマンスを最適化し、データ整合性を管理することが求められます。この問題のバランスは、明確に定義された更新プロセスを使用することで実現できます。
派生データまたは計算済みデータの保存
非正規化のもう1つの方法は、頻繁に行われる計算を保存し、事前計算することです。正規化されたデータベースシステムでは、計算はクエリ実行時に動的に行われます。これにより値が最新であることは保証されますが、計算負荷にも悪影響を与えます。
大規模なデータセットや多数のクエリ要求を扱う場合、システムパフォーマンスは低下します。しかし、これらの値を既存のテーブル行内の追加列として追加することで、パフォーマンスを向上させることができます。
たとえば、データベースは注文テーブルに合計注文金額を事前に保存できるため、ユーザーが注文履歴を要求する際にこの情報を再計算する必要がありません。これらの値はすでに保存されているため、データベースシステムは追加処理なしで値を提供できます。
この手法は、集計や複雑な計算を必要とする大量のデータを扱う金融分野、eコマース、BIシステムにおいて有益です。ただし、事前計算された値の整合性を維持することは重要です。そのため、データの変更に基づく定期的な更新やトリガーの起動が必要になります。
テーブルパーティショニング
テーブルパーティショニングは、大きなテーブルをパーティションに分割してクエリ処理とデータ取得速度を向上させる主要な非正規化アプローチです。トランザクションログ、監査記録、履歴データセットを含む大規模データベースを処理する際に優れた結果をもたらします。さらに、次の2つの部分に分けられます。
水平パーティショニング: このパーティショニング手法は、日付パラメータ、地理的地域、ユーザー区分などの基準に基づいて、テーブルを小さなパーティションに分割します。たとえば、数百万件の販売取引を持つオンライン小売業者は、注文テーブルを年単位のパーティションに従って分割できます。クエリが最近の取引を必要とする場合、完全なテーブルではなく縮小されたデータサブセットをスキャンすればよいため、パフォーマンスが向上します。
垂直パーティショニング: 垂直パーティショニングは、テーブルを列ベースの個別セクションに分離するため、水平パーティショニングとは異なる機能を持ちます。頻繁にアクセスされる列とアクセス頻度の低い列を分けて配置することで、クエリが必要なデータのみを取得できるように、テーブルを2つの部分に分割します。このアプローチは、多数の属性を含む幅広いテーブルに有益であり、クエリが必須フィールドのみにアクセスできるようにします。
どちらのパーティショニング方法もストレージ最適化を改善し、クエリ実行時間を短縮することで、高性能データベースに大きな価値を追加します。ただし、これらの方法はインデックス作成とパーティショニングの複雑さを増し、適切な戦略が適用されない場合はクエリの非効率を招く可能性があります。
サマリーテーブルまたは集計テーブルの作成
レポート生成およびデータ分析処理アプリケーションでは、生の入力からリアルタイムの要約統計を抽出することがよくあります。これには通常、大きな処理能力が必要です。したがって、1つのアプローチはテーブルを集計することです。再計算の代わりに、サマリーテーブルを保存場所として使用でき、事前集計されたデータへ即座にアクセスできます。
複数の地域にわたる販売実績を分析する小売企業を考えてみましょう。各地域について月ごとの総売上を集計したサマリーテーブルを作成すれば、ハイレベルなインサイトを容易に把握できます。
このテーブルは、リアルタイム、トリガー、またはスケジュールされたバッチ更新によって更新できます。サマリーテーブルは、元のトランザクションテーブルよりも行数が少ないため、クエリ実行が高速になり、ダッシュボードやレポートの応答性が向上します。
この方法はハイレベルなインサイトを改善する一方で、強力なデータ更新メカニズムも必要とします。バッチ処理やETLパイプラインにより、最新のサマリーデータ保持を強制できます。
マテリアライズドビューの使用
マテリアライズドビューは、クエリ実行結果を含む物理的なデータベースオブジェクトを作成する高度な最適化機能です。標準ビューでは、アクセスのたびに動的なクエリ実行が必要です。しかし、マテリアライズドビューはデータをディスク上に保存するため、ユーザーは追加処理なしで即座に情報を取得できます。
顧客の購入を監視するEコマースWebサイトの例を見てみましょう。サイト所有者は、複数の商品カテゴリ内で顧客ごとの総支出を追跡するマテリアライズドビューを作成できます。このアプローチはより高速なクエリ応答を提供するため、データベースはリアルタイム計算を実行するのではなく、事前計算された結果を取得します。
マテリアライズドビューは、システム要件に応じて定期的にリフレッシュしたり、増分更新したりできます。この手法は、結合、集計、および複数ステップの変換を必要とするデータベースに優れた利点をもたらします。
比較: 非正規化 vs. 正規化
データベース設計における正規化と非正規化の選択は、パフォーマンス速度、ストレージ効率、およびデータ一貫性の要件によって異なります。この表は、非正規化と正規化の違いを示しています。
| 観点 | 正規化 | 非正規化 |
| 目的 | 冗長性を削減 | 読み取りパフォーマンスを向上 |
| データ構造 | 複数の関連テーブル | 少ないテーブル、冗長データ |
| クエリの複雑さ | 複雑な結合 | 簡略化されたクエリ |
| 最適な用途 | 書き込みの多いアプリケーション | 読み取りの多いアプリケーション |
| データ整合性 | 高い | 損なわれる可能性あり |
| ストレージ使用量 | 効率的 | 増加 |
| メンテナンス | 簡略化 | より複雑 |
| 更新時の異常 | 最小化 | リスク増加 |
データベースの選択プロセスでは、データ取得パターン、更新速度要件、およびシステムパフォーマンス仕様の分析が求められます。適切にバランスの取れたデータベースは、運用効率とスケーラビリティを維持します。
利点と課題
非正規化は、読み取り操作とクエリ実行速度を向上させるために冗長データを追加する最適化手法です。しかし、パフォーマンス向上はストレージや異常に関する問題を引き起こす可能性があります。非正規化の利点を得るには、潜在的なリスクの発生を防ぐバランスの取れた実装が必要です。以下に利点と課題の一部を示します。
非正規化の利点
アプリケーションの複雑さの軽減: 非正規化は、複雑な結合や複数テーブルにまたがるクエリの必要性をなくすことで、アプリケーションロジックを簡素化します。これにより、クエリの可読性とシンプルさが向上し、開発者の生産性が高まります。
分散システムにおけるパフォーマンスの向上: 分散データベースで複数のノードからデータを取得すると、パフォーマンスの遅延につながります。非正規化では、重複データをその主なアクセスポイントの近くに配置します。これにより、ノード間のデータ取得の必要性が低下します。この手法は、クラウドベースのシステムだけでなく、水平スケールされたアーキテクチャにも有用です。
データウェアハウジング効率の向上: データウェアハウスでは、複雑な計算や集計手順を実行する分析タスクを効率的に処理する必要があります。非正規化は、事前に結合または集計されたデータを保存することで読み取りパフォーマンスに利点をもたらし、リアルタイムのデータ変換の必要性をなくします。
リアルタイム分析の促進: 分析を実行するアプリケーションでは、迅速な洞察を得るためにデータへ即時にアクセスする必要があります。非正規化は、冗長データとともに事前計算された値を保存することで、複雑なリアルタイム計算の必要性を減らします。
レポーティングの最適化: 非正規化されたデータベースは、即時にレポートを作成できるよう前処理済みデータを保持し、データ変換操作の必要性を最小限に抑えます。このアプローチは、ビジネスインテリジェンスアプリケーションや経営層向けダッシュボードに大きな利点をもたらします。
課題
データ異常: データの重複は、更新がすべてのシステムインスタンス間に適切に伝播しない可能性があるため、データ不整合のリスクを高めます。非正規化されたシステムでは、異常のリスクを減らすためにデータ検証と整合性チェックが重要です。
ストレージコストの増加: 冗長データには追加のストレージ容量が必要となり、データベース全体のサイズが増加します。使用量ベースの料金モデルを採用するクラウドベースのデータベースでは、ストレージ要件によりコストが高くなる可能性があります。
データ同期の複雑さ: データ同期では、すべての更新操作がすべてのデータコピーを同時に変更する必要があり、パフォーマンス上の制約につながります。データ同期の実行が不十分だと、不正確または古い情報を含むレコードが生成されます。
データ整合性問題の可能性: 複数のインスタンスにわたる更新の実行が不適切だと、一貫性のないデータが生成されます。これにより、運用品質とレポーティング精度が低下します。高トランザクションシステムでは、データ整合性を維持するために追加のリソースと厳格な検証システムが必要です。
柔軟性の低下: 複数テーブル環境では、スキーマ変更がより困難になります。これにより開発サイクルが遅くなり、組織が新しいビジネス要件に適応することが難しくなります。
データ異常、整合性の問題、ストレージ費用を防ぐために、非正規化を実装するには適切な管理が必要です。組織は、自社のシステムニーズに合致する特定されたパフォーマンス要件に基づいて、非正規化を実装すべきです。
ユースケース
非正規化の利点は特定のユースケースで明らかになりますが、組織はさまざまな状況におけるその影響を理解する必要があります。主なユースケースは以下のとおりです。
データウェアハウジング & OLAPシステム: データウェアハウジングとOLAPシステムでは、複雑なクエリや集計をより効率的にするために非正規化手法を使用します。非正規化スキーマを使用すると、複数のテーブル結合の必要性がなくなるため、データ取得が高速化します。これは、ビジネスインテリジェンスアプリケーションや分析ワークロードに不可欠です。
低レイテンシアプリケーション: 非正規化は、金融取引プラットフォームなどの重要な環境でデータの取得と処理に必要な時間を短縮することで、低レイテンシアプリケーションに利点をもたらします。
読み取り中心のアプリケーション: 書き込み操作よりも読み取り操作を多く実行するアプリケーションは、非正規化を使用することでパフォーマンスを向上させることができます。コンテンツ管理やレポーティングツールなどのシステムは、重複データを追加することで読み取りリクエストのパフォーマンスを向上させることができます。
リアルタイム分析: 即時のインサイトを必要とするアプリケーションは、事前集計済みデータにアクセスすることで非正規化の恩恵を受けられます。これによりクエリ処理時間が短縮され、最新情報を使った迅速な意思決定が可能になります。
FAQs
データベースの非正規化は常にパフォーマンスに優れていますか?
書き込み負荷の高いシステムにおける非正規化は、冗長データの維持に大きな課題があるため、データ不整合の問題を引き起こします。データベースの非正規化を決定する前に、アプリケーションの読み取りおよび書き込みパターンを評価する必要があります。
非正規化は正規化に取って代わりますか?
非正規化は、パフォーマンス上の問題を改善するために、正規化に続く追加ステップとして機能します。正規化プロセスは、重複を排除しデータの整合性を維持するようにデータを構造化しますが、非正規化は読み取り速度を向上させるためにデータの重複を再導入します。
非正規化のリスクは何ですか?
非正規化を実装すると、データの冗長性、ストレージ要件の増加、不整合という3つの主なリスクが生じます。データの冗長性が増すと、不適切に管理された場合に潜在的な異常が発生し、データサイズの拡大にはストレージ費用の増加が必要になります。
データベースの一部だけを非正規化できますか?
はい、データベースの非正規化は、特定のデータベース部分を対象としてパフォーマンスを最適化することで機能します。対象を絞った実装により、データベースの管理容易性や整合性に影響を与えることなく、特定の領域で読み取り効率を向上させることができます。
非正規化されたデータベースでデータの一貫性を維持するにはどうすればよいですか?
非正規化されたデータベースでは、更新中に冗長データの一貫性を保つために、データベーストリガー、制約、およびアプリケーションロジックが必要です。これらの仕組みを実装することで、すべてのデータコピー間でデータ同期が維持されます。