




MilvusとPythonで映画推薦エンジンを作る
この記事はThe New Stackに掲載されたもので、許可を得てここに再掲載している。
**オープンソースのツールを使って、人々が観たいと思うような映画を見つけるのを助けよう。
レコメンダー・システムやレコメンデーション・エンジンは、ユーザーが興味を持ちそうなものを予測し、提案することを目的とした情報フィルタリング・システムである。これらのアイテムには、製品やサービス、映画、本、音楽、ニュース記事などのコンテンツが含まれます。
推薦システムには、協調フィルタリング(https://realpython.com/build-recommendation-engine-collaborative-filtering/)、コンテンツベースフィルタリング(https://www.turing.com/kb/content-based-filtering-in-recommender-systems)、ハイブリッド推薦システム(https://analyticsindiamag.com/a-guide-to-building-hybrid-recommendation-systems-for-beginners/)、ベクトルベース推薦システム(https://medium.com/vector-database/building-personal-recommender-systems-with-milvus-and-paddlepaddle-808567e3d65e)などの種類がある。ベクトルベース推薦システムは、ベクトル空間を使って、データベース内の最も近いアイテムを見つける(推薦する)。これらのベクトルを保存する方法は様々であるが、最も効率的なものの一つは、Milvus オープンソースベクトルデータベースを使用することである。このデータベースは柔軟性、高速性、信頼性が高く、1兆バイト規模の追加、削除、更新、ほぼリアルタイムのベクトル検索が可能です。
この記事では、MilvusとPythonを使った映画レコメンダーの構築方法を説明する。このシステムでは、SentenceTransformersを用いてテキスト情報をベクトルに変換し、そのベクトルをMilvusに格納する。Milvusでは、ユーザが入力したテキスト情報に基づいて、データベース内の映画を検索することができます。
注目の画像:Tima Miroshnichenko on Pexels](https://assets.zilliz.com/Creat_Movie_Recommendation_Engine_4dcac67c49.jpg)
環境を整える
この記事を書くには、以下の環境がインストールされている必要があります:
Python 3.x](https://www.python.org/downloads/)
パッケージをインストールするための Python Package Manager (PIP)
コードを書くためのJupyter Notebook
Docker](https://www.docker.com/)
32GB以上のRAMを搭載したシステム、またはZilliz Cloudのアカウント
Pythonの要件
このチュートリアルで必要となるライブラリのセットもインストールする必要があります。PIPを使ってライブラリをインストールしてください:
python -m pip install pymilvus pandas sentence_transformers kaggle
ベクトルデータストア (Milvus)
Milvusのベクトルデータベースを使い、映画の説明を使って生成した埋め込みデータを保存します。このデータセットは比較的大きく、少なくともパーソナルコンピュータ上で動作するサーバには適していません。そのため、これらのベクトルを保存するためにZilliz Cloudインスタンスを使用することをお勧めします。
ローカルのインスタンスに留まりたい場合は、docker-composeコンフィギュレーションをダウンロードして実行することができます:
$ wget https://github.com/milvus-io/milvus/releases/download/v2.3.0/milvus-standalone-docker-compose.yml -O docker-compose.yml
docker-compose up -d
これで、Milvusを使って独自の映画レコメンダーシステムを構築するための要件がすべて揃ったことになる。
データの収集と前処理
このプロジェクトでは、KaggleのMovies Datasetを使用します。このデータセットには45,000本の映画のメタデータが含まれています。このデータセットは直接ダウンロードすることもできますし、Pythonを使ってデータセットをダウンロードするためにKaggle APIを使うこともできます。Pythonを使ってダウンロードするには、Kaggle.comのprofile sectionからkaggle.jsonファイルをダウンロードし、APIが見つけられる場所に置く必要があります。
次に、Kaggle認証のための環境変数を設定します。これには、Jupyter Notebookを開き、以下のコードを記述します:
KAGGLE_USERNAME= ユーザー名
%env KAGGLE_KEY=XXXXXXXXXXXXXXXXXXXXXXXXXXXXX
TOKENIZERS_PARALLELISM=true
完了したら、KaggleのPython依存を使用してKaggleからデータセットをダウンロードすることができます:
# インポート kaggle 依存
インポート kaggle

kaggle.api.authenticate()
kaggle.api.dataset_download_files('rounakbanik/the-movies-dataset', path='dataset', unzip=True)
データセットのダウンロードが完了したら、pandasのread_csv()メソッドを使用してデータセットを読み込むことができます:
# import pandas
pandas を pd としてインポートする

# csvデータを読み込む
movies=pd.read_csv('dataset/movies_metadata.csv',low_memory=False)
# データの形状をチェックする
movies.shape
 データセットの形状
この画像は、24列のメタデータを持つ45,466レコードがあることを示している。これらのメタデータ・カラムをすべてチェックする:
# カラム名をチェックする
映画.カラム
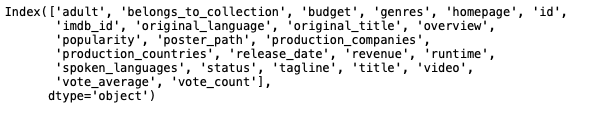 データセットのカラム
レコメンダー・システムを作成するのに不要なカラムがたくさんあります。必要なカラムをフィルタリングすることができます:
# 必須カラムをフィルターする
trimmed_movies = movies[["id", "title", "overview", "release_date", "genres"]].
trimmed_movies.head(5)
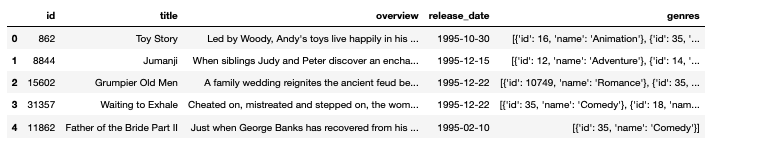 必須カラム
また、データのフィールドの一部が欠落しているので、それらの行を削除してクリーンなデータセットを作成する:
unclean_movies_dict = trimmed_movies.to_dict('records')
print('{} movies'.format(len(unclean_movies_dict)))
movies_dict = [].

for movie in unclean_movies_dict:
    if movie["overview"] == movie["overview"] and movie["release_date"] == movie["release_date"] and movie["genres"] == movie["genres"] and movie["title"] == movie["title"]:
        movies_dict.append(movie)
ミルバスに接続する
必要なカラムが揃ったので、Milvusに接続してデータのアップロードを開始します。Milvusのクラウドインスタンスに接続するには、Zilliz CloudのダッシュボードからダウンロードできるURI(Uniform Resource Identifier)とトークンが必要です。
Zillizダッシュボード](https://assets.zilliz.com/Zilliz_Dashboard_328bcab3ca.png)
URIとAPIキーが手に入ったら、PyMilvusのconnect()メソッドを使ってMilvusサーバに接続します:
# milvus 依存のインポート
from pymilvus import * * # milvusのインポート

# milvusに接続する
milvus_uri="YOUR_URI"
token="YOUR_API_TOKEN"
connections.connect("default", uri=milvus_uri, token=token)
print("Connected!")
ムービーのエンベッディングを生成する
さて、いよいよ映画データセットに含まれるテキストデータの埋め込みを計算します。まず、映画のIDと埋め込みデータを格納する collection オブジェクトを作成します。また、indexフィールドを作成し、検索を効率化します:
COLLECTION_NAME = 'film_vectors'
PARTITION_NAME = '映画'

# これがレコード・スキーマである。
"""
"タイトル":映画のタイトル、
"概要": 説明、
"release_date": 映画の公開日、
"genres": 映画のジャンル
"embedding": 埋め込み
"""

id = FieldSchema(name='title', dtype=DataType.VARCHAR, max_length=500, is_primary=True)
field = FieldSchema(name='embedding', dtype=DataType.FLOAT_VECTOR, dim=384)

schema = CollectionSchema(fields=[id, field], description="movie recommender: film vectors", enable_dynamic_field=True)

if utility.has_collection(COLLECTION_NAME):# 以前に作成された同じコレクションを削除する
    コレクション = コレクション(COLLECTION_NAME)
    collection.drop()

コレクション = コレクション(name=COLLECTION_NAME, schema=schema)
print("コレクションが作成されました。")

index_params = { {インデックス・タイプ
    「index_type":"IVF_FLAT"、
    "metric_type":"L2",
    「params":params": {"nlist":128},
}

collection.create_index(field_name="embedding", index_params=index_params)
コレクション.load()

print("Collection indexed!")
インデックス付きコレクションができたので、テキストの埋め込みを生成する関数を作成します。overviewは埋め込みを生成するために使用される主要なカラムですが、データをより論理的にするために、overviewと一緒にgenreとrelease data**の情報も使用します。
埋め込みデータを生成するには、SentenceTransformerを使用します:
from sentence_transformers import SentenceTransformer
インポート ast

# ジャンルカラムからテキストを抽出する関数
def build_genres(data):
    genres = data['genres'].
    genre_list = ""
    entries= ast.literal_eval(genres)
    genres = ""
    for entry in entries:
        genre_list = genre_list + entry["name"] + ", ".
    genres += genre_list
    genres = "".join(genres.rsplit(",", 1))
    リターンジャンル

# SentenceTransformer のオブジェクトを作成する。
transformer = SentenceTransformer('all-MiniLM-L6-v2')

# 埋め込みを生成する関数
def embed_movie(data):
    embed = "{}.公開日は{}。ジャンルは{}です。".format(data["概要"], data["release_date"], build_genres(data))
    embeddings = transformer.encode(embed)
    return embeddings
この関数は、build_genres() メソッドを使って genre 列をクリーニングし、テキストを取り出します。次に、テキストから埋め込みを生成するための SentenceTransformer オブジェクトを作成します。最後に、encode() メソッドを使用して、overview、release_date、genre 特徴を使用して埋め込みを生成します。
エンベッディングをMilvusに送る
これでembed_movie()メソッドを使って埋め込みデータを作成することができます。このデータセットはMilvusに送信するには大きすぎるため、一度にinsertステートメントで送信することはできません。そこで、Milvusに送信するデータのバッチ(例えば、5,000行)を作成する:
# バッチ処理と進捗表示のためのループカウンタ
j = 0
バッチ = [].

for movie_dict in movies_dict:
    try:
        movie_dict["embedding"] = embed_movie(movie_dict)
        batch.append(movie_dict)
        j += 1
        if j % 5 == 0:
            print("埋め込まれた{}レコード".format(j))
            collection.insert(バッチ)
            print("バッチ挿入完了")
            batch=[]
    except Exception as e:
        print("レコード {} の挿入エラー".format(e))
        pprint(batch)
        ブレーク

collection.insert(movie_dict)
print("最終バッチが完了しました")
print("{}個の埋め込みを終了しました".format(j))
***注意:**** *バッチサイズはお好みで調整してください。また、整数にキャストできないIDの場合、いくつかのムービーが失敗します。これはスキーマを変更するか、フォーマットを確認することで解決できます。
エンベッディングをMilvusに送る](https://assets.zilliz.com/Send_Embeddings_to_Milvus_f5d4344f03.png)
Milvusを使って新しい映画を推薦する
Milvusのほぼリアルタイムのベクトル検索機能を活用し、視聴者の条件に近い映画を取得することができます。そのために、2つの異なる機能を作成します:
- embed_search(): ユーザーの検索文字列をエンベッディングに変換するトランスフォーマーが必要です。この関数は、視聴者の条件を受け取り、Milvusに入力するために使用したのと同じ変換器に渡します。
2.search_for_movies():この関数は、サポートのために他の関数を使用して、実際のベクトル検索を実行します。
# 検索前にコレクションメモリをロードする
コレクション.load()

# 検索パラメータを設定する
topK = 5
search_param = {
    "metric_type": "L2"、
    "params":{"nprobe": 20}、
}

# 検索文字列を埋め込みに変換
def embed_search(search_string):
    search_embeddings = transformer.encode(search_string)
    return search_embeddings

# ユーザのクエリに対して類似の埋め込みを検索する
def search_for_movies(search_string):
    user_vector = embed_search(search_string)
    return collection.search([user_vector], "embedding",param=SEARCH_PARAM, limit=topK, expr=None, output_fields=['title', 'overview'])
上記のコードでは、上位5つの類似ベクトルを取得するためのパラメータtopK、2つのベクトル間の距離を計算するL2 (squared Euclidean)としてのmetric_type、検索するクラスタ単位の数を示すnprobeを定義しています。また、ユーザのクエリ(推薦)から類似ベクトルを取得するための様々な関数が実装されている。
最後に、search_for_movies()関数を使用して、ユーザの検索文字列に基づいて映画を推薦する:
from pprint import pprint

search_string = "病院を舞台にした1990年代のコメディ。主人公は20代で、吸血鬼を止めようとしている。"
results = search_for_movies(search_string)

# 結果をチェック
for hits in iter(results):
    for hit in hits:
        print(hit.entity.get('title'))
        print(hit.entity.get('overview'))
        print("-------------------------------")
おすすめ映画](https://assets.zilliz.com/Recommend_Movies_b351d757f7.png)
Milvusのベクトル検索機能を使用することで、このコードはユーザーのクエリに基づいて類似した映画のトップ5を推薦する。これで完成です:これでMilvusを使った独自の映画推薦システムが構築できました。
結論
この記事を読んで、ベクトルベースの推薦システムとは何か、そしてMilvusを使ってどのように映画推薦システムを作るのかがわかったでしょう。Milvusは効率的でスケーラブルな映画推薦システムの構築を支援します。ベクトルストレージと類似検索を活用したMilvusは、パーソナライズされたレコメンデーションを可能にし、ユーザーエンゲージメントを高め、最新のレコメンデーションシステムにおける高度なベクトルベースモデルの役割を示す大きな可能性を秘めています。詳しくはMilvusウェブサイトをご覧ください。
読み続けて
Zilliz Cloud Now Available in 6 New Regions Across Japan and Europe
Zilliz Cloud is now available in new regions across Japan and Europe, including Tokyo on all three major clouds, bringing the total to 28 regions.
The AWS Outage Was a Wake-Up Call for Vector Database Cross-Region Disaster Recovery
Zilliz Cloud Had the Answer Before the Crisis. Zilliz Cloud is the world's first vector database with native cross-region disaster recovery.
3 Easiest Ways to Use Claude Code on Your Mobile Phone
Run Claude Code from your phone with Remote Control, Happy Coder, or SSH + Tailscale. Comparison table, setup steps, and tools for typing, memory, and parallel tasks.