Optimierung der Auswahl von Embedding-Modellen mit TDA-Clustering: Ein strategischer Leitfaden für Vektordatenbanken
Durch Interpretation von Erkenntnissen aus einem kürzlich von Zilliz veranstalteten Webinar mit den Referenten Gunnar Carlsson und Gabriel Alon – geschrieben von Wania Shafqat
Large Language Models (LLMs) haben die Datenverarbeitung transformiert, doch ihre Leistung ist eng mit der Qualität der Embeddings verknüpft, die sie antreiben. In unserem kürzlich durchgeführten Webinar untersuchten Gunnar Carlsson, Co-Founder und CTO von Blue Light AI, Gabriel Alon, Senior Data Scientist, und Stefan Webb, Developer Advocate bei Zilliz, wie Topological Data Analysis (TDA) Clustering verborgene Schwächen in Embedding-Modellen aufdeckt. Dieser Artikel fasst zentrale Erkenntnisse aus der Sitzung und Techniken zur Leistungssteigerung zusammen, ergänzt durch zusätzliche Forschungsergebnisse und praktische Tipps, die Ihnen helfen, selbstbewusst Modelle auszuwählen und zu entwickeln, die Ihren individuellen Anforderungen entsprechen.
Die Herausforderung: Bewertung von Embedding-Modellen
Embedding-Modelle wandeln rohe, unstrukturierte Daten (Text, Bilder, Videos) in hochdimensionale Vektoren um, die semantische Bedeutung erfassen. Die Auswahl des richtigen Embedding-Modells ist jedoch bei jeder Bereitstellung einer Vektordatenbank eine Herausforderung.
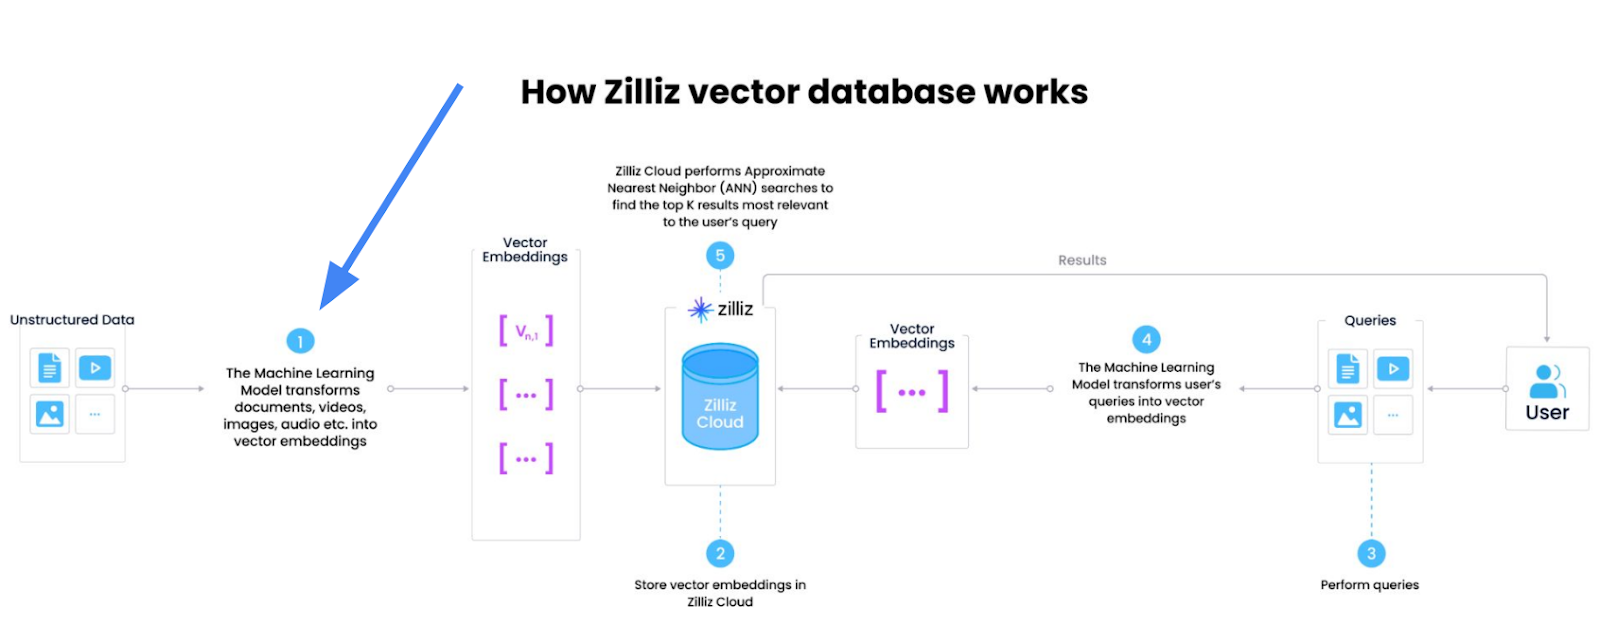
Abbildung: Auswahl des richtigen Embedding-Modells.
Traditionelle Embedding-Methoden stützen sich oft auf:
Öffentliche Leaderboards (MTEB): Modelle überanpassen sich an öffentliche Daten und schneiden bei realen Aufgaben schlecht ab.
Durchschnittliche Metriken: Metriken wie NDCG@10 verbergen Fehlercluster, in denen kritische Abfragen unterdurchschnittlich abschneiden.
Skalierbarkeitsprobleme: Die manuelle Prüfung großer Datensätze mit mehr als 100K Abfragen ist unpraktikabel.
Wie Gabriel Alon während des Webinars anmerkte, mag ein Durchschnittswert von 0.34 NDCG (Normalized Discounted Cumulative Gain) akzeptabel erscheinen, aber wenn ein erheblicher Anteil der Abfragen unter 0.1 liegt, kann das Modell für reale Anwendungen ungeeignet sein und das Vertrauen der Nutzer gefährden. Daher wurde dringend empfohlen, Modelle anhand Ihrer eigenen Daten zu bewerten, um Train-Test-Mismatch zu überwinden und Overfitting auf öffentlichen Benchmarks zu vermeiden.
Betrachten Sie zum Beispiel zwei Modelle, die Ergebnisse für „Television Stands“ abrufen:
Modell A gibt [Mobile TV Cart, Universal TV Stand, Black Television] zurück
Modell B gibt [Mobile TV Cart, Universal TV Stand, TV Stand (2 feet)] zurück
Obwohl Modell B eine höhere Recall aufweist, zeigen weder Durchschnittsmetriken noch Leaderboards diesen Unterschied auf.
Die Lösung: Navigierbares TDA-Clustering
Topological Data Analysis (TDA) ist ein mathematisches Framework, das die „Form“ von Daten untersucht, während navigierbares Clustering Flexibilität bietet, Hyperparameter (z. B. Auflösung) für granulare Erkenntnisse anzupassen. Durch die Anwendung von TDA-Clustering-Techniken, wie etwa dem Mapper-Algorithmus, können Sie visuelle Darstellungen erstellen, die zugrunde liegende Strukturen, Cluster und Ausreißer innerhalb hochdimensionaler Embeddings aufdecken, die traditionelle Durchschnittsmetriken übersehen. Navigierbares TDA-Clustering erweitert dies durch:
Abbildung der Datentopologie: Erstellung einer graphbasierten Struktur des Embedding-Raums.
Identifizierung kritischer Cluster: Hervorheben von Gruppen leistungsschwacher Abfragen für gezielte Verbesserungen statt einer Einheitslösung.
Automatisierte Interpretierbarkeit: Generieren von Schlüsselwörtern und Heatmaps, um Cluster und Modellverhalten zu erklären.
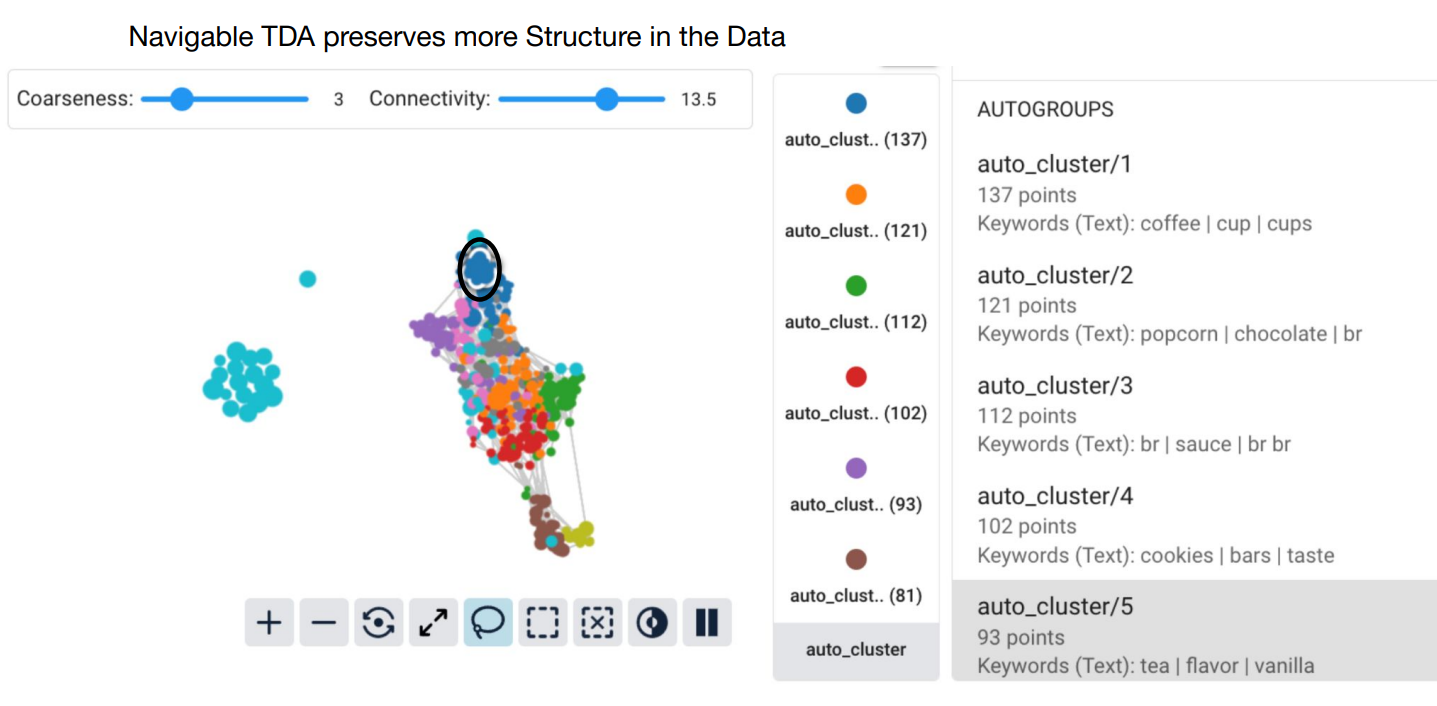
Abbildung: TDA-Clustering-Workflow: Hervorheben leistungsschwacher Gruppen.
So funktioniert es:
Abfragen nach Ähnlichkeit clustern: Abfragen mithilfe von Vektor-Embeddings gruppieren.
Metriken pro Cluster auswerten: Präzision, Recall oder NDCG für jeden Cluster berechnen.
Strategisch optimieren: Hyperparameter anpassen oder Modelle für schwache Cluster wechseln.
Im Gegensatz zu statischen Clustering-Methoden (z. B. K-means oder DBSCAN) erkennt navigierbares TDA-Clustering Fehler-Hotspots, die für Durchschnittsmetriken unsichtbar sind, bewertet Modelle objektiv (E5 vs. SBERT) anhand Ihrer Daten und verarbeitet 100K+ Abfragen in Minuten.
Fallstudie: Optimierung von E-Commerce-Abfragen
Unter Verwendung einer Teilmenge des Marqo-GS-10M-Datensatzes (10M Google Shopping-Abfragen) deckte Blue Light AI schwerwiegende Schwächen in einem beliebten Embedding-Modell (E5) auf. Nach Anwendung von TDA-Clustering:
| Abfragecluster | Größe | NDCG |
| Schwangerschaftskleidung | 35 | 0.10 |
| Espressomaschinen | 32 | 0.11 |
| Jungen-Trainingsanzüge | 35 | 0.13 |
Erkenntnisse:
Trotz eines durchschnittlichen NDCG von 0.34 schnitten etwa 30% der Cluster deutlich schlechter ab (<0.15).
Fine-Tuning verschlechterte die Leistung für kritische Cluster.
Ohne TDA bleiben diese subtilen Schwächen verborgen.
Machine-Learning-Lebenszyklus: TDA-Erkenntnisse
Modellvergleiche:
E5 (NDCG 0.34) übertraf SBERT (0.26) im Durchschnitt, aber SBERT glänzte in Clustern wie „novelty wallets“:
| Cluster | E5 NDCG | SBERT NDCG | Bestes Modell |
| Novelty wallets | 0.16 | 0.28 | SBERT |
| Luftmatratzen | 0.38 | 0.38 | Gleichstand |
Kostensparende Kompromisse:
Der Wechsel von E5-large zu E5-small sparte Speicherplatz, führte jedoch zu erheblichen Leistungseinbußen bei kritischen Clustern:
| Abfragetyp | Leistungseinbruch |
| Anpassbare Taillenbünde | -35% |
| Polo-Aktivitäten | -65% |
Fallstricke beim Fine-Tuning
Das Monitoring nach der Bereitstellung zeigte, dass Fine-Tuning den durchschnittlichen NDCG von 0.35 auf 0.45 verbesserte, aber bestimmte Cluster verschlechterte:
| Abfragetyp | Leistungseinbruch |
| Datenschutzfolien | -29% |
| Knoblauchschälen | -22% |
Lektion: Validieren Sie Fine-Tuning immer auf Cluster-Ebene, nicht nur global.
Strategien nach der Bereitstellung
Risikominderung: Vermeiden Sie die Bewerbung von Produkten in Clustern mit niedrigen Bewertungen, bis sich die Modelle verbessern.
Human-in-the-Loop: Leiten Sie schlecht performende Abfragen an menschliche Agenten weiter.
Modell-Routing: Wechseln Sie Modelle dynamisch basierend auf der Cluster-Leistung (z. B. SBERT für bestimmte Abfragetypen verwenden).
Integration von TDA mit Zilliz Cloud und Milvus
Zilliz Cloud und Milvus vereinfachen das Speichern und Abfragen von Embeddings. Durch die Anwendung von TDA-Clustering bieten sie verbesserte Sucheffizienz, Interaktivität und optimierte Ressourcenzuweisung. So kombinieren Sie es mit TDA:
Embeddings speichern
Validieren Sie Embeddings vor der Indexierung, um verschwendete Ressourcen zu reduzieren:
from pymilvus import connections, Collection

# Mit Zilliz Cloud verbinden

connections.connect(

    alias="default",

    uri="YOUR_CLUSTER_ENDPOINT",  # Beispiel: "https://your-cluster.zillizcloud.com"

    token="YOUR_API_KEY"

)

# Ihre Collection laden

collection = Collection("product_embeddings")

collection.load()
Mit TDA evaluieren und clustern
import pandas as pd

from sklearn.manifold import TSNE

import matplotlib.pyplot as plt

# Embeddings aus Zilliz laden

embeddings = collection.query(expr="", output_fields=["embedding"])

# Dimensionalität für die Visualisierung reduzieren

tsne = TSNE(n_components=2)

embeddings_2d = tsne.fit_transform(embeddings)

plt.scatter(embeddings_2d[:, 0], embeddings_2d[:, 1], c=cluster_labels)

plt.title("T-SNE Visualization of Query Clusters")

plt.show()
Warum Zilliz in TDA-Workflows überzeugt
Skalierbarkeit: Verarbeitet Milliarden von Vektoren, ideal für TDA im großen Maßstab.
Echtzeit-Einblicke: Cluster dynamisch aktualisieren, wenn neue Daten einströmen.
Nahtlose Integration: Python-SDKs und REST-APIs passen in bestehende Pipelines.
Für tiefere Einblicke lesen Sie den Leitfaden zu Vektordatenbanken von Zilliz.
Best Practices für die Entwicklung von Embedding-Modellen
Lokal validieren: Testen Sie Modelle mit Ihren Daten, anstatt sich ausschließlich auf Benchmarks zu verlassen.
TDA früh einführen: Integrieren Sie navigierbares Clustering, um Probleme während des Prototypings zu erkennen.
Nach dem Deployment überwachen: Nutzen Sie die Tools von Zilliz Cloud, um die Clusterleistung kontinuierlich zu verfolgen.
Q&A: Wichtige Fragen aus dem Webinar
Während des Webinars haben wir mehrere Fragen erhalten. Nachfolgend finden Sie einige der am häufigsten gestellten Fragen sowie die Antworten von Gunnar und Gabriel:
F: Was hat Sie beim Anwenden von TDA-Clustering am meisten überrascht?
Fine-Tuning verschlechterte in unserer Fallstudie die Leistung bei 30-40% der Cluster. Beispielsweise schnitten Anfragen im Zusammenhang mit Espressomaschinen nach dem Tuning deutlich schlechter ab. Noch kritischer: Im E-Commerce könnte eine einzelne Anfrage ein Produkt im Wert von 20 $ repräsentieren. Wenn Ihr Modell hier versagt, ist das ein echter Umsatzverlust.
F: Haben Sie Fine-Tuning von Retrieval-Modellen im Vergleich zu Embedding-Modellen untersucht?
Ja! In RAG-Setups haben wir TDA verwendet, um mehrdeutige Anfragen in unterschiedliche Cluster aufzuteilen. Beispielsweise trennt TDA bei der Anfrage ‘tell me about the draft’ die Ergebnisse in Cluster für NBA draft und military draft. Dies hilft Retrieval-Modellen, Kontext zu priorisieren und irrelevante Ergebnisse zu vermeiden.
F: Wie schneidet TDA im Vergleich zu Methoden wie DBSCAN ab?
TDA bietet Flexibilität durch navigierbare Hyperparameter. Traditionelle Methoden wie DBSCAN arbeiten mit festen Datenkarten. Mit TDA passen Sie die „Kartenauflösung“ an, ähnlich wie beim Wechsel zwischen geografischen Projektionen, um lokale Minima zu isolieren (z. B. leistungsschwache Anfrage-Cluster).
F: Wie stehen Sie zu abfrageabhängigen Embedding-Modellen?
Die Topologie-Kartierung von TDA ergänzt diesen Trend auf natürliche Weise. Beispielsweise zeigen Sparse-Autoencoder-Features von Modellen wie OpenAI Cluster auf, die traditionelle Methoden übersehen. Ein Fall teilt „rules“ in Cluster für compliance vs. breaking rules auf und zeigt, wie Embeddings sich an den Abfragekontext anpassen können.
F: Wie können Teams mit TDA beginnen?
Probieren Sie das Python-Paket Cobalt aus, indem Sie pip install cobalt-ai ausführen, und erkunden Sie die Dokumentation sowie Ressourcen auf GitHub und Slack, um Unterstützung bei der Fehlerbehebung zu erhalten. Dieses Paket vereinfacht die Integration von TDA-Clustering in bestehende Workflows. Es verarbeitet 100K Anfragen in wenigen Minuten und lässt sich in Zilliz integrieren.
Fazit
Das Webinar bot einen umfassenden Überblick darüber, wie TDA-Clustering die Bewertung von Embedding-Modellen verändern kann. Indem es detaillierte Leistungsaufschlüsselungen durch navigierbares Clustering sichtbar macht, können Teams die Modellauswahl optimieren, die Ressourcenzuweisung verbessern und Nutzererlebnisse steigern. In Kombination mit Zilliz Cloud oder Milvus führen diese Erkenntnisse zu:
Transparenz: Verborgene Schwächen in Embeddings aufdecken.
Präzision: Modelle mit granularen Leistungseinblicken bereitstellen.
Kosteneinsparungen: Verschwendete Rechen- und Speicherressourcen reduzieren.
Entdecken Sie Zilliz Cloud , um noch heute intelligenter mit dem Clustering zu beginnen.
Vollständige Webinar-Aufzeichnung und Folien ansehen
Sie können sich die Webinar-Aufzeichnung auf dem YouTube-Kanal von Zilliz ansehen und auf die Präsentationsfolien zugreifen, um weitere Einblicke in Topological Data Analysis (TDA)-Clustering und die Diskussion zwischen Gunnar und Gabriel zu erhalten.
Verwandte Ressourcen
Weiterlesen
What Is a Vector Lakebase?
A Vector Lakebase is a unified, lake-native data architecture for AI that combines vector-database-grade serving with open lake storage, reusable lake-level indexes, and a shared semantic layer.
Top 10 Context Engineering Techniques You Should Know for Production RAG
A practical guide to context engineering for production LLM systems, covering RAG, context processing, memory, agents, and multimodal context.
Zilliz Cloud Now Available in Azure North Europe: Bringing AI-Powered Vector Search Closer to European Customers
The addition of the Azure North Europe (Ireland) region further expands our global footprint to better serve our European customers.