




Изучение DSPy и его интеграции с Milvus для создания высокоэффективных RAG-конвейеров
Введение
Большие языковые модели (LLMs) обладают преобразующими генеративными возможностями и дополняются такими инструментами, как базы знаний и ретриверы, что способствует развитию продвинутых GenAI-приложений, таких как чат-боты и agents. Центральное место во взаимодействии с LLM занимают промпты — инструкции, которые направляют эти модели на выполнение конкретных задач. Однако создание эффективных промптов — это тонкий и сложный процесс, часто требующий продвинутых техник, таких как Chain-of-Thought и ReAct. С учетом этого промпты становятся все более и более сложными. Более того, даже идентичные промпты могут давать различные результаты в разных LLM, таких как GPT-4 и Gemini, из-за различий в их методах предварительного обучения и наборах данных. Эта проблема вызвала всплеск интереса к Prompt Engineering — трудоемкой задаче, сосредоточенной на настройке и оптимизации промптов для получения более качественных и адаптированных результатов.
Хотя ручное создание промптов хорошо работает для простых LLM-приложений, оно становится раздражающим и затратным по времени для сложных конвейеров на основе LLM, включающих несколько компонентов. DSPy представляет собой смену парадигмы в том, как разработчики взаимодействуют с языковыми моделями, вводя программируемый интерфейс, который обеспечивает алгоритмическую оптимизацию промптов и весов модели, что приводит к более эффективной разработке языковых моделей. DSPy бесшовно интегрировал векторную базу данных Milvus, автоматизируя оптимизацию приложений Retrieval Augmented Generation (RAG) с помощью программного подхода.
В следующих разделах мы рассмотрим суть DSPy и механизмы его работы, а также приведем практический пример, демонстрирующий, как создать и оптимизировать RAG-приложение с использованием DSPy и векторной базы данных Milvus.
Что такое DSPy?
DSPy, представленный Stanford NLP Group, — это программный фреймворк, предназначенный для оптимизации промптов и весов в языковых моделях, что особенно полезно, когда LLM интегрированы на нескольких этапах конвейера. Он предоставляет различные компонуемые и декларативные модули для инструктирования LLM в синтаксисе Pythonic.
В отличие от традиционных техник prompt engineering, которые полагаются на ручное создание и настройку промптов, DSPy обучается на примерах запрос-ответ и имитирует это обучение, чтобы генерировать оптимизированные промпты для более адаптированных результатов. Такой подход позволяет динамически пересобирать весь конвейер, явно адаптируя его к нюансам вашей задачи, тем самым устраняя необходимость в постоянной ручной корректировке промптов.
Ключевые понятия и фундаментальные компоненты
В DSPy три базовых элемента — Signatures, Modules и Optimizers (ранее называвшиеся Teleprompters) — образуют основные строительные блоки для автоматизированной оптимизации промптов и тонкой настройки модели.
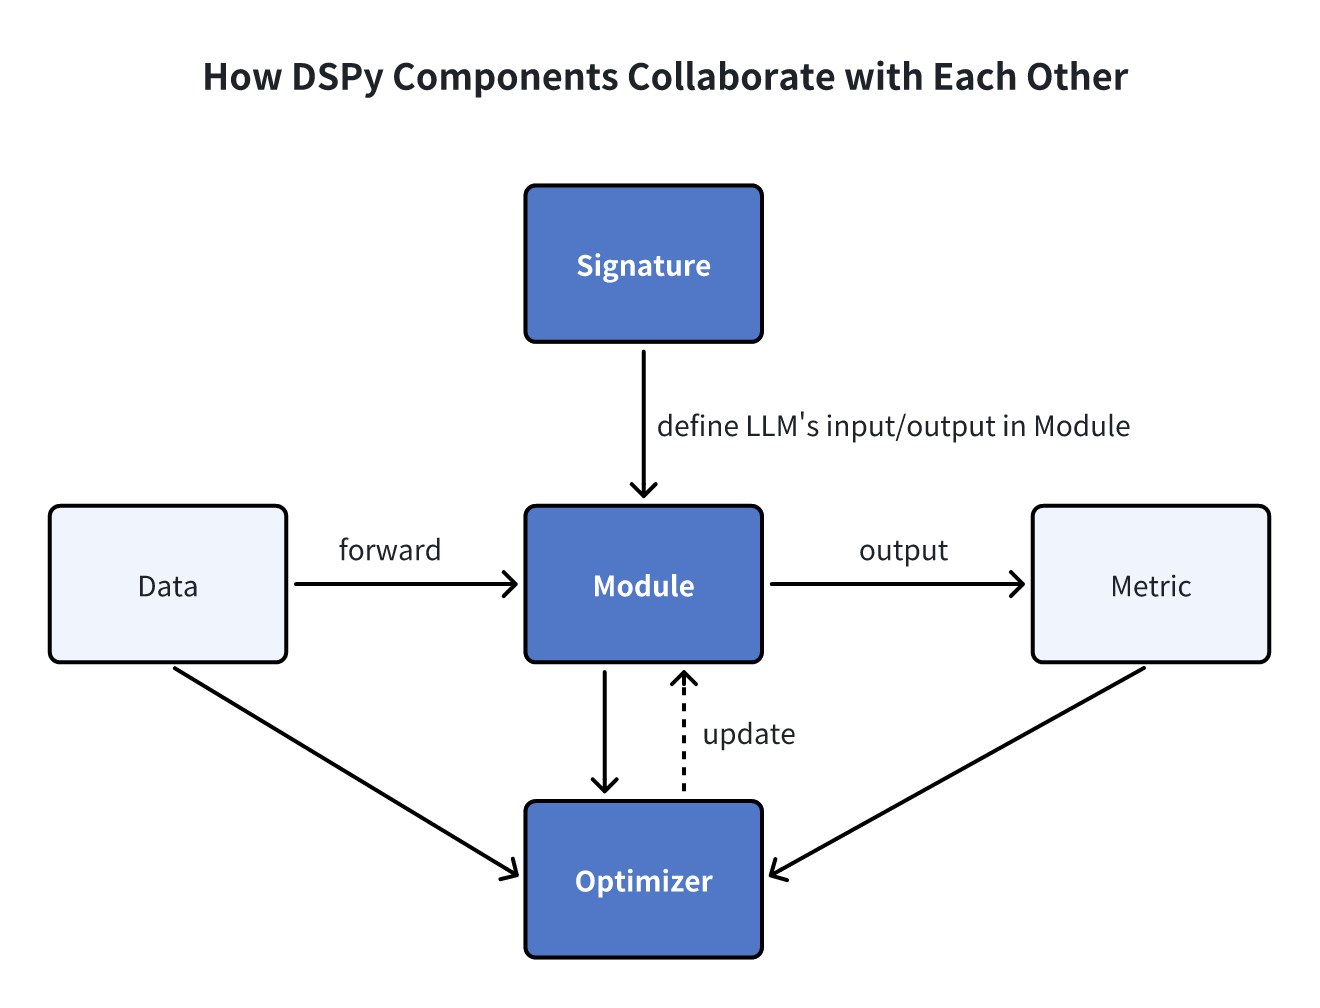
Signatures
Signatures — это декларативные спецификации, определяющие поведение ввода/вывода модуля DSPy. Они сообщают языковой модели, какие задачи она должна выполнять, а не то, как мы должны формулировать промпт для языковой модели.
- Сигнатура включает три ключевых элемента:
- Краткое описание подзадачи, которую языковая модель стремится решить.
- Описание одного или нескольких входных полей (например, входных вопросов), которые мы передаём языковой модели.
- Описание одного или нескольких выходных полей (например, ответов на вопросы), которые мы ожидаем от языковой модели.
Вот примеры сигнатур для популярных задач LLM:
- Ответы на вопросы:
"question -> answer" - Классификация тональности:
"sentence -> sentiment" - Ответы на вопросы с дополнением извлеченной информации:
"context, question -> answer" - Ответы на вопросы с несколькими вариантами выбора и рассуждением:
"question, choices -> reasoning, selection"
Эти сигнатуры помогают DSPy эффективно организовывать операции LLM в различных модулях, обеспечивая упрощённое и точное выполнение задач.
Модули
Модули DSPy абстрагируют традиционные техники prompting в рамках LLM pipeline. Они имеют три ключевые характеристики:
- Каждый встроенный модуль абстрагирует конкретную технику prompting (например, Chain of Thoughts или ReAct) и обрабатывает сигнатуры DSPy.
- Модули DSPy имеют обучаемые параметры, включая компоненты prompt и веса LLM, что позволяет им обрабатывать входные данные и генерировать выходные данные.
- Модули DSPy можно объединять для создания более крупных и сложных модулей.
- DSPy предоставляет семь встроенных модулей для различных целей, включая
dspy.ReAct,dspy.ChainofThought,dspy.Predict,dspy.ProgramOfThought,dspy.ReAct,dspy.MultiChainComparisonиdspy.Retrieve.
Оптимизаторы
Оптимизаторы DSPy, ранее Teleprompters, — это алгоритмы, разработанные для тонкой настройки параметров программы DSPy — таких как prompts и веса LLM — с целью максимизации заданных метрик, например точности. Типичному оптимизатору DSPy требуются три входных элемента:
Ваша программа DSPy: может быть одним модулем (например,
dspy.Predict) или сложной многомодульной программой.Выбранная вами метрика: функция, которая оценивает выходные данные программы и присваивает им оценку (более высокие оценки означают лучшие результаты).
Небольшой набор обучающих входных данных: часто всего 5–10 примеров.
После того как вы определите обучающие данные, модули и метрики, оптимизатор оптимизирует веса LLM, инструкции prompt и few-shot demonstrations для повышения эффективности программы. Например, оптимизатор BootstrapFewShot генерирует ответы, которые соответствуют заданной метрике, а такие модули, как COT (Chain of Thought), генерируют структурированные рассуждения для получения точных ответов. DSPy записывает эти успешные экземпляры и обоснования как few-shot demonstrations для обработки будущих тестовых запросов.
В дополнение к основным строительным блокам, упомянутым выше, DSPy включает данные, метрики и assertions в качестве дополнительных компонентов, расширяя его функциональность и адаптивность. Обратитесь к документации DSPy для получения более подробной информации.
Рабочие процессы DSPy: создание эффективных LLM pipelines
Как именно DSPy функционирует при построении LLM pipelines? Для ясности мы можем разбить процесс на несколько ключевых шагов.
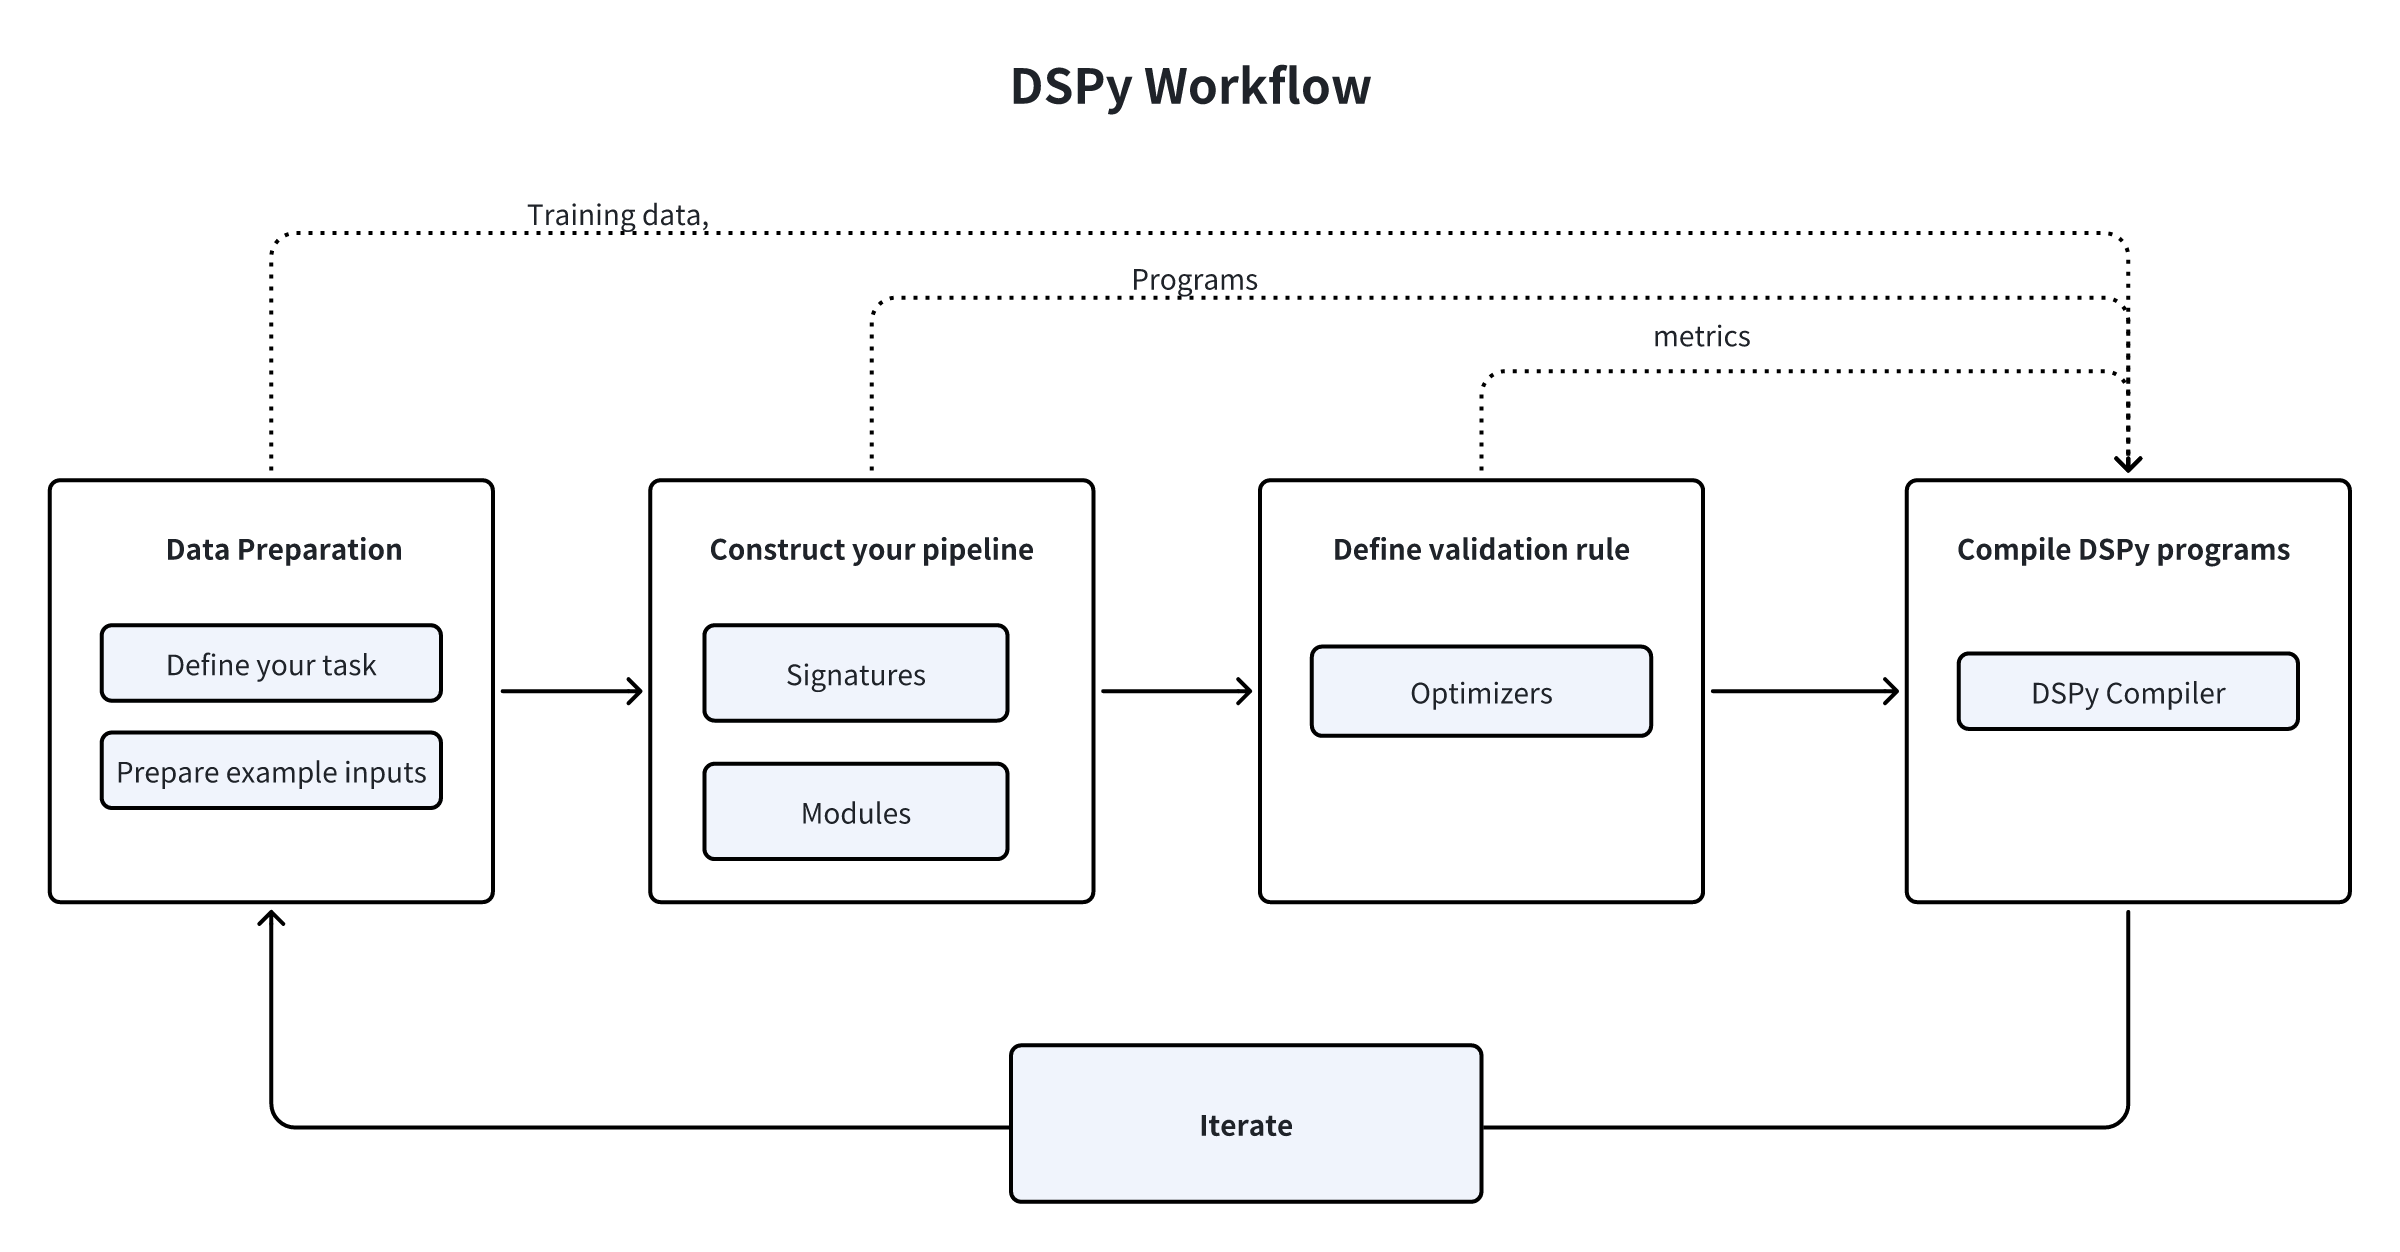
- Во-первых, вы должны определить свою задачу и подготовить несколько примеров входных данных — часто без меток (или только с метками для финальных выходных данных, если ваша метрика этого требует).
- Во-вторых, постройте свой пайплайн, выбрав встроенные модули, назначив каждому модулю сигнатуру (спецификацию входа/выхода) и бесшовно включив эти модули в свой Python-код.
- В-третьих, определите логику валидации для своего пайплайна, включая то, какие метрики и примеры входных данных использовать для оценки качества промптов и финальных результатов.
- В-четвертых, скомпилируйте свой код с помощью оптимизатора DSPy, который генерирует высококачественные инструкции, автоматические few-shot примеры или обновленные веса LLM.
- Наконец, включитесь в итеративный процесс уточнения вашего набора данных, программы или логики валидации, чтобы достичь желаемого уровня производительности вашего пайплайна. Постоянно оценивайте и улучшайте, чтобы соответствовать меняющимся требованиям и оптимизировать результаты.
DSPy vs. LlamaIndex/LangChain/AutoGPT
DSPy выделяется своим подходом по сравнению со многими другими популярными AI-фреймворками, такими как LangChain, LlamaIndex и AutoGPT. Рассмотрим подробнее, чем они отличаются и в чем совпадают:
LangChain — это инструментарий для создания кастомизированных приложений. Он использует различные языковые модели и утилитарные пакеты, позволяя разработчикам адаптировать приложения под конкретные потребности.
LlamaIndex — это оркестрационный фреймворк, предназначенный для упрощения интеграции различных приватных источников данных с языковыми моделями. Он упрощает задачи обработки данных и работы с ними.
AutoGPT — это продвинутый AI-агент на базе GPT-4 и GPT3.5. Он запрограммирован принимать решения и выполнять действия на основе предопределенных правил и целей. Он делает акцент на автономности и возможностях принятия решений.
Отличительные особенности DSPy:
- DSPy оптимизирует и автоматизирует построение промптов для улучшенного взаимодействия с языковыми моделями.
- В отличие от LangChain и LlamaIndex, которые ориентированы на разработку приложений высокого уровня с предустановленными модулями, DSPy предоставляет мощные модули общего назначения, способные обучаться формулировать промпты или дообучать LLM в рамках кастомных пайплайнов. Сила DSPy заключается в его способности динамически адаптировать промпты и дообучать LLM на основе меняющихся данных, корректировок потока управления программы или вариаций целевого языка. Этот автоматизированный процесс оптимизации может приводить к результатам превосходного качества с минимальными усилиями, особенно когда разработчики готовы масштабировать свои простые или прототипные программы в более сложные решения для production-использования.
- DSPy идеально подходит для сценариев использования, требующих легковесной, но автоматически оптимизируемой программной модели, вместо опоры на предопределенные промпты и интеграции, предлагаемые библиотеками вроде LangChain и LlamaIndex.
Интеграция DSPy с векторной базой данных Milvus
Milvus — это чрезвычайно гибкая, надежная и молниеносно быстрая cloud-native векторная база данных с открытым исходным кодом. Она обеспечивает векторный поиск по сходству и особенно полезна при создании различных GenAI- и Retrieval Augmented Generation (RAG)-приложений.
Milvus интегрирован в workflow DSPy как модуль извлечения в форме клиента MilvusRM, что упрощает реализацию быстрого и эффективного RAG-пайплайна.
Создание RAG-приложения с DSPy и Milvus
Retrieval Augmented Generation (RAG) — это метод, который позволяет LLM получать доступ к внешним хранилищам знаний, выполнять поиск в этих хранилищах контекстной информации, релевантной пользовательским запросам, и генерировать уточненные ответы.
В этой демонстрации мы создадим простое приложение RAG, используя GPT-3.5 (gpt-3.5-turbo) для генерации ответов. Мы используем Milvus в качестве векторного хранилища через MilvusRM и DSPy для настройки и оптимизации конвейера RAG.
Предварительные требования
Перед созданием приложения RAG установите клиент MilvusRM и Milvus.
- Чтобы установить MilvusRM, выполните следующий код.
pip install dspy-ai[milvus]
- Установите Milvus. Подробные инструкции см. в документации Milvus.
Загрузка набора данных
В этом примере мы используем HotPotQA, набор сложных пар «вопрос-ответ», в качестве нашего обучающего набора данных. Мы можем загрузить их через класс HotPotQA.
from dspy.datasets import HotPotQA

# Load the dataset.
dataset = HotPotQA(train_seed=1, train_size=20, eval_seed=2023, dev_size=50, test_size=0)

# Tell DSPy that the 'question' field is the input. Any other fields are labels and/or metadata.
trainset = [x.with_inputs('question') for x in dataset.train]
devset = [x.with_inputs('question') for x in dataset.dev]
Импорт данных в векторную базу данных Milvus
Загрузите контекстную информацию в коллекцию Milvus для векторного поиска. Эта коллекция должна иметь поле embedding и поле text. В данном случае мы используем модель OpenAI text-embedding-3-small в качестве функции встраивания запросов по умолчанию.
import requests
MILVUS_URI = "http://localhost:19530"
MILVUS_TOKEN = ""

from pymilvus import MilvusClient, DataType, Collection
from dspy.retrieve.milvus_rm import openai_embedding_function

client = MilvusClient(
   uri=MILVUS_URI,
   token=MILVUS_TOKEN
)

if 'dspy_example' not in client.list_collections():
   client.create_collection(
      collection_name="dspy_example",
       overwrite= True,
       dimension=1536,
       primary_field_name="id",
       vector_field_name="embedding",
       id_type="int",
       metric_type="IP",
       max_length=65535,
       enable_dynamic=True
   )
text = requests.get('https://raw.githubusercontent.com/wxywb/dspy_dataset_sample/master/sample_data.txt').text

for idx, passage in enumerate(text.split('\n')):
   if len(passage) == 0:
       continue
   client.insert(collection_name="dspy_example", data = [{"id": idx , "embedding": openai_embedding_function(passage)[0], "text": passage}])
Определение MilvusRM.
Теперь вам нужно определить MilvusRM.
from dspy.retrieve.milvus_rm import MilvusRM
import os
import dspy

os.environ["OPENAI_API_KEY"] = "<YOUR_OPENAI_API_KEY>"

retriever_model = MilvusRM(
   collection_name="dspy_example",
   uri=MILVUS_URI,
   token=MILVUS_TOKEN,  # ignore this if no token is required for Milvus connection
   embedding_function = openai_embedding_function
   )
turbo = dspy.OpenAI(model='gpt-3.5-turbo')
dspy.settings.configure(lm=turbo)
Создание сигнатур
Теперь, когда мы загрузили данные, давайте начнем определять сигнатуры для подзадач нашего конвейера. Мы можем определить наш простой вход question и выход answer, но поскольку мы создаем конвейер RAG, мы будем извлекать контекстную информацию из Milvus. Поэтому давайте определим нашу сигнатуру как context, question --> answer.
class GenerateAnswer(dspy.Signature):
   """Answer questions with short factoid answers."""

   context = dspy.InputField(desc="may contain relevant facts")
   question = dspy.InputField()
   answer = dspy.OutputField(desc="often between 1 and 5 words")
Мы включаем краткие описания для полей context и answer, чтобы определить более четкие указания о том, что модель получит и что должна сгенерировать.
Создание конвейера
Теперь давайте определим конвейер RAG.
class RAG(dspy.Module):
   def __init__(self, rm):
       super().__init__()
       self.retrieve = rm

# This signature indicates the task imposed on the COT module.
       self.generate_answer = dspy.ChainOfThought(GenerateAnswer)

   def forward(self, question):
       # Используйте milvus_rm для извлечения контекста для вопроса.
       context = self.retrieve(question).passages
       # Модуль COT принимает "context, query" и выводит "answer".
       prediction = self.generate_answer(context=context, question=question)
       return dspy.Prediction(context=[item.long_text for item in context], answer=prediction.answer)
Выполнение pipeline и получение результатов
Теперь мы построили этот RAG pipeline. Давайте попробуем его и получим результаты.
rag = RAG(retriever_model)
print(rag("who write At My Window").answer)

# Результат:
# 'Townes Van Zandt'
Мы можем оценить количественные результаты на датасете.
from dspy.evaluate.evaluate import Evaluate
from dspy.datasets import HotPotQA

evaluate_on_hotpotqa = Evaluate(devset=devset, num_threads=1, display_progress=False, display_table=5)

metric = dspy.evaluate.answer_exact_match
score = evaluate_on_hotpotqa(rag, metric=metric)
print('rag:', score)

# Результат:
# rag: 50.0
Оптимизация pipeline
После определения этой программы следующий шаг — компиляция. Этот процесс обновляет параметры внутри каждого модуля для повышения производительности. Процесс компиляции зависит от трех критически важных факторов:
- Обучающая выборка: Для этой демонстрации мы будем использовать 20 примеров вопросов и ответов из нашего обучающего датасета.
- Метрика валидации: Мы установим простую метрику
validate_context_and_answer. Эта метрика проверяет точность предсказанного ответа и убеждается, что извлеченный контекст включает ответ. - Конкретный оптимизатор (Teleprompter): Компилятор DSPy включает несколько teleprompter, предназначенных для эффективной оптимизации ваших программ.
from dspy.teleprompt import BootstrapFewShot

# Логика валидации: проверить, что предсказанный ответ правильный.
# Также проверить, что извлеченный контекст действительно содержит этот ответ.
def validate_context_and_answer(example, pred, trace=None):
   answer_EM = dspy.evaluate.answer_exact_match(example, pred)
   answer_PM = dspy.evaluate.answer_passage_match(example, pred)
   return answer_EM and answer_PM

# Настройте базовый teleprompter, который скомпилирует нашу программу RAG.
teleprompter = BootstrapFewShot(metric=validate_context_and_answer)

# Компилируем!
compiled_rag = teleprompter.compile(rag, trainset=trainset)

# Теперь compiled_rag оптимизирован и готов ответить на ваш новый вопрос!
Теперь давайте оценим скомпилированную программу RAG.
score = evaluate_on_hotpotqa(compiled_rag, metric=metric)
print(score)
print('compile_rag:', score)

# Результат:
# compile_rag: 52.0
Оценка увеличилась с предыдущего значения 50.0 до 52.0, что указывает на улучшение качества ответов.
Резюме
DSPy знаменует собой скачок во взаимодействии с языковыми моделями благодаря своему программируемому интерфейсу, который облегчает алгоритмическую и автоматизированную оптимизацию prompts и весов моделей. Использование DSPy для реализации RAG позволяет легко адаптироваться к различным языковым моделям или датасетам, значительно снижая необходимость в утомительных ручных вмешательствах.
Более того, DSPy внедряет модуль извлечения MilvusRM в свой рабочий процесс путем интеграции векторной базы данных Milvus. Благодаря этой новой интеграции разработчики могут автоматизировать оптимизацию prompts и настройку параметров модели в приложениях RAG для повышения качества ответов. Если вы хотите узнать больше, ознакомьтесь с подробным руководством по MilvusRM в документации DSPy!
Ссылки
Страница DSPy на GitHub: https://github.com/stanfordnlp/dspy
Статья DSPy: https://arxiv.org/pdf/2310.03714
Документация DSPy: https://dspy-docs.vercel.app/quick-start/installation/
Руководство по MilvusRM: https://dspy-docs.vercel.app/docs/deep-dive/retrieval_models_clients/MilvusRM
Документация Milvus: https://milvus.io/docs
Читать далее
How to Migrate from Chroma to Zilliz Cloud
Chroma Cloud goes read-only on November 22. Move your collections to Zilliz Cloud, from Chroma Cloud or self-hosted Chroma, and update your app.
Expanding Our Global Reach: Zilliz Cloud Launches in Azure Central India
Zilliz Cloud expands to Azure Central India. This new region helps customers meet compliance, reduce latency, and optimize cloud costs when building AI applications.
1 Table = 1000 Words? Foundation Models for Tabular Data
TableGPT2 automates tabular data insights, overcoming schema variability, while Milvus accelerates vector search for efficient, scalable decision-making.