Демократизация ИИ: делаем векторный поиск мощным и доступным
За последние несколько лет вы, вероятно, слышали, как мы говорили о «демократизации ИИ» — особенно когда речь идет о векторном поиске. Но что мы на самом деле имеем в виду?
В Zilliz мы твердо убеждены: чтобы ИИ действительно процветал, такие важнейшие инструменты, как продвинутые векторные базы данных, должны быть доступны разработчикам. Эти инструменты раскрывают ценные инсайты из огромных объемов неструктурированных данных, расширяя возможности приложений в разных отраслях.
Мы понимаем — бюджеты ограничены. Ваша финансовая команда не раздает чистые чеки на новые технологии. Именно поэтому сделать векторный поиск не только мощным, но и экономически эффективным — один из наших главных приоритетов. Чем ниже стоимость поиска, тем больше вы можете с ним сделать — будь то более точные рекомендации, масштабирование конвейеров retrieval-augmented generation (RAG) или просто запуск большего числа рабочих нагрузок без лишних расходов.
Именно здесь вступает в силу экономический принцип под названием парадокс Джевонса. Впервые описанный в XIX веке, он объясняет, как повышение эффективности использования ресурса — например угля, электричества или, в нашем случае, вычислительных ресурсов — может фактически увеличить его общее потребление. Когда векторный поиск становится более доступным по цене и проще в использовании, команды могут проводить больше экспериментов, расширять сценарии применения и в итоге обрабатывать больше данных. Короче говоря: снижение стоимости открывает путь к более широкому использованию.
В Zilliz Cloud мы предлагаем гибкие тарифные планы, созданные под ваш бюджет и потребности использования. От по-настоящему serverless-варианта с оплатой по мере использования до выделенных кластеров в трех ценовых уровнях — вы можете выбрать то, что лучше всего подходит для ваших приложений, и уверенно наращивать рабочие нагрузки.
Но демократизация — это не только коммерческие предложения. Мы знаем, что иногда open-source-версия является основой для многих проектов. Именно поэтому наш последний релиз, Milvus 2.6, предлагает одно из самых экономически эффективных решений для векторных баз данных на рынке — сокращая затраты на инфраструктуру, операции и время разработчиков, чтобы вы могли масштабировать приложения, не масштабируя счета.
Milvus 2.6: создан для масштабирования, спроектирован для снижения затрат
Сегодня мы запускаем Milvus 2.6, продолжая нашу миссию сделать ИИ более доступным за счет снижения стоимости решений для векторных данных, фокусируясь на трех измерениях экономии: денежная экономия, операционная эффективность и время разработчиков.
Как Milvus 2.6 помогает вам экономить деньги
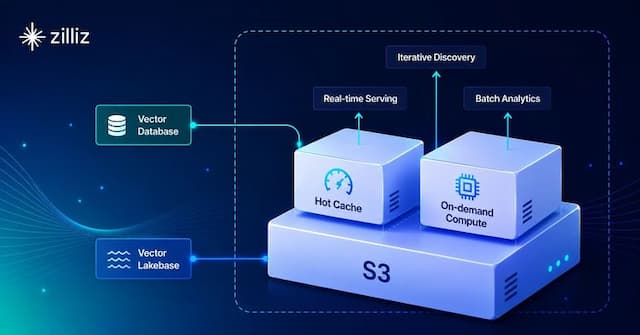
Milvus 2.6 представляет несколько инноваций для снижения затрат. Многоуровневое хранение с разделением горячих/холодных данных автоматически перемещает часто используемые векторы в высокопроизводительное хранилище и архивирует менее используемые данные в более экономичных местах — снижая стоимость хранения без ущерба для скорости извлечения. Оно бесшовно работает с такими провайдерами, как Cohesity, Pure Storage, MinIO и NetApp.
Сжатие векторов Int8 и квантование RabitQ значительно снижают требования к памяти, сохраняя высокую точность. Woodpecker Write-Ahead Log (WAL) устраняет необходимость в очередях сообщений вроде Kafka или Pulsar, предлагая бездисковую архитектуру, которая повышает скорость записи и одновременно снижает расходы на инфраструктуру.
Делая операции проще и дешевле
Milvus 2.6 упрощает управление инфраструктурой с помощью нескольких новых функций. Streaming Node обеспечивает прием данных в реальном времени без внешних очередей сообщений. CDC + BulkInsert упрощает межрегиональную репликацию, а Storage v2 Format и нативная поддержка пакетов APT/YUM снижают операционные накладные расходы, делая установки и обновления проще и надежнее.
Экономия времени разработчиков с помощью встроенных инструментов
Milvus 2.6 повышает продуктивность благодаря большему количеству возможностей «из коробки». Data-In, Data-Out позволяет напрямую загружать необработанный текст, изображения и аудио со встроенным инференсом — без необходимости в пайплайне предварительной обработки. Custom Reranker позволяет применять собственную логику со скалярными полями и UDF. Встроенный Text & JSON Search поддерживает расширенную токенизацию (например, для японского/корейского языков), индексирование JSON-путей и запросы match/phrase. Наконец, sampling and aggregation queries помогают быстро анализировать данные и быстрее итерироваться во время разработки.
Открытый исходный код, прозрачность и доверие
Milvus полностью открыт под либеральной лицензией Apache 2.0. Никаких «черных ящиков» — разработчики и организации могут настраивать, аудировать и вносить вклад по мере необходимости.
Milvus стал одной из самых широко используемых векторных баз данных в мире, обеспечивая работу AI-приложений в масштабе для более чем 10 000 организаций. Но такой импульс возможен только благодаря невероятному сообществу, стоящему за ним.
Чтобы отметить ваш вклад, мы недавно запустили Milvus Ambassador Program — способ выделить разработчиков, которые создали что-то впечатляющее и хотят поделиться этим с более широким сообществом.
В своей основе мы — группа разработчиков, которые верят в прозрачность: в то, чтобы делиться хорошим, плохим и всем тем непростым, что между ними. Мы не идеальны и не притворяемся таковыми. Мы учимся, создавая, ломая и помогая друг другу расти — и именно это позволяет этому сообществу процветать.
Готовы попробовать экономически эффективный векторный поиск?
Независимо от того, только ли вы начинаете или хотите масштабировать свои AI-приложения, Zilliz Cloud и Milvus 2.6 предлагают инструменты, которые делают векторный поиск мощным, доступным и масштабируемым. У нас есть множество ресурсов, созданных командой: от нашей документации, bootcamps и tutorials. Мы также предлагаем бесплатные частные office hours, чтобы помочь вам с любыми вашими вопросами, или вы можете присоединиться к команде в нашем канале Discord.
Приходите строить вместе с нами, и давайте вместе воплотим эту магию.
Читать далее
DeepSeek-OCR Explained: Optical Compression for Scalable Long-Context and RAG Systems
Discover how DeepSeek-OCR uses visual tokens and Contexts Optical Compression to boost long-context LLM efficiency and reshape RAG performance.

Introducing Zilliz MCP Server: Natural Language Access to Your Vector Database
Developers can easily manage and query vector databases with natural language via Zilliz MCP Server in AI-native environments.
Similarity Metrics for Vector Search
Exploring five similarity metrics for vector search: L2 or Euclidean distance, cosine distance, inner product, and hamming distance.