




Развенчиваем заблуждения о скорости вставки данных в Milvus
Многие пользователи, полагающиеся на LangChain или LlamaIndex из-за их удобных и более коротких шагов API, могут думать, что «Вставка данных в Milvus медленная». Однако такое восприятие часто возникает из-за поверхностного рассмотрения подробных этапов процесса.
Скрытые шаги
При использовании LangChain или LlamaIndex эти библиотеки преобразуют неструктурированные данные (например, тексты, изображения или звуки) в векторы с помощью моделей эмбеддингов. Затем они вставляют эти векторы в Milvus Lite. Библиотеки упрощают этот сложный процесс, выполняя за вас множество шагов за кулисами.
Эта абстракция может создавать иллюзию, что процесс вставки данных занимает много времени.
Пожиратель времени: генерация эмбеддингов
Среднее время, затрачиваемое на генерацию эмбеддингов из неструктурированных данных, значительно превышает время, необходимое для вставки данных в Milvus. Воспринимаемая медлительность часто связана с вычислительно интенсивным процессом преобразования данных в векторные представления, а не с этапом вставки данных.
Чтобы проиллюстрировать разницу между временем генерации эмбеддингов и временем вставки данных, я покажу пример в этом блоге, где среднее время эмбеддинга составляет примерно 5 секунд. Напротив, среднее время вставки в векторную базу данных Milvus составляет всего около одной десятой секунды. Полный код находится на моем GitHub.
Другими словами, около 97% времени "вставки Milvus", наблюдаемого в LangChain или LlamaIndex, тратится на генерацию эмбеддингов, тогда как около 3% уходит на фактический этап вставки в базу данных.
В предыдущем блоге я показал, как подключиться к Milvus Lite с помощью LlamaIndex или LangChain.
В следующих разделах я рассмотрю:
Пример кода LlamaIndex для вставки данных в Milvus
Пример кода LangChain для вставки данных в Milvus
Пример кода Pymilvus API для вставки данных в Milvus
Пример кода LlamaIndex для вставки данных в Milvus
Вот пример кода в LlamaIndex.
from llama_index.core import (
   ServiceContext,
   StorageContext,
   VectorStoreIndex,
)
from llama_index.embeddings.huggingface import HuggingFaceEmbedding
from llama_index.vector_stores.milvus import MilvusVectorStore
import time

# Define the embedding model.
service_context = ServiceContext.from_defaults(
   # LlamaIndex local: translates to the same location as default HF cache.
   embed_model="local:BAAI/bge-large-en-v1.5",
)

# Create a Milvus collection from the documents and embeddings.
EMBEDDING_DIM = 1024
vectorstore = MilvusVectorStore(
   uri="./milvus_llamaindex.db",
   dim=EMBEDDING_DIM,
   # Override LlamaIndex default values for Milvus.
   consistency_level="Eventually",
   drop_old=True,
   index_params = {
       "metric_type": "COSINE",
       "index_type": "AUTOINDEX",
       "params": {},}
)
storage_context = StorageContext.from_defaults(
   vector_store=vectorstore
)
llamaindex = VectorStoreIndex.from_documents(
   lli_docs[:1],
   storage_context=storage_context,
   service_context=service_context
)
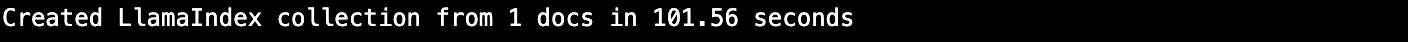
Пример кода LangChain для вставки данных в Milvus
Вот пример кода в LangChain.
from langchain_milvus import Milvus
from langchain_huggingface import HuggingFaceEmbeddings
from langchain.text_splitter import RecursiveCharacterTextSplitter
import time

# Define the embedding model.
model_name = "BAAI/bge-large-en-v1.5"
model_kwargs = {'device': 'cpu'}
encode_kwargs = {'normalize_embeddings': True}
embed_model = HuggingFaceEmbeddings(
   model_name=model_name,
   model_kwargs=model_kwargs,
   encode_kwargs=encode_kwargs
)
EMBEDDING_DIM = embed_model.dict()['client'].get_sentence_embedding_dimension()

# Define the chunking strategy.
text_splitter = RecursiveCharacterTextSplitter(chunk_size=512, chunk_overlap=51)

# Create a Milvus collection from the documents with chunking and embeddings.
start_time = time.time()
docs = text_splitter.split_documents(docs)
vectorstore = Milvus.from_documents(
   documents=docs,
   embedding=embed_model,
   connection_args={"uri": "./milvus_demo.db"},
   # Override LangChain default values for Milvus.
   consistency_level="Eventually",
   drop_old=True,
   index_params = {
       "metric_type": "COSINE",
       "index_type": "AUTOINDEX",
       "params": {},}
)

Пример кода Pymilvus API для вставки данных в Milvus
Используя вызовы Pymilvus API напрямую, покажем, что на самом деле происходит за кулисами этих коротких и удобных фрагментов кода LangChain и LlamaIndex.
В приведённых выше примерах использовались веб-страницы документации Milvus, загруженные напрямую из Интернета. Чтобы показать разницу между временем создания эмбеддингов и временем вставки, ниже я использую open-source мультимодальную модель эмбеддингов, чтобы 1) создавать эмбеддинги как для изображений, так и для текстов и 2) вставлять плотные векторы в Milvus.
import pymilvus
import requests
from io import BytesIO

# Run this in small batches to avoid memory issues.
BATCH_SIZE = 10

# Batch embed text and images and insert data into Milvus.
batch_embedding_times = []
batch_insert_times = []
for i in range(0, 300, BATCH_SIZE):
   batch_images = []
   batch_texts = []
   batch_urls = []
   for j in range(BATCH_SIZE):
       if i + j < len(image_texts):
           text = image_texts[i + j]
           url = image_urls[i + j]
           with Image.open(f"./images/{url}.jpg") as img:
               batch_images.append(img.copy())
               batch_texts.append(text)
               batch_urls.append(url)

   # STEP 1. EMBEDDING INFERENCE FOR TEXT AND IMAGES.
   start_time = time.time()
   image_embeddings, text_embeddings = embedding_model(
       batch_images=batch_images,
       batch_texts=batch_texts)
   end_time = time.time()
   # print(f"Embedding time for batch size {len(batch_images)}: ", end="")
   # print(f"{np.round(end_time - start_time, 2)} seconds")
   batch_embedding_times.append(end_time - start_time)

   # STEP 2. INSERT CHUNK LIST INTO MILVUS OR ZILLIZ.
   chunk_dict_list = []
   # Create chunk dict_list.
   for chunk, img_url, img_embed, text_embed in zip(
       batch_texts,
       batch_urls,
       image_embeddings, text_embeddings):
       chunk_dict = {
           'chunk': chunk,
           'image_filepath': img_url,
           'text_vector': text_embed,
           'image_vector': img_embed
       }
       chunk_dict_list.append(chunk_dict)

   start_time = time.time()
   try:
       col.insert(data=chunk_dict_list)
   except:
       print(f"Insert error: {img_url}")
   end_time = time.time()
   # print(f"Insert time for {len(chunk_dict_list)} vectors: ", end="")
   # print(f"{np.round(end_time - start_time, 4)} seconds")
   batch_insert_times.append(end_time - start_time)
   col.flush()

# Calculate the average embedding time.
average_time = np.mean(batch_embedding_times)
print(f"Average embedding time: {round(average_time,2)} seconds")

# Calculate the average insert time.
average_time = np.mean(batch_insert_times)
print(f"Average insert time: {round(average_time,2)} seconds")
Вот вывод времени пакетного создания эмбеддингов.
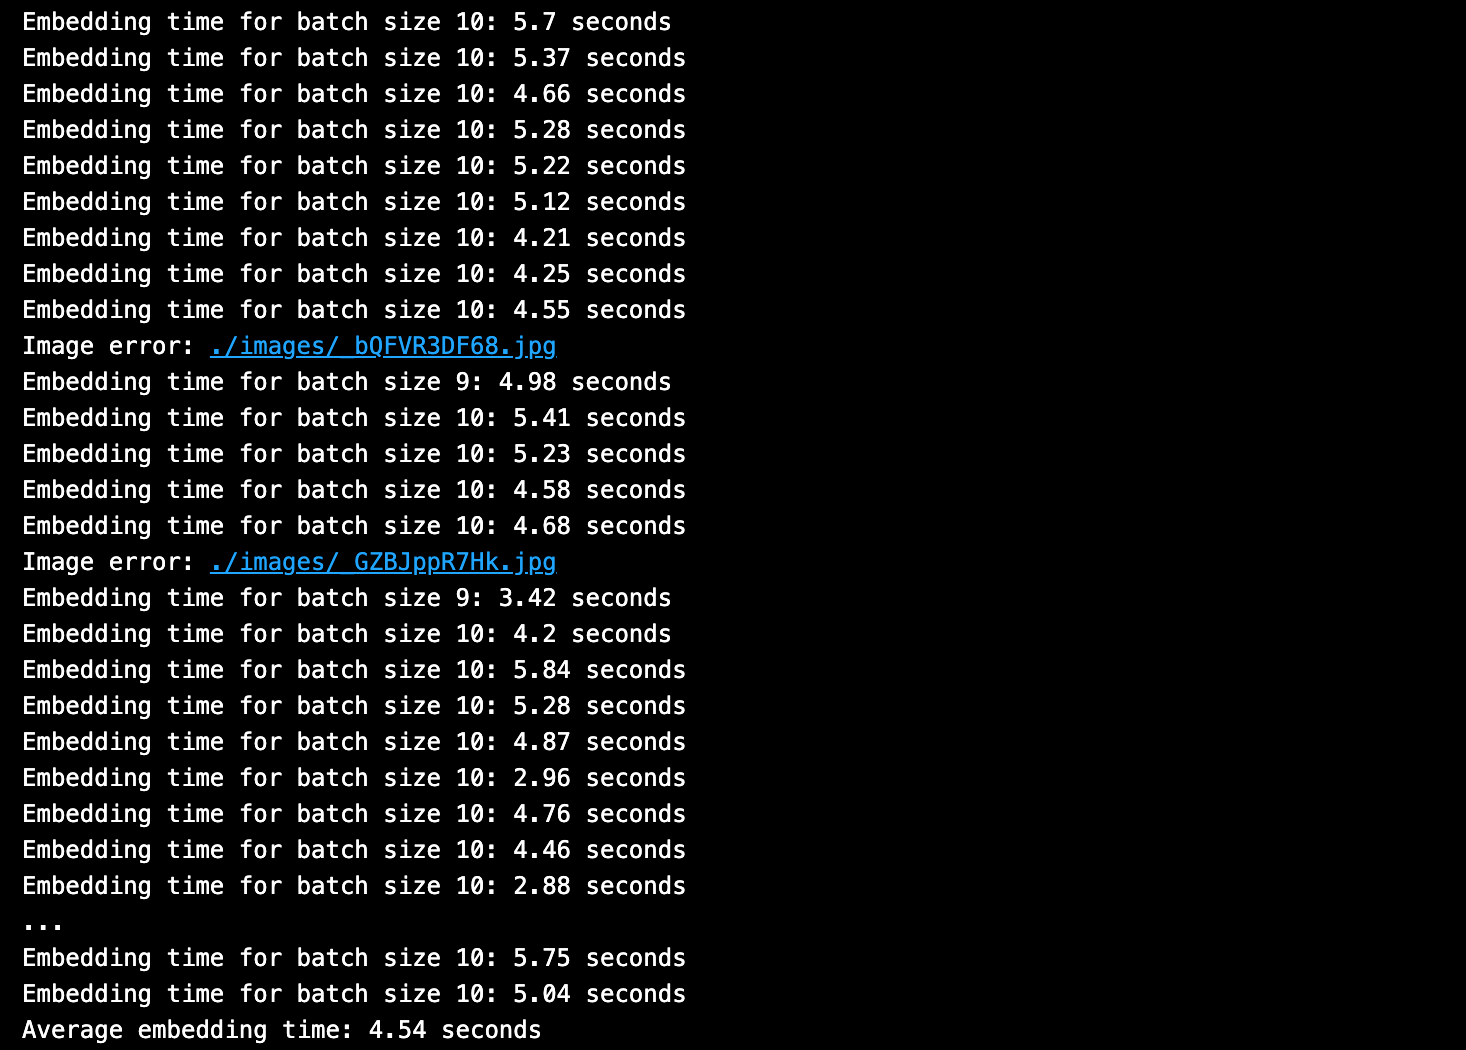
Вот вывод времени пакетной вставки данных в Milvus.

Среднее время создания эмбеддингов составило ~5 секунд, а среднее время вставки в векторную базу данных Milvus — около одной десятой секунды. Это означает, что около 97% общего времени было затрачено на генерацию эмбеддингов, тогда как около 3% — на вставку в базу данных.
Как видите, этап создания эмбеддингов занимает больше всего времени!
Ресурсы и дополнительная литература
Читать далее
What Is a Vector Lakebase?
A Vector Lakebase is a unified, lake-native data architecture for AI that combines vector-database-grade serving with open lake storage, reusable lake-level indexes, and a shared semantic layer.
Why Not All VectorDBs Are Agent-Ready
Explore why choosing the right vector database is critical for scaling AI agents, and why traditional solutions fall short in production.
DeepSeek Always Busy? Deploy It Locally with Milvus in Just 10 Minutes—No More Waiting!
Learn how to set up DeepSeek-R1 on your local machine using Ollama, AnythingLLM, and Milvus in just 10 minutes. Bypass busy servers and enhance AI responses with custom data.