




ガウス過程:確率的モデリングの包括的ガイド
ガウス過程:確率的モデリングの包括的ガイド
機械学習モデルは従来、入力データに基づいて最も可能性の高い結果を表す点予測を生成します。現実の状況は、この単純なパターンには従いません。金融分野、医療、ロボティクスにおける将来の結果を予測するには、予測結果とそれに伴う不確実性レベルを理解する必要があります。
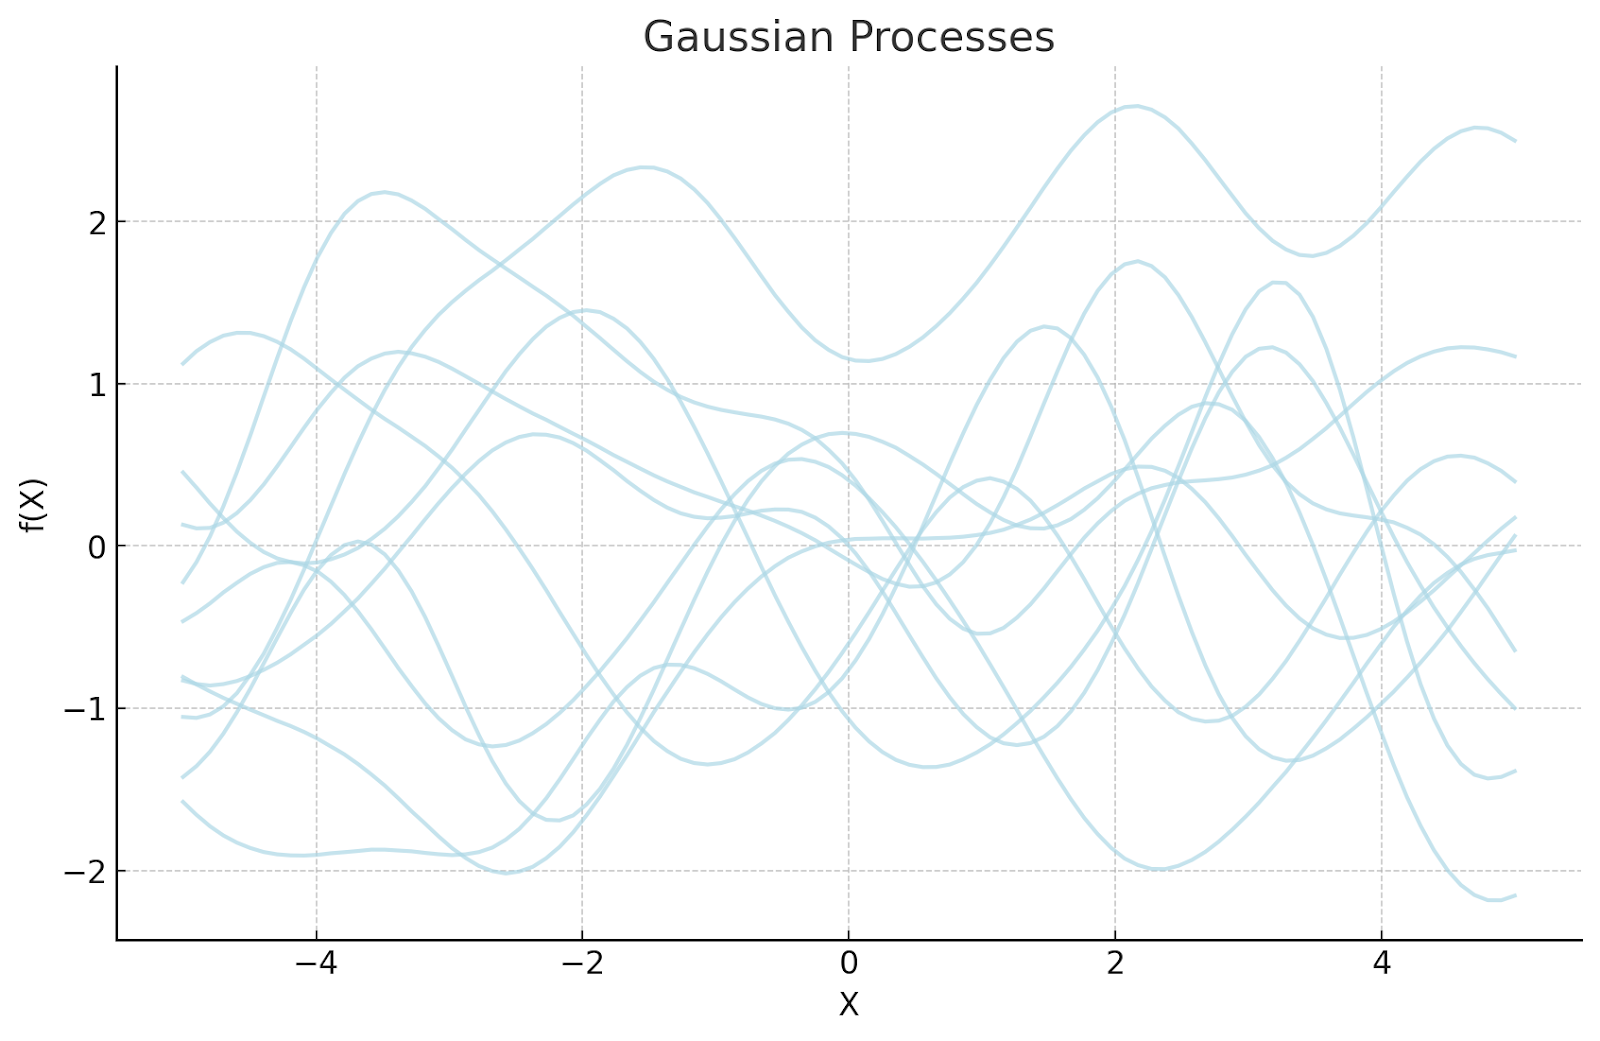 図 1 - ガウス過程の図解
図 1:ガウス過程の図解
ガウス過程(GP)は、これらの課題に対する解決策として機能します。GPは、推定値と信頼度の測定値を提供する確率的予測を行い、予測の不確実性レベルを表します。GPは確率的モデリングに有用であり、堅牢な定量的不確実性評価を提供します。
ガウス過程(GP)は、固定パラメータに依存するのではなく、関数上の分布を定義する点で、多くの機械学習モデルとは異なります。これにより、データに柔軟に適応し、予測における明示的な不確実性の定量化を提供できます。
最大の強みの一つは、小規模なデータセットでもうまく機能しながら、過学習を回避できることです。また、新しい情報を取り込むことで動的に適応するため、データが限られている、または絶えず変化している状況に最適です。
このガイドでは、ガウス過程の基本概念、動作メカニズム、実用的な応用を提示することで説明します。また、これらのプロセスを実装するために使用できるツールについても見ていきます。
ガウス過程とは?
ガウス過程は、連続関数を推論する柔軟なノンパラメトリック機械学習モデルです。固定パラメータに依存するのではなく、関数上の分布を定義することでデータの関係をモデル化します。ガウス過程は、観測データに応じてその挙動を調整するため、パラメトリック関数とは異なります。
GPは、予測と不確実性推定の両方を提供するため、確率的モデリングにおいて特に有用です。これはベイズ推論によって可能になり、新しいデータが利用可能になるにつれてGPが予測を洗練させるのに役立ちます。
GPは、複雑なデータ構造を事前定義された数学的パターンなしに扱うことを可能にする適応可能な構造によって柔軟性を維持します。不確実性推定を必要とする回帰モデル、最適化問題、予測シナリオにおいて有用です。
近似手法により、計算の複雑さにもかかわらず、これらのモデルを実用的に利用できます。GPのデータ学習能力により、特に不確実性の定量化を必要とする多くの現代的な機械学習アプリケーションにおいて価値があります。
仕組み
ガウス過程の基本概念を確立したところで、それらがどのようにデータをモデル化し、関係を定義し、確信度の高い予測を行うかについて説明しましょう。
多変量正規分布
GPは、データ内の関係をモデル化し不確実性を捉えるために、共分散関数(カーネル)と組み合わせた多変量正規分布を基本的な構成要素として依存しています。この分布は、基本的なガウス分布を拡張し、単一の確率的枠組みを通じて複数の変数を分析します。GPはこの能力を使って、予測の一貫性を保ちながら複雑なデータ関係を構築します。
多変量正規分布は、変数間の依存関係を効果的にモデル化します。これがその主な運用上の利点です。共分散行列は、2つの変数が変化する際にそれらの間の影響度を確立する中心的な構成要素として機能します。
この原理により、GPは観測データに適したすべての可能な関数を表す分布を定義できます。訓練点により、GPは観測データと未知の点を含む確率モデルを作成します。データ内の既知の値により、モデルは確率的かつ連続的な補間を維持しながら、新しい点に対する予測を更新できます。
カーネル(共分散関数)
ガウス過程は、共分散関数としても知られるカーネルを通じてデータ点間の関係を定義します。カーネルは点間の情報伝達を制御し、関数出力のパターンを決定します。カーネルの選択により、モデルが検出するパターンの種類が決まり、滑らかな変化や急激な変化に加えて周期的パターンも含まれます。一般的なカーネル関数には次のものがあります。
二乗指数カーネル: 滑らかで連続的なパターンを作成するため、ほとんどの回帰アプリケーションに適しています。モデルは、互いに近い点ほど高い相関を示すと予測します。
Matérnカーネル: このカーネルにより、ユーザーは関数の滑らかさのレベルを指定できるため、不規則なパターンや急激な変化を特徴とするデータセットに適用できます。
周期カーネル: これは反復的なデータパターンや季節性効果を認識するため、時系列データの予測や周期的パターンの検出に適しています。
線形カーネル: 線形関係の検出に有効なモデルであり、データ内の線形依存関係を発見するのに役立ちます。
GPは、ユーザーが異なるデータセットに適切なカーネルを選択することで、より高い精度と解釈可能性を実現します。
ノンパラメトリックモデル
ガウス過程は、データに対して固定された方程式の記述を仮定しないため、ノンパラメトリック手法として機能します。モデルは固定された方程式を課すことなく、観測点からパターンを抽出します。
GPは、新しいデータ入力を通じて複雑で進化する関数を扱えるため、柔軟性を維持します。GPは、パラメトリックモデルのような固定された数学的構造を使用しないため、データ収集を通じて複雑性を拡張します。このようなアプリケーションは、未知または変化する関数に適応できる能力により、GPを使用することで大きな恩恵を受けます。
同時確率と条件付き確率
GPの予測プロセスは、同時確率分布と条件付き確率分布の使用に依存します。GPは、観測されたデータ点に対して同時ガウス分布構造を作成します。新しい点が追加されるたびに、モデルは以前に観測されたデータに基づいて予測を条件付けます。
ベイズ推論により、新しいデータが以前に獲得した知識を失うことなく関数予測を改善するため、推定プロセスが可能になります。モデルは予測値と、不確実性の尺度の両方を生成し、それらは信頼区間になります。この機能により、ロボティクス、金融、医療などの重要なアプリケーションにおいて推定が信頼できるものになります。
ハイパーパラメータとその影響
GPモデルは、カーネルの動作とモデルの適応性を定義するハイパーパラメータの制御下で動作します。主なハイパーパラメータには次のものがあります。
長さスケール: 長さスケールパラメータは相関が低下する速度を制御し、結果として得られる関数の滑らかさを決定します。モデルの長さスケールは変化の速度と詳細なパターンの検出を制御しますが、より広範なデータ傾向の確立にも影響します。
分散: 分散パラメータは、関数値が領域全体にどれだけ広がるかを直接制御し、不確実性の予測に影響します。より高い分散はモデルが大きな関数値の変化を検出する能力を高めますが、より低い分散はよりリスク回避的な予測を生み出します。
ノイズレベル: ガウス過程におけるノイズレベルパラメータは、データの変動性を考慮することで、実際のデータ信号とランダムノイズを区別します。ノイズの多い観測値への過適合を防ぐために測定の不確実性を調整しつつ、信頼できる測定値は通過させます。
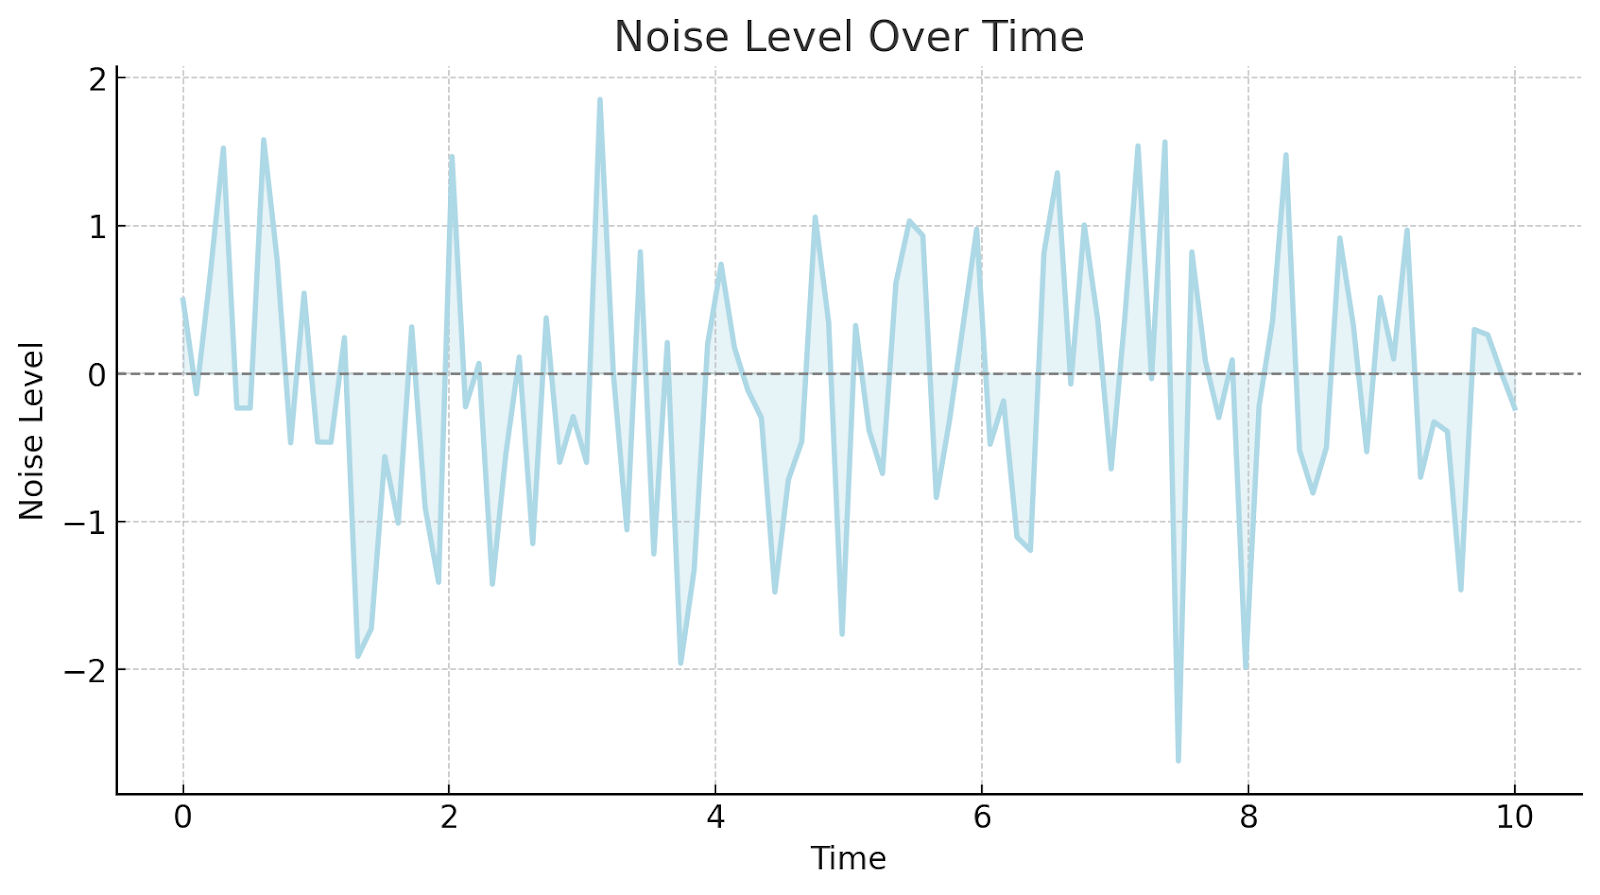 図2 - 時間の経過に伴うノイズレベル
図2: 時間の経過に伴うノイズレベル
正確な予測には、これらのハイパーパラメータの調整が必要です。最尤推定やベイズ最適化などの最適化手法は、特定のデータセットに対する最適なパラメータ値を見つけ出します。
他のモデルとの関連
ガウス過程は独立して機能しますが、複数の機械学習モデルと重要な原理を共有しています。GPと他の手法との関係は、その強みと適した用途を理解するのに役立ちます。
関連ベクトルマシン(RVM)
GPは、関連ベクトルマシン(RVM)と並行した機能を示します。どちらも確率的予測モデルを用いるためです。RVMは限られた基底関数セットで動作し、その結果、計算性能が向上します。GPは連続的な関数分布を提供し、他のモデルよりも詳細な不確実性予測を生成します。
RVMのベイズ推論はデータの疎性の仮定に依存しますが、GPはこれらの制約なしにカーネル関数を通じて不確実性をモデル化します。GPは、正確な信頼区間計算と適応可能な関数推定能力が必要な状況により適しています。
カルマンフィルタリング
ガウス過程の確率的モデリング能力は、不確実性を扱うという共通の能力を通じて、カルマンフィルタの能力と一致します。カルマンフィルタは、再帰的推定手法によって線形動的システムで優れており、リアルタイムの追跡および制御システムで効果的に機能できます。
GPは、非線形関数を通じて多様なデータ構造を扱う汎用的なモデリングシステムを提供します。マルコフ的な状態依存性はカルマンフィルタの基礎を形成しますが、GPは共分散構造を通じて関係性を確立し、柔軟で滑らかな関数近似を支えます。
他の機械学習モデルとの比較
GPは独自の利点を提示しますが、適切な用途と限界を判断するには、標準的な機械学習モデルとの比較が必要です。
| 観点 | ガウス過程(GPs) | ニューラルネットワーク(NNs) | サポートベクターマシン(SVMs) |
| モデルの種類 | ノンパラメトリック、確率的 | パラメトリック、深層学習ベース | パラメトリック、マージンベース |
| 不確実性の定量化 | 信頼区間を提供 | ベイズNNsを除き限定的 | 追加の手法が必要 |
| スケーラビリティ | O(N³)の計算量、大規模データセットにはあまり適さない | 大規模データセットに対してよくスケールする | 小規模データセットに対して効率的 |
| 柔軟性 | カーネルの選択が適応性を決定する | 非常に複雑な関数をモデル化できる | カーネルに依存した柔軟性 |
| 解釈可能性 | 中程度;カーネルが洞察を提供する | 低い;しばしば「ブラックボックス」とみなされる | 中程度;決定境界が明示的 |
| 訓練データの要件 | 小規模データセットで良好に機能する | 大規模データセットが必要 | 中規模データセットで有効 |
| 応用 | 回帰、予測、ベイズ最適化 | 画像、音声認識、NLP | 分類、バイオインフォマティクス |
利点と課題
GPsは、大きな利点と技術的制約をもたらす機械学習アプローチです。利点と限界の両方を理解することで、GPsの適切な利用シナリオを判断できます。
利点
確率的フレームワーク: GPsは、予測結果と信頼度推定のために関数分布を定義します。これらのモデルは、精密な不確実性計算を必要とする診断システムやリスク評価で優れています。
ノンパラメトリックな性質: GPsのモデル構造は、あらかじめ定められた関数形状に依存しません。複雑なデータ構造に適応するため、動的なパターン適応能力を示します。
事前知識の組み込み: 平均関数と共分散関数により、GPsはドメイン固有の知識をモデリングプロセスに組み込むことができます。過去データや専門家の知見を追加することで、GPsを通じてモデル精度が向上します。
ドメインをまたぐ汎用性: GPsは、地球統計学、時系列予測、ベイズ最適化に効果的に役立ち、適応的な関数モデリングに有用であることを示しています。
閉形式推論: ガウス過程は、ガウスノイズ回帰に対して厳密な事後解を提供し、時間のかかる数値近似なしに効率的な推論を可能にします。
課題
計算上のスケーラビリティ: GPsは機能するためにO(N³)(データ点数Nに対する三次の時間計算量)の演算を必要とし、その結果、大規模データセットでは高い計算コストが生じます。スパースGPsとして知られる近似手法はより高い効率をもたらしますが、モデルに新たな制約を導入します。
カーネル選択への感度: カーネル関数の選択は、GPsがデータをどれだけ正確にモデル化できるかを決定する重要な要因であり続けます。不適切なカーネル選択を用いると汎化の問題が生じ、綿密なチューニングと検証ステップが必要になります。
限定的な外挿能力: 既知の領域を超えた汎化は、外挿よりも内挿で優れた性能を発揮するGPsにとって依然として困難です。モデルは観測データに依存するため、これらの領域外では予測が信頼できなくなります。
ハイパーパラメータ最適化: 長さ尺度や分散を含む適切なハイパーパラメータを見つけることは困難です。ベイズ最適化は、パラメータ調整の効率を高める自動化システムです。
実装の複雑さ: GPの実装には、ベイズ推論や共分散関数解析などの高度な数学が必要です。実装とチューニングを成功させるには、これらの概念を完全に理解している必要があります。
ユースケース
GPは、その柔軟性と不確実性を定量化する能力により、さまざまな実世界のアプリケーションで広く使用されています。主なユースケースには次のようなものがあります。
時系列予測: GPは、正確な不確実性の測定値を生成しながら、将来のデータポイントを予測することに優れています。金融市場、気候モデリング、需要予測では、信頼区間付きの正確な予測を提供するため、GPが標準的なツールとして使用されています。
空間データ分析: GPは堅牢な空間データ分析ツールです。環境モニタリングデータ、土地利用情報、気象観測から空間的関係を抽出します。地球統計学のアプリケーションでは、主にこれらのモデルをクリギング操作に使用します。
ハイパーパラメータ最適化: GPはベイズ最適化において不可欠であり、機械学習パラメータ、深層学習構造、コストの高い関数評価を伴う実験設計を最適化します。
異常検知: GPは異常の検出に優れており、不正検知、予測保全システム、医療診断に不可欠であることが証明されています。
強化学習: GPは強化学習を通じて意思決定システムをサポートします。特に、不確実性モデリングがロボティクス、自律システム、ゲームプレイで不可欠な場合に有効です。
ツールとライブラリ
効率的なGP実装には、モデル学習、推論、最適化タスクを簡素化する専門ツールが必要です。さまざまなライブラリが包括的なフレームワークを提供し、実務者が実用的なアプリケーションでGPを使用できるようにしています。ツールには次のようなものがあります。
GPy: ガウス過程モデリングを実行するための使いやすいライブラリです。カーネル定義、モデルフィッティング、予測タスクのためのシンプルなインターフェースを提供します。
GPflow: TensorFlow上に構築された大規模なガウス過程ライブラリです。変分推論を含む最新の最適化アプローチをサポートしており、スケーラブルなアプリケーションに最適です。
Scikit-learn: シンプルなGPの回帰と分類実装を提供し、初心者や実務者が利用できるようにしています。
GPyTorch: PyTorch上に構築されたガウス過程ライブラリで、スケーラブルな推論を可能にし、深層カーネル学習の統合をサポートします。
Stan: ベイズ推論アプリケーションを通じてGPモデリングを実装する確率的プログラミング言語です。
Emukit: 意思決定のニーズに応じたGPの実装を支援する、ベイズ最適化と確率的モデリングツールのためのツールキット です。
よくある質問
ガウス過程は何に使用されますか?
GPは回帰、分類、ベイズ最適化に使用され、不確実性推定を伴う確率的予測を提供します。ML、地球統計学、時系列予測で使用されます。
ガウス過程は不確実性をどのように扱いますか?
GPは、観測されたデータポイントに一致するすべての関数上に確率分布を定義することで、不確実性を管理します。これにより、計算された平均と定量化された信頼区間を伴う予測が可能になります。
ガウス過程の文脈におけるカーネルとは何ですか?
GPは、プロセスの共分散構造を定義することでデータポイントの類似性を特定する共分散関数としてカーネルを使用します。選択したカーネルはモデルの滑らかさに影響します。
ガウス過程は大規模データセットに使用できますか?
従来のGPは、3次の時間計算量のため大規模データセットでは計算上の課題に直面しますが、スパースGPのようなスパース近似によりスケーラビリティは向上しています。
ガウス過程はニューラルネットワークとどのように比較されますか?
GPは、正確な不確実性の測定を含む予測を提供します。ニューラルネットワークは決定論的な結果を提供しますが、同等の性能結果を達成するには大規模なデータセットが必要です。