




CUREアルゴリズムの理解:代表点を用いたクラスタリングの包括的探究
 クラスタリングの視覚的表現
図1:クラスタリングの視覚的表現
企業は、絶えず変化する市場をどのように乗り切り、類似したパターンを持つ顧客を効果的にグループ化できるのでしょうか?従来のクラスタリング手法は、不規則なデータ形状や外れ値を扱う際に十分に機能しないことがよくあります。現代のデータセットの複雑さには、より賢く、より適応性の高いソリューションが求められます。
そこで登場するのがCURE(Clustering Using Representatives)アルゴリズムです。これは、標準的なクラスタリング手法の制約に対処する効果的な方法です。CUREは、代表点の選択を用いることで従来のクラスタリング手法との差別化を図り、複雑なデータ分布を識別する知能を向上させます。これらの代表点はクラスタの平均に近づくため、任意形状のクラスタを扱えるようになり、アルゴリズムはより高度になります。
CUREは、大規模データセットに適用すると計算負荷が高くなる可能性があります。それにもかかわらず、異常値や複雑なクラスタを処理するアプローチは非常に効果的です。CUREアルゴリズムの中核的なアプローチ、利点、実用的な応用を探りながら、その動作について説明しましょう。また、CUREを実装する際に直面する可能性のある課題についても取り上げます。
CUREアルゴリズムとは?
CUREアルゴリズムは階層的クラスタリングアプローチを用い、複雑なクラスタ形状を識別し、外れ値を効果的に処理します。****k-meansのような重心ベースのアルゴリズムとは異なり、CUREは複数の代表点を使ってクラスタを表現します。これらの点は、固定された縮小係数でクラスタ平均に向かって移動し、堅牢なクラスタ表現を作成します。
CUREは、その設計によりさまざまな不規則なデータセットタイプに対応できるため、k-meansよりも高い柔軟性を示します。凸型または等距離のクラスタに関する従来のアルゴリズムの制約を克服できるため、クラスタの境界や形状を正確に検出できます。
仕組み
CUREアルゴリズムは、最終出力を生成するために複数のステップを含みます。外れ値のないクラスタを作成するために、どのようにデータを選択するのかを明らかにしましょう。
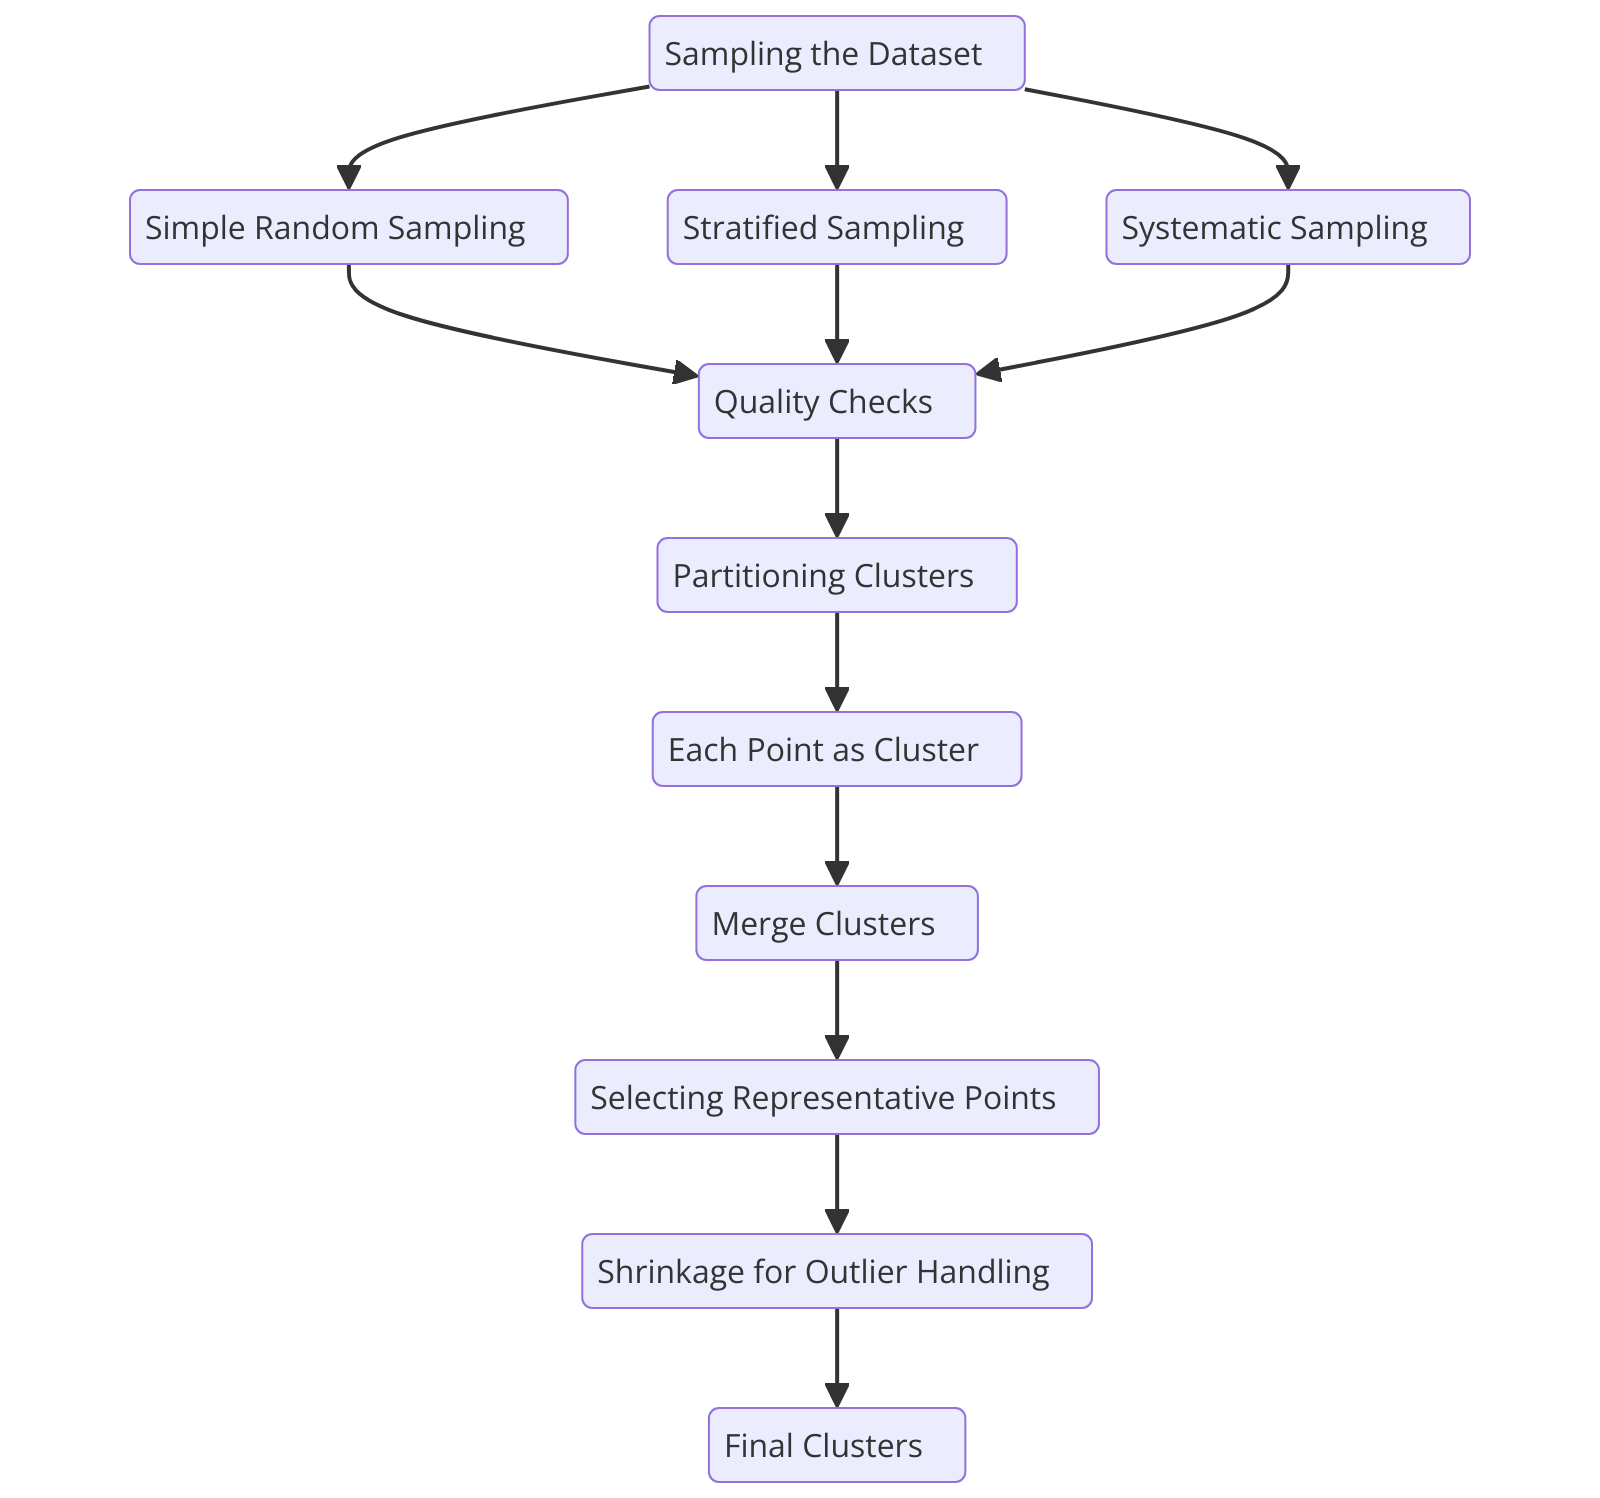 CUREクラスタリングアルゴリズムのプロセスフロー
図2:CUREクラスタリングアルゴリズムのプロセスフロー
CUREクラスタリングアルゴリズムのプロセスフロー
CUREアルゴリズムの仕組みを理解するために、データセットのサンプリングから始めて、そのプロセスを段階的に分解してみましょう。
データセットのサンプリング
CUREは、データセットから代表的なランダムサンプルを選択することから始めます。サンプリングプロセスによりデータポイント数が減少し、クラスタの完全性を維持しながら計算速度が向上します。
単純ランダムサンプリングは迅速に実装できますが、重要なエッジケースを捉えられません。その結果、不均衡なデータセットでは少数派グループの表現が不十分になります。データ内の異なるクラスの比例分布を維持する必要がある場合には、層化サンプリングが必要になります。
この方法により、分析において重要な小さなデータサブセットがすべて可視のまま保たれます。もう1つの方法は系統サンプリングで、一定間隔のシステムを通じてデータポイントを選択します。系統サンプリングは、データセット内の時間的性質と順序パターンを保持するため、時系列データや順序付きデータで優れています。
品質チェックでは、収集後のサンプルが元のデータセット分布と一貫しているかを検証します。平均値、分散レベル、分布特性を比較することで、取得したサンプルと完全な元データセットとの類似性を評価できます。CUREによって実装される厳密なサンプリング戦略により、その後のクラスタリングはデータセット全体の複雑性と多様性を正確に表現できるようになります。
クラスターの分割
データセットをサンプリングした後、CUREはデータを扱いやすいサブセットに分割する階層的手法を適用します。特に、クラスタリングにはボトムアップのマージ戦略を使用します。このアルゴリズムは、ユークリッド距離またはマンハッタン距離を使用する距離指標によってデータ点の類似性を測定します。距離計算指標は、効果的なクラスターマージのための確固たる基盤を確立しながら、点の近接性を判断するうえで不可欠です。
プロセスの開始時には、各データ点がそれぞれ1つのクラスターとして機能し、データの細粒度な性質を表します。アルゴリズムは、近接性の基準を使用して類似した点をグループ化するため、連続的にクラスターをマージします。アルゴリズムは、定義されたクラスター数に到達するか、別の終了条件が有効になるまで、クラスターマージ操作を続けます。
CUREにおけるグループ選択プロセスは、データに存在する自然なカテゴリに沿ったクラスターを作成します。階層的分割を使用することで、CUREはクラスターが凸形状であることを必要とする従来のクラスタリングアルゴリズムの制限を克服します。
代表点の選択
CUREは、単一の重心に依存するのではなく、各クラスターを表すために複数の代表点を選択します。クラスターから慎重に選ばれたこれらの点は、その空間的範囲と構造を捉えます。CUREは、複数の点を使用して各クラスターを表すことで、クラスター境界の認識と内部構造の理解を向上させます。
代表点を選択した後、アルゴリズムは指定された収縮量でそれらをクラスター平均へ向けて移動させます。この収縮手順により、遠く離れた点をクラスターの中心点へ移動させることで、アルゴリズムは外れ値に対して反応しにくくなります。
アルゴリズムの成功は、実行中に使用される代表点の数に大きく依存します。代表点を適切に選択することが重要です。代表点が少なすぎるとクラスターの複雑さを捉えられない可能性があり、多すぎると計算コストが増加する可能性があります。
クラスターのマージ
代表点を特定した後、アルゴリズムは体系的な反復アプローチを使用してクラスターをマージします。この手順は、異なるクラスターの代表点間の距離を測定することに依存します。ユークリッド距離などの事前定義された指標を使用して距離を測定することで、最も近いクラスターを見つける際の不一致を排除します。
アルゴリズムは、各評価ステップにおいて、代表点間の分離距離が最も小さいクラスターのペアを特定します。アルゴリズムは、クラスター内の空間的関係と自然なデータ整列パターンを維持しながら、正確なクラスターマージの判断を行います。
このプロセスは、あらかじめ定められたクラスター数が達成されるか、別の終了基準が満たされるまで反復されます。終了基準は、クラスター間の最小距離やクラスター内で許容される最大類似度などの要因に依存します。これにより、生成されたクラスターがデータ内の自然なグループ化に対応し、不規則で複雑な形状を捉えるのに十分な柔軟性を持つことが保証されます。
外れ値の処理
外れ値が存在する場合、それらは誤ったクラスター形状を引き起こし、データ構造を誤って解釈させるため、結果が歪められます。CUREアルゴリズムは、クラスターの実際の形状と分布を正確に識別する複数の代表点を使用することで、これらの制限を解決します。
収縮メカニズムはCUREにおけるもう1つの根本的な進歩であり、システムの耐性を高め、その高度性を向上させます。この意図的な調整は、代表点をクラスター中心位置へ移動させることで、極端な値に対するアルゴリズムの感度を低下させます。
収縮係数は、ユーザーがデータセットの特性に応じてその値をカスタマイズできる調整パラメータです。これにより、クラスターの自然な境界を維持しながら、柔軟な外れ値の緩和が可能になります。
他のクラスタリング手法との比較
CUREアルゴリズムの革新的なアプローチは、他の一般的なクラスタリング手法と一線を画しています。以下は、より詳しい比較です。
| 側面 | CURE | k-means | DBSCAN |
| 表現方法 | 複数の代表点 | 単一の重心 | 密度ベース |
| 外れ値の処理 | 優秀 | 不十分 | 良好 |
| 形状の柔軟性 | 任意の形状 | 凸形状のみ | 任意の形状 |
| スケーラビリティ | 高い(サンプリング使用時) | 高い | 中程度 |
| 複雑性 | 高い | 低い | 中程度 |
利点と課題
実世界のシナリオに適用すると、CUREには利点と課題の両方があります。実用的なアプリケーションにおいて、CUREがどのように価値を提供できる一方で、特定のハードルももたらすのかを見ていきましょう。
利点
スケーラビリティ: CUREはデータサンプリング戦略によってスケーラビリティを実現し、クラスタの精度を損なうことなく計算負荷を削減します。
堅牢性: CUREは、クラスタの形状と構造を捉えるために複数の代表点を使用することで、堅牢性を高めます。そのため、データにノイズがあり一貫性がない場合でも、クラスタリングは信頼性が高く安定した結果をもたらします。
汎用性: CUREは任意の形状のクラスタを捉え、不規則性や非凸構造に対応します。これは、多様なデータセットにおいて特に有用であり、k-meansのような従来手法ではそれらを正確に表現できない場合があります。
課題
パラメータ感度: このアルゴリズムでは、縮小係数と代表点数について正確なパラメータ調整が必要です。最適な性能を得るには適切なバランスを見つけることが重要であり、実験とドメイン専門知識の両方が求められます。
サンプリングバイアス: 不十分なサンプリング手法は、不正確なクラスタ形成と悪い結果を生み出します。データセット構造を損なわないようにするには、偏りのない代表サンプルを維持することが不可欠です。
計算要件: CUREのスケーラビリティに関する課題は、複数の距離評価が必要になるため、大規模・高次元・非構造化データセットで増大します。PCAや並列計算のような手法は次元数を削減でき、重要な関係性を保持しながら計算コストを下げられます。
ユースケース
CUREアルゴリズムの実践的な影響を理解するために、さまざまな領域における実世界のクラスタリング課題をどのように解決できるかを見ていきましょう。
異常検知
CUREは、典型的な取引をグループ化し、不正を示す可能性のある不規則な取引を分離することで、異常を効果的に特定します。これにより、金融機関は不審な活動を迅速に検出し、セキュリティ対策を強化できます。
市場セグメンテーション
マーケティングにおいて、CUREは購買行動、人口統計、嗜好などの属性に基づいて顧客をセグメント化できます。これにより、ターゲットを絞ったマーケティングキャンペーンが可能になり、顧客維持率を改善し、将来のトレンドを予測できます。たとえば、高価値顧客をクラスタ化して限定オファーを提供し、ロイヤルティを高めることができます。
地理空間データ分析
都市計画者はCUREを実装して、類似した気候、人口密度、またはインフラ開発を持つ地域を分類できます。環境科学者は、生態系を研究しながら、生物多様性や資源の利用可能性に応じて地域をクラスタ化するために使用できます。
ドキュメントクラスタリング
CUREは、標準的なテーマやトピックに基づいて広範なドキュメントカタログをグループ化することで、テキストマイニングにおいて優れた有効性を示します。検索エンジンはこの方法を使用して正確な結果カテゴリを作成し、ユーザーが関連コンテンツを迅速に見つけられるようにします。
CUREにより、recommendation systemsは、類似した主題を持つ記事や研究論文を特定できます。これにより、ユーザーに対してパーソナライズされた有意義な推薦が実現します。CUREは、多様なテキスト構造を効果的にクラスタリングし、高次元データセットの複雑さやサイズに関係なく、正確なグループ化結果を維持できます。このアルゴリズムは多言語テキストデータセットや異種データエントリにうまく適応し、現代の情報検索プラットフォームにとって不可欠なソリューションとして位置づけられています。
結論
CUREクラスタリングアルゴリズムは、クラスタリング手法における大きなブレークスルーです。現代のデータ問題に対して、効果的でスケーラブルなソリューションを提供します。このアルゴリズムは、階層的原理とともに代表点を使用することで、従来のクラスタリングの制限を克服しながら、柔軟で正確な結果を保証します。アルゴリズムにはパラメータ最適化や計算要件に関する課題がありますが、ノイズの多いデータや複雑なパターンを管理する能力は、複数のビジネス分野にとって不可欠です。
データセットの複雑さが増大し続けることで、将来的にはCUREのような柔軟なクラスタリングアルゴリズムの必要性がさらに高まるでしょう。CUREの原理を理解するデータサイエンティストや機械学習の実務者は、複雑なデータセットから有意義なインサイトを生成する可能性を最大限に引き出せるようになります。
FAQ
- k-meansと比較してCUREが独自である点は何ですか?
CUREは、単一のクラスタ重心ではなく複数の代表点を利用することで、k-meansと差別化されます。この方法により、凸型クラスタの仮定を必要とせずに、複雑なデータセット全体で不規則なクラスタ形状や非線形パターンを検出できます。
- CUREは大規模データセットをどのように扱いますか?
CUREは、計算処理要件を最小限に抑えるランダムサンプリング手法を通じて、大規模データセットを管理します。このサンプリング戦略により、アルゴリズムは削減されたデータサブセットを処理でき、クラスタ関係の完全性を維持します。
- CUREにおける縮小係数の役割は何ですか?
CUREの縮小係数は、代表点がそのクラスタの平均位置へ向かって移動する距離を制御します。この係数により、ユーザーは精度と堅牢性の間で最適な結果を達成できます。CUREの実装の成功は、各データセットに適した正しい縮小係数を見つけることに大きく依存します。
- CUREは高次元データで機能しますか?
高次元データにCUREアルゴリズムを使用するには、PCAなどの手法による事前の前処理が必要です。高次元データ処理では、データの単純性を維持しながらも重要なパターンを見つけるために、効率的な次元削減が必要です。
- CUREの典型的な用途は何ですか?
CUREの典型的な用途には、異常検知、市場セグメンテーション、地理空間分析、ドキュメントクラスタリング分析が含まれます。不正検知のための異常な金融パターンの特定、行動に基づく顧客のグループ化、特性に基づく地域の分析が可能です。
関連リソース
https://zilliz.com/ai-faq/how-are-embeddings-used-for-clustering
https://zilliz.com/ai-faq/how-does-clustering-improve-vector-search
https://zilliz.com/ai-faq/how-does-swarm-intelligence-improve-data-clustering
https://zilliz.com/ai-faq/what-is-graph-clustering-in-knowledge-graphs
https://zilliz.com/ai-faq/what-are-the-most-common-algorithms-for-anomaly-detection