




TAL Education GroupはいかにMilvusでAIを活用した学習をスケールさせているか
ミリ秒単位のセマンティック検索
数十億のベクトルを瞬時に検索し、遅いファジーマッチングを置き換えます
採点精度の向上
自由記述式およびマルチモーダルな学生の回答に対する、より精密な意味理解
より高品質なレコメンデーション
高再現率のベクトル検索は、キーワード検索では見逃される関連コンテンツを浮かび上がらせます
エンドツーエンドの高速化
全体的なレイテンシを低減した、より高速な採点、検索、推薦パイプライン
TAL Education Groupについて
TAL Education Group (NYSE: TAL) は、アジアを代表する教育テクノロジー企業の1つであり、数百万人の生徒と家庭にサービスを提供しています。2003年に設立され、2010年にニューヨーク証券取引所に上場したTALは、Xueersiの個別指導事業から、Xueersi.com、Xueersi Smart Devices、MathGPT、その他のテクノロジー主導の教育ブランドを含む幅広いデジタル学習製品ポートフォリオへと成長してきました。これらはすべて、家庭やデジタル教室環境で生徒を支援するよう設計されています。
TALが、パーソナライズされた個別指導、自動採点、コンテンツ推薦、マルチモーダルな知識検索にわたるAI主導の学習へとさらに深く拡大するにつれ、同社には、これらの計算集約型ワークロードを大規模に支えられる新しいデータインフラストラクチャが必要になりました。TALはベクトル検索プラットフォームの基盤としてMilvusを選択することで、より迅速な採点、より正確な推薦、そして製品全体にわたるよりインテリジェントなセマンティック検索を実現するために必要な性能、スケーラビリティ、柔軟性を獲得しました。Milvusは現在、すべての生徒にとってアクセスしやすく、効率的で、効果的な、高品質でテクノロジーを活用した学習体験を提供するというTALのより広範な使命を支えるうえで重要な役割を果たしています。
TALのAI搭載学習システムが直面する課題
TALは、自動採点、学習リソース推薦、ベクトルベースの文書検索といった複数の主要な教育シナリオにAIを導入しています。しかし、これらのサービスが拡大するにつれて、同社は従来型データシステムの限界にすぐに直面しました。現代のオンライン教育は、複雑でマルチモーダルなコンテンツを大量に生成する一方、AI搭載の採点には高いスループットと、生徒の回答に対する深い理解の両方が求められます。こうした圧力により、レガシーインフラストラクチャでは到底対応できない構造的な問題が表面化しました。
1. マルチモーダルデータの爆発的増加
TALは、科目、学年、形式を問わず、画像、図表、手書きの数式を含む何十万件もの新しい問題と解答を毎日処理しています。この絶え間ないデータ流入は、従来型データベースの能力を超えて、データを効率的にインデックス化し検索することを困難にしています。TALのデジタル学習プラットフォームが成長するにつれ、バックエンドは、性能や可用性を損なうことなく、増大するストレージ需要、高スループットのベクトル検索、試験時や学習のピーク期間に発生する突発的なトラフィック急増をシームレスに支えられる必要があります。
2. 採点パイプラインにおける運用上の非効率性
人による採点は、現代のオンライン学習の規模に追いつくことができません。1回のテストの評価に教師が15~20分かかることもあり、主観式の問題では採点者によって点数が一貫しないことがよくあります。TALの規模では、これが採点のボトルネックとなり、個別化された指導に振り向けられるはずの貴重な教師の時間を消費してしまいます。
さらに、TALは解説、解答、学習教材の膨大なライブラリを保有していますが、これらの資産は複数のシステムに分散しています。インテリジェントな検索がなければ、高品質なリソースは十分に活用されず、コンテンツ作成と実際の学習者のニーズとの間にギャップが生じます。
3. AI搭載フィードバックに求められる高い精度
AI採点は、キーワードの一致以上のことを行う必要があります。意味を理解しなければなりません。TALのシステムは、意味的な同等性を識別し、多様な表現を解釈し、生徒を公平かつ一貫して採点する必要があります。生成される解説はいずれも、正確で、教育学的に妥当であり、年齢に適したものでなければなりません。これを支えるために、TALには各問題を適切な概念に結び付け、それらの関係をマッピングする堅牢なナレッジグラフが必要です。従来型システムは、このレベルのセマンティック推論を大規模に支援するようには設計されていません。
MilvusによるTALのAI採点・学習システムの強化
TALがAI駆動の採点および学習サービスを拡大するにつれ、高い精度とリアルタイムの応答性を備え、大規模な埋め込みワークロードを支えられるベクトルインフラストラクチャが必要になりました。複数のソリューションを評価した後、TALは自社のベクトルデータプラットフォームの中核エンジンとしてMilvusを選択しました。
Milvusの上に、TALは高いデータ品質、アプリケーションとのシームレスな統合、継続的なシステム改善を確保するモジュール型アーキテクチャを構築しました。
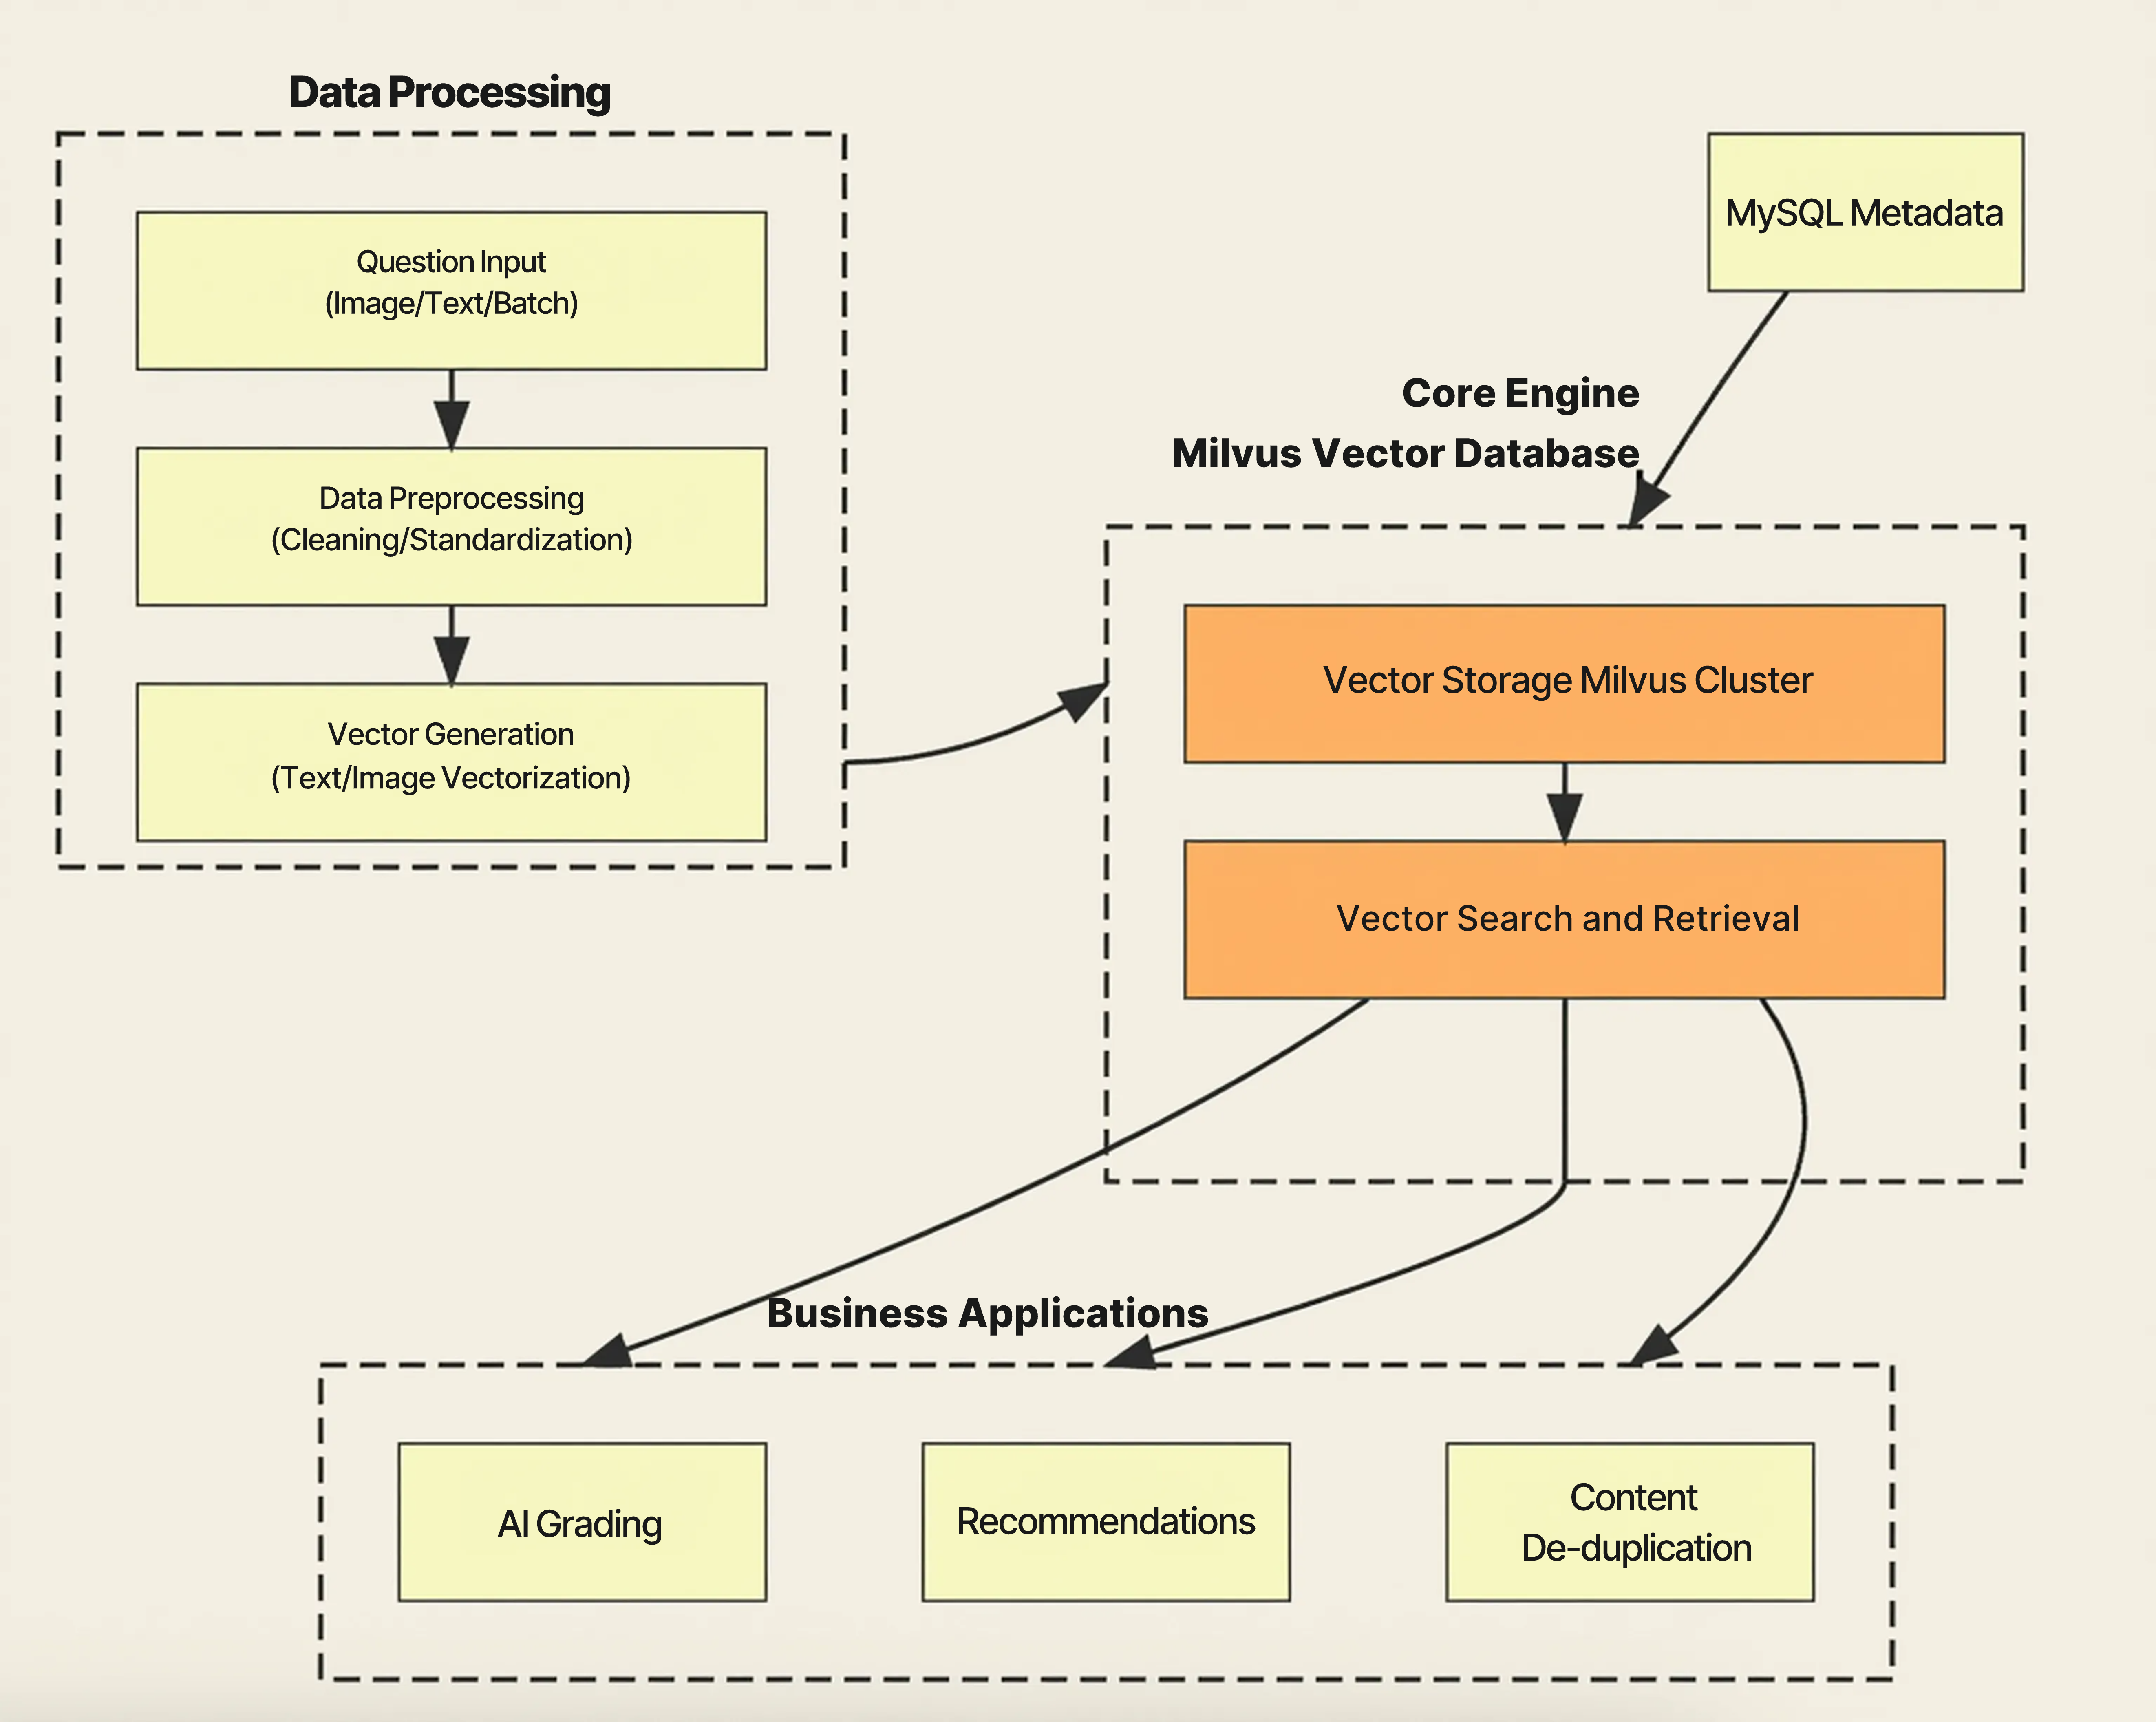
データ処理パイプライン:クリーンで一貫性があり、ベクトル化に適したデータ
TALのデータ処理パイプラインは、システム全体の基盤を形成しています。問題、回答、学習教材は、API、バッチアップロード、画像や手書き文字からのOCR抽出など、複数のソースから取り込まれます。取り込まれたすべてのコンテンツは、ベクトル埋め込みに変換される前に、正規化、特徴抽出、品質チェックを経ます。このパイプラインにより、Milvusに保存されるすべてのデータがクリーンで一貫性があり、高品質なセマンティック検索向けに最適化されることが保証されます。
Milvusベクトルデータベース:10億規模での高性能検索
TALのアーキテクチャの中心にあるのがMilvusベクトルデータベースであり、10億規模のベクトルストレージと高性能なセマンティック検索を提供します。Milvusの分散アーキテクチャとApproximate Nearest Neighbor(ANN)インデックスにより、TALは数億から数十億の埋め込みを対象としても、類似性クエリをミリ秒単位で処理できます。Milvusのマルチインデックス戦略は、TALが速度と精度のバランスを取るのに役立ち、MySQLはバージョン管理やインデックスマッピングなどの構造化メタデータを保存します。これにより、ベクトルデータとリレーショナルデータが密接に同期された状態に保たれます。
現在、このMilvusデプロイメントは20以上のコレクションにわたって10億以上のベクトルを管理しており、単一クラスターで1日あたり数百万件の検索リクエストを処理しています。
アプリケーションサービス:ベクトル検索を教育的インパクトへ
アプリケーションサービス層は、Milvusの機能を実際の教育的インパクトへと変換します。
AI採点: セマンティック類似性を使用して学生の回答を評価し、解説を生成します。
レコメンデーション: 学生の学習レベルと進捗に合わせた類似問題を見つけます。
コンテンツ重複排除: 問題バンクの品質を維持するため、反復的または冗長なコンテンツを検出します。
各サービスは、Milvusが大規模環境で高速かつ正確な検索を提供できる能力に依存しており、学生と教育者がタイムリーでパーソナライズされ、一貫した結果を受け取れるようにしています。
品質評価フレームワーク:継続的改善のためのクローズドループ
大規模環境で信頼性を維持するため、TALはシステム全体にわたる継続的な品質評価フレームワークを構築しました。AIが生成した各採点結果には、セマンティック類似性、過去のパフォーマンス、教師からのフィードバックに基づく信頼度スコアが付与されます。これらのシグナルは、異常を特定し、採点ロジックを調整し、モデルパラメータを更新し、検索品質を時間とともに向上させる構造化されたフィードバックループに取り込まれます。
このクローズドループの仕組みにより、負荷の増加によって劣化するのではなく、利用が拡大するほどシステムの精度が高まることが保証されます。
Milvusによって実現された実際の性能向上と新たな可能性
ハイブリッドクラウド環境全体にMilvusを導入した後、TALはシステム性能とAI活用型学習体験の品質において、すぐに大きな改善を確認しました。
10億規模でのミリ秒レベルの検索
Milvusは現在、数十億のベクトルに対してミリ秒レベルのセマンティック検索を処理しており、かつてAI採点、レコメンデーション、コンテンツ検索の足かせとなっていた低速なあいまいマッチング手法を置き換えています。Milvusを導入したことで、結果の返却がより速くなり、精度が向上し、教師と学生は全体を通じてより一貫した回答を得られるようになりました。
より高い精度とより優れた安定性
Milvusのベクトル類似性検索により、TALは学生の回答をはるかに深く理解できるようになりました。以前のシステムと比較して、Milvusは以下を実現します。
より正確な検索結果、特にオープンエンドかつマルチモーダルな質問において
より高品質なリコール、キーワード検索では一致できない関連コンテンツを提示
10億規模でも安定したパフォーマンス、試験期間のピーク時でも維持
より高速なエンドツーエンド処理、採点やレコメンデーションのレイテンシを削減
これらの進歩は、システム効率だけでなく教育の質も高めます。AIが学生の意図をより深く理解し、より教育的関連性の高い応答を返せるようになるためです。
エコシステム全体で新たなAI機能を解放
既存プロセスの高速化にとどまらず、MilvusはTALの学習プラットフォーム全体で新機能の波を可能にしました。
AI Grading: より精密なセマンティックマッチングにより、採点の一貫性と説明の質が向上します。
Internal IM Platform: より高速で関連性の高いドキュメント検索により、コラボレーションとコンテンツ再利用が強化されます。
Knowledge-Base QA: 正確なチャンクレベルのリコールにより、キーワード検索では決して提示できなかった回答を提供します。
教育の公平性と効率性の向上
Milvusの改善は、教室における実質的な成果につながります。より高速で信頼性の高いAI採点は教師の負担を軽減し、大人数の学生に対してより一貫した採点を実現します。より優れたセマンティック検索により、高品質な学習リソースを見つけやすく、再利用しやすくなります。これらの強化により、TALはすべての学生に対して、よりパーソナライズされた公平な支援を提供できるようになります。
より強力な運用効率とオブザーバビリティ
エンジニアリングチームにとっても、Milvusは日々の運用を簡素化します。Milvusの公式管理ツールであるAttu web consoleは、ベクトルの検査とコレクション管理をより直感的にし、運用上の負担を軽減します。同時に、Prometheus + Alertmanagerとの統合により、レイテンシ、ノードの健全性、ストレージ使用率、エラーパターンに対する深い可視性を提供します。このオブザーバビリティにより、TALはトラフィック急増時や大規模な試験サイクル中でも、安定した予測可能なサービスを維持できます。
次の展望:Milvusとコミュニティとともに成長
複数のチームでMilvusがしっかりと導入されたことで、TALは現在、ベクトル検索がさらに多くのAI施策をどのように支援できるかを見据えています。10億規模でMilvusを運用してきたことで、TALのエンジニアは、何がうまく機能し、どこに新たな改善があればさらに大きな効果を生み出せるかを明確に把握できました。
TALは今後もMilvusコミュニティで積極的に活動し続ける予定です。実際の本番環境から得た知見を共有し、新機能へのフィードバックを提供し、コントリビューターと密接に協力して、ベクトルデータベース機能の次の波を形づくっていきます。よりシンプルなクロスクラスターデータ移行や継続的なパフォーマンスチューニングといった改善により、TALはさらに多くの製品へMilvusを導入しやすくなります。
重要なサービスを円滑に稼働させ続けるため、TALはオープンソースのMilvusデプロイメントと並行して、フルマネージドのMilvusサービスであるZilliz Cloudも運用しています。このデュアルアクティブ構成により、アップグレード時や高トラフィック期間中にチームへ追加の信頼性を提供し、学生と教師が常に安定した学習体験を得られるようにしています。
TALが教育向けに、よりインテリジェントでスケーラブルなAIツールを構築し続ける中で、Milvusは同社のテクノロジースタックの重要な一部であり続けます。数百万の家庭に、より高速で、よりスマートで、より信頼性の高い学習ソリューションを提供するために貢献します。
注: 本ケーススタディは、TAL Education GroupのシニアデータサイエンティストであるZhiming Huang氏とMuzi Lee氏によって執筆され、許可を得て翻訳、編集、再掲載されています。