




世界をリードするGPUおよびAIプラットフォームが、自動運転システム向けのマルチモーダルデータマイニングをスケールさせるためにMilvusを活用する方法
-30% コスト
Milvus 2.5 におけるディスクベースの主キーと最適化されたセグメントレイアウトにより、メモリおよびストレージのフットプリントを削減。
10倍スケール
再設計やコスト面の想定外なしに、さらに一桁規模までスケールできることが実証済みの余力。アーキテクチャの変更や予期しないコストなし。
エンタープライズ信頼性
重大なインシデントのない大規模な継続生産。
ハイブリッド検索
複雑なクエリをサポートする統合ベクトル検索とメタデータフィルタリング。
From a system stability perspective, it's really quite good. Over the year-plus that we've been using it—from version 2.4.3 to now 2.5.8—I honestly haven't encountered many issues. The system can just run there for months, with new data being written every day and users searching every day, without any problems. I don't need to worry about it.
Team Lead
会社概要
この顧客は、アクセラレーテッドコンピューティングと人工知能の分野におけるグローバルリーダーであり、ゲーム、ロボティクス、データセンター、自動車アプリケーションで使用されるGPUとソフトウェアプラットフォームを数十年にわたり構築してきた経験を持っています。同社の主要な取り組みの1つが、高度な運転支援および自動運転のためのエンドツーエンドプラットフォームです。このプラットフォームは、大規模なデータ収集やAIモデルのトレーニングから、車載推論やリアルタイムの意思決定に至るまで、自動運転開発のライフサイクル全体をサポートします。
このプラットフォームを支えているのが、同社の自動運転車(AV)データエンジニアリング組織です。同組織は、自社の自動運転技術を動かすデータインフラストラクチャを担っています。実世界での走行1時間ごとに、同期されたカメラストリーム、LiDAR点群、レーダー計測、高精度ローカライゼーションデータ、詳細な車両状態メタデータなど、テラバイト規模のマルチモーダルセンサーデータが生成されます。チームの使命は、この膨大で増え続けるデータセットを、ロングテールのシナリオを抽出し、まれなエッジケースを特定し、実世界の条件下でモデルの挙動を検証しなければならない数百人のエンジニアにとって、検索可能で、発見しやすく、運用上利用可能なものにすることです。
これらの要件を満たすため、チームはテストフリートから収集された数百億件のインデックス化済みセンサーデータポイントを検索できるマルチモーダルデータマイニングシステムを構築しました。このシステムは生のセンサーデータをベクトル埋め込みに変換するため、エンジニアは深く文脈を考慮したクエリを実行できます。たとえば、「激しい雨の中で右側から合流する車両」、「標識のない交差点で夕暮れ時に横断する歩行者」、「視界が遮られた2車線のラウンドアバウト」といったクエリです。
このシステムは当初、FAISS 上で動作していましたが、データ量と運用上の要求が増大するにつれて、チームはより高いスケーラビリティ、低い保守負荷、より強固な本番環境での信頼性を実現するために Milvus へ移行しました。Milvus は、自動運転フリートが拡大し続ける中で、桁違いに多くのデータをサポートし、運用オーバーヘッドを削減し、クラスタリング、インデックス作成、ストレージ効率を向上させるための明確な道筋を提供しました。
課題:FAISS はスケールできなかった
データ管理のボトルネック
このデータマイニングシステムの初期設計は、意図的にシンプルなものでした。各自動運転セッション(通常は1時間程度の走行)はフレームに処理され、同社独自のモデルによってベクトル埋め込みに変換され、FAISSインデックスファイルにまとめられていました。通常は1日あたり1つのファイルです。
この構造は当初はうまく機能していましたが、スケールしませんでした。データセットが急増するにつれて、インデックスファイルの数も増え、最終的には数十万に達しました。それぞれが小さく孤立した情報の塊を表していました。それらを横断して検索するには大きな複雑さが伴いました。日次インデックスには重複データが含まれることが多く、メタデータをフィルタリングしてマージするための複雑なロジックが必要でした。実際には、単一の日付内での検索は問題なく機能する一方で、ほとんどのユーザーは、複数の日付や地域にまたがる特定の走行シナリオのような、より広範な条件をクエリしたいと考えていました。そうした検索では、多数の個別のインデックスファイルに同時にアクセスする必要があり、計算コストが高くなりました。エンジニアはしばしば、クエリを実行する前に、関連データが含まれていそうなファイルを推測しながら、手動で対象範囲を絞り込まなければなりませんでした。この推測作業により、検索プロセスは遅く、信頼性の低いものになっていました。
柔軟性のギャップ
FAISS はデータベースではなく、ライブラリです。与えられたベクトルに対する最近傍を見つける用途には適していますが、本番グレードの検索システムには、高速な類似度マッチングだけではるかに不十分です。
実際には、エンジニアたちはコーパス全体を一度に検索したいわけではありませんでした。彼らに必要だったのはコンテキストに基づくフィルタリングでした。たとえば、「都市部の道路で小雨の中に撮影された前方カメラのフレーム」や、「カリフォルニアの高速道路での夜間走行」を見つけることです。そのレベルの精度を実現するには、ベクトル検索を、カメラの種類、時刻、場所、天候、モデルバージョンなどのメタデータフィルターと組み合わせる必要がありました。しかしFAISSは、これらの機能を標準では提供していませんでした。そのギャップを埋めるために、チームは、個別のメタデータデータベース、どのFAISSインデックスをスキャンするかを決定する専用のクエリプランナー、取得後に結果を手動でポストフィルタリングする仕組みなど、カスタムロジックの複雑なスタックを構築しなければなりませんでした。
時間の経過とともに、これらのカスタマイズは大きなスケーリング問題を生み出しました。異なるカメラアングル、複数の埋め込みモデル、バージョン管理された前処理パイプラインはすべて、それぞれ異なる管理戦略を必要としました。コレクション、パーティション、論理的なデータグループ化という組み込みの概念はなく、あるのはインデックスファイルだけでした。データのバージョン管理からクエリフィルタリングに至るまで、あらゆる組織化のレイヤーをカスタムコードで作成し、保守する必要がありました。システムは機能していましたが、その代償として柔軟性、保守性、長期的なスケーラビリティが犠牲になっていました。
スケーラビリティの問題
システムはすでに数十億のベクトルで限界に近づいており、同社のテスト車両は毎日新しいデータを生成していました。一方で、研究チームは新しい埋め込みモデルを導入しており、それぞれが過去データの大規模な再インデックス化を必要としていました。ワークロードが10倍に増えるのは時間の問題でしたが、ファイルベースのFAISS構成には、そのレベルまでスケールさせる実用的な方法がありませんでした。
さらに悪いことに、新しいデータセットが増えるたびに、インデックスファイルが増え、メタデータストレージへの手動更新も増えていきました。自動シャーディングはなく、組み込みの負荷分散もなく、必要に応じて容量を追加する方法もありませんでした。このアーキテクチャは時代遅れになっていました — 静的で、労力がかかり、成長に対応しにくいものだったのです。
隠れたエンジニアリングコスト
クラウドコスト以外で最大の課題は、FAISSを維持するための隠れたエンジニアリング負荷でした。エンジニアは複雑なメタデータシステムを管理し、データを分散するためのカスタムロジックを設計し、何百万ものインデックスファイルを手動で更新しなければなりませんでした。時間の経過とともに、この負荷はイノベーションを遅らせました。検索性能は低下し、開発サイクルは長期化し、新しいアイデアはホワイトボードを超えて進まなくなりました。データ量が増え続けるにつれて、システムはますます硬直的で脆弱になっていきました。レガシーな構成をアップグレードしようとすることは、もはや持続可能ではないことが明らかでした。
解決策:Milvusでスケールに向けて再設計する
これらの課題を克服するために、AV Dataチームには、現在の数百億のベクトルを処理でき、10倍以上の成長への明確な道筋を持つシステムが必要でした。そのシステムは、堅牢なフィルタリング、運用のシンプルさ、そして何よりも、最小限の保守で本番環境における信頼性を提供する必要がありました。
評価プロセス
登場しつつあるすべてのベクトルデータベースを対象に広範な比較検証を行うのではなく、チームは人気のあるMilvus Vector Databaseに焦点を当て、4億〜5億のベクトルを使った概念実証を実施しました。これは実世界のボトルネックを明らかにするのに十分な規模でした。テスト中、エンジニアたちはデータワークフロー全体を再現しました。異なるインデックスタイプでデータセットをインデックス化してトレードオフを比較し、インデックス作成時間を測定して日次バッチ更新を見積もり、現実的なフィルターの組み合わせやクエリパターンの下でレイテンシをベンチマークしました。彼らは意図的にMilvusを限界まで押し込み、複雑な複数条件の検索を実行し、データ量を拡大して安定性をテストしました。
なぜMilvusなのか?
概念実証の結果、MilvusはAV Dataチームにとって明確な選択肢となりました。
許容可能なクエリ性能: Milvusは、最も複雑でフィルターの多い検索であっても、一貫して秒単位のクエリレイテンシを実現しました。これは社内のデータマイニングワークロードの要件を十分に満たしていました。
ネイティブなフィルタリングとクエリの柔軟性: エンジニアは、ベクトル類似検索とメタデータフィルターを単一のクエリで組み合わせられるようになりました。これは以前、FAISSで大量のカスタムコードを必要としていた機能です。
整理されたデータ構造: 異なるモデルからのベクトル埋め込みは別々のコレクションに保存され、それぞれが撮影日や地域などの属性でパーティション化されました。Milvusはセグメント全体のデータ分散を自動的に管理し、手動のファイル管理の負担をなくしました。
シームレスなスケーラビリティ: データが増加するにつれて、チームはノードを追加して容量を拡張しました。Milvusの分散アーキテクチャは、システム再設計を必要とせずに線形にスケールしました。
活発なオープンソースコミュニティ: テスト中、AV DataのエンジニアはMilvusチームとコミュニティ貢献者から迅速で実践的なサポートを受け、信頼できる本番環境対応のエコシステムとしてのMilvusに強い確信を築きました。
Milvusによる新しいアーキテクチャの実装
このマルチモーダルデータマイニングシステムのアーキテクチャは、その中核ではシンプルです。しかし、それを大規模に実行するには、慎重なエンジニアリングと精度が求められます。自動運転車の走行から得られる生の動画データ、つまり複数のカメラからの連続した数時間分の映像は、個々のフレームまたは通常数秒程度の短いクリップを抽出する処理パイプラインへ流れ込みます。
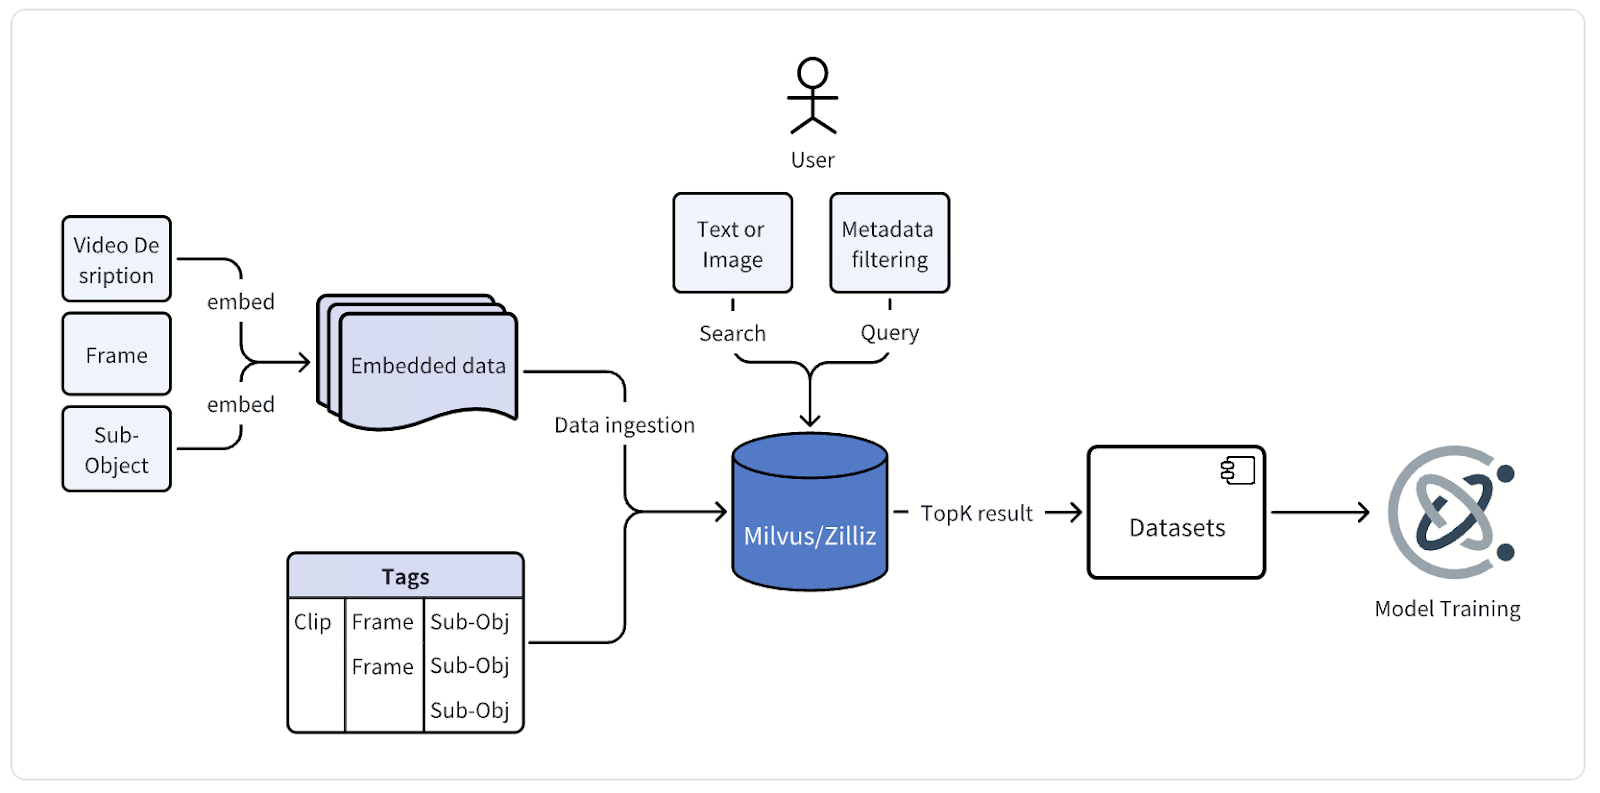
各フレームまたはクリップはその後、自動運転向けに専用設計された同社独自の埋め込みモデルを通過します。画像データについては、チームはCLIPアーキテクチャから派生し、道路固有の意味情報を捉えるようにカスタマイズおよびファインチューニングされたモデルを使用しています。動画データについては、物理AIアプリケーション向けの基盤モデル群である自社製モデルに依存しています。これらのモデルを組み合わせることで、視覚データは豊かな文脈的意味をエンコードした高次元ベクトル埋め込みへ変換されます。
生成されたこれらのベクトル埋め込みは、詳細なメタデータとともにMilvus Vector Databaseに保存され、インデックス化されます。各データポイントには、走行セッション、カメラ位置、タイムスタンプ、車両状態、位置情報、気象条件などを記述する属性が付与されます。このメタデータもインデックス化され、大規模データセット全体で高速かつ正確なフィルター検索を可能にします。
統一されたクエリインターフェースを通じて、エンジニアは複数の方法でデータを検索できます。テキストの説明を入力したり、参照画像や動画をアップロードしたり、ベクトル検索とメタデータフィルターを組み合わせて必要なものを正確に特定したりできます。たとえば、単一のクエリで「夜間の都市交差点で歩行者が横断している場面」を求めると、Milvusはレビュー、分析、モデル改善のために最も関連性の高いフレームまたはクリップを返します。
メリット: コスト効率、安定性、そしてスケール
1年以上にわたる継続運用の後、Milvusは技術的に堅牢であるだけでなく、運用面でも変革をもたらすことを証明しました。以下の成果は、そのアーキテクチャとエコシステムが、現実世界の大規模な効率性へどのようにつながったかを示しています。
よりシンプルな運用、少ない負担、そしてより迅速な開発
数十万ものFAISSファイルからMilvusへ移行したことで、運用上のオーバーヘッドの層が丸ごと取り除かれました。手動のインデックスファイル管理も、場当たり的なスクリプトも、カスタムクエリロジックも不要になりました。データ分散、セグメント管理、クエリルーティングは現在すべて自動的に行われます。アップグレードは簡単で、監視は統合され、メトリクスは明確な状況を示します。その結果、システム保守に費やす時間が減り、インサイトを得るためのデータマイニングにより多くの時間を使えるようになりました。
エンジニアリング負荷の低減に加え、Milvus 2.5へのアップグレード後にさらに30%のコスト削減
Milvus の導入により、インフラストラクチャとエンジニアリングの両方のコストが即座に削減されました。FAISS のファイルベースシステムから移行したことで、手動のファイル管理や複雑なメタデータ追跡が不要になり、開発者の時間と運用工数を大幅に削減できました。その後、Milvus 2.4 から Milvus 2.5 へのアップグレードにより、よりスマートなメモリマッピング、ディスクベースの主キー保存、より効率的なセグメント管理のおかげで、インフラストラクチャコストをさらに 30% 削減できました。
これらの改善により、AV Data チームは支出や保守のオーバーヘッドを増やすことなく、同じワークロードをより小規模な AWS インスタンスで実行したり、はるかに多くのデータをインデックス化したりできるようになりました。これらの成果に後押しされ、チームは Milvus 2.6 のテストを計画しています。Milvus 2.6 では、RaBitQ のような新しいインデックスタイプと、パフォーマンスとコスト効率の両方をさらに高めることが期待される追加の最適化が導入されています。 大規模なオフラインバッチワークロードでは、インデックス構築速度が引き続き重要な課題です。NVIDIA cuVS チームからの貢献により、Milvus は現在、CPU ベースのサービングを伴う GPU アクセラレーションによるインデックス構築(GPU-build, CPU-serve)をサポートしています。このアプローチにより、コスト効率を維持しながらインデックス構築を大幅に高速化でき、自動運転ワークロードにおける Milvus の価格性能面での優位性をさらに高めることが期待されています。
実運用で実証された組み込みのスケーラビリティ
このプラットフォームは現在、数百億のベクトルをインデックス化し、新しいデータを日々スムーズに取り込んでいます。社内モデリングにより、再設計や予期しないコスト増なしにさらに 10 倍スケールできることが確認されており、かつて容量上の制約だったものが、長期的な戦略的優位性へと変わりました。この余裕により、チームは直近 2 年間の運転データのインデックス化から、過去のアーカイブ全体を対象にするところまで拡張でき、記録されたすべての走行セッションを横断して検索できるようになります。また、複数の埋め込みモデルを並行して実行し、さまざまなクエリタイプに合わせて検索を最適化したり、データを期限切れとして削除するのではなく無期限に保持したりすることも可能です。ここでのスケーラビリティとは、単により多くのデータを扱うことではなく、継続的な学習と、より安全な自動運転に向けた進歩の加速を実現することを意味します。
大規模環境におけるエンタープライズ級の信頼性
1 年以上にわたる継続的な本番運用の中で、Milvus は数百億のベクトルを日々の取り込みとクエリ処理とともに、重大なインシデントを一度も起こすことなく安定して処理してきました。システムはバックグラウンドで安定して稼働し、最小限の監視で済んでいます。週末の停止も、緊急パッチもなく、ただ一貫した予測可能なパフォーマンスを提供しています。この規模でのこのような信頼性は、運用リスクの低減、火消し対応の削減、そしてインフラ管理ではなく価値の構築により集中できることにつながります。
より豊かな検索、よりスマートなワークフロー
Milvus はベクトル検索とメタデータフィルタリングを組み合わせることで、同社のエンジニアに複雑な運転データを分析する新たな方法を提供しています。たとえば、日中に前方カメラで撮影されたすべての工事区域の画像を見つけたり、時間と場所でフィルタリングして、アップデートや地域ごとのモデル挙動を比較したりできます。異なるコレクションには異なるモデルからの埋め込みが保持されるため、チームは本番環境に影響を与えることなく新しいアーキテクチャをテストできます。これらの機能は実験を加速し、以前は大規模なカスタムエンジニアリングを必要としていた知見を明らかにします。
インパクトを倍増させる強力なコミュニティ
テクノロジーに加えて、Milvusのオープンソースコミュニティは同社の成功の大きな要因となってきました。テストおよびデプロイ中、エンジニアはMilvusのコントリビューターやメンテナーから直接、迅速なサポートを受けました。この応答性により、ダウンタイムが削減され、デバッグが迅速化し、進捗を予定どおりに維持できました。時間の経過とともに、活発なコミュニティは新しいアイデアの検証、アップグレードの円滑化、ベストプラクティスの共有を支援することで、価値を提供し続けています。この顧客にとって、Milvusは単なる信頼性の高いソフトウェアではなく、プラットフォームを強化し、長期的な効率をもたらす協働的なエコシステムです。
本番環境から得た教訓
適切なインデックスの選択:スケール、コスト、精度のバランス
インデックスの選択は、ベクトル検索システムを構築する際の最も重要な実践的判断の1つです。Milvusは多くのインデックスタイプをサポートしており、それぞれ速度、メモリ使用量、精度において独自のトレードオフがあります。AV Dataチームの目標は、単に最速の選択肢を選ぶことではなく、データ規模、インフラコスト、検索精度のバランスを見つけることでした。
いくつかの構成をテストした後、彼らはIVF_FLATを選択しました。これはベクトルをクラスタにグループ化し、関連するクラスタ内で厳密検索を実行するものです。これは最速でも最もコンパクトでもありませんが、数百億のベクトルと中程度のレイテンシ要件に対して、効率を維持しながら性能と精度の適切な組み合わせを実現しました。
チームは、インデックスがワークロードにうまく適合すれば、新しいものに切り替える必要はほとんどないことを発見しました。実際には、わずかな性能向上を追い求めるよりも、適切に適合したインデックスのほうが多くの時間とリソースを節約します。大規模システムでは、安定して予測可能な性能こそが運用を円滑に保ちます。
メモリマッピング:大規模環境におけるレイテンシとコストのトレードオフ
チームの最も効果的な技術的選択の1つは、インフラコストを抑えるためにメモリマッピング(Mmap)を使用したことでした。従来の構成では、すべてのベクトルデータをRAMに保持するには、大規模で高コストなインスタンスが必要になります。Milvusのメモリマッピングでは、ほとんどのデータをディスク上に置いたまま、オペレーティングシステムが頻繁にアクセスされる部分を自動的にメモリ内に保持します。この設計により、ある程度のレイテンシが発生します—ディスク読み取りはRAMより遅いためです—が、予測可能な性能と効率的なリソース使用を維持します。同社のワークロードにとって、このトレードオフは非常に理にかなっていました。ユーザーは即時応答を期待するエンドユーザーではなく、分析クエリを実行するエンジニアであり、同時実行数も低く抑えられているためです。
削除操作:小さな前提が大規模環境で崩れるとき
チームの最大の教訓の1つは、一見単純に思えること、つまりデータの削除から得られました。Milvusの追記型アーキテクチャでは、削除されたベクトルはすぐには取り除かれません—削除対象としてマークされ、後でバックグラウンドのコンパクションによってクリーンアップされます。テスト中、数百万のベクトルを削除したところ、Bloomフィルターが数千のセグメントにわたって偽陽性を生成したため、予期せず数十億の再インデックス化が引き起こされました。日常的なクリーンアップのように見えたものが、結果的にデータノードに過負荷をかけ、ジョブを停滞させました。
解決策は、Milvusがデータをどのように管理しているかを理解し、ワークフローを調整することから生まれました—Bloomフィルターのチューニング、削除対象を正確に絞るためのパーティションキーの使用、insert-onlyの一括ロードへの切り替えです。要点は、大規模環境では単純な操作であっても異なる挙動を示すことがあり、性能を予測可能に保つにはシステム内部の理解が重要だということです。
今後の展望
チームはリリース直後にMilvus 2.6を採用する準備を進めており、新しいインデックスタイプとアーキテクチャ上の最適化によって、効率性がさらに大きく向上すると確信しています。Milvusエンジニアリングチームとの初期の議論では、継続的なコスト削減とリソース利用率の向上が見込まれており、同社はフルスケールのベンチマークを通じてそれを検証する予定です。
さらに先を見据えると、チームは機能拡張とスケールに向けた大きな機会を見出しています。テキスト検索とベクトル検索を組み合わせるハイブリッド検索などの機能は、マルチモーダルデータを探索する新たな方法を切り開く可能性があり、強化されたデータベーススタイルのフィルターは複雑なワークフローを簡素化します。今後リリースされる Milvus 3.0 では、階層型アーキテクチャへの期待も高まっており、同社は最近のデータへの高速アクセスを維持しながら、完全な履歴アーカイブを効率的に保存できるようになります。これらの進歩が組み合わさることで、同社は容易にスケールし、より深い検索機能をサポートし、より効率的に成長するデータプラットフォームを手にすることになります。
さらに、Milvus における NVIDIA cuVS 搭載の GPU アクセラレーションによるインデックス構築と CPU ベースのサービング(GPU-build, CPU-serve) の導入と成熟により、オフラインインデックス作成性能が段階的に大きく向上することが期待されています。NVIDIA GPU と高度に最適化された cuVS ライブラリを活用することで、Milvus は CPU のみのパイプラインよりも大規模なベクトルインデックスを劇的に高速に構築できる一方で、クエリのサービングは引き続き CPU 上でコスト効率よく実行できます。これにより、データからクエリ可能になるまでの時間が大幅に短縮され、より頻繁なインデックス更新サイクルが可能になり、自動運転やその他の大規模マルチモーダルワークロードにおいて、迅速な反復と最新データが重要となる場面で、Milvus の価格性能優位性がさらに高まります。
結論
顧客の AV Data チームは、膨大な量のマルチモーダルデータを検索可能かつ実行可能にすることで、自動運転開発を加速する強力なデータマイニングプラットフォームを構築しました。FAISS から Milvus への移行により、スケーラビリティ、柔軟性、運用上の複雑性における重要な課題が解決されると同時に、測定可能なコスト削減と優れた本番安定性が実現されました。
1 年を超える継続運用と数百億のインデックス化されたベクトルを経て、このプラットフォームは、Milvus が大規模かつドメイン特化型のベクトル検索における本番グレードの基盤として機能できることを証明しました。このシステムは毎日新しいデータを取り込み、同社の自動運転プログラム全体のエンジニアを支援し、再アーキテクチャなしでさらに 10 倍へスケールする明確な道筋を提供しています。
大規模データを扱うベクトル検索システムを構築する組織にとって、コスト効率は重要であり、安定性はサブミリ秒のレイテンシよりも重視されます。同社の経験は示唆に富んでいます。Milvus は、オープンソースのベクトルデータベースが本番環境の要求を満たすだけでなく、時間とともに改善し続けられることを示しており、現実世界の AI インフラストラクチャに対して、信頼性が高く、スケーラブルで、将来に備えたバックボーンを提供します。