Почему базам данных ИИ не нужен SQL
На протяжении десятилетий SELECT * FROM WHERE был золотым правилом запросов к базам данных. Будь то системы отчетности, финансовый анализ или запросы о поведении пользователей, мы привыкли использовать структурированный язык, чтобы точно манипулировать данными. Даже NoSQL, когда-то провозгласивший «анти-SQL-революцию», в итоге сдался и внедрил поддержку SQL, признав его, казалось бы, незаменимое положение.
Но задумывались ли вы когда-нибудь: мы потратили более 50 лет, обучая компьютеры говорить на человеческом языке, так почему же мы все еще заставляем людей говорить на «компьютерном»?
Нравится вам это или нет, вот правда: SQL обречен на упадок в эпоху AI. Он, возможно, все еще будет использоваться в legacy-системах, но становится все менее актуальным для современных AI-приложений. AI-революция не просто меняет то, как мы создаем программное обеспечение, — она делает SQL устаревшим, а большинство разработчиков слишком заняты оптимизацией своих JOIN, чтобы это заметить.
Естественный язык: новый интерфейс для AI-баз данных
Будущее взаимодействия с базами данных — не в изучении лучшего SQL, а в полном отказе от синтаксиса.
Вместо борьбы со сложными SQL-запросами представьте, что вы просто говорите:
"Помоги мне найти пользователей, чье недавнее покупательское поведение наиболее похоже на поведение наших лучших клиентов за прошлый квартал."
Система понимает ваше намерение и автоматически решает:
Нужно ли ей запросить структурированные таблицы или выполнить поиск векторного сходства по пользовательским embeddings?
Нужно ли ей вызвать внешние APIs, чтобы обогатить данные?
Как ей ранжировать и фильтровать результаты?
Все выполняется автоматически. Никакого синтаксиса. Никакой отладки. Никаких поисков в Stack Overflow по запросу «как сделать оконную функцию с несколькими CTE». Вы больше не «программист» баз данных — вы ведете разговор с интеллектуальной системой данных.
Это не научная фантастика. Согласно прогнозам Gartner, к 2026 году большинство предприятий будут отдавать приоритет естественному языку как основному интерфейсу запросов, а SQL превратится из «обязательного» навыка в «необязательный».
Трансформация уже происходит:
✅ Нулевые синтаксические барьеры: Имена полей, связи между таблицами и оптимизация запросов становятся проблемой системы, а не вашей
✅ Дружелюбность к неструктурированным данным: Изображения, аудио и текст становятся полноценными объектами запросов
✅ Демократизация доступа: Операционные команды, менеджеры продуктов и аналитики могут напрямую запрашивать данные так же легко, как ваш senior-инженер
Естественный язык — лишь поверхность; AI-агенты — настоящий мозг
Запросы на естественном языке — лишь вершина айсберга. Настоящий прорыв — это AI-агенты, которые способны рассуждать о данных так же, как люди.
Понимать человеческую речь — это первый шаг. Понимать, чего вы хотите, и эффективно это выполнять — вот где начинается магия.
AI-агенты служат «мозгом» базы данных, отвечая за:
🤔 Понимание намерения: Определение того, какие поля, базы данных и индексы вам действительно нужны
⚙️ Выбор стратегии: Выбор между структурированной фильтрацией, векторным сходством или гибридными подходами
📦 Оркестрация возможностей: Выполнение APIs, запуск сервисов, координация межсистемных запросов
🧾 Интеллектуальное форматирование: Возврат результатов, которые вы можете сразу понять и использовать
Вот как это выглядит на практике. В векторной базе данных Milvus сложный поиск сходства становится тривиальным:
results = collection.search(query_vector, top_k=10, filter="is_active == true")
Одна строка. Никаких JOIN. Никаких подзапросов. Никакой настройки производительности. Векторная база данных обрабатывает семантическое сходство, а традиционные фильтры — точные совпадения. Это быстрее, проще и действительно понимает, чего вы хотите.
Этот подход "API-first" естественным образом интегрируется с возможностями Function Calling больших языковых моделей — более быстрое выполнение, меньше ошибок, более простая интеграция.
Почему SQL разваливается в эпоху ИИ
SQL был разработан для структурированного мира. Однако в будущем, определяемом ИИ, будут доминировать неструктурированные данные, семантическое понимание и интеллектуальный поиск — всё то, для чего SQL никогда не создавался.
Современные приложения переполнены неструктурированными данными, включая текстовые embeddings из языковых моделей, векторы изображений из систем компьютерного зрения, аудиоотпечатки из распознавания речи и мультимодальные представления, объединяющие текст, изображения и метаданные.
Эти данные не укладываются аккуратно в строки и столбцы — они существуют как векторные embeddings в многомерном семантическом пространстве, и SQL совершенно не знает, что с ними делать.
SQL + векторы: красивая идея с плохим исполнением
Отчаянно пытаясь оставаться актуальными, традиционные базы данных прикручивают векторные возможности к SQL. PostgreSQL добавил оператор <-> для поиска по векторному сходству:
SELECT *
  FROM items
 ORDER BY embedding <-> query_vector
 LIMIT 10;
Это выглядит умно, но в основе своей ошибочно. Вы принуждаете векторные операции проходить через SQL-парсеры, оптимизаторы запросов и транзакционные системы, спроектированные для совершенно другой модели данных.
Штраф к производительности жестокий:
📊 Реальные данные бенчмарков: При одинаковых условиях специально созданный Milvus обеспечивает на 60% меньшую задержку запросов и в 4,5 раза более высокую пропускную способность по сравнению с PostgreSQL с pgvector.
Почему такая низкая производительность? Традиционные базы данных создают излишне сложные пути выполнения:
Накладные расходы парсера: Векторные запросы принудительно проходят через проверку SQL-синтаксиса
Путаница оптимизатора: Планировщики запросов, оптимизированные для реляционных join-операций, плохо справляются с поиском по сходству
Неэффективность хранения: Векторы, хранящиеся как BLOB, требуют постоянного кодирования/декодирования
Несоответствие индексов: B-деревья и LSM-структуры совершенно не подходят для поиска сходства в многомерном пространстве
Реляционные базы данных vs AI/Vector Databases: принципиально разные философии
Несовместимость глубже, чем производительность. Это совершенно разные подходы к данным:
| Аспект | SQL/реляционные базы данных | Vector/AI Databases |
|---|---|---|
| Модель данных | Структурированные поля (числа, строки) в строках и столбцах | Многомерные векторные представления неструктурированных данных (текст, изображения, аудио) |
| Логика запросов | Точные совпадения + булевы операции | Сопоставление по сходству + семантический поиск |
| Интерфейс | SQL | Естественный язык + Python APIs |
| Философия | Соответствие ACID, идеальная согласованность | Оптимизированный recall, семантическая релевантность, производительность в реальном времени |
| Стратегия индексации | B+ деревья, hash indexes и т. д. | HNSW, IVF, product quantization и т. д. |
| Основные сценарии использования | Транзакции, отчетность, аналитика | Семантический поиск, мультимодальный поиск, рекомендации, RAG-системы, AI agents |
Пытаться заставить SQL работать с векторными операциями — всё равно что использовать отвертку как молоток: технически это не невозможно, но вы используете неправильный инструмент для задачи.
Векторные базы данных: специально созданы для ИИ
Векторные базы данных, такие как Milvus и Zilliz Cloud, — это не «SQL-базы данных с векторными функциями», а интеллектуальные системы данных, изначально созданные для AI-native приложений.
1. Нативная поддержка мультимодальности
Настоящие AI-приложения не просто хранят текст — они работают с изображениями, аудио, видео и сложными вложенными документами. Векторные базы данных обрабатывают разнообразные типы данных и многовекторные структуры, такие как ColBERT и ColPALI, адаптируясь к богатым семантическим представлениям от различных AI-моделей.
2. Архитектура, удобная для агентов
Большие языковые модели особенно хорошо справляются с вызовом функций, а не с генерацией SQL. Векторные базы данных предлагают Python-first API, которые бесшовно интегрируются с AI-агентами, позволяя выполнять сложные операции, такие как векторный поиск, фильтрация, reranking и семантическая подсветка, в рамках одного вызова функции, без необходимости в промежуточном слое перевода в язык запросов.
3. Встроенный семантический интеллект
Векторные базы данных не просто выполняют команды — они понимают намерение. Работая с AI-агентами и другими AI-приложениями, они выходят за рамки буквального сопоставления ключевых слов, чтобы обеспечить настоящий семантический поиск. Они знают не только «как выполнить запрос», но и «что вы на самом деле хотите найти».
4. Оптимизированы для релевантности, а не только для скорости
Как и большие языковые модели, векторные базы данных находят баланс между производительностью и полнотой поиска. Благодаря фильтрации по метаданным, гибридному векторному и полнотекстовому поиску и алгоритмам reranking они постоянно повышают качество и релевантность результатов, находя контент, который действительно ценен, а не просто быстро извлекается.
Будущее баз данных — разговорное
Векторные базы данных отражают фундаментальный сдвиг в том, как мы думаем о взаимодействии с данными. Они не заменяют реляционные базы данных — они специально созданы для AI-нагрузок и решают совершенно иные задачи в мире, где AI стоит на первом месте.
Так же как большие языковые модели не модернизировали традиционные системы правил, а полностью переосмыслили взаимодействие человека и машины, векторные базы данных переопределяют то, как мы находим информацию и работаем с ней.
Мы переходим от «языков, написанных для чтения машинами», к «системам, которые понимают человеческое намерение». Базы данных эволюционируют от жестких исполнителей запросов к интеллектуальным агентам данных, которые понимают контекст и проактивно выявляют инсайты.
Разработчики, создающие AI-приложения сегодня, не хотят писать SQL — они хотят описывать, что им нужно, и позволять интеллектуальным системам самим понять, как это получить.
Поэтому в следующий раз, когда вам понадобится найти что-то в своих данных, попробуйте другой подход. Не пишите запрос — просто скажите, что вы ищете. Ваша база данных может удивить вас тем, что действительно поймет, что вы имеете в виду.
А если нет? Возможно, пора прокачать базу данных, а не свои навыки SQL.

Читать далее
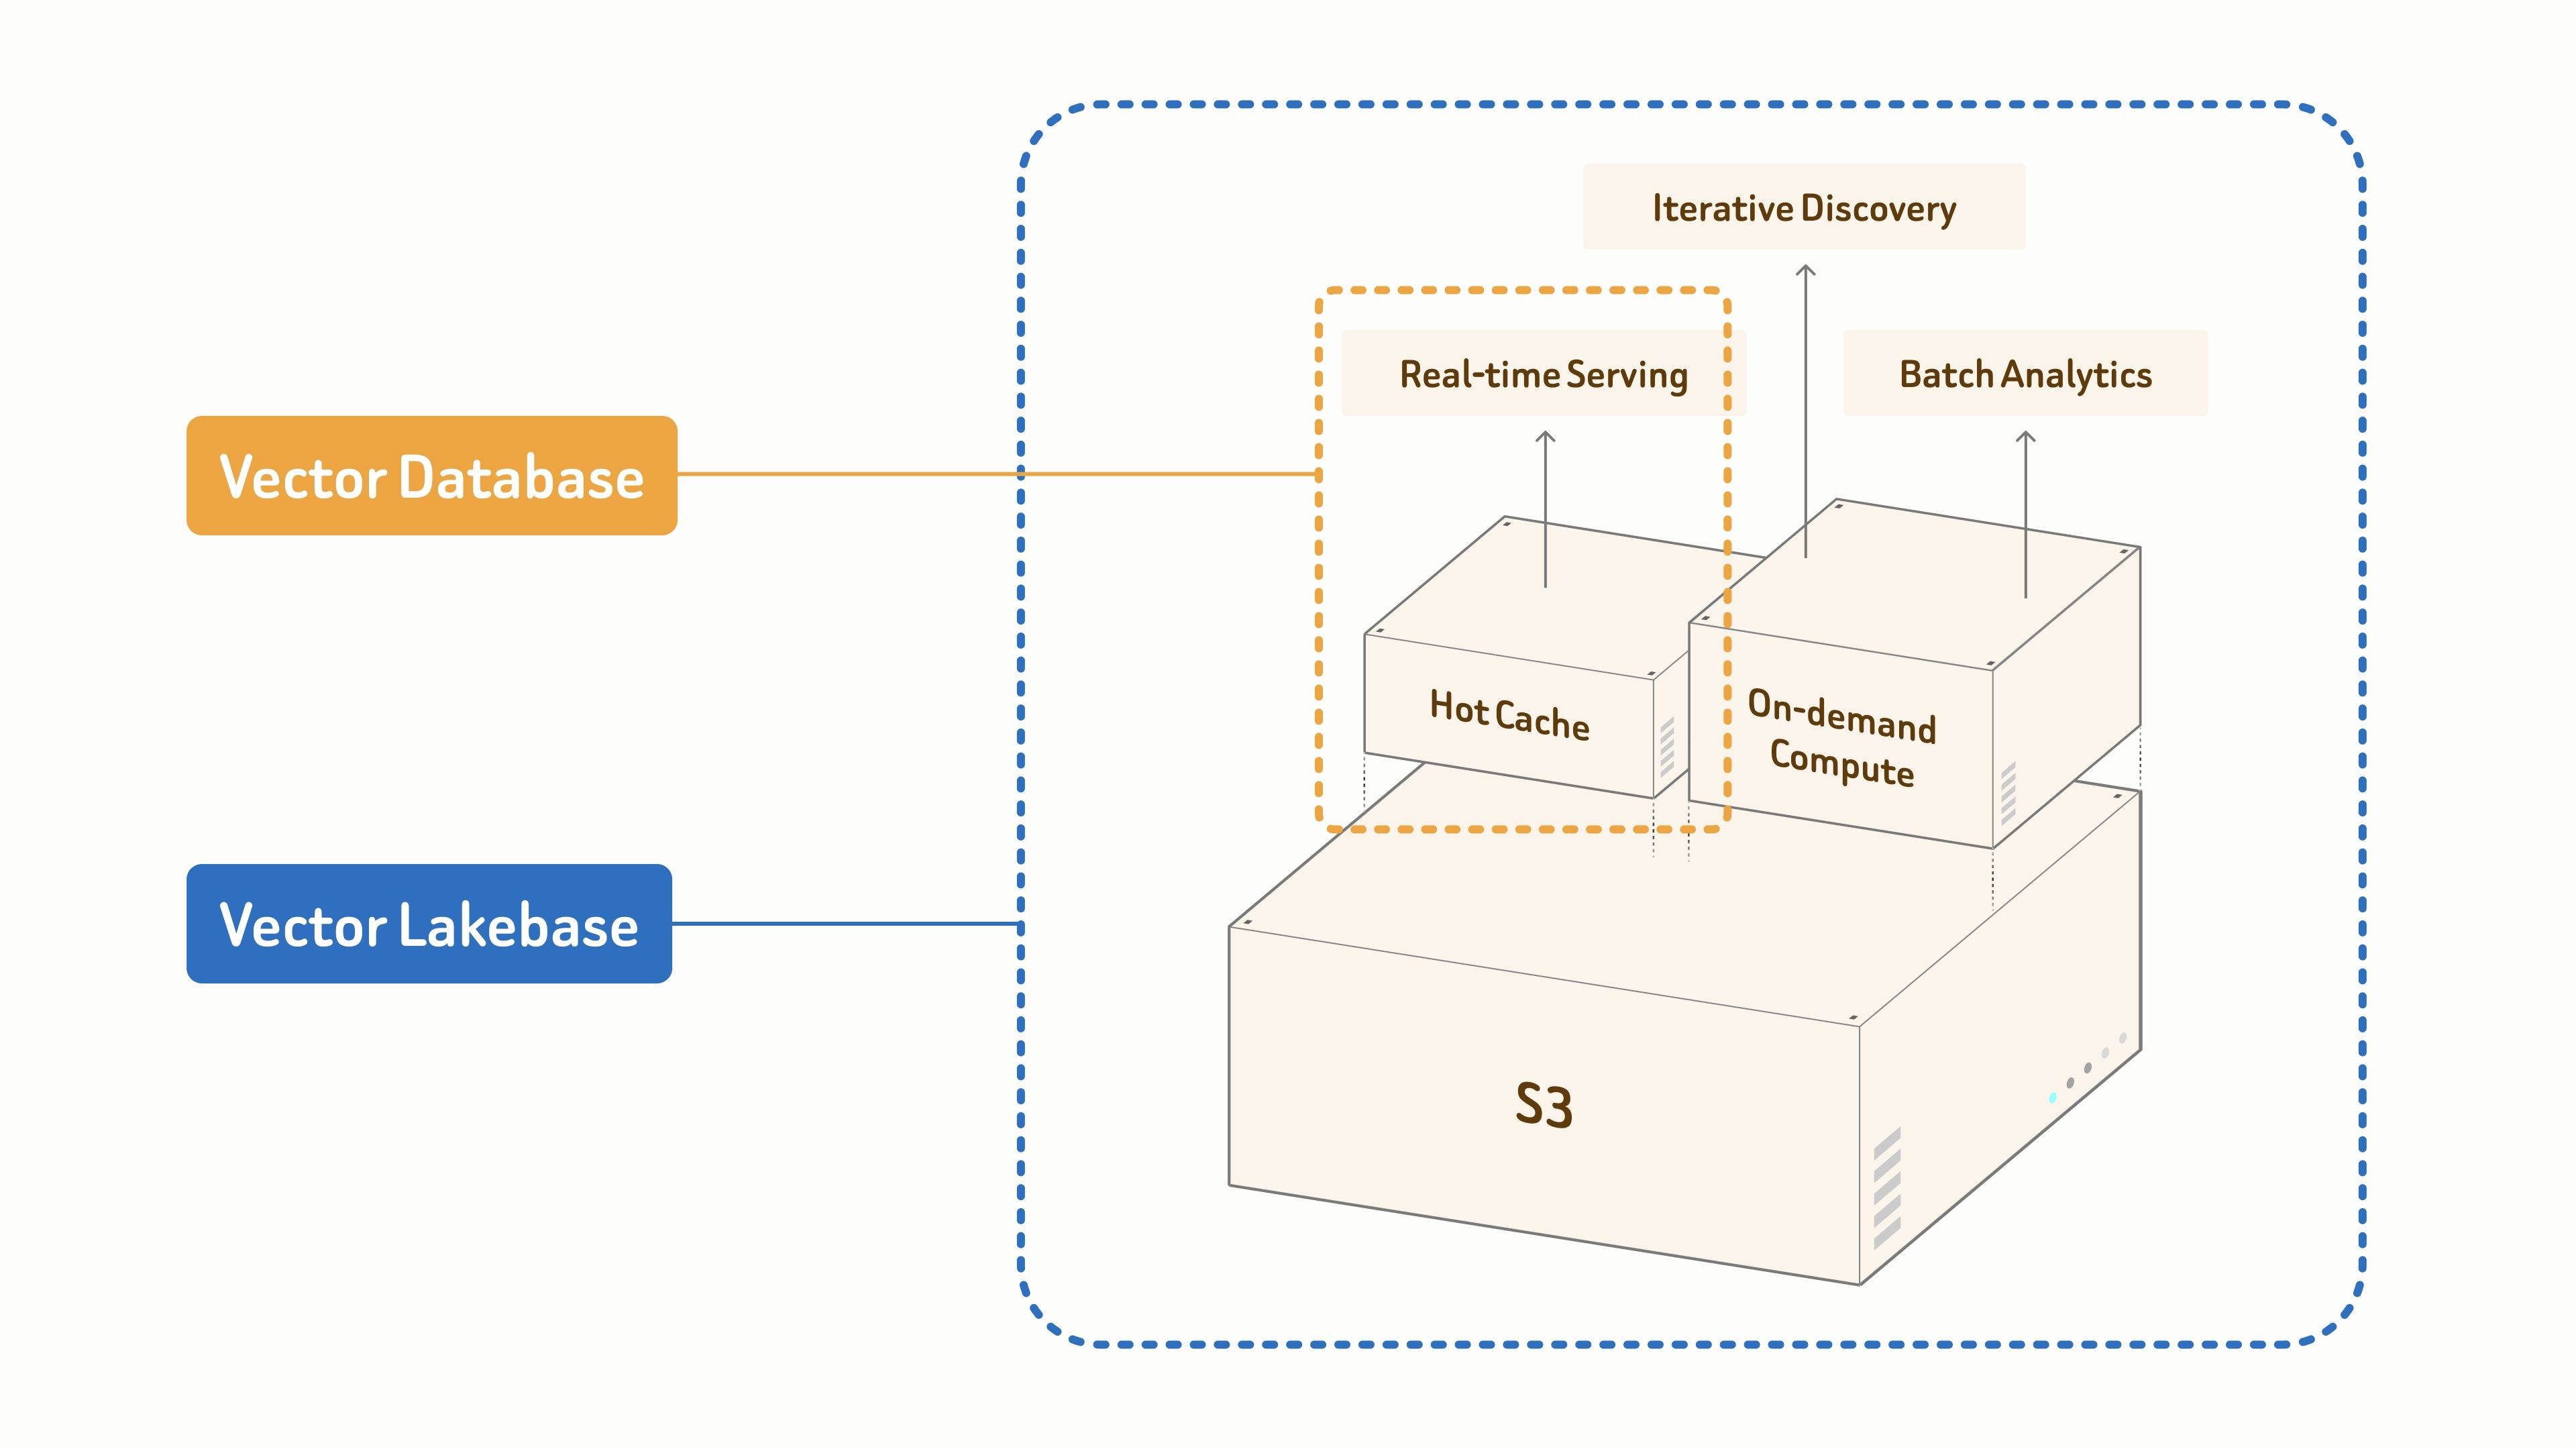
From Vector Database to Vector Lakebase
Zilliz offers a fully managed Vector Lakebase powered by Milvus, unifying real-time vector search, lake-scale discovery, and Al data operations.
Milvus 2.6.x Now Generally Available on Zilliz Cloud, Making Vector Search Faster, Smarter, and More Cost-Efficient for Production AI
Milvus 2.6.x is now GA on Zilliz Cloud, delivering faster vector search, smarter hybrid queries, and lower costs for production RAG and AI applications.
Multimodal Pipelines for AI Applications
Learn how to build scalable multimodal AI pipelines using DataVolo and Milvus. Discover best practices for handling unstructured data and implementing RAG systems.