




🚀 Что нового в фильтрации метаданных в Milvus v2.4.3
Milvus v2.4.3 представил полнотекстовое сопоставление метаданных! 🎉 Теперь вы можете сопоставлять строки, используя поиск по префиксу, инфиксу, постфиксу или даже с подстановочным символом для символа.
# Пример префикса, соответствует любой строке, начинающейся с “The”.
expression='title like "The%"'
# Пример инфикса, соответствует любой строке со словом “the” в любом месте предложения.
expression='title like "%the%"'
# Пример постфикса, соответствует любой строке, заканчивающейся на “Rye”.
expression='title like "%Rye"'
# Пример подстановочного символа для одного символа, соответствует любому одному символу в определенной позиции.
expression='title like "Flip_ed"'
В предыдущих блогах мы говорили только о сопоставлении строк по префиксу. Однако начиная с Milvus v2.4.3 также возможны все эти варианты, а также использование значений массивов — либо через точные совпадения, либо путем проверки, совпадают ли какие-либо элементы в массиве (contains_any()). 🗂️🔍
Эти обновления делают фильтрацию метаданных более гибкой и мощной!
Давайте сделаем всё это понятнее на примере. Для этого блога я буду использовать данные о фильмах IMDB, которые я скачал с Kaggle.
# Импорт распространенных библиотек.
import sys, os, time, pprint
import pandas as pd

# Чтение CSV-данных.
df = pd.read_csv("data/original_data.csv")

# Сокращение данных для демонстрации.
df = df.tail(200)
display(df.head())
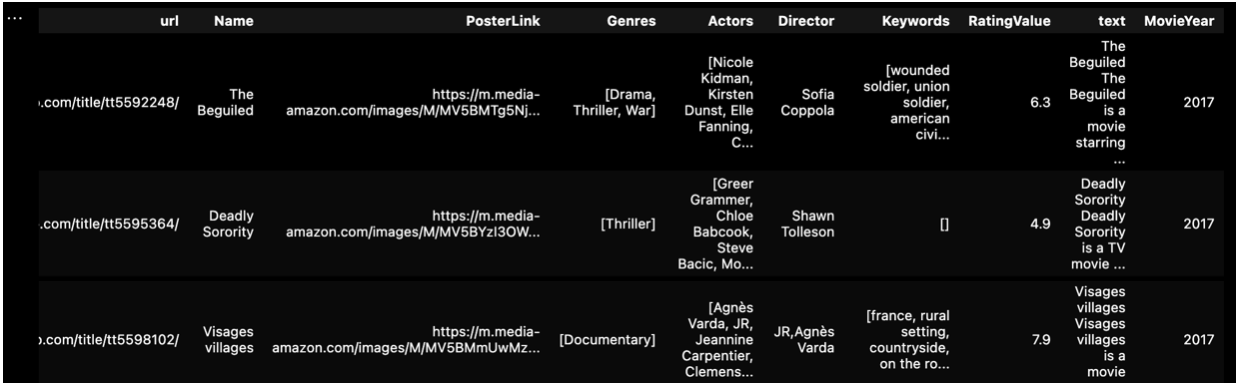
У каждого фильма есть поле ‘text’ с его описанием и отзывами. 📝
Каждый фильм включает метаданные, такие как год выпуска, рейтинг и списки жанров, актеров и ключевых слов. 🎬⭐️📅
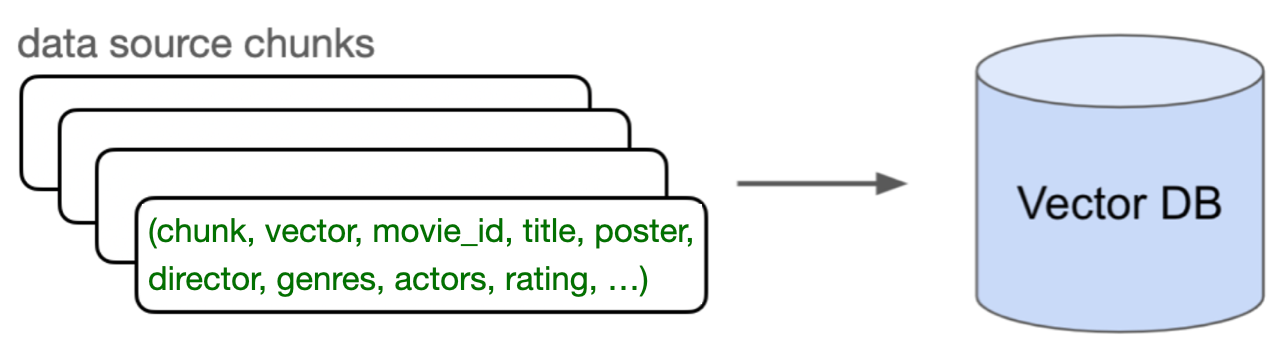
Каждая “строка” представляет собой фрагмент текста рецензии на фильм, его векторное представление и метаданные, такие как movie_id, название фильма, ссылка на постер, жанры и актеры.
Следуя обычному шаблону RAG: 📝🎬
Подключение к Milvus: Сначала подключитесь к Milvus Lite, локальному развертыванию Milvus. Это наша база данных для хранения векторов и управления ими. 🖥️🔗
Преобразование текста фильма в векторы: Возьмите текстовое поле каждого фильма, которое включает описание и отзыв, и преобразуйте его в вектор. Для этого мы будем использовать модель HuggingFace BAAI/bge-large-en-v1.5. 🧠➡️📏
📥📊 Вставка векторов и метаданных в Milvus: Вставьте этот вектор вместе с исходным текстом (называемым “chunk”) и его метаданными (такими как год, рейтинг, жанры и т. д.) в Milvus. 📥📊
Обработка пользовательских запросов: Преобразуйте запрос пользователя в вектор с помощью той же модели эмбеддингов. Затем выполните поиск Approximate Nearest Neighbors, чтобы найти векторы данных, ближайшие к вектору запроса. 🔍🎬
Полный код можно найти на моем GitHub.
Сначала подключитесь к Milvus. Вам нужно будет установить Pymilvus через pip. (Если указать только имя локального файла, используется Milvus Lite, локальная векторная база данных. Если у вас есть другой Milvus, например развернутый в docker или K8s, либо полностью управляемый Zilliz Cloud, вы можете указать URI и Token для подключения к ним. Остальной код работает так же.)
# !python -m pip install -U pymilvus
import pymilvus
# Подключение клиента к серверу Milvus Lite.
from pymilvus import MilvusClient
client = MilvusClient("milvus_demo.db")
Далее разбейте на фрагменты и преобразуйте в эмбеддинги текстовый столбец, содержащий рецензию на фильм, в векторы. Многие ресурсы приводят примеры того, как это сделать, поэтому я не буду снова показывать здесь код. Ниже я показываю, как собрать фрагментированный текст, векторное представление и метаданные, а также вставить данные в Milvus.
# Создайте chunk_list и dict_list в одном цикле
dict_list = []
for id, title, chunk, vector, poster_url, director,\
   genres, actors, keywords, film_year, rating in zip(
       df.id, df.Name, chunks, converted_values, df.PosterLink,
       df.Director, df.Genres, df.Actors, df.Keywords,
       df.MovieYear, df.RatingValue):

   # Соберите вектор embedding, исходный текстовый фрагмент, метаданные.
   chunk_dict = {
       'movie_index': id,
       'title': title,
       'chunk': chunk.page_content,
       'poster_url': poster_url,
       'director': director,
       'genres': genres,
       'actors': actors,
       'keywords': keywords,
       'film_year': film_year,
       'rating': rating,
       'vector': vector,
   }
   dict_list.append(chunk_dict)

# Вставьте данные в коллекцию Milvus.
print("Start inserting entities")
start_time = time.time()
client.insert(
   COLLECTION_NAME,
   data=dict_list,
   progress_bar=True)

end_time = time.time()
print(f"Milvus insert time for {len(dict_list)} vectors: ", end="")
print(f"{np.round(end_time - start_time, 2)} seconds")

Теперь, когда данные находятся в Milvus, мы готовы к поиску!
Поиск с использованием строковых фильтров метаданных
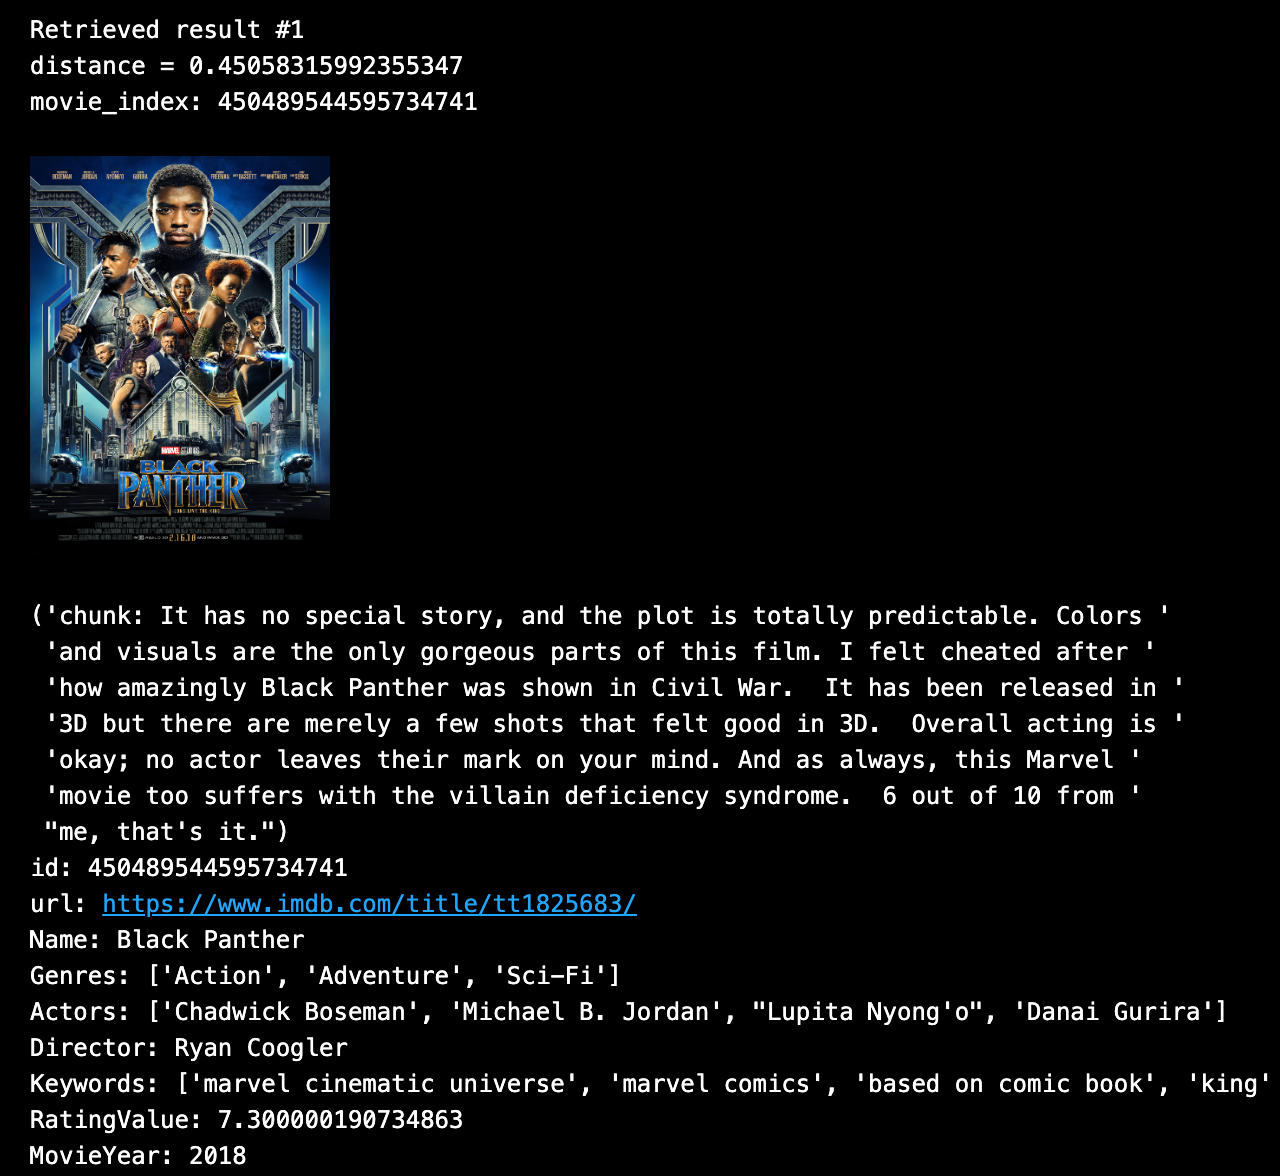
Допустим, мы хотим найти научно-фантастические фильмы о антиутопическом будущем с роботами и с высоким рейтингом. В наших примерных данных есть метаданные, которые можно использовать для этого поиска.
Вот пример фильтрации метаданных с использованием нечетких строковых совпадений. Ниже я обернул vanilla Milvus search API только для того, чтобы удобнее отображать метаданные после каждого поиска.
SAMPLE_QUESTION = "Dystopia science fiction with a robot."
TOP_K = 1
# Metadata filters.
expression='rating >= 7'
# Infix string match.
expression=expression + ' && title like "%Panther%"'
formatted_results, contexts, context_metadata = \
     mc_run_search(SAMPLE_QUESTION, expression, TOP_K)
Ресурсы и дополнительное чтение
Использование полей-массивов | Документация Milvus
https://github.com/milvus-io/pymilvus/blob/2.4/examples/fuzzy_match.py
https://milvus.io/docs/boolean.md#Usage
https://milvus.io/docs/single-vector-search.md#Filtered-search
Читать далее
A Few Notes from Databricks Data + AI Summit 2026: Why the Data Layer Matters Again
James Luan shares notes from Databricks Data + AI Summit 2026 on why production AI is pushing the data layer back to the center of infrastructure.
DeepSeek-OCR Explained: Optical Compression for Scalable Long-Context and RAG Systems
Discover how DeepSeek-OCR uses visual tokens and Contexts Optical Compression to boost long-context LLM efficiency and reshape RAG performance.

The Real Bottlenecks in Autonomous Driving — And How AI Infrastructure Can Solve Them
Autonomous driving faces a data bottleneck. Learn how AI-native vector databases like Zilliz solve scale, cost, and insight challenges across AV pipelines.