Выбор правильных инструментов ETL для неструктурированных данных при подготовке к ИИ
Сколько данных вашей организации действительно используется? Если вы похожи на большинство предприятий, ответ — не так много. Это связано с тем, что более 90% данных, генерируемых предприятиями, являются неструктурированными — распределены по документам, электронным письмам, видео и многому другому. В отличие от структурированных данных, которые укладываются в строки и столбцы, неструктурированные данные не имеют фиксированной схемы, что усложняет их обработку.
Управление неструктурированными данными затруднено из-за несогласованных форматов и разнообразных источников. Они обладают огромным потенциалом для бизнес-аналитики (BI), искусственного интеллекта (AI) и принятия решений. Организации, которые эффективно обрабатывают неструктурированные данные, получают более глубокие инсайты, улучшают автоматизацию и повышают качество клиентского опыта.
Extract, Transform, and Load (ETL) — это процесс, который перемещает данные из различных источников, преобразует их в пригодный для использования формат и загружает в целевую систему. Процессы ETL были созданы для структурированных данных, с использованием заранее определенных схем и жестких преобразований. В результате они плохо справлялись со сложностью и изменчивостью неструктурированных данных. Современные инструменты ETL используют передовые методы, такие как обработка естественного языка (NLP) и машинное обучение (ML). Эти возможности позволяют эффективно обрабатывать, стандартизировать и хранить неструктурированные данные в векторных базах данных. Это делает данные более удобными для поиска, анализа и использования в приложениях на основе AI, таких как прогнозная аналитика, чатботы и графы знаний.
В этом блоге рассматриваются инструменты ETL для неструктурированных данных, ключевые сложности и то, как выбрать подходящий инструмент для вашего сценария использования. Также включено сравнение различных ETL-решений.
Что такое ETL?
ETL означает Extract, Transform, and Load. Это ключевой процесс интеграции данных, который извлекает данные, преобразует их в согласованный и пригодный для использования формат и загружает в целевую систему, такую как хранилище данных или векторная база данных.
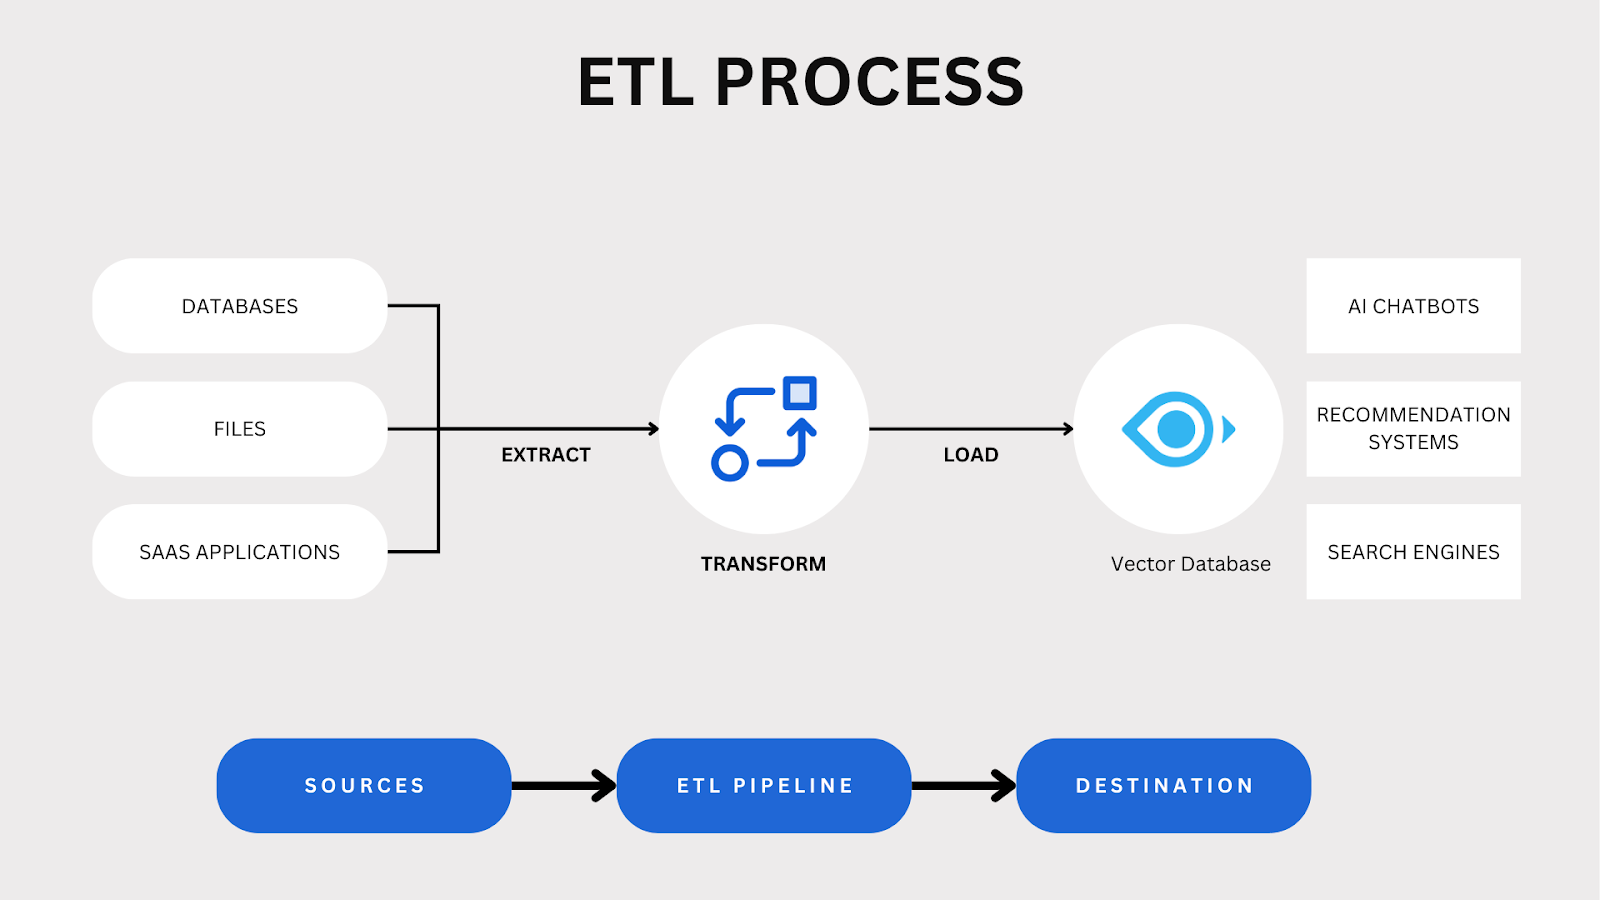
Обзор процесса ETL
Существует несколько этапов процесса ETL:
Извлечение: Данные собираются из различных источников, включая PDF, электронные письма, видео, изображения и ленты социальных сетей. Неструктурированный контент требует специализированных методов, таких как оптическое распознавание символов (OCR) для отсканированных документов, преобразование речи в текст для аудиофайлов и извлечение метаданных из изображений или видео. Цель — получить всю релевантную информацию независимо от ее структуры.
Преобразование: Извлеченные данные обрабатываются для соответствия бизнес- или техническим требованиям. Это включает очистку, нормализацию, агрегирование и применение бизнес-правил для обеспечения точности и удобства использования.
Загрузка: Обработанные данные сохраняются в системе, оптимизированной для неструктурированного контента, такой как векторная база данных. Эти системы обеспечивают эффективное индексирование, извлечение и анализ многомерных данных, упрощая поддержку принятия решений.
ETL помогает организациям консолидировать данные из нескольких источников, делая их доступными и готовыми к анализу. С помощью эффективных стратегий ETL компании могут получать инсайты, повышать эффективность и сохранять конкурентоспособность в мире, управляемом данными.
Популярные ETL-инструменты для неструктурированных данных
Выбор подходящего ETL-инструмента для вашего сценария использования имеет решающее значение, будь то создание AI-моделей или настройка конвейера генерации с дополненным извлечением (RAG). Несколько ETL-инструментов помогают управлять интеграцией неструктурированных данных с вашей векторной базой данных. Ниже приведен обзор заметных инструментов, их ключевых функций и сценариев использования.
1. Airbyte
Airbyte — это инфраструктура перемещения данных с открытым исходным кодом для создания конвейеров данных extract and load (EL). Она упрощает перемещение неструктурированных и полуструктурированных данных с помощью коннекторов источников данных.
Ключевые функции и возможности:
Обширный каталог коннекторов: Предлагает более 550 готовых коннекторов, поддерживающих как структурированные, так и неструктурированные источники данных.
Интеграция с AI: Поддерживает рабочие процессы генеративного AI (GenAI), перемещая данные из сотен популярных источников в векторные базы данных.
Настройка и расширяемость: Предоставляет платформу с открытым исходным кодом для создания пользовательских коннекторов с помощью low-code/no-code инструментов за считанные минуты.
Варианты использования:
Создание конвейеров retrieval-augmented generation (RAG).
Интеграция неструктурированных данных в модели AI и машинного обучения.
Консолидация данных из нескольких источников для комплексного анализа.
2. Fivetran
Fivetran — это управляемый сервис интеграции данных, который автоматизирует перемещение данных из различных источников в хранилища данных или векторные базы данных.
Ключевые функции и возможности:
Готовые коннекторы: Предлагает более 650 no-code коннекторов, включая SaaS-приложения, базы данных и ERP-системы.
Автоматизированная синхронизация данных: Непрерывно обновляет данные от источника к назначению без ручного вмешательства.
Поддержка преобразований: Модели данных Fivetran сразу преобразуют необработанные данные в готовые к промышленному использованию таблицы для получения аналитических выводов.
Встроенная миграция схемы: Поддерживает встроенную миграцию схемы для бесшовной репликации данных.
Варианты использования:
Централизация данных из нескольких баз данных и инструментов software-as-a-service (SaaS), таких как Salesforce и Zendesk.
Поддержание аналитических баз данных в актуальном состоянии с минимальными усилиями.
Упрощение ETL-процессов для структурированных и неструктурированных источников данных.
3. Unstructured.io
Unstructured — это платформа, предназначенная для загрузки, обработки и преобразования неструктурированных документов для AI-приложений, таких как RAG и дообучение моделей.
Ключевые функции и возможности:
Разнообразные источники данных: Поддерживает различные типы файлов, включая текстовые документы, изображения, PDF-файлы и презентации, обеспечивая бесшовную загрузку из нескольких форматов.
Готовность к LLM: Предоставляет коннекторы для захвата данных там, где они находятся, и преобразования их в удобные для AI JSON-файлы.
Совместимость: Бесшовно интегрируется с основными векторными базами данных и фреймворками LLM.
Варианты использования:
Подготовка неструктурированных данных для приложений AI и машинного обучения.
Повышение качества данных для корпоративной аналитики.
Интеграция неструктурированных данных в архитектуры генеративного AI.
4. Vectorize
Vectorize автоматизирует извлечение данных, находит оптимальную стратегию векторизации с использованием оценки RAG и позволяет быстро развертывать RAG-конвейеры реального времени для ваших неструктурированных данных.
Ключевые функции и возможности:
RAG-as-a-Service: Создавайте высокооптимизированные поисковые индексы, которые гарантируют, что у ваших AI-приложений всегда будут необходимые им данные.
Неструктурированные данные в индексы: Автоматически извлекайте текст, изображения и таблицы из PDF-файлов, Word Docs, PowerPoint и других источников.
Подключение: Загружайте данные из документов ваших клиентов, баз знаний и SaaS-платформ.
Варианты использования:
Создание и поддержка автоматизированных конвейеров retrieval-augmented generation (RAG)
Развертывание надежного конвейера, способного управлять векторными данными миллиардного масштаба и предоставлять ответы в реальном времени.
Превращение ваших неструктурированных данных в оптимизированные поисковые индексы.
5. Unstract
Unstract — это no-code платформа, которая автоматизирует рабочие процессы обработки документов в любом масштабе. Она использует передовой ИИ, чтобы превзойти текущие возможности Intelligent Document Processing (IDP) и Robotic Process Automation (RPA).
Ключевые функции и возможности:
Автоматизированное структурирование данных: Использует большие языковые модели (LLMs) для преобразования неструктурированных данных в структурированные форматы без значительных ручных усилий.
Универсальная обработка данных: Поддерживает различные типы неструктурированных данных, включая текст, изображения и мультимедиа.
Уникальный подход к извлечению: Использует систему с двумя LLM, где одна модель выступает в роли экстрактора, а другая — в роли оспаривающей; обе должны согласиться со значением извлеченного поля, прежде чем оно будет финализировано.
Варианты использования:
Упрощение подготовки неструктурированных данных для платформ бизнес-аналитики.
Создание оптимизированных для ИИ выходных данных из неструктурированных документов.
Улучшение понимания LLM извлеченных данных документов.
Проблемы ETL для неструктурированных данных
ETL для неструктурированных данных сопряжен с уникальными проблемами из-за разнообразной и непредсказуемой природы данных. Обработка различных форматов, обеспечение качества данных и поддержание согласованности могут быть сложными. Ниже приведены некоторые ключевые проблемы
Разнообразие данных: Неструктурированные данные представлены в таких форматах, как текст, изображения, видео и аудио. Обработка нескольких типов требует продвинутых инструментов.
Отсутствие схемы: В отличие от структурированных данных, неструктурированные данные не имеют заранее заданной схемы, что затрудняет прямое извлечение значимой информации.
Сложность преобразования: Преобразование неструктурированных данных в структурированные форматы требует сложных преобразований, часто с использованием NLP и машинного обучения.
Качество и согласованность данных: Неструктурированные данные содержат ошибки и несоответствия. Обеспечение точности затруднено из-за разных форматов и отсутствия фиксированной схемы.
Сложности интеграции: Объединение неструктурированных данных из нескольких источников является сложным. Стандартизация форматов необходима для бесшовной интеграции.
Специализированные инструменты и фреймворки ETL помогают решать эти проблемы, делая неструктурированные данные более управляемыми и готовыми для ИИ.
Сравнение и рекомендации
Выбор подходящего инструмента ETL для неструктурированных данных имеет решающее значение для эффективной интеграции и анализа данных. Ниже приведено сравнение нескольких популярных инструментов ETL для неструктурированных данных с выделением их ключевых функций, вариантов использования и потенциальных ограничений:
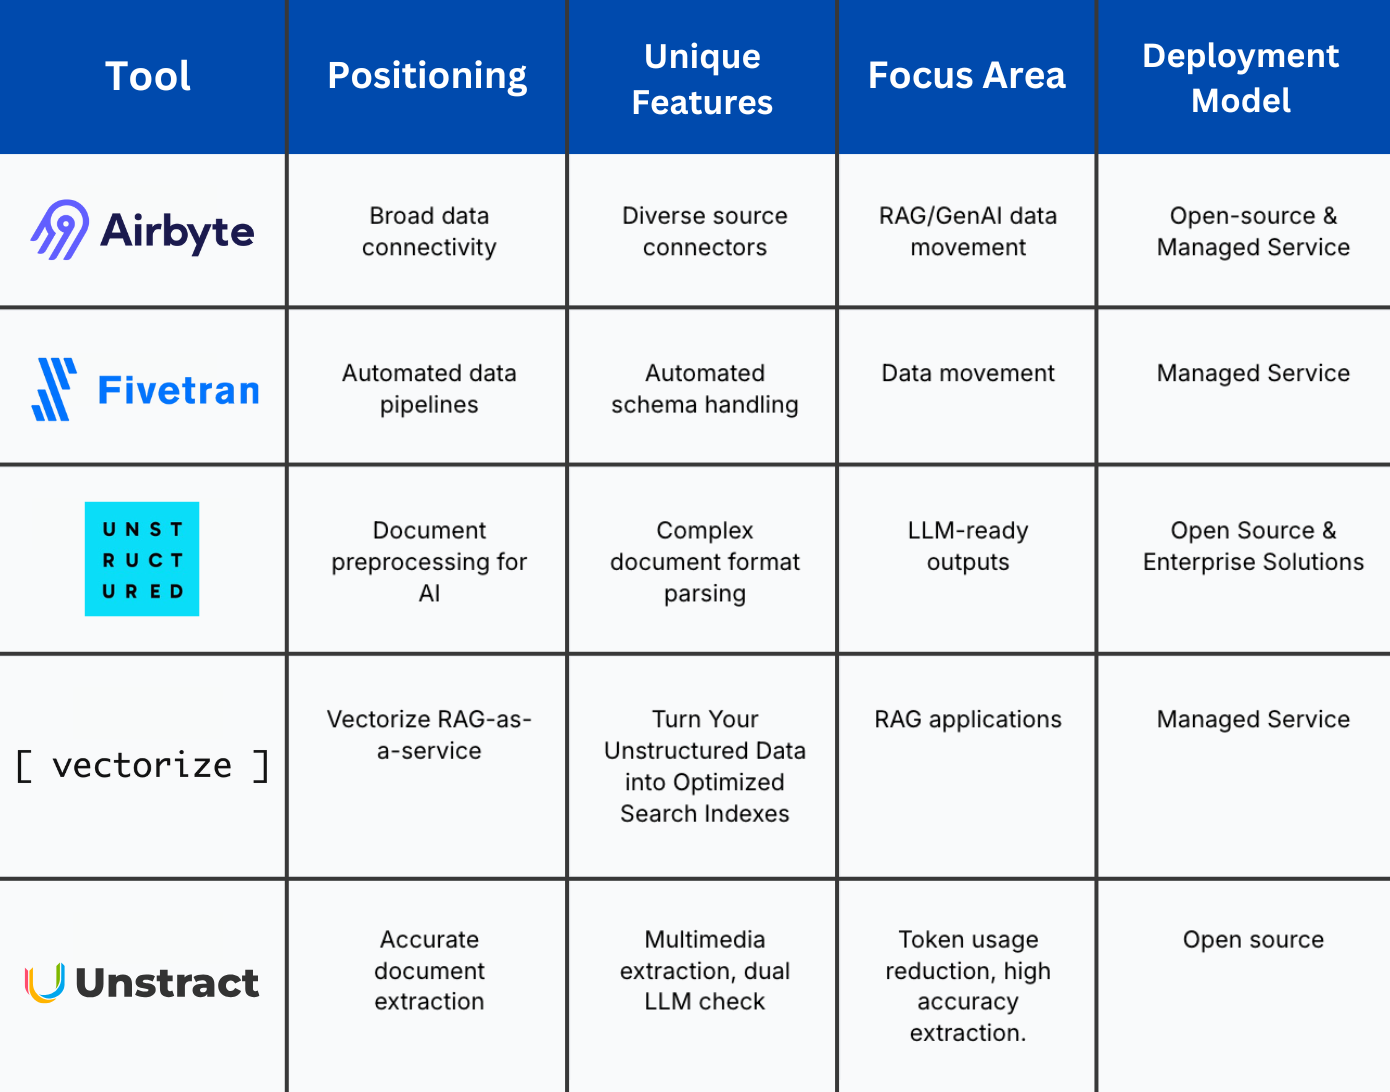 Сравнение инструментов ETL
Рекомендации
Выбор инструмента ETL зависит от ваших целей и технических требований. Нужно ли вам централизовать данные из нескольких источников, интегрироваться с ИИ или отдать приоритет open-source решению? Ниже приведены рекомендации для разных вариантов использования:
Для интеграции с ИИ и машинным обучением: Unstructured.io, VectorETL и Unstract хорошо подходят для проектов, ориентированных на ИИ-приложения, предлагая надежную поддержку преобразования неструктурированных данных в форматы, совместимые с ИИ.
Для комплексной централизации данных: Airbyte и Fivetran предоставляют обширные коннекторы, что делает их идеальными для консолидации данных из нескольких источников, как структурированных, так и неструктурированных.
Для организаций, ищущих open-source решения: Airbyte предлагает широкий набор коннекторов и настраиваемых функций, что делает его идеальным для команд, желающих адаптировать свои ETL-процессы.
Для сложных задач обработки документов: Unstract выделяется своим подходом с двумя LLM, обеспечивая высокую точность извлечения данных из разных типов документов.
Практические сведения по внедрению
Начало с пилотных проектов: Выберите конкретный источник неструктурированных данных и запустите небольшой ETL-проект с использованием выбранного инструмента. Это поможет оценить совместимость, эффективность и возможности инструмента перед переходом к полномасштабному внедрению.
Межфункциональное сотрудничество: Поощряйте сотрудничество между дата-инженерами, аналитиками и профильными экспертами. Это гарантирует, что ETL-процессы соответствуют бизнес-целям и используют специализированную экспертизу для более эффективной обработки данных и принятия решений.
Масштабирование ETL-процессов: По мере роста объемов и сложности данных убедитесь, что выбранный ETL-инструмент может эффективно масштабироваться. Учитывайте такие факторы, как скорость обработки, поддержка коннекторов и совместимость с различными форматами неструктурированных данных.
Вы можете обеспечить более плавный и эффективный рабочий процесс, тщательно оценивая ETL-инструменты с учетом ваших потребностей. Пилотный проект помогает проверить правильность выбора инструмента, минимизируя сложности интеграции и максимизируя ценность неструктурированных данных. Если ваш сценарий использования — RAG, выбор инструмента с надежной поддержкой разбиения на чанки, эмбеддингов и векторного хранилища упрощает внедрение.
Раскройте потенциал неструктурированных данных для ИИ с помощью векторного поиска
Неструктурированные данные — такие как текст, изображения и видео — содержат ценные инсайты, которые часто остаются неиспользованными из-за своей сложности. Интеграция векторного поиска в AI-процессы раскрывает их полный потенциал. Векторный поиск обеспечивает обработку и анализ неструктурированных данных, преобразуя их в векторные эмбеддинги, что позволяет AI-моделям выявлять скрытые закономерности.
Зачем осваивать неструктурированные данные для ИИ с помощью векторного поиска?
Раскрывайте скрытые инсайты: Неструктурированные данные содержат сложную информацию. Векторный поиск выявляет закономерности и тренды, которые традиционные методы часто упускают. Это помогает компаниям принимать решения на основе данных и получать конкурентное преимущество.
Разрушайте разрозненность данных: Организации хранят неструктурированные данные на нескольких платформах, создавая разрозненные хранилища. Векторный поиск бесшовно интегрирует разнообразные источники для комплексного анализа. Это обеспечивает глубокий анализ и способствует получению более качественных инсайтов и стратегий, основанных на данных.
Улучшайте приложения генеративного ИИ: Преобразование неструктурированных данных в векторные эмбеддинги обеспечивает более точный, контекстно-зависимый поиск. Это улучшает AI-приложения, повышая качество пользовательского опыта и релевантность результатов.
Интеграция Milvus/Zilliz Cloud с ETL-инструментами
Milvus, векторная база данных с открытым исходным кодом, и Zilliz Cloud, ее управляемый сервис, обрабатывают крупномасштабные векторные данные для AI-приложений. Zilliz предлагает множество интеграций векторных баз данных, максимально раскрывая потенциал неструктурированных данных. Она поддерживает более 1 000 коннекторов, обеспечивая бесшовную интеграцию различных источников неструктурированных данных для поиска и анализа на базе ИИ.
Интеграция с Airbyte: Milvus предоставляет коннектор для Airbyte, обеспечивая бесшовную загрузку неструктурированных данных из различных источников в векторную базу данных. Это упрощает ETL-процессы и повышает готовность к использованию ИИ.
Интеграция с Fivetran: Благодаря коннектору Milvus для Fivetran организации могут автоматизировать перенос структурированных и неструктурированных данных в векторную базу данных. Такая настройка оптимизирует поиск и аналитику на базе ИИ.
Интеграция с Unstructured.io: Milvus интегрируется с Unstructured.io, обеспечивая прямую загрузку преобразованных неструктурированных данных в векторную базу данных. Это гарантирует, что AI-модели смогут эффективно обрабатывать и извлекать инсайты.
Начало работы с векторным поиском
Выберите подходящий ETL-инструмент: Выберите ETL-инструмент, который соответствует вашим источникам данных и бизнес-требованиям. Учитывайте такие факторы, как масштабируемость, простота интеграции и поддержка неструктурированных данных.
Интегрируйте с Milvus/Zilliz Cloud: Используйте коннекторы Milvus выбранного ETL-инструмента. Эта интеграция обеспечивает бесшовную загрузку и хранение векторных эмбеддингов, полученных из неструктурированных данных.
Разрабатывайте AI-приложения: Используйте векторные данные, хранящиеся в Milvus/Zilliz Cloud, для создания AI-приложений, таких как чат-боты, рекомендательные системы и интеллектуальные поисковые системы. Эти решения обеспечивают расширенный поиск и анализ, извлекая ценные сведения из неструктурированных данных для стимулирования инноваций и принятия обоснованных решений.
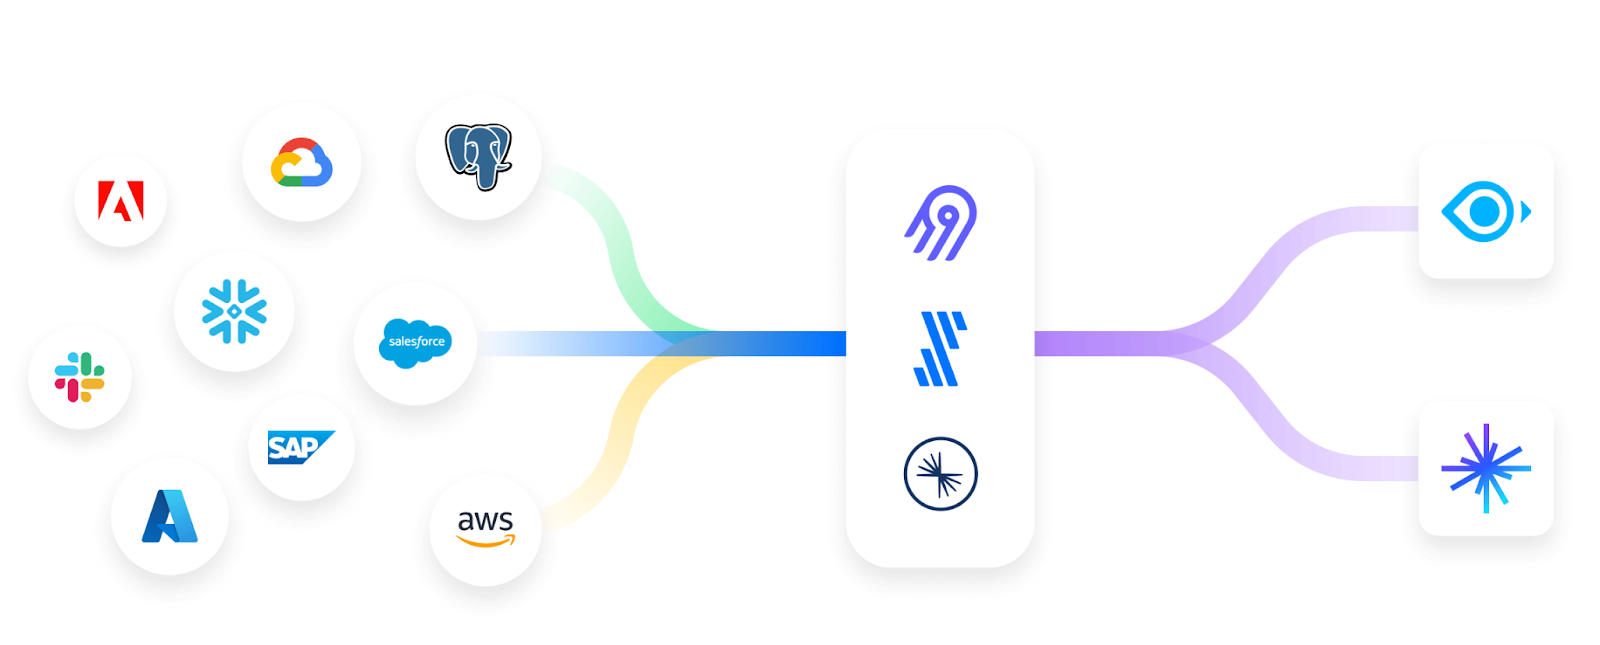
Источники неструктурированных данных для коннекторов Milvus | Источник
Заключение
Эффективное управление неструктурированными данными имеет решающее значение для организаций, стремящихся максимально использовать потенциал AI и машинного обучения. Инструменты ETL, такие как Airbyte, Fivetran, Unstructured.io, VectorETL и Unstract, предлагают надежные решения для обработки и интеграции неструктурированных данных.
Интеграция этих инструментов ETL с векторными базами данных, такими как Milvus, расширяет возможности поиска на основе AI и продвинутой аналитики. Zilliz упрощает этот процесс, обеспечивая бесшовные интеграции ETL и позволяя компаниям загружать данные из более чем 1 000 неструктурированных источников напрямую в Milvus.
Выбор подходящих инструментов ETL и интеграций позволяет компаниям находить ценные инсайты, стимулировать инновации и сохранять конкурентоспособность в мире, движимом AI.
Связанные ресурсы
Читать далее
Announcing VDBBench 1.0: Open-Source VectorDB Benchmarking with Your Real-World Production Workloads
Discover VDBBench 1.0, an open-source tool for benchmarking vector databases with real-world production data, streaming ingestion, and concurrent workloads.
Bringing AI to Legal Tech: The Role of Vector Databases in Enhancing LLM Guardrails
Discover how vector databases enhance AI reliability in legal tech, ensuring accurate, compliant, and trustworthy AI-powered legal solutions.
Building RAG Pipelines for Real-Time Data with Cloudera and Milvus
explore how Cloudera can be integrated with Milvus to effectively implement some of the key functionalities of RAG pipelines.