Обработка потоковых данных в Kafka с помощью Timeplus Proton
В апреле 2024 года Джов Чжун, сооснователь Timeplus, выступил на Seattle Unstructured Data Meetup с докладом на тему "Processing Streaming Data in Kafka with Timeplus Proton." Как эксперт в области потоковой передачи данных и обработки в реальном времени, Джов представил всесторонний обзор того, как Timeplus интегрируется с Kafka для работы с данными в реальном времени, а также провел для нас живые демо, которые были одновременно увлекательными и образовательными. Давайте рассмотрим ключевые моменты и выводы из этой содержательной сессии.
Ссылка на запись выступления Джова Чжуна на YouTube: Смотреть выступление на YouTube
Timeplus и ее возможности реального времени
Джов Чжун — маэстро программной инженерии. Если вы мне не верите, взгляните на его послужной список. Сооснователь и руководитель продукта в Timeplus, бывший директор по инженерии в Splunk, обладатель 17 патентов и 4 сертификаций AWS. Да, и он является “папой мирового класса” с 2010 года. Джов проводит увлекательные параллели между отцовством и бизнес-лидерством, показывая, что воспитание ребенка и управление компанией имеют больше общего, чем можно подумать.
С учетом этого давайте углубимся в доклад Джова “Processing Streaming Data in Kafka with Timeplus Proton.”
Штаб-квартира Timeplus находится в Санта-Кларе, Калифорния, и компания революционизирует работу с данными в реальном времени благодаря своей инновационной потоковой SQL-базе данных и платформе аналитики в реальном времени. При поддержке ведущих венчурных инвесторов и технологов Timeplus предлагает как открытые, так и коммерческие версии, обеспечивая эффективное управление и обработку потоков данных в реальном времени. Среди ее выдающихся возможностей — динамические панели мониторинга и обработка на основе SQL, что делает манипулирование данными в реальном времени доступным и удобным для пользователя.
Timeplus Proton, ядро Timeplus, служит мощной альтернативой таким платформам, как ksqlDB и Apache Flink. Оно легковесное, написано на C++ и оптимизировано для производительности. Благодаря таким возможностям, как потоковый ETL, оконные функции и агрегация с высокой кардинальностью, Proton позволяет разработчикам эффективно решать задачи обработки потоковых данных. Платформа поддерживает различные источники данных, включая Apache Kafka, Confluent Cloud и Redpanda, а также обеспечивает получение аналитики и оповещений в реальном времени.
Будь то FinTech, ИИ, машинное обучение или наблюдаемость, Timeplus предоставляет сквозные возможности, которые помогают командам по работе с данными быстро и интуитивно обрабатывать потоковые и исторические данные. Это простое, мощное и экономически эффективное решение, разработанное для организаций любого размера и из любых отраслей.
Живая демонстрация: мониторинг цены Bitcoin в реальном времени
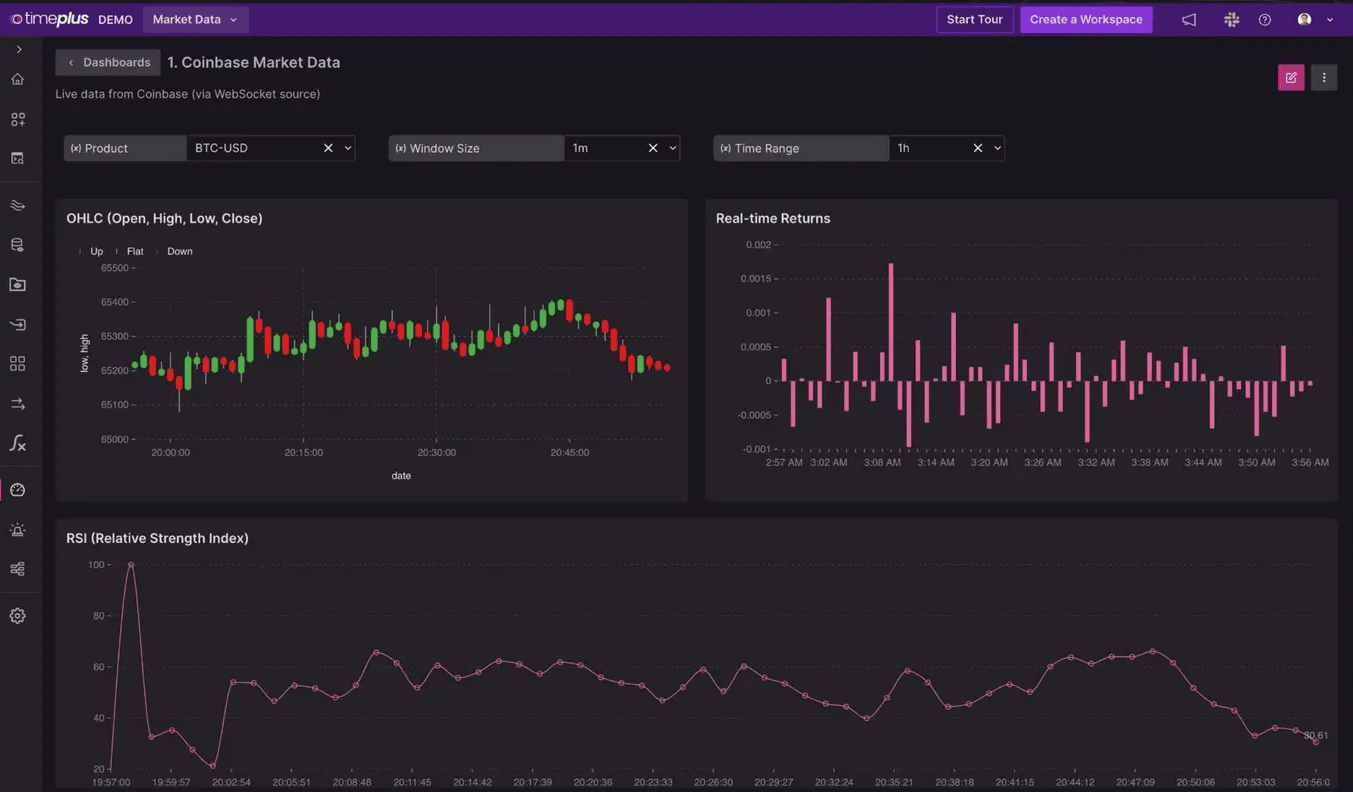
Для начала Джов продемонстрировал возможности Timeplus в реальном времени, показав живой поток цен Bitcoin. Эта демонстрация была не просто показом технологической мощи, но и иллюстрацией того, как Timeplus может обрабатывать и отображать данные быстрее, чем традиционные источники вроде Google. Аудитория была впечатлена, когда Джов сравнил поток в реальном времени с данными Google, подчеркнув превосходную производительность Timeplus.
Kafka: основа потоковой передачи данных в реальном времени
Джов подробно рассказал о Kafka, объяснив ее архитектуру и функциональность. Kafka — это мощная платформа потоковой передачи событий с открытым исходным кодом для работы с различными типами данных и управления распределенными вычислительными средами. Написанная на Java и Scala, Kafka предназначена для обработки потоков данных в реальном времени с высокой пропускной способностью и низкой задержкой. Ей доверяют более 80% компаний из Fortune 100, включая таких гигантов отрасли, как Goldman Sachs, Target и Cisco, а Kafka известна своей надежностью и производительностью.
Понимание архитектуры Kafka
Kafka функционирует как распределенная платформа потоковой передачи данных, способная обрабатывать миллионы событий в секунду. Визуализируя архитектуру Kafka с помощью следующей диаграммы, Jove продемонстрировал способность платформы обрабатывать потоки данных в реальном времени с высокой пропускной способностью и низкой задержкой, что делает ее мощным инструментом для современных задач потоковой передачи данных. Диаграмма объясняет архитектуру того, как производители, потребители и брокеры работают вместе, чтобы обеспечить эффективную обработку и доставку данных. Он также обсудил стратегии репликации и партиционирования Kafka, которые обеспечивают отказоустойчивость и масштабируемость.
Kafka функционирует как распределенная система, состоящая из серверов и клиентов, взаимодействующих через высокопроизводительный сетевой протокол TCP. Ее можно развертывать на физическом оборудовании, виртуальных машинах и в контейнерах как в локальных, так и в облачных средах.

Архитектура Kafka, как показано на диаграмме, состоит из нескольких ключевых компонентов:
Клиенты и брокеры: Kafka функционирует как распределенная система, состоящая из клиентов и брокеров. Клиенты — это приложения, которые создают и потребляют сообщения. Брокеры — это серверы, которые хранят и пересылают эти сообщения. Диаграмма показывает, как клиенты подключаются к брокеру, который выступает в роли bootstrap-сервера для маршрутизации данных к другим брокерам в кластере.
Производители и потребители: Производители отвечают за отправку данных в топики Kafka, а потребители считывают данные из этих топиков. Диаграмма показывает, как производитель отправляет сообщения в разные топики (Topic A, Topic B, Topic C) через несколько брокеров. Затем потребители считывают данные из этих топиков, обеспечивая эффективную обработку и доставку данных.
Топики и партиции: Топики Kafka разделены на партиции, что позволяет выполнять параллельную обработку данных. Каждая партиция реплицируется на несколько брокеров для обеспечения отказоустойчивости. Диаграмма показывает топик с тремя партициями, которые потребляются разными потребителями, демонстрируя, как Kafka распределяет нагрузку и поддерживает высокую доступность.
Масштабируемость и отказоустойчивость: Кластеры Kafka обладают высокой масштабируемостью и могут охватывать несколько дата-центров или облачных регионов. Архитектура поддерживает эластичное расширение и сокращение, обеспечивая непрерывную работу без потери данных. Если брокер выходит из строя, система может восстановиться, перенаправив данные к другим брокерам.
Потоковые LLM и векторные базы данных
Значительная часть выступления была посвящена изучению того, как потоковая передача данных интегрируется с большими языковыми моделями (LLM) и векторными базами данных. Jove подчеркнул потенциал этих интеграций для улучшения AI-приложений, делая обработку данных более эффективной и точной. Объединение потоковых данных с моделями AI может значительно повысить отзывчивость и интеллектуальность различных приложений.
Недавно Zilliz Cloud и Confluent Cloud for Apache Flink® объявили о партнерстве, которое дополнительно демонстрирует эту концепцию. Используя это, вы можете создавать GenAI-приложения реального времени с помощью Kafka и Flink; компании могут создавать конвейеры данных реального времени, которые передают данные в векторные базы данных, такие как Milvus. Такая конфигурация позволяет разрабатывать продвинутые AI-приложения, такие как семантический поиск в реальном времени и генерация с дополнением извлечением (RAG). Благодаря обработке данных в реальном времени LLM могут получать доступ к самой актуальной информации, обеспечивая точные и своевременные ответы в приложениях — от корпоративного поиска до персонализированных рекомендаций в электронной коммерции.
Практические применения: чат-боты на базе AI
Одним из практических применений, о которых говорил Jove, было использование данных в реальном времени в чатботах на базе ИИ. Используя потоки данных в реальном времени, эти чатботы могут предоставлять актуальную информацию, например обновления статуса рейса. Например, чатбот может мгновенно сообщать пользователям о задержках рейсов и предлагать альтернативные рейсы, демонстрируя практические преимущества обработки данных в реальном времени.

Jove привел пример, в котором представил, что вы общаетесь с ботом статуса рейсов:
Пользователь: "Каков статус моего рейса в Нью-Йорк?"
Чатбот: "Ваш рейс задержан на 2 часа."
Пользователь: "Могу ли я найти другой рейс, который доставит меня туда быстрее?"
Чатбот: "Да, есть альтернативный рейс с одним оставшимся местом. Он будет стоить вам $1500, но вы прибудете вовремя."
Пользователь: "Отлично, забронируй его для меня."
В этом сценарии чатбот использует потоки данных Kafka в реальном времени, чтобы предоставлять актуальную информацию о рейсах. Он не только информирует пользователя о задержках, но и проверяет доступные рейсы, места и цены в реальном времени. Затем чатбот представляет эту информацию пользователю, позволяя быстро принимать обоснованные решения. Этот пример показывает, как возможности Kafka по обработке данных в реальном времени повышают функциональность и отзывчивость чатботов на базе ИИ, делая их ценными инструментами для пользователей, которым нужна немедленная и точная информация.
Интеграция Timeplus с векторными базами данных
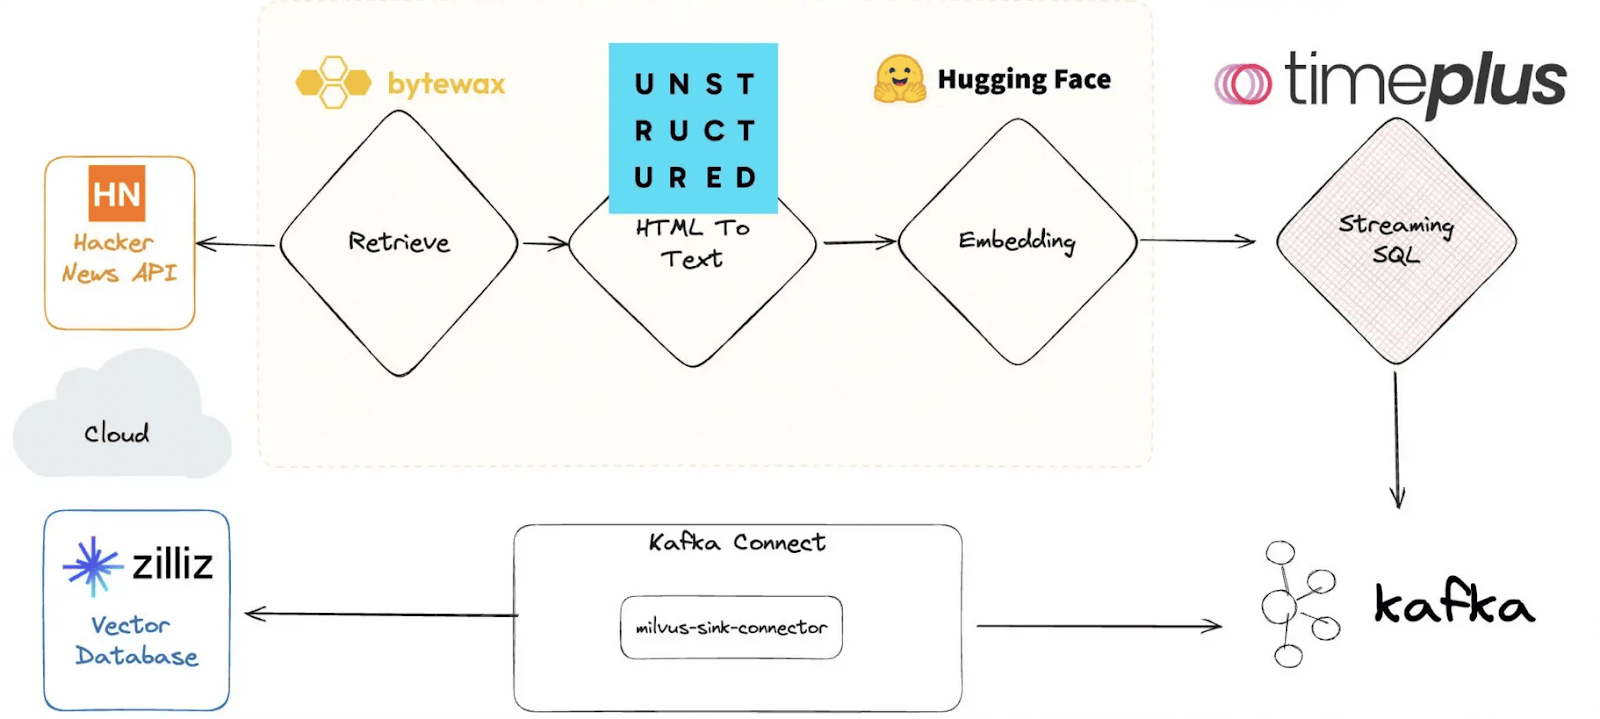
Демо Jove продолжилось впечатляющей интеграцией Timeplus и векторных баз данных, т. е. Milvus, показывая, как данные из Hacker News обрабатывались и запрашивались в реальном времени. Этот процесс проиллюстрирован на диаграмме ниже. Рабочий процесс начинается с получения данных из Hacker News API, затем следует преобразование HTML в текст с помощью Bytewax. Затем текст преобразуется в эмбеддинги с помощью Hugging Face и транслируется с использованием SQL-возможностей Timeplus. Данные подключаются к Kafka через Milvus sink connector, что обеспечивает запросы и обработку в реальном времени в векторной базе данных Milvus.
Он провел нас через конкретный пример, чтобы проиллюстрировать мощь этой интеграции.
Представьте, что вы работаете с данными Hacker News. Давайте получим последние данные из Hacker News. Используя Timeplus, мы можем транслировать эти данные в реальном времени. Jove вводит команду, и через несколько секунд появляется поток постов Hacker News. Теперь, скажем, мы хотим найти все посты, упоминающие 'dogfooding.' Мы можем выполнить сложный запрос по этим неструктурированным данным. Он вводит запрос, и почти мгновенно система возвращает список релевантных постов.
Но мы на этом не останавливаемся. Давайте посмотрим анализ тональности этих постов. С помощью другой команды данные обрабатываются, и отображается анализ тональности, показывающий, какие посты являются позитивными, негативными или нейтральными.
В этом сила интеграции Timeplus с векторными базами данных. Мы можем обрабатывать огромные объемы неструктурированных данных, выполнять сложные запросы и извлекать ценные инсайты в реальном времени."
В дополнение к Timeplus, Milvus также предлагает интеграцию с Kafka с использованием Confluent Kafka Connector, обеспечивая потоковую передачу векторных данных в реальном времени в Milvus или Zilliz Cloud. Такая настройка позволяет выполнять семантический поиск и поиск по сходству в реальном времени, повышая способность получать немедленные инсайты из потоковых данных.
Чтобы дать вам краткое представление, в следующей таблице перечислены некоторые важные продукты с их описанием и вариантами использования, обсуждавшимися в этой статье.
| Продукт | Описание | Сценарий использования |
| Timeplus | Платформа для аналитики в реальном времени с мощными возможностями потокового SQL. | Обработка и аналитика данных в реальном времени. |
| Timeplus Proton | Основной движок Timeplus — легковесный, написан на C++ и оптимизирован для производительности. | Потоковый ETL, оконные функции, агрегация с высокой кардинальностью. |
| Kafka | Распределенная платформа потоковой передачи событий, обрабатывающая высокопроизводительные потоки данных с низкой задержкой. | Конвейеры данных, потоковая аналитика, интеграция данных. |
| Confluent Kafka Connector | Инструмент для интеграции Kafka с Milvus и Zilliz Cloud, обеспечивающий потоковую передачу векторных данных в реальном времени. | Потоковая передача данных в реальном времени в векторные базы данных. |
| Apache Flink | Унифицированный фреймворк для потоковой и пакетной обработки, интегрированный с Kafka в Confluent Cloud. | Высокопроизводительная потоковая обработка. |
Заключение
Выступление Jove Zhong на Seattle Unstructured Data Meetup стало мастер-классом по обработке данных в реальном времени. От практических демонстраций до глубокого погружения в продвинутые концепции — Jove предоставил всесторонний обзор того, как Timeplus и Kafka формируют будущее аналитики данных. Выступление завершилось взглядом в будущее потокового SQL и обработки в реальном времени. Jove подчеркнул растущую важность этих технологий для создания более интеллектуальных и отзывчивых AI-систем. Способность обрабатывать данные в реальном времени и принимать немедленные решения становится критически важной во многих отраслях — от финансов до здравоохранения.
Для тех, кто заинтересован в дальнейшем изучении этих технологий, доступны полная запись выступления и слайды презентации.
Читать далее
Milvus 3.0 vs Elasticsearch on Vector and Full-Text Search
A reproducible, side-by-side walkthrough of Milvus 3.0 and Elasticsearch 9 on keyword, vector, and hybrid search — same box, same data, same analyzers, with the gaps spelled out.
Introducing Zilliz CLI and Agent Skills for Zilliz Cloud
Manage your vector database from your terminal or AI coding agent. Zilliz CLI and Agent Skills work with Claude Code, Cursor, Codex, and Copilot.
Will Amazon S3 Vectors Kill Vector Databases—or Save Them?
AWS S3 Vectors aims for 90% cost savings for vector storage. But will it kill vectordbs like Milvus? A deep dive into costs, limits, and the future of tiered storage.