




ChromaからZilliz Cloudへの移行方法
Chroma Cloud は、Chroma の終了スケジュールによると、2026年11月22日に書き込みの受付を停止し、2026年12月22日に読み取りの提供を停止します。アプリケーションが Chroma Cloud に書き込んでいる場合、最初の日までに新しい移行先が必要であり、2番目の日までにデータを移出する必要があります。
オープンソースの Chroma は影響を受けません。ただし、自分で運用していて、1台のマシンが快適に保持できる以上のデータ、稼働時間の目標があり、誰もオンコールを進んで引き受けたがらないという状況で本番環境に移行する場合、移行手順は同じですが、期限はありません。
このガイドでは、どちらの場合も、オープンソースの Milvus 上に構築されたフルマネージドベクターデータベースである Zilliz Cloud に移行します。埋め込みはそのまま引き継がれるため、再埋め込みは一切行われず、ID、ドキュメント、URI、メタデータも一緒に移行されます。オープンソースの Milvus を自分で運用したい場合も、同じ手順が適用されます。Step 1 の Chroma をオープンソース Milvus に移行する を参照してください。
移行は4つのステップで構成されます。データの移動、確認、アプリケーションの更新、そして切り替えです。
始める前に
必要なもの:
- Zilliz Cloud クラスター。パブリックエンドポイントと API キーを用意します。まだない場合はサインアップしてください。無料プランでは最大 5 コレクションまで保持できます。それ以上の場合は、Serverless または Dedicated クラスターを使用してください。
- Chroma の接続情報。 Chroma Cloud では、ダッシュボードの Connect パネルに API キー、テナント ID、データベース名が表示されます。セルフホスト型 Chroma の場合は、サーバーアドレスに加えて、認証を有効にしている場合はトークン、またはユーザー名とパスワードが必要です。
- Python 3.10 以降 と両方のクライアント。コピーの確認とアプリケーションの更新に必要です:
pip install chromadb==1.5.9 pymilvus==3.0.2
- Docker。オープンソースの Vector Transport Service を使用する場合に必要です(Step 1 のオプション B)。
データのマッピング方法
各 Chroma コレクションは、4つのフィールドを持つ Zilliz Cloud コレクションになります。メタデータはコレクションの動的フィールドに入るため、すべてのメタデータキーは、Chroma の場合と同様にフィルタリング可能なままです。Zilliz Cloud のドキュメントページ Migrate from Chroma to Zilliz Cloud に、メタデータ型が型付きフィールドに変換される方法を含む完全なマッピングが記載されています。
| Chroma | Zilliz Cloud |
|---|---|
| コレクション | 同じ名前のコレクション。- は _ に変換されます: support-docs は support_docs になります。Zilliz Cloud の名前は英字、数字、アンダースコアのみを使用でき、数字で始めることはできないため、kb.v2 や 2024-notes のような名前は、コピーを設定するときに新しい名前が必要です。また、support-docs と support_docs のように、変換後に同じ名前になる2つの名前のうちの1つも同様です。 |
id | id。VARCHAR 主キー。ID は変更されません。 |
embedding | embedding。同じ次元を持つ FLOAT_VECTOR フィールド。 |
document | document。NULL 許容の VARCHAR フィールドで、最大 65,535 バイト。 |
uri | uri。NULL 許容の VARCHAR フィールド。URI 文字列はコピーされますが、その URI が指すファイルはコピーされません。 |
| メタデータ | 動的フィールドのキー。コピーを設定するときに、選択したキーを型付きフィールドに変換することもできます。 |
距離空間: cosine、l2、ip | インデックスメトリック: COSINE、L2、IP。メトリックはコピーされません。インデックスを構築するときに設定します。 |
| 埋め込み関数 | データベースには保存されません。アプリケーションがクエリを埋め込みます(Step 3)。 |
ユーザーごとに1コレクション? 各 Chroma コレクションは独自の Zilliz Cloud コレクションになり、クラスターで保持できる数には制限があります: Free では 5、Serverless では 100、Dedicated クラスターではコンピュートユニットあたり 1,024、最大 16,384 です。ユーザーごとのコレクションがこれより多い場合、または増える見込みがある場合は、移行前にご相談ください: より良い設計は、パーティションキーを持つ1つのコレクションであり、何百万ものテナントをサポートできます。
Step 1: データを移行する
データのコピー方法は2つあります。どちらが適しているかは、Chromaの実行環境によって異なります。
| Chromaの環境 | 利用方法 |
|---|---|
| Chroma Cloud | オプションA: 組み込みの移行サービス |
| インターネットから到達可能な自前のChromaサーバー | オプションA: 組み込みの移行サービス |
| プライベートネットワーク上またはラップトップ上の自前のChroma、あるいはアプリケーションに組み込まれたChroma | オプションB: Vector Transport Service(オープンソース) |
違いは、誰が誰に接続するかです。移行サービスはZilliz Cloud内で実行され、お使いのChromaから読み取るため、到達可能なアドレスが必要です。Vector Transport Serviceはお客様が選択したマシン上で実行され、Zilliz Cloudに書き出すため、両方に到達できる任意の場所から動作します。
まず、各コレクションのレコード数と距離空間を確認してください。 どのオプションを使用する場合でも、インデックスのメトリックを設定するには距離空間が必要であり、コピーを確認するにはレコード数が必要です。
import chromadb

client = chromadb.HttpClient(host="localhost", port=8000)
# Chroma Cloud: chromadb.CloudClient(api_key=..., tenant=..., database=...)

for collection in client.list_collections():
    config = collection.configuration_json
    space = (config.get("hnsw") or config.get("spann") or {}).get("space") or "l2"
    print(f"{collection.name}: {collection.count()} records, space {space}")
Chromaは、距離空間を指定せずに作成されたコレクションにはl2を使用します。空のコレクションはコピーから除外してください。Chromaは最初の埋め込みが到着するまで次元を記録しないため、ターゲットを作成するための情報がありません。
オプションA: Zilliz Cloud移行サービス
移行サービスはZilliz Cloudコンソールに組み込まれており、無料で使用できます。Organization OwnerまたはProject Adminロールが必要です。セルフホスト型のChromaサーバーは、ChromaのREST API v2を提供し、Zilliz Cloudから到達可能である必要があります。ファイアウォールの背後にある場合は、Zilliz CloudのIPアドレスを許可リストに追加してください。
- 接続。 コンソールでMigrationsを開き、ソースとしてChromaを選択します。Chromaのエンドポイント、テナント、データベース、および資格情報を入力します。Chroma Cloudの場合は、Connectパネルからそれらをコピーします。エンドポイントは
https://api.trychroma.com、またはデータベースがAWS us-east-1の外部にある場合はリージョンのエンドポイントであり、資格情報はAPIキーです。セルフホスト型のChromaでは、認証なし、トークン、またはユーザー名とパスワードを使用でき、デフォルトのテナントとデータベースはdefault_tenantとdefault_databaseです。次に、ターゲットのクラスターとデータベースを選択します。
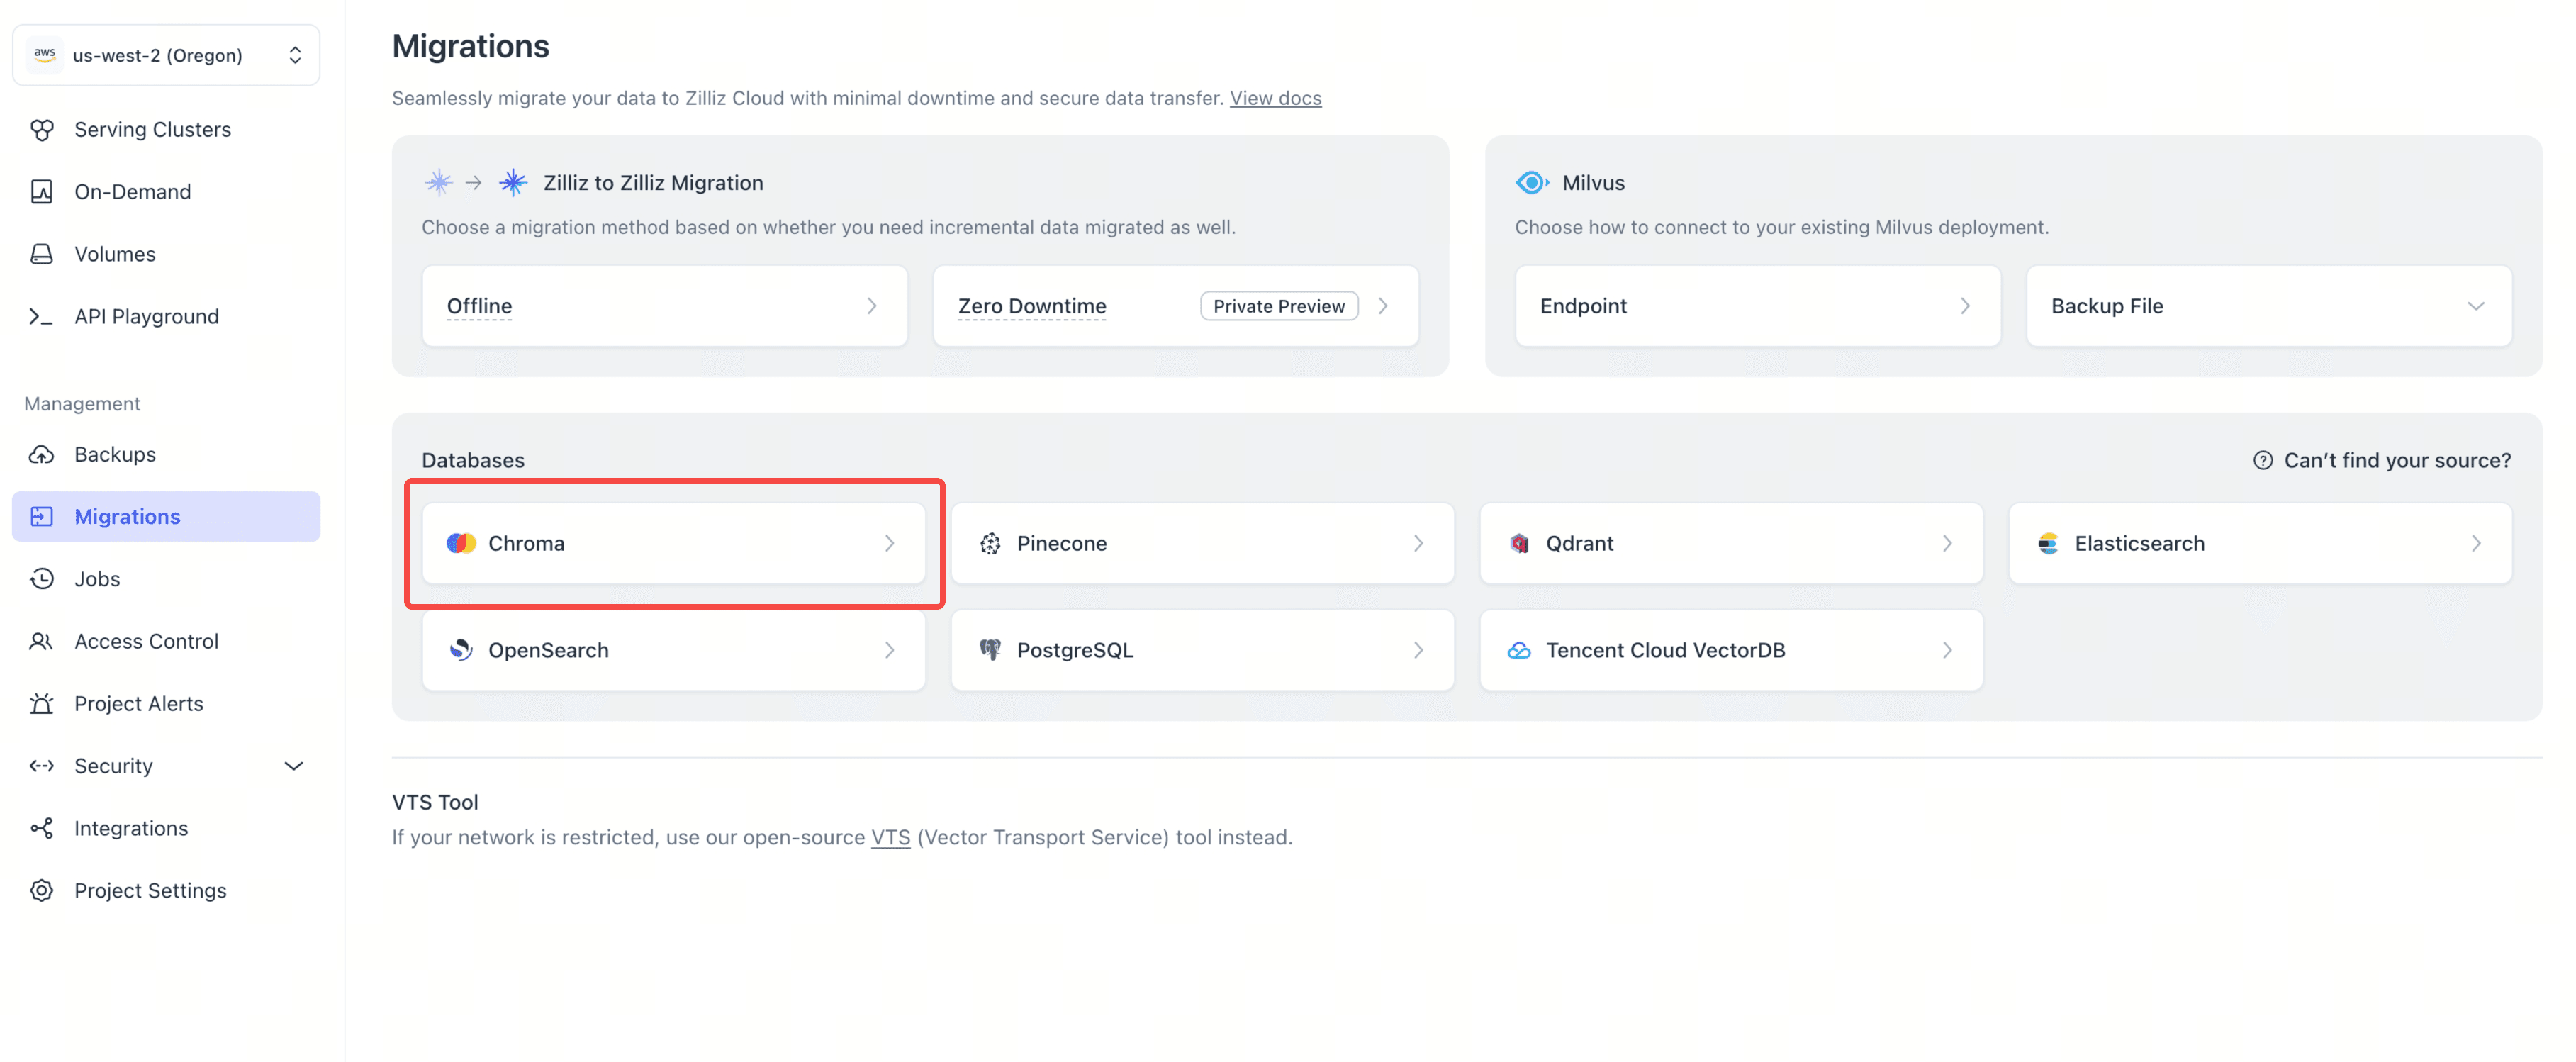
- 選択と確認。 移行するコレクションを選択します。各ターゲット名を確認し、Zilliz Cloudで使用できない名前や既に使用されている名前は、名前を変更してください。フィールドマッピングを確認します。メタデータはデフォルトで動的フィールドに入り、選択したキーをここで型付きフィールドに変換できます。
- インデックスの設定。 Create indexes after migrationをオンのままにして、ジョブが完了するとすぐにコレクションを検索可能にします。各コレクションのメトリックをChromaの距離空間に合わせて設定します。
cosineはCOSINEに、l2はL2に、ipはIPにします。メトリックはChromaからコピーされません。インデックス設定を参照してください。 - 実行。 ジョブを開始し、Jobsページで追跡します。完了すると、ジョブは検証した行数を報告します。
すべてのフィールドとオプションは、Zilliz CloudドキュメントのMigrate from Chroma to Zilliz Cloudに記載されています。次に、ステップ2に進みます。
オプションB: Vector Transport Service
Vector Transport Service(VTS)は、Zillizのオープンソース移行ツールであり、移行サービスが実行されているエンジンです。Docker内で設定ファイルから自分で実行します。これは、バージョン0.6以降の任意のChromaサーバーが提供するv2 REST APIを介してChromaを読み取ります。
アプリケーションにChromaが組み込まれている場合、chromadb.PersistentClient を通じてローカルディレクトリにデータがあると、VTSが読み取るためのサーバーがまだ存在しません。そのディレクトリでサーバーを起動してください:
chroma run --path ./chroma_data --port 8000
次に、ジョブ設定を記述します。 これを migration.conf として保存し、各 $ プレースホルダーを実際の値に置き換えてください。これらは環境変数ではなく、自動的に展開されません。
env {
  parallelism = 1
  job.mode = "BATCH"
}

source {
  ChromaDB {
    url = "$CHROMA_URL"                  # e.g. http://host.docker.internal:8000
    tenant = "default_tenant"
    database = "default_database"
    collections = ["$CHROMA_COLLECTION"] # e.g. ["support-docs"]

    # If your Chroma requires auth, see the table below
    # auth_type = "X_CHROMA_TOKEN"
    # token = "$CHROMA_TOKEN"

    id_split_size = 300
    batch_size = 300
  }
}

sink {
  Milvus {
    url = "$ZILLIZ_CLOUD_ENDPOINT"
    token = "$ZILLIZ_CLOUD_API_KEY"
    database = "default"                 # must already exist
    batch_size = 50
    enable_dynamic_field = true          # required, this is where metadata goes
    schema_save_mode = "CREATE_SCHEMA_WHEN_NOT_EXIST"
    data_save_mode = "APPEND_DATA"
  }
}
設定には資格情報が含まれるため、chmod 600 migration.conf で権限を制限してください。
| パラメータ | 設定する内容 |
|---|---|
url(ソース) | VTSが付加する /api/v2 を含まないChromaサーバーのルート。VTSはコンテナ内で実行されるため、localhost はコンテナ自身を指します。Chromaが同じマシン上で実行されている場合は、macOSとWindowsでは http://host.docker.internal:8000 を使用し、Linuxでは docker run に --network host を追加して localhost のままにします。Chroma Cloudの場合は、https://api.trychroma.com またはお住まいのリージョンのエンドポイントを使用します。 |
tenant と database | 他に作成していない限り、default_tenant と default_database。Chroma Cloudでは、テナントIDとデータベース名。 |
auth_type と token | サーバーが認証なしで動作する場合は両方とも省略します。それ以外の場合は、token を指定して X_CHROMA_TOKEN または BEARER を使用するか、username と password を指定して BASIC を使用します。Chroma Cloudでは、APIキーを指定して X_CHROMA_TOKEN を使用します。 |
id_split_size と batch_size | 両方とも 300 であればどこでも動作します。Chroma Cloudでは両方とも300以下に保つ必要があります。大規模なセルフホストコレクションの場合は、10000000 と 1000 を指定するとIDを一括でスキャンし、その後IDごとにレコードを取得するため、低速なディープページングを回避できます。 |
collection_rename(シンク) | オプション。{ "source" = "target" }。- が _ になるとZilliz Cloudの有効な名前にならないソース名には必須です。 |
選択したメタデータキーを型付きフィールドに変換するには、シンクに field_schema ブロックを追加します。Milvus sink guide は field_schema と collection_rename を説明し、ChromaDB source guide はバッチサイズ、認証、その他のソースオプションを説明しています。
ジョブを実行:
docker run --rm \
  --mount "type=bind,source=$(pwd)/migration.conf,target=/config/migration.conf,readonly" \
  --workdir /opt/seatunnel \
  --entrypoint /bin/bash \
  zilliz/vector-transport-service:v1.3.0 \
  -lc 'mkdir -p logs && ./bin/seatunnel.sh --config /config/migration.conf -m local'
ログが end with state FINISHED で終わり、Total Read Count が Total Write Count と等しく、Total Failed Count が 0 であれば、ジョブは成功したことになります。
ジョブは追記(append)されるため、同じコレクションに対して再実行しないでください。 2回目の実行ではすべてのレコードが再び書き込まれます。ジョブが途中で失敗した場合や、新しいコピーが必要な場合は、最初にターゲットコレクションを削除するか、collection_rename を使用して新しいコレクションにジョブを送信してください。
インデックスを構築します。 そのコレクションについて記録しておいた距離空間を使用してください:
from pymilvus import MilvusClient
client = MilvusClient(
    uri="YOUR_ZILLIZ_CLOUD_ENDPOINT",
    token="YOUR_ZILLIZ_CLOUD_API_KEY",
)

index_params = client.prepare_index_params()
index_params.add_index(
    field_name="embedding",
    index_type="AUTOINDEX",
    metric_type="COSINE",  # cosine -> COSINE, l2 -> L2, ip -> IP
)
client.create_index(collection_name="support_docs", index_params=index_params)
client.load_collection("support_docs")
ChromaをオープンソースMilvusに移行する
このガイドの内容は、オープンソースのMilvus 2.5以降で動作します。オプションBを使用してください。これは、到達可能な任意のMilvusに書き込みます。シンクのurlをMilvusのアドレスに設定します。たとえば、Milvusが同じマシン上で実行されている場合はhttp://host.docker.internal:19530、tokenはusername:passwordに設定します。認証が無効になっている場合はtokenの行を削除します。ステップ2から4は同じで、アプリケーションではuriとtokenだけが変わります。MilvusとZilliz Cloudは同じAPIを共有しているため、後でコードを変更せずに両者を移動できます。
ステップ2: データを確認する
まず、レコード数を比較します。移行サービスは検証した行数を報告します。VTSの場合はログのTotal Write Countです。どちらもChromaの数と一致する必要があります。
件数が分かれば、すべてのレコードが到着したことがわかります。しかし、インデックスがChromaと同じようにクエリに応答するかどうかは示しません。間違ったメトリックで構築されたインデックスは件数チェックに合格しても、間違った近傍を返します。そこで、両側でいくつかの検索を実行して比較してください:
import chromadb
from pymilvus import MilvusClient

chroma = chromadb.CloudClient(api_key="YOUR_CHROMA_API_KEY", tenant="YOUR_TENANT_ID", database="YOUR_DATABASE_NAME")
# Self-hosted Chroma: chromadb.HttpClient(host="localhost", port=8000)
milvus = MilvusClient(uri="YOUR_ZILLIZ_CLOUD_ENDPOINT", token="YOUR_ZILLIZ_CLOUD_API_KEY")

source = chroma.get_collection("support-docs")
overlaps = []
for vector in source.get(limit=20, include=["embeddings"])["embeddings"]:
    expected = source.query(query_embeddings=[vector], n_results=10, include=[])["ids"][0]
    hits = milvus.search("support_docs", data=[vector.tolist()], limit=10)[0]
    overlaps.append(len(set(expected) & {hit["id"] for hit in hits}) / len(expected))
print(f"top-10 overlap: {sum(overlaps) / len(overlaps):.0%}")
これは20件のレコードをクエリとして使用し、トップ10の結果のうちいくつが一致するかを数えます。両システムとも近似インデックスを使用するため、100%を少し下回る値は正常です。大幅に低い場合は、ほとんどの場合、インデックスのメトリックがコレクションの距離空間と一致していないことを意味します。
どちらのチェックもレコードの内部を調べません。最終コピーを本番稼働させる前に、それらも比較してください。すべてのIDが転送されたことを確認し、次にベクトル、ドキュメント、URI、メタデータを比較します。小規模なコレクションではすべてのレコードを比較し、大規模なものではランダムサンプルを比較します。
コピー中にアプリケーションがChromaへの書き込みを続けていた場合、件数は異なる可能性があります。最初のパスではそれで問題ありません。切り替え時の最終コピーでは、一致している必要があります。
ステップ3: アプリケーションを更新する
ほとんどの呼び出しは1対1で変換されます。注意すべき点は2つあります。アプリケーションがクエリの埋め込みを自分で作成するようになり、cosineおよびipコレクションのスコアが逆方向に動作することです。
Zilliz Cloudに接続する:
from pymilvus import MilvusClient

client = MilvusClient(
    uri="YOUR_ZILLIZ_CLOUD_ENDPOINT",
    token="YOUR_ZILLIZ_CLOUD_API_KEY",
)
オープンソースMilvusの場合は、uriをMilvusのアドレスに、tokenをusername:passwordに設定します。認証が無効の場合はtokenを省略します。以降はすべて同じです。
以前と同じモデルでクエリを埋め込む。 Chromaにquery_textsを渡すと、Chromaがコレクションの埋め込み関数を実行してくれました。移行されたコレクションにはその関数が含まれていないため、コード内で同じモデルを呼び出してください。Chromaにテキストの埋め込みを任せていて、埋め込み関数を設定したことがない場合、Chromaはデフォルトのモデルであるall-MiniLM-L6-v2を使用していました。chromadbパッケージは今でもローカルでそれを実行できます:
from chromadb.utils.embedding_functions import DefaultEmbeddingFunction
embed = DefaultEmbeddingFunction() query_vector = embed(["How do I get a refund?"])[0].tolist()
OpenAIまたは別のプロバイダーを使用した場合は、同じ設定で同じモデルを呼び出してください。

**フィルターを使った検索。** 以前はChromaで次のようにしていました:

```python
results = collection.query(
    query_embeddings=[query_vector],
    n_results=5,
    where={"category": "billing"},
    where_document={"$contains": "refund"},
)
移行後、Zilliz Cloudでは次のようになります:
results = client.search(
    collection_name="support_docs",
    data=[query_vector],
    limit=5,
    filter='category == "billing" and document like "%refund%"',
    output_fields=["document", "category"],
)
各ヒットは、id、distance、および entity の下で要求したフィールドを持つdictです。Chromaの where フィルターと where_document フィルターは、1つのフィルター式になります:
| Chroma | Zilliz Cloud |
|---|---|
{"category": "billing"} | category == "billing" |
{"category": {"$ne": "billing"}} | category != "billing" |
{"year": {"$gte": 2023}} ($gt、$lt、$lte も使用可能) | year >= 2023 (>、<、<= も使用可能) |
{"category": {"$in": ["billing", "account"]}} | category in ["billing", "account"] |
{"category": {"$nin": ["billing", "account"]}} | category not in ["billing", "account"] |
{"$and": [...]} と {"$or": [...]} | ... and ... と ... or ... |
{"is_public": True} | is_public == true |
{"tags": {"$contains": "faq"}} (配列メタデータ) | array_contains(tags, "faq") |
where_document={"$contains": "refund"} | document like "%refund%" |
where_document={"$not_contains": "refund"} | not (document like "%refund%") |
スコアの読み方が逆になります。 Chromaは距離を返し、値が小さいほど類似していることを示します。COSINE と IP の場合、Zilliz Cloudは類似度スコアを返し、値が大きいほど類似していることを示します。ランキングは変わりませんが、コード内のしきい値は変更する必要があります。私たちのテストでは、上記の検索で最上位のヒットのChroma距離は0.0545、Zilliz Cloudのスコアは0.9455でした。
| Chromaのスペース | Chromaが返す値 | Zilliz Cloudが返す値 | distance < 0.3 のようなしきい値は次のようになります |
|---|---|---|---|
cosine | 1 − コサイン類似度 | コサイン類似度 | score > 0.7 |
ip | 1 − 内積 | 内積 | score > 0.7 |
l2 | L2距離の二乗 | L2距離の二乗 | 変更なし |
レコードの書き込みと削除。 メタデータキーは各行の他のフィールドの隣に配置されるため、別個の metadatas 引数はありません。add と upsert はどちらも upsert(新しいIDの場合は insert)にマッピングされ、delete はIDまたはフィルターで動作します:
client.upsert(
    collection_name="support_docs",
    data=[{"id": "doc-1001", "embedding": vector, "document": "How to change your billing address", "category": "billing"}],
)
client.delete(collection_name="support_docs", ids=["doc-1001"])
client.delete(collection_name="support_docs", filter='category == "archived"')
ここで vector は、コレクションの他の部分と同じモデルから生成された埋め込みです。uri は省略可能で、nullにできます。
LangChainを使っていますか? ベクターストアクラスを置き換え、移行後のフィールド名を指すようにします。以前:
from langchain_chroma import Chroma

vector_store = Chroma(
    collection_name="support-docs",
    embedding_function=embeddings,
    chroma_cloud_api_key="YOUR_CHROMA_API_KEY",
    tenant="YOUR_TENANT_ID",
    database="YOUR_DATABASE_NAME",
)
docs = vector_store.similarity_search("How do I get a refund?", k=5, filter={"category": "billing"})
移行後は、pip install langchain-milvus でインストールした状態で:
from langchain_milvus import Milvus
vector_store = Milvus(
    embedding_function=embeddings,
    collection_name="support_docs",
    connection_args={"uri": "YOUR_ZILLIZ_CLOUD_ENDPOINT", "token": "YOUR_ZILLIZ_CLOUD_API_KEY"},
    primary_field="id",
    text_field="document",
    vector_field="embedding",
    enable_dynamic_field=True,
)
docs = vector_store.similarity_search("How do I get a refund?", k=5, expr='category == "billing"')
「embeddings」はChromaで使用したものと同じLangChainのembeddingsオブジェクトです。また、フィルターは filter={...} から expr="..." に変わります。LlamaIndexユーザーも同じように Milvusベクターストア に切り替えることができます。
ステップ4: 切り替え
- データをコピーして確認し、アプリケーションのステージングビルドをZilliz Cloudに向けます。
- Chromaへの書き込みを一時停止します。11月22日以降、Chroma Cloudはそもそも書き込みをブロックします。
- 再度コピーします。これにより、一時停止までのすべての書き込みを取得でき、カウントが正確に一致することを確認します。開始する前に最初のコピーを削除するか、このコピーを別のデータベースに送ります。
- アプリケーションをZilliz Cloudに対してデプロイします。
- Chroma Cloudでは、Chromaの終了通知が求めているように、12月22日までに資格情報を削除またはローテーションします。
11月22日以降にこれを読んでいますか?お使いのChroma Cloudデータはすでに読み取り専用です。そのため、ステップ2をスキップして、一度だけコピーしてください。12月22日までコピーできます。
セルフホストのChromaには期限はありませんが、コピー→書き込みの一時停止→再コピー→切り替えという順序を守ってください。その後もしばらくChromaサーバーを保持してください。アプリケーションがZilliz Cloudに新しいものを書き込むまでは、ロールバックは設定変更で済みます。
次のステップ
- 大規模または本番環境のワークロードを移行しますか? サポートチーム に切り替えの計画についてご相談ください。
- 先に選択肢を比較しますか? Chroma vs. Zilliz Cloud は、機能、スケール、およびChroma Cloudから移行できるものを紹介しています。
- Chroma Cloudでハイブリッド検索を使用していましたか? Zilliz Cloudの ハイブリッド検索 は、高密度ベクトルとBM25またはその他のスパースベクトルを1つのリクエストで組み合わせます。
- 他のデータベースも移行しますか? 同じ Migration Service がPinecone、Qdrant、Elasticsearch、OpenSearch、PostgreSQLに対応しています。
 Fendy Feng
 is the Product Marketing Manager at Zilliz. She has extensive experience developing and enhancing the impact of open-source projects in various global markets by producing high-quality, tailored content. Before joining Zilliz, Fendy worked as a Content Strategist at PingCAP, a fast-growing E-Series startup renowned for its open-source distributed SQL database.
 Sebastian Huang
Staff Software Engineer at Zilliz
 Shawn He
 is a Senior Software Engineer at Zilliz, specializing in vector database migration, data pipelines, and cloud SaaS development. He builds reliable tools and services that help users move data across vector databases and streamline cloud data workflows.
読み続けて
Why Teams Are Migrating from Weaviate to Zilliz Cloud — and How to Do It Seamlessly
Explore how Milvus scales for large datasets and complex queries with advanced features, and discover how to migrate from Weaviate to Zilliz Cloud.
Why I’m Against Claude Code’s Grep-Only Retrieval? It Just Burns Too Many Tokens
Learn how vector-based code retrieval cuts Claude Code token consumption by 40%. Open-source solution with easy MCP integration. Try claude-context today.
Selecting the Right ETL Tools for Unstructured Data to Prepare for AI
Learn the right ETL tools for unstructured data to power AI. Explore key challenges, tool comparisons, and integrations with Milvus for vector search.