




Запуск Llama 3, Mixtral и GPT-4o
Существует так много разных способов запустить G-Generation часть RAG! Сегодня я покажу несколько способов запуска одних из самых горячих претендентов в этой области: Llama 3 от Meta, Mixtral от Mistral и недавно анонсированный GPT-4o от OpenAI.
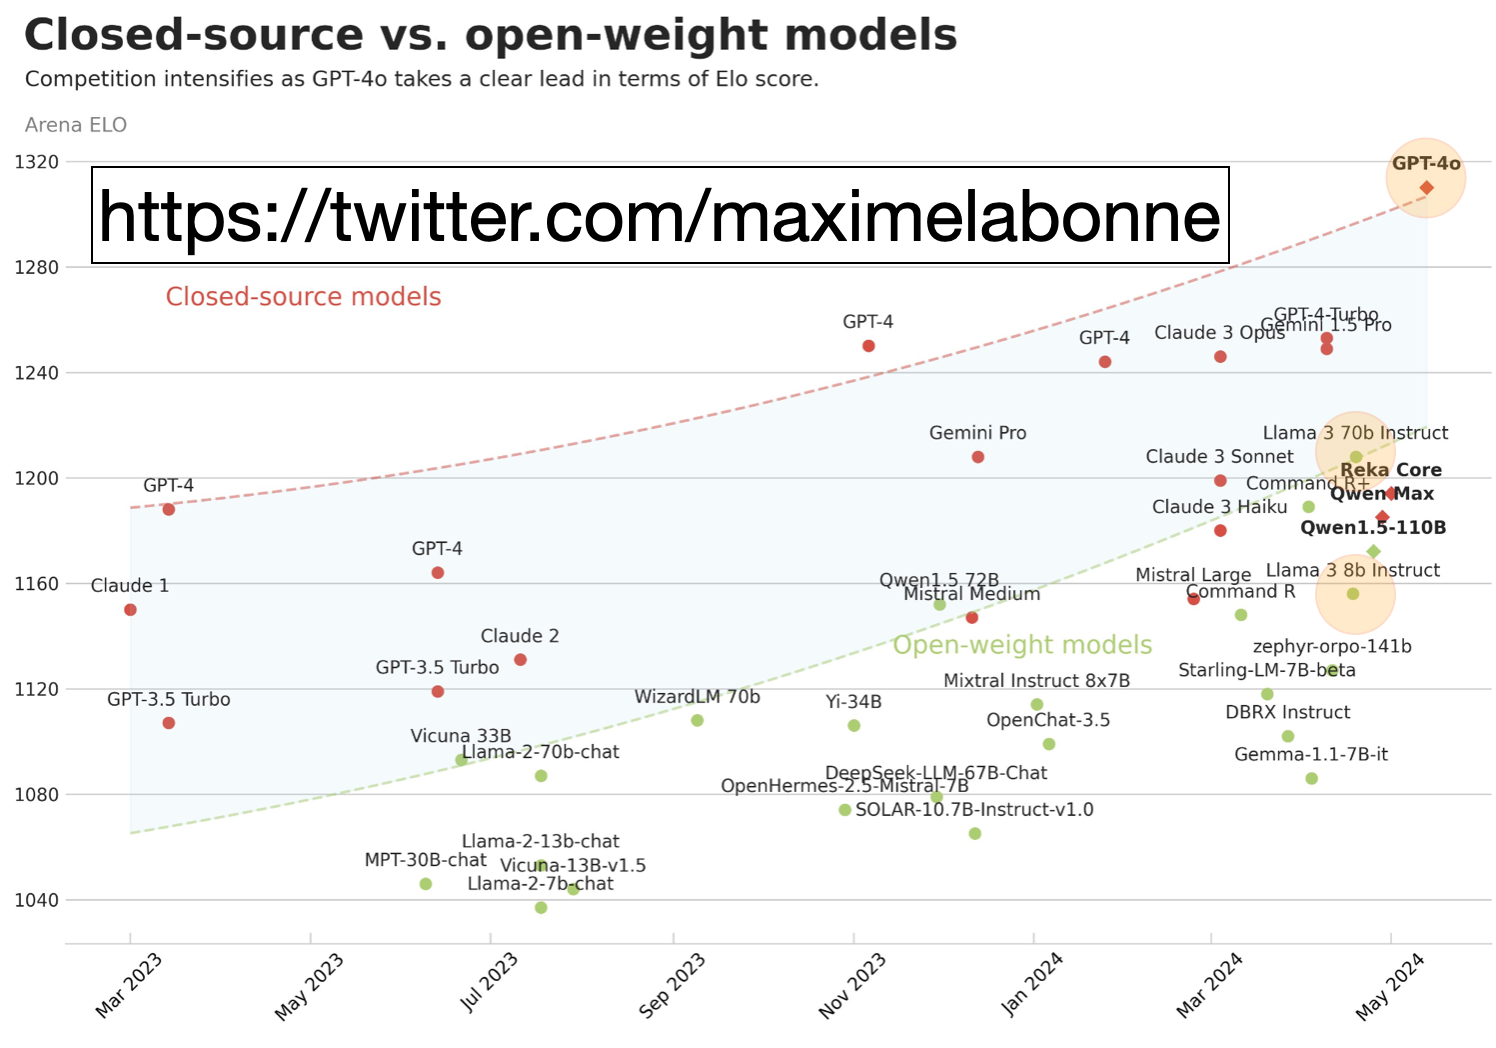
Как мы видим на LMSYS Leaderboard ниже, разрыв (светло-голубым) между моделями с закрытым исходным кодом и моделями с открытым исходным кодом на этой неделе существенно увеличился после нового анонса OpenAI.
 closed-source vs open
Источник изображения: https://twitter.com/maximelabonne на основе https://chat.lmsys.org/?leaderboard.
План этого блога:
Самые быстрые способы запустить open-source Llama 3 или Mixtral
Локально с Ollama
Эндпоинты Anyscale
Эндпоинт OctoAI
Эндпоинт Groq
Запуск новейшего gpt-4o от OpenAI
Оценка ответов: GPT-4o, Llama 3, Mixtral
Давайте начнем!
Запуск Llama 3 локально с использованием Ollama
Сначала запустите RAG обычным способом, вплоть до последнего шага, где вы генерируете ответ, G-часть RAG. У нас есть много руководств для начала работы с RAG, включая это на Python.
Чтобы запустить Llama 3 локально с использованием Ollama.
Следуйте инструкциям, чтобы установить ollama и загрузить модель.
На этой странице сказано, что
ollama run llama3по умолчанию загрузит последнюю "instruct" модель, которая дообучена для сценариев чата/диалога И помещается на вашем компьютере. Выполните эту команду.Для Python:
pip install ollama.В вашем Python-коде RAG определите Prompt и Question и вызовите API-вызов к вашей локально установленной модели Llama 3.
В моем случае у меня ноутбук M2 16GB, поэтому загруженная модель Ollama — это наиболее квантованная gguf-скомпилированная версия Llama3-8B. То есть теперь на моем ноутбуке установлена очень маленькая версия Llama 3!
# Separate all the context together by space, reverse order.
# See “Lost in the middle” arxiv.org paper.
contexts_combined = ' '.join(reversed(contexts))
source_combined = ' '.join(reversed(sources))

# Define a Prompt.
SYSTEM_PROMPT = f"""Given the provided Context, your task is to
understand the content and accurately answer the question based
on the information available in the context.
Provide a complete, clear, concise, relevant response in fewer
than 4 sentences and cite the unique Sources.
Answer: The answer to the question.
Sources: {source_combined}
Context: {contexts_combined}
"""

# Send the Question and Prompt to local! llama 3 chat.
import ollama
start_time = time.time()
response = ollama.chat(
   messages=[
       {"role": "system", "content": SYSTEM_PROMPT,},
       {"role": "user", "content": f"question: {SAMPLE_QUESTION}",}
   ],
   model='llama3',
   stream=False,
   options={"temperature": TEMPERATURE, "seed": RANDOM_SEED,
            "top_p": TOP_P,
           #  "max_tokens": MAX_TOKENS, # not recognized
            "frequency_penalty": FREQUENCY_PENALTY}
)

ollama_llama3_time = time.time() - start_time
pprint.pprint(response['message']['content'].replace('\n', ' '))
print(f"ollama_llama3_time: {format(ollama_llama3_time, '.2f')} seconds")
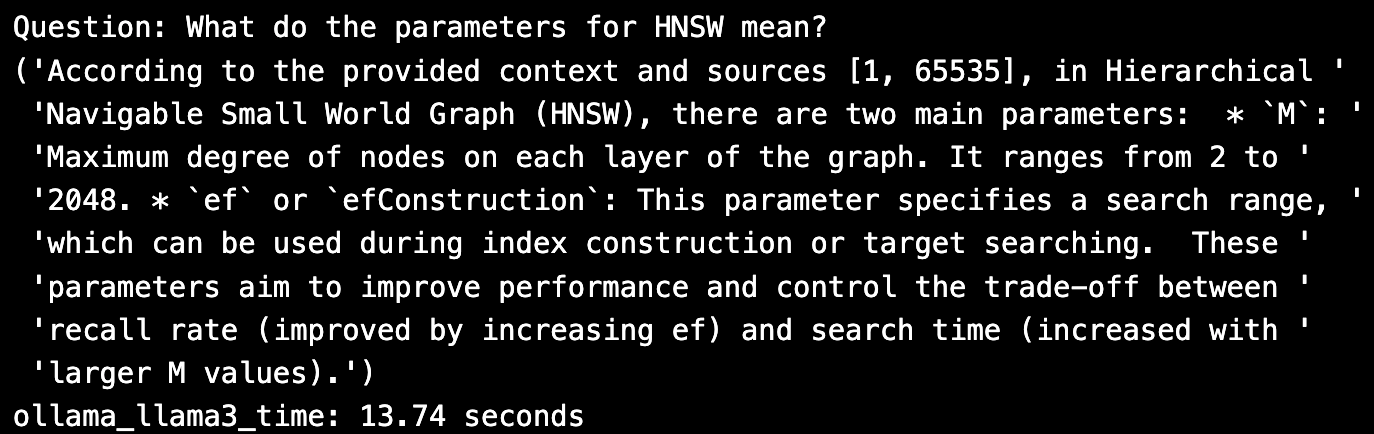
Ответ выглядит довольно хорошо; я вижу три параметра, но только цитирование выглядит искаженным. Локальной модели потребовалось 13 секунд, чтобы выполнить инференс на моем ноутбуке, но стоимость была нулевой.
Запуск Llama 3 через эндпоинты Anyscale
Чтобы запустить инференс Llama 3 через эндпоинты Anyscale:
Следуйте инструкциям на github-странице Anyscale endpoints, чтобы установить командную строку, а затем установить плагин.
Получите API-токен вашего эндпоинта Anysclae и обновите переменные окружения.
Для Python:
pip install openai.Прочитайте о модели Llama 3, загруженной с HuggingFace, и вызовите её с помощью OpenAI API. Я использовал Llama 3 по умолчанию в Anyscale playground, которая была моделью 70B-Instruct.
import openai

LLM_NAME = "meta-llama/Llama-3-70b-chat-hf"

anyscale_client = openai.OpenAI(
   base_url = "https://api.endpoints.anyscale.com/v1",
   api_key=os.environ.get("ANYSCALE_ENPOINT_KEY"),
)

start_time = time.time()
response = anyscale_client.chat.completions.create(
   messages=[
       {"role": "system", "content": SYSTEM_PROMPT,},
       {"role": "user", "content": f"question: {SAMPLE_QUESTION}",}
   ],
   model=LLM_NAME,
   temperature=TEMPERATURE,
   seed=RANDOM_SEED,
   frequency_penalty=FREQUENCY_PENALTY,
   top_p=TOP_P,
   max_tokens=MAX_TOKENS,
)
llama3_anyscale_endpoints_time = time.time() - start_time

# Print the response.
pprint.pprint(response.choices[0].message.content.replace('\n', ' '))
print(f"llama3_anyscale_endpoints_time: {format(llama3_anyscale_endpoints_time, '.2f')} seconds")
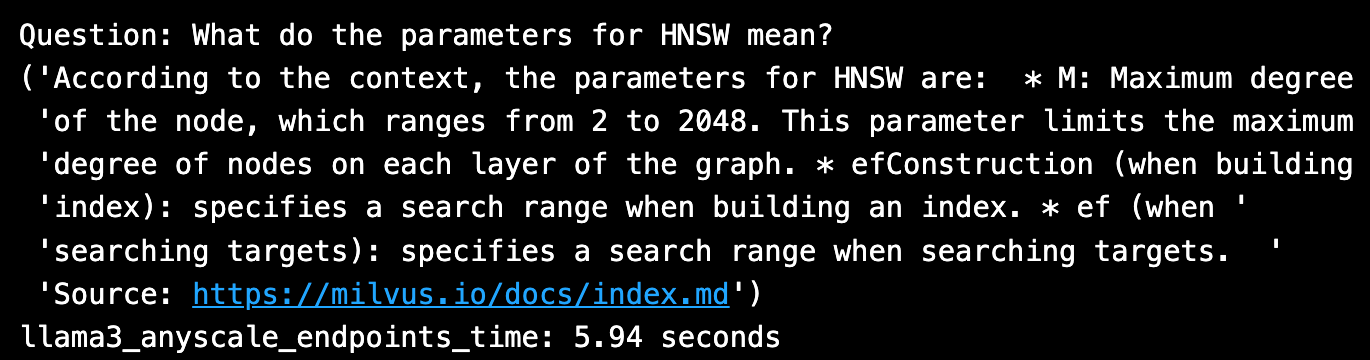
Ответ выглядит хорошо, включая идеальную цитату. Вызов HuggingFace Llama 3 70B из Anyscale endpoints занял ~6 секунд.
Запуск Llama 3 из OctoAI Endpoints
Чтобы запустить инференс Llama 3 из OctoAI endpoints:
Перейдите на https://octoai.cloud/text, выберите модель Llama 3 8B, нажмите на ссылку модели, и вы увидите пример кода.
Получите ваш OctoAI endpoint API token и обновите переменные окружения.
Для Python выполните
pip install octoai.Прочитайте о модели Llama 3 8B, загруженной с Meta, и вызовите её.
from octoai.text_gen import ChatMessage
from octoai.client import OctoAI

LLM_NAME = "meta-llama-3-70b-instruct"

octoai_client = OctoAI(
   api_key=os.environ.get("OCTOAI_TOKEN"),
)

start_time = time.time()
response = octoai_client.text_gen.create_chat_completion(
   messages=[
       ChatMessage(
           content=SYSTEM_PROMPT,
           role="system"
       ),
       ChatMessage(
           content=SAMPLE_QUESTION,
           role="user"
       )
   ],
   model=LLM_NAME,
   temperature=TEMPERATURE,
   # seed=RANDOM_SEED, # not recognized
   frequency_penalty=FREQUENCY_PENALTY,
   top_p=TOP_P,
   max_tokens=MAX_TOKENS,
)
llama3_octai_endpoints_time = time.time() - start_time

# Print the response.
pprint.pprint(response.choices[0].message.content.replace('\n', ' '))
print(f"llama3_octai_endpoints_time: {format(llama3_octai_endpoints_time, '.2f')} seconds")
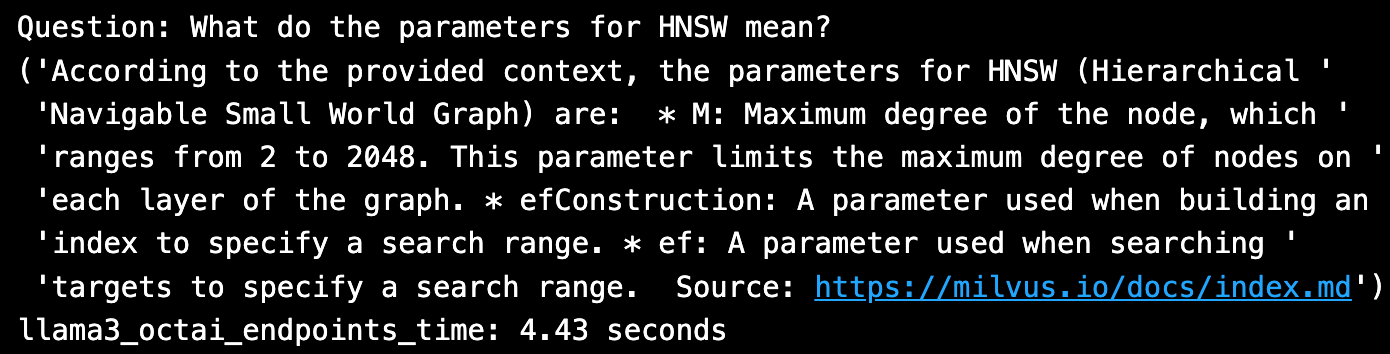
Ответ выглядит хорошо, и цитата идеальна. Вызов Llama 3 70B из OctoAI endpoints занял менее ~4 секунд.
Запуск Llama 3 из Groq LPU endpoints
Чтобы запустить инференс Llama 3 из Groq endpoints:
Перейдите на console.groq.com и следуйте инструкциям.
Получите ваш Groq endpoint API token и обновите переменные окружения.
Для Python выполните
pip install groq.Прочитайте о модели Llama 3 8B, загруженной с HuggingFace, и вызовите её.
from groq import Groq

LLM_NAME = "llama3-70b-8192"

groq_client = Groq(
   api_key=os.environ.get("GROQ_API_KEY"),
)

start_time = time.time()
response = groq_client.chat.completions.create(
   messages=[
       {"role": "system", "content": SYSTEM_PROMPT,},
       {"role": "user", "content": f"question: {SAMPLE_QUESTION}",}
   ],
   model=LLM_NAME,
   temperature=TEMPERATURE,
   seed=RANDOM_SEED,
   frequency_penalty=FREQUENCY_PENALTY,
   top_p=TOP_P,
   max_tokens=MAX_TOKENS,
)
llama3_groq_endpoints_time = time.time() - start_time

# Выведите ответ.
pprint.pprint(response.choices[0].message.content.replace('\n', ' '))
print(f"llama3_groq_endpoints_time: {format(llama3_groq_endpoints_time, '.2f')} seconds")
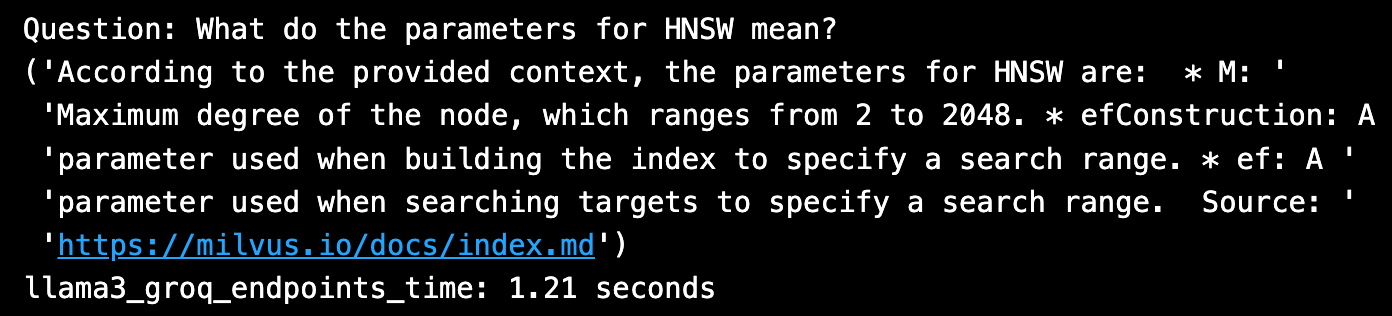
Ответ выглядит немного более лаконичным, а цитирование идеально. Llama 3 20B потребовалось ~1 секунда для вызова из конечных точек Groq LPU, что является самым быстрым инференсом на данный момент!
Примечание — чтобы запустить Mixtral, выполните все те же шаги, просто измените LLM_NAME на имя, используемое каждой Endpoint Platform для модели Mixtral.
Запуск GPT-4o от OpenAI
Чтобы запустить инференс новейшей GPT-4o от OpenAI:
Получите ваш API-токен OpenAI и обновите переменные окружения.
Следуйте инструкциям о том, как вызывать новую модель.
Для Python:
pip install --upgrade openai --quiet.Прочитайте о новой модели GPT-4o и вызовите её.
import openai, pprint
from openai import OpenAI

LLM_NAME = "gpt-4o" # "gpt-3.5-turbo"

openai_client = OpenAI(
   # This is the default and can be omitted
   api_key=os.environ.get("OPENAI_API_KEY"),
)

start_time = time.time()
response = openai_client.chat.completions.create(
   messages=[
       {"role": "system", "content": SYSTEM_PROMPT,},
       {"role": "user", "content": f"question: {SAMPLE_QUESTION}",}
   ],
   model=LLM_NAME,
   temperature=TEMPERATURE,
   seed=RANDOM_SEED,
   frequency_penalty=FREQUENCY_PENALTY,
   top_p=TOP_P,
   max_tokens=MAX_TOKENS,
)
chatgpt_4o_turbo_time = time.time() - start_time

# Print the question and answer along with grounding sources and citations.
print(f"Question: {SAMPLE_QUESTION}")
for i, choice in enumerate(response.choices, 1):
   message = choice.message.content.replace('\n', '')
   pprint.pprint(f"Answer: {message}")
print(f"chatgpt_4o_turbo_time: {format(chatgpt_4o_turbo_time, '.5f')}")
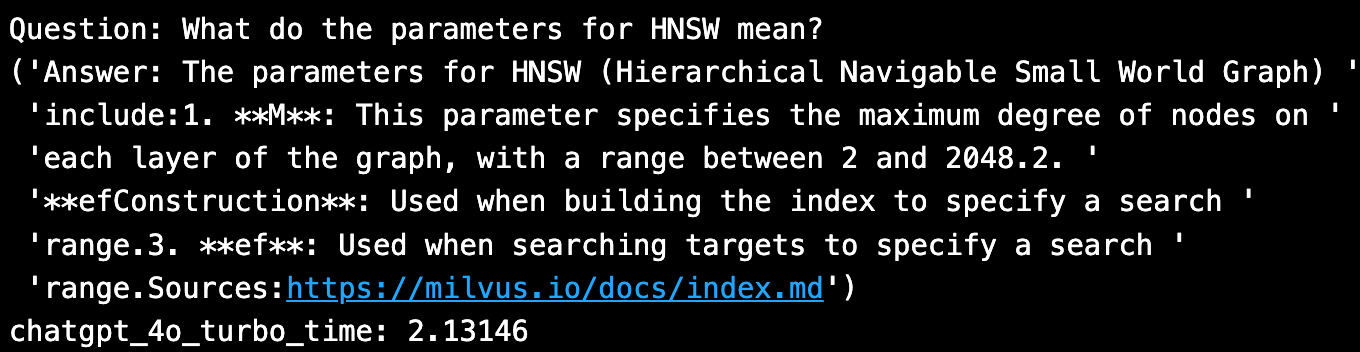
Новая модель GPT-4o выглядит хорошо и включает цитирование источника для обоснования. На инференс ушло 2 секунды.
Быстрая оценка ответа с использованием Ragas
В этом блоге я объясняю, как использовать open source Ragas для оценки RAG-систем. Ниже я использую только один вопрос-ответ. Более реалистичная оценка использовала бы ~20 вопросов.
import os, sys
import pandas as pd
import numpy as np
import ragas, datasets
from langchain_community.embeddings import HuggingFaceEmbeddings
from ragas.embeddings import LangchainEmbeddingsWrapper

from ragas.metrics import (
   # context_recall,
   # context_precision,
   # faithfulness,
   answer_relevancy,
   answer_similarity,
   answer_correctness
   )

# Read ground truth answers from file.
eval_df = pd.read_csv(file_path, header=0, skip_blank_lines=True)

# Possible LLM model choices to evaluate:
# openai gpt-4o = 'Custom_RAG_answer'
LLM_TO_EVALUATE = 'Custom_RAG_answer'
# LLM_TO_EVALUATE = 'llama3_ollama_answer'
# LLM_TO_EVALUATE = 'llama3_anyscale_answer'
# LLM_TO_EVALUATE = 'llama3_octoai_answer'
# LLM_TO_EVALUATE = 'llama3_groq_answer'
# LLM_TO_EVALUATE = 'mixtral_8x7b_anyscale_answer'

CONTEXT_TO_EVALUATE='Custom_RAG_context'
eval_metrics=[
    answer_relevancy,
    answer_similarity,
    answer_correctness,]
metrics = ['answer_relevancy', 'answer_similarity', 'answer_correctness']

# Change the default llm-as-critic, to save $.
LLM_NAME = "gpt-3.5-turbo"
ragas_llm = ragas.llms.llm_factory(model=LLM_NAME)

# Change the default embeddings to HuggingFace models.
EMB_NAME = "BAAI/bge-large-en-v1.5"
lc_embeddings = HuggingFaceEmbeddings(model_name=EMB_NAME)
ragas_emb = LangchainEmbeddingsWrapper(embeddings=lc_embeddings)

# Измените каждую метрику.
for metric in metrics:
   globals()[metric].llm = ragas_llm
   globals()[metric].embeddings = ragas_emb

# Выполните оценку.
ragas_result, score = _eval_ragas.evaluate_ragas_model(
   eval_df, eval_metrics, LLM_TO_EVALUATE,
   CONTEXT_TO_EVALUATE, EVALUATE_WHAT)

# Отобразите результаты.
print(f"Используя {eval_df.shape[0]} вопросов для оценки, средняя оценка = {score}")
display(ragas_result.head())
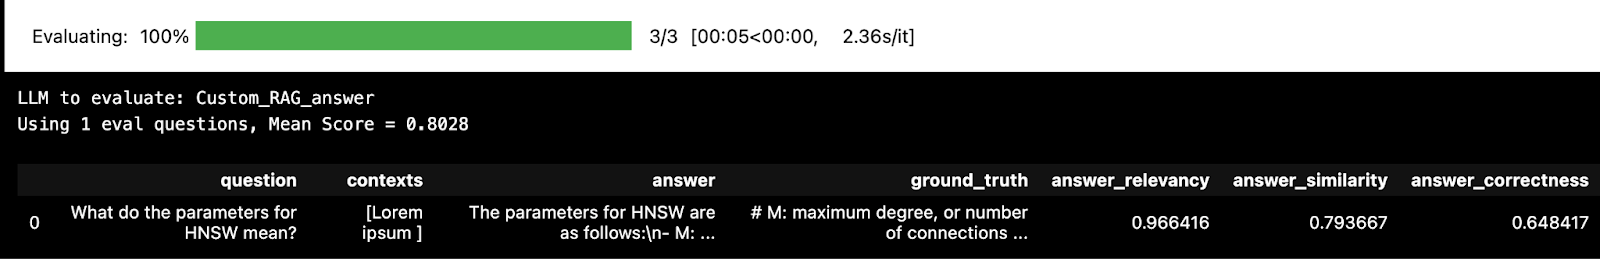
Ниже приведена таблица, обобщающая результаты.
| Эндпоинт модели | Ответ | Задержка (секунды) | Стоимость | Оценка ответа Ragas |
Ollama Llama 3 | Согласно предоставленному контексту и источникам [1, 65535], в Hierarchical Navigable Small World Graph (HNSW) есть два основных параметра: * `M`: Максимальная степень узлов на каждом слое графа. Диапазон — от 2 до 2048. * `ef` или `efConstruction`: Этот параметр задает диапазон поиска, который может использоваться при построении индекса или поиске целевых объектов. Эти параметры предназначены для повышения производительности и управления компромиссом между долей найденных релевантных результатов (улучшается при увеличении ef) и временем поиска (увеличивается при больших значениях M). | 13.74 | Бесплатно | 0.76 |
Anyscale endpoints Llama 3 | `Согласно контексту, параметры для HNSW следующие: * M: Максимальная степень узла, которая находится в диапазоне от 2 до 2048. Этот параметр ограничивает максимальную степень узлов на каждом слое графа. * efConstruction (при построении индекса): задает диапазон поиска при построении индекса. * ef (при поиске целевых объектов): задает диапазон поиска при поиске целевых объектов. | |||
Источник:[ https://milvus.io/docs/index.md](https://milvus.io/docs/index.md)'` | 5.94 | Бесплатная площадка | 0.80 | |
Anyscale Mixtral | `Параметр M для HNSW обозначает максимальную степень узла, то есть максимальное количество соединений, которое узел может иметь в структуре графа. Диапазон — от 2 до 2048. Кроме того, efConstruction и ef — это параметры, используемые для задания диапазона поиска во время построения индекса и поиска целевых объектов соответственно. | |||
Источники: 1.[ https://milvus.io/docs/index.md](https://milvus.io/docs/index.md) 2. [https://milvus.io/docs/index.md](https://milvus.io/docs/index.md)'` | 3.57 | Бесплатная площадка | 0.79 | |
OctoAI Llama 3 | `Согласно предоставленному контексту, параметры для HNSW (Hierarchical Navigable Small World Graph) следующие: * M: Максимальная степень узла, которая находится в диапазоне от 2 до 2048. Этот параметр ограничивает максимальную степень узлов на каждом слое графа. * efConstruction: Параметр, используемый при построении индекса для задания диапазона поиска. * ef: Параметр, используемый при поиске целевых объектов для задания диапазона поиска. | |||
Источник:[ https://milvus.io/docs/index.md](https://milvus.io/docs/index.md) ` | 4.43 | $0.15 за миллион токенов | 0.73 | |
Groq Llama 3 | `Согласно предоставленному контексту, параметры для HNSW следующие: * M: Максимальная степень узла, которая находится в диапазоне от 2 до 2048. * efConstruction: Параметр, используемый при построении индекса для задания диапазона поиска. * ef: Параметр, используемый при поиске целевых объектов для задания диапазона поиска. | |||
Источник: [https://milvus.io/docs/index.md`](https://milvus.io/docs/index.md) | 1.21 | `Бесплатно | ||
| бета` | 0.79 | |||
Openai gpt-4o | Параметры для HNSW следующие:``- M: Максимальная степень узла, ограничивающая количество соединений, которые каждый узел может иметь в графе. Диапазон — [2, 2048].``- efConstruction: Параметр, используемый во время построения индекса для задания диапазона поиска.``- ef: Параметр, используемый при поиске целевых объектов для задания диапазона поиска.``Источники:https://milvus.io/docs/index.md | 2.13 | `$5/M входных | |
| $15/M выходных` | 0.803 |
Источник: код автора и https://console.anyscale.com/v2/playground, https://console.groq.com/playground?model=llama3-70b-8192, https://octoai.cloud/text?selectedTags=Chat, https://openai.com/api/pricing/.
Заключение
Сегодня у нас есть множество вариантов моделей и конечных точек инференса на выбор для части G-Generation в RAG! Все конечные точки, опробованные в этом блоге, имеют различное качество ответов (по оценке GPT-критика), задержки и стоимость, которые следует учитывать.
Читать далее
Introducing Loon: A New Storage Engine for Vector Data That Never Stops Changing
Loon is a new storage engine for Milvus 3.0 and Zilliz Vector Lakebase, built to manage evolving vector datasets with ColumnGroups, row ID alignment, and Manifests.
Vector Lakebase: End the AI Data Silo
Learn how Vector Lakebase unifies vector search, data lakes, and AI data operations so teams can serve RAG and agents without copy-and-sync pipelines.
Why Not All VectorDBs Are Agent-Ready
Explore why choosing the right vector database is critical for scaling AI agents, and why traditional solutions fall short in production.