




Как озёра метаданных расширяют возможности AI/ML-приложений нового поколения
По мере того как технологии ИИ, такие как большие языковые модели (LLMs) и Retrieval Augmented Generation (RAG), продолжают развиваться, растет спрос на гибкую и эффективную инфраструктуру данных. Организации ищут архитектуры данных, которые могут поддерживать эти новые инструменты, минимизируя технический долг и обеспечивая бесштабное масштабирование.
Озера метаданных становятся ключевым решением в этом отношении. Это централизованные репозитории, которые хранят метаданные из различных источников в организации, предлагая единый подход к управлению данными. Метаданные обеспечивают контекст и понимание хранимых данных, включая источник данных, качество, происхождение, владение, содержание, структуру и контекст.
Lisa N. Cao, менеджер по продукту в Datastrato, недавно выступила с докладом на Unstructured Data Meetup, организованном Zilliz, где обсудила критическую роль озер метаданных в разработке ИИ/ML следующего поколения. Опираясь на свой опыт инженера данных, Лиза поделилась наблюдениями о том, как озера метаданных могут упростить управление данными и интегрироваться с различными технологиями, такими как векторные базы данных, модели глубокого обучения и LLMs в средах, управляемых ИИ.
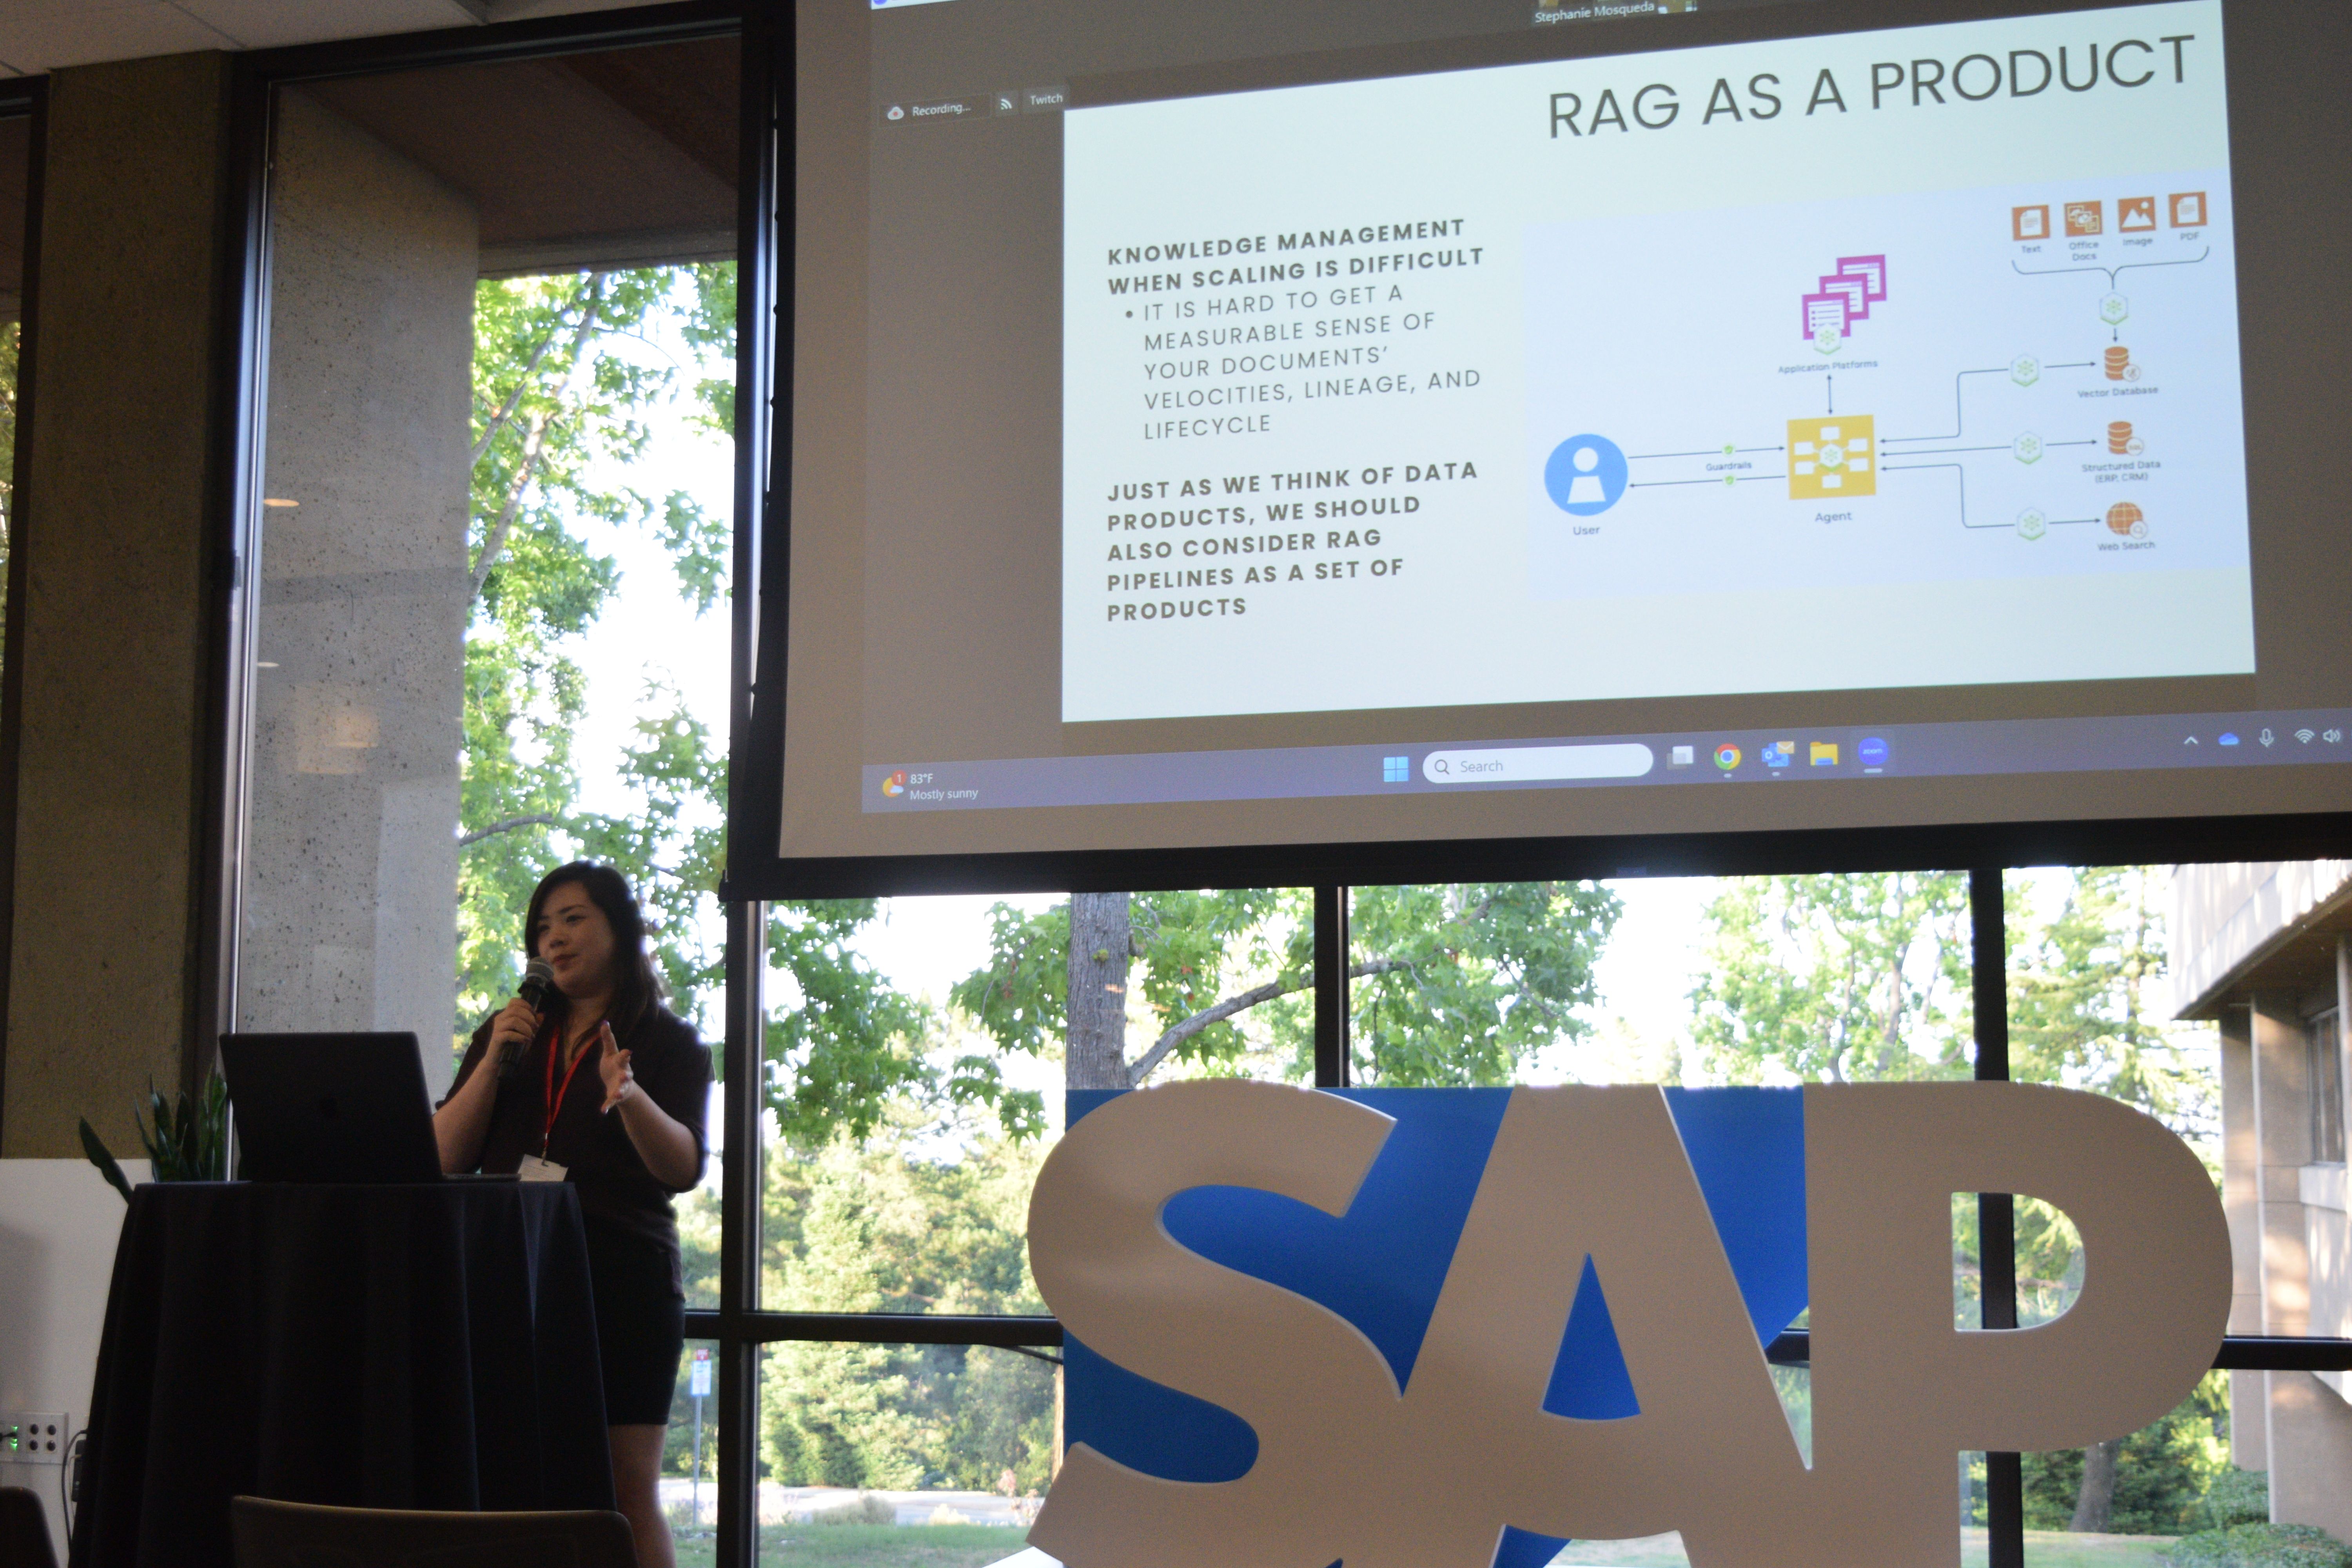 Lisa выступает на июньском Unstructured Data Meetup в Palo Alto
В этом блоге кратко изложены ключевые тезисы Лизы и рассматриваются проблемы развертывания RAG-конвейеров в production. Но сначала давайте кратко представим RAG и проблемы в разработке и развертывании RAG.
Краткое введение в RAG (Retrieval Augmented Generation)
RAG, или Retrieval-Augmented Generation, — это продвинутый фреймворк, который улучшает ответы LLM, объединяя модули поиска и генерации. Модуль поиска включает векторную базу данных, такую как Milvus или Zilliz Cloud (полностью управляемый Milvus), и модель эмбеддингов, а генеративный модуль обычно представляет собой LLM, такую как ChatGPT.
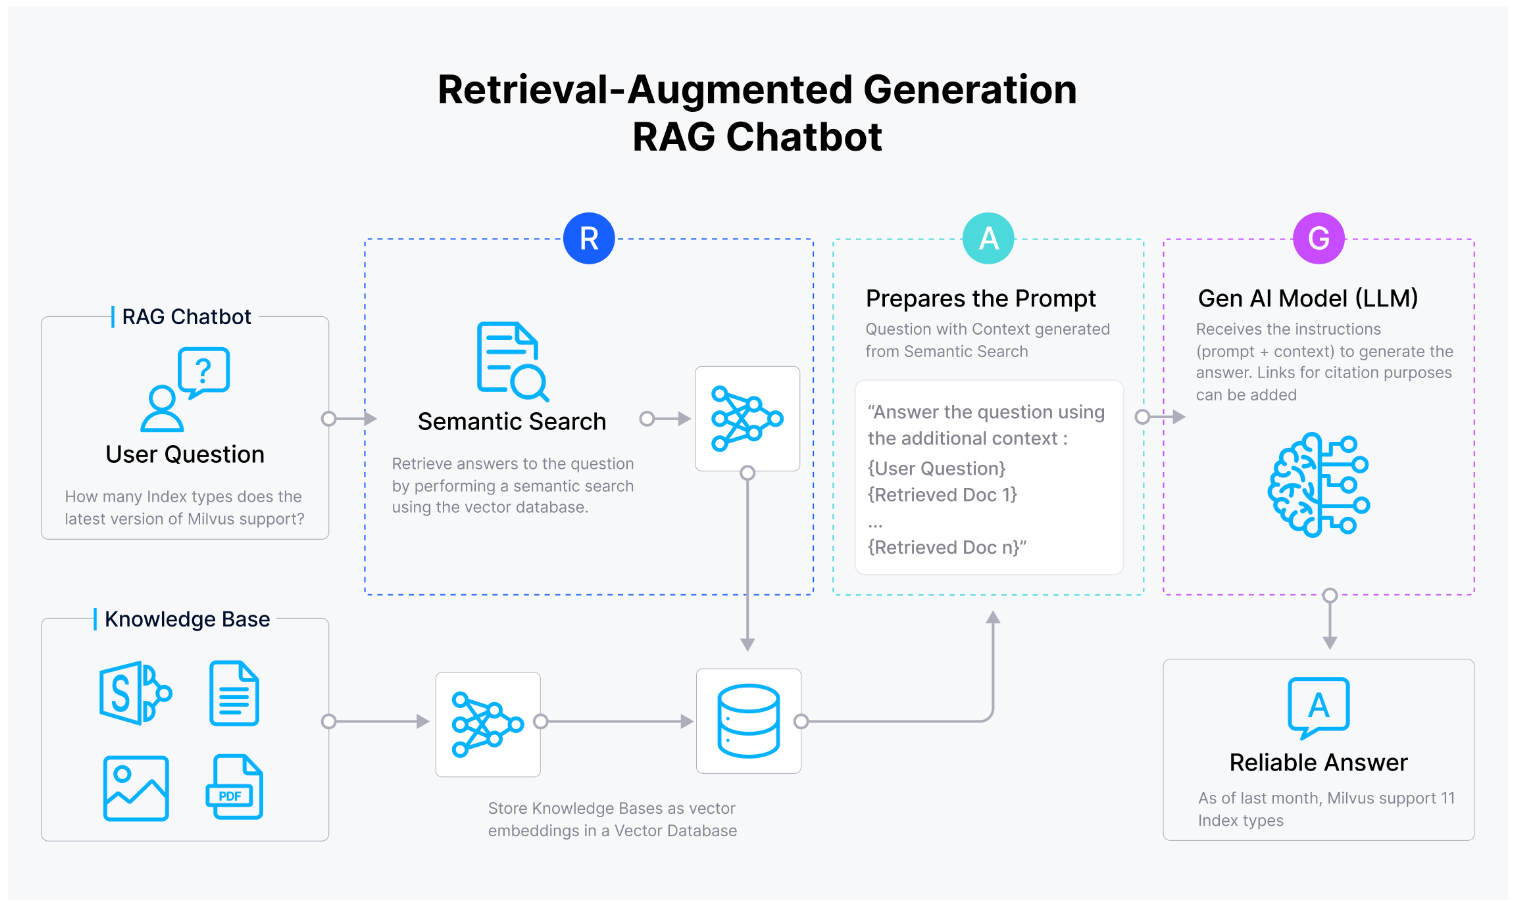 Figure 1 Как работает RAG
Рисунок 1: Как работает RAG
Когда пользователь вводит запрос в приложение RAG, векторная база данных в модуле поиска извлекает наиболее релевантные документы из большого текстового корпуса. Эти извлеченные документы называются «top candidates» и передаются в LLM в качестве контекста пользовательского запроса для генерации более точного ответа. RAG особенно полезен в приложениях, таких как ответы на вопросы, чат-боты и системы управления знаниями.
Текущие проблемы в разработке RAG
В последнее время в RAG-конвейер было внедрено множество продвинутых техник для повышения точности и производительности, включая сложные методы поиска на основе повторного ранжирования и рекурсивного поиска, а также техники тонкой настройки на основе эмбеддингов и LLM. Кроме того, были представлены агентные фреймворки, предназначенные для маршрутизации и планирования запросов, чтобы расширить возможности RAG.
Однако эти достижения также привносят новые сложности. Лиза обсудила несколько проблем, с которыми сталкиваются многие команды ИИ при разработке и развертывании RAG в production:
Низкая наблюдаемость: Мониторинг скорости загрузки документов и изменений распределения данных в RAG-конвейерах представляет собой сложную задачу. Поскольку векторная база данных в RAG-приложении часто хранит миллиарды документов, отслеживание изменений и обновлений данных для управления знаниями становится затруднительным.
Управление жизненным циклом: Эффективный контроль версий и управление жизненным циклом имеют решающее значение для отслеживания изменений и обновлений данных. Командам нужны надежные инструменты, чтобы прозрачно и с возможностью аудита отслеживать происхождение данных и обеспечивать соблюдение требований.
Задержка и оптимизация: Хотя продвинутая тонкая настройка и рекурсивный поиск могут повысить точность генерируемых результатов, они также могут увеличить время ответа, приводя к более высокой задержке и более низкой удовлетворенности пользователей.
Контекстные ответы на запросы: Сложные пользовательские запросы могут быть трудны для точной интерпретации LLM, что приводит к ответам, которым не хватает контекста или нюансов.
Конфиденциальность данных: Управление ИИ — еще одна проблема, особенно когда речь идет о добавлении маскирования или шифрования к данным, используемым в обучении.
Механизм непрерывного обучения: Лиза подчеркнула важность поддержания RAG-приложений в актуальном состоянии с помощью свежих данных. «Существует огромная разница между моделями, которые получают доступ к непрерывно обновляемым данным, и теми, которые полагаются на устаревшие данные», — отметила она. Однако реализация механизма непрерывного обучения может быть технически сложной.
Привязка к поставщику: Сильная зависимость от одного поставщика облачных услуг для потребностей конвейера может привести к привязке к поставщику, из-за чего переход в другую экосистему становится сложным и затратным.
Одна из фундаментальных проблем, способствующих возникновению этих сложностей, — это наличие разрозненных хранилищ данных в организациях.
Разрозненные хранилища данных в организациях: ключевой фактор сложностей RAG
Разрозненные хранилища данных — распространенная проблема в организациях, где данные не являются легко доступными для разных команд или отделов из-за структурных или технологических барьеров. Такие изолированные хранилища могут существовать на операционном уровне, между различными командами или из-за сложности используемых инструментов и приложений.
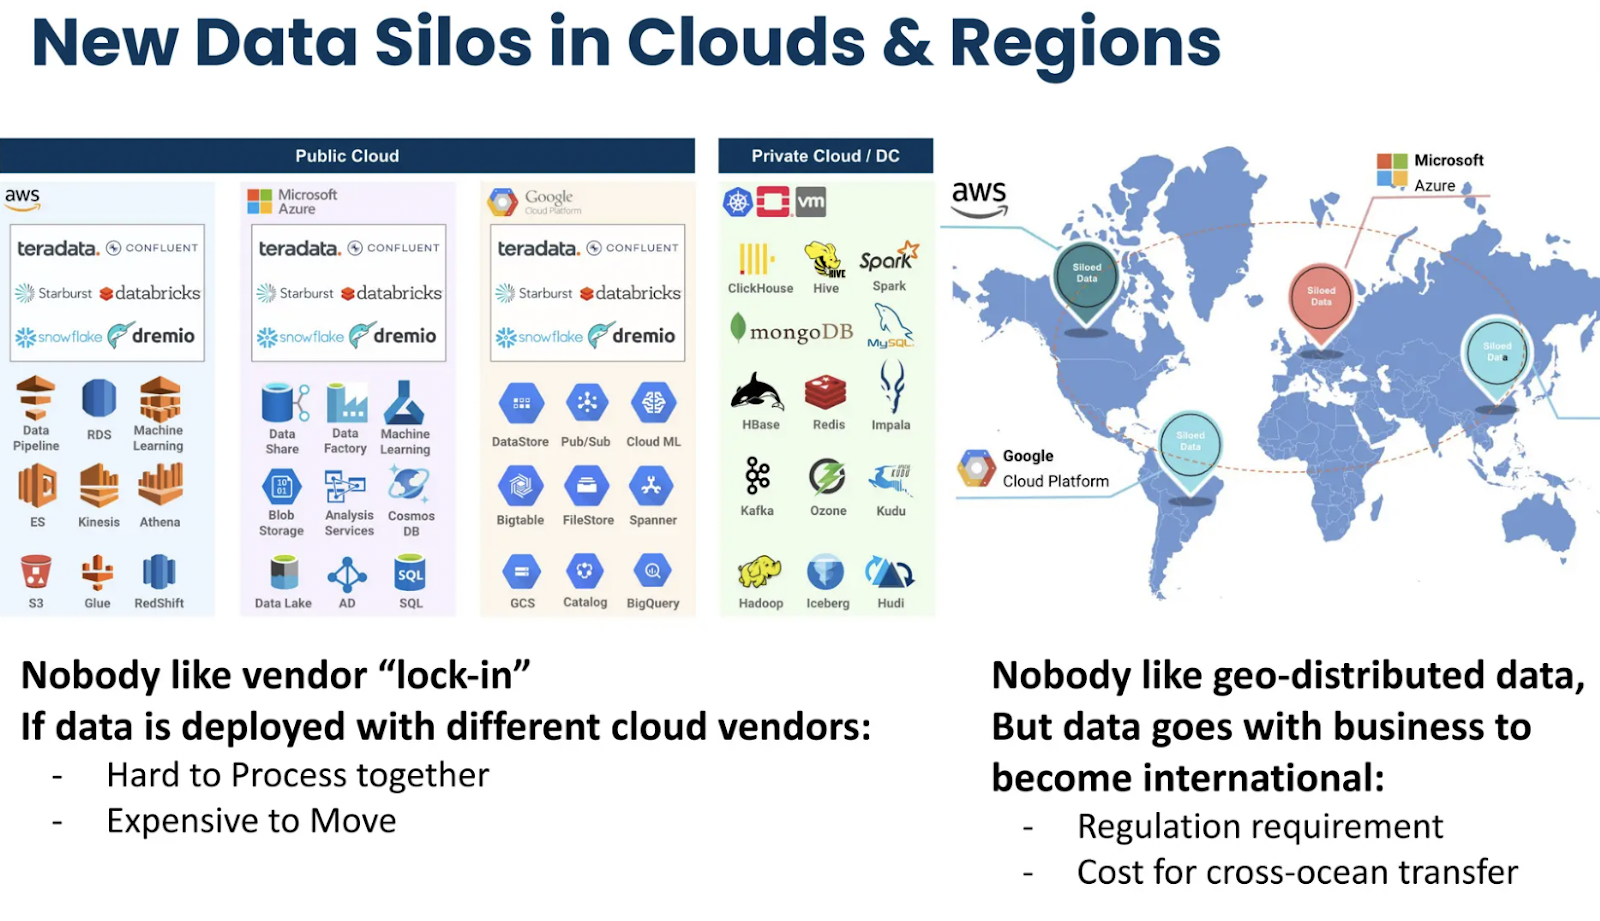 Рисунок 2- Влияние разрозненных хранилищ данных на эффективность в организациях
Рисунок 2: Влияние разрозненных хранилищ данных на эффективность в организациях
Лиза подчеркнула повсеместную проблему разрозненных хранилищ данных, отметив: «Каждая компания пытается ответить на этот вопрос: „Как нам обеспечить операционную согласованность наших данных во всей организации?“» Это особенно сложно, когда команды распределены по всему миру и работают с разными хранилищами данных.
Также существуют барьеры между разными командами. Например, BI-аналитики и инженеры данных часто используют разные инструменты и могут не иметь эффективной коммуникации. Некоторые команды могут не обладать знаниями программирования или техническими навыками для доступа к доступным данным и их обработки. Например, DevOps-инженерам может быть трудно понять кодовую базу ML-инженеров.
Разрозненные хранилища данных напрямую влияют на способность создавать и поддерживать эффективные RAG-конвейеры, поскольку они препятствуют беспрепятственному потоку данных по организации. Отсутствие такой интеграции может привести к фрагментации источников данных, несогласованности в использовании данных и, в конечном итоге, к сложностям при развертывании RAG-систем, которые зависят от всеобъемлющих и актуальных данных.
Озера метаданных: преодоление разрыва для унифицированного управления данными
Чтобы решить вышеупомянутые проблемы RAG, бизнесу нужны решения в области архитектуры данных для унификации, стандартизации и операционализации данных во всей организации. Озера метаданных предлагают гибкую архитектуру для хранения и управления метаданными — информацией об источнике, структуре, формате, использовании, происхождении и многом другом.
Что такое озеро метаданных?
Озеро метаданных, или управление метаданными озера данных, — это централизованное хранилище, в котором хранятся метаданные из различных источников в организации. Метаданные — это описательная информация, которая предоставляет контекст и понимание данных в озере данных. Обычно они включают такие сведения, как источник данных, качество, происхождение, владелец, содержимое, структура и контекст.
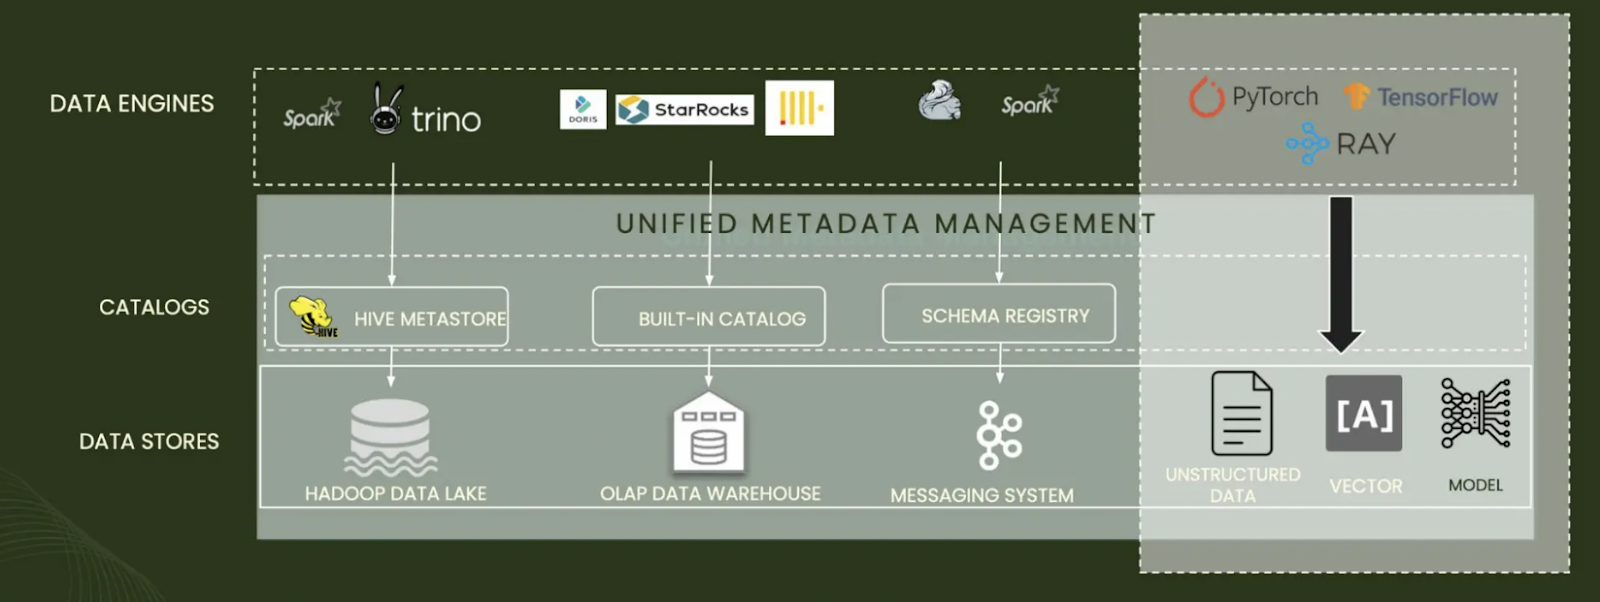 Figure 3- A unified metadata management .png
Рисунок 3: Унифицированное управление метаданными
В отличие от традиционного озера данных, которое хранит необработанные данные, озеро метаданных фокусируется на управлении, организации и обеспечении доступа к метаданным, связанным с информационными активами в различных системах, базах данных и приложениях.
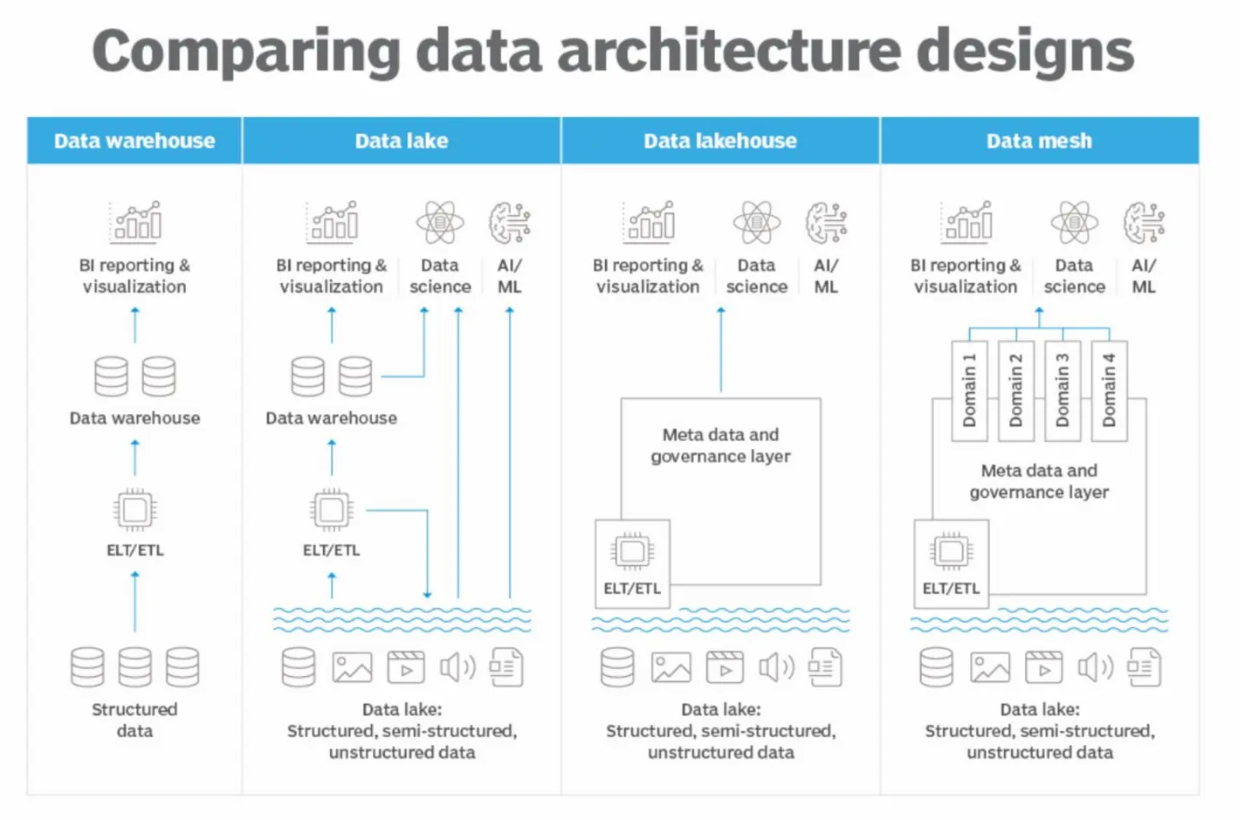 Figure 4- Comparing different data architecture designs
Рисунок 4: Сравнение различных вариантов архитектуры данных
Преимущества озер метаданных
Улучшенное обнаружение данных: Озера метаданных служат централизованными каталогами, храня все метаданные и упрощая командам и пользователям поиск информационных активов в организации.
Активные метаданные: Эти озера поддерживают активные метаданные, которые могут запускать действия и интегрироваться с оркестрированными конвейерами, автоматизируя задачи и снижая необходимость ручного вмешательства.
Встроенные метаданные: Метаданные могут быть встроены в различные приложения, обеспечивая бесшовную интеграцию и взаимодействие в экосистеме данных.
Улучшенное управление ИИ: Централизация управления метаданными упрощает внедрение согласованных политик управления, обеспечивая соблюдение требований и качество данных. Озера метаданных также поддерживают детальное отслеживание происхождения данных, контроль доступа и возможности аудита.
Эффективное использование расширенных метаданных: Унифицированное управление метаданными позволяет шире использовать метаданные, например для обогащения, маскирования данных и классификации, повышая качество, безопасность и удобство использования данных.
В целом озера метаданных упрощают и автоматизируют управление жизненным циклом данных, облегчая сотрудничество между техническими командами и помогая устранить информационные разрозненные хранилища, которые препятствуют разработке RAG.
Демонстрация: создание озер метаданных с помощью Gravitino
Лиза поделилась своим опытом работы над open-source-проектом, в рамках которого озеро метаданных было разработано с использованием Gravitino. Проект был направлен на создание каталога данных, поддерживающего нескольких поставщиков облачных сервисов, включая AWS, Azure и GCP. Он позволяет пользователям регистрировать различные источники данных в озере метаданных, такие как S3 buckets, векторная база данных Milvus, HiMetastores и другие хранилища данных. Gravitino также предоставляет средства контроля доступа и инструменты для отслеживания происхождения данных и содействия аудиту.
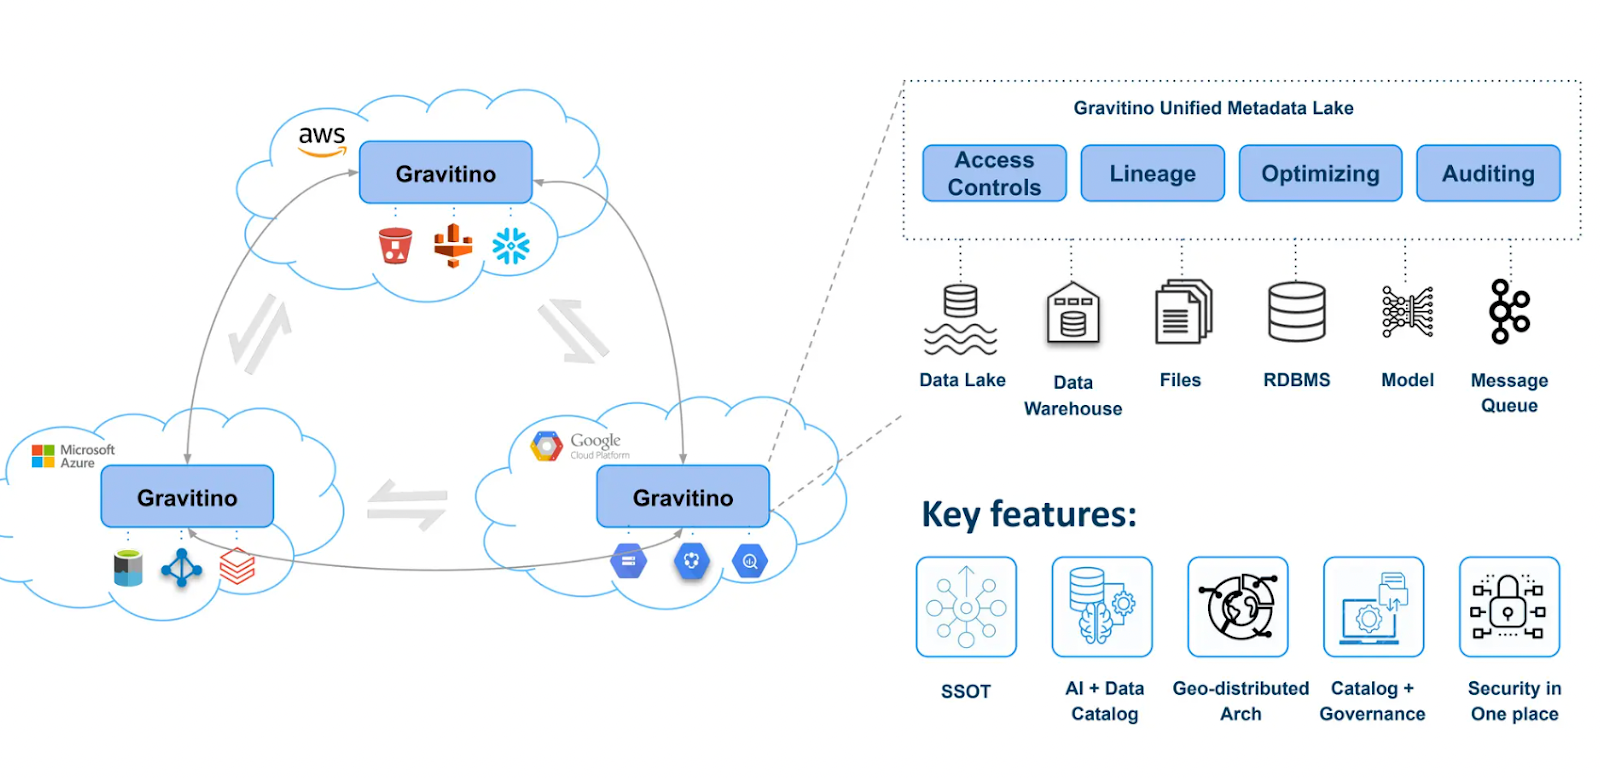 Figure 5- The metadata lake architecture built with Gravitino
Рисунок 5: Архитектура озера метаданных, построенная с использованием Gravitino
Архитектура использует REST APIs для предоставления метаданных различным приложениям. Слои подключения преобразуют все данные в общую схему перед сохранением в озере метаданных. Gravitino поддерживает как табличные, так и нетабличные форматы данных и позволяет применять маскирование на основе тегов для обеспечения безопасности данных.
Команды, работающие с ИИ, также могут интегрировать графы знаний и векторные хранилища в рамках системы управления метаданными, создавая унифицированный каталог. Благодаря федеративной природе каталога запросы могут получать доступ к метаданным без перемещения исходных данных. Операции соединения выполняются либо в памяти, либо в заданных местах, оптимизируя производительность и поддерживая целостность данных в распределенных средах.
Заключение
Озёра метаданных эволюционируют в AI-каталоги, которые управляют метаданными и интегрируются с рабочими процессами AI и ML. Эти озёра могут помогать в разработке RAG, регистрации моделей, управлении AI и внедрении продвинутой аналитики. Предоставляя единый уровень для операций с данными, озёра метаданных позволяют командам поддерживать наблюдаемость в анализе метаданных, обеспечивать плавные переходы между различными облачными средами и источниками данных, такими как векторная база данных Milvus, и беспрепятственно поддерживать фреймворки управления. По мере развития технологий AI озёра метаданных будут играть ключевую роль в поддержке приложений AI/ML следующего поколения.
Дополнительные ресурсы
 Fendy Feng
 is the Technical Marketing Writer at Zilliz. She has extensive experience developing and enhancing the impact of open-source projects in various global markets by producing high-quality, tailored content. Before joining Zilliz, Fendy worked as a Content Strategist at PingCAP, a fast-growing E-Series startup renowned for its open-source distributed SQL database.
 ShriVarsheni R
Читать далее
Vector Lakebase: End the AI Data Silo
Learn how Vector Lakebase unifies vector search, data lakes, and AI data operations so teams can serve RAG and agents without copy-and-sync pipelines.
How Zilliz Saw the Future of Vector Databases—and Built for Production
An inside look at how Zilliz built vector databases for real-world use, focusing on scalability, stability, and running them reliably at scale.
Zilliz Cloud Launches in AWS Australia, Expanding Global Reach to Australia and Neighboring Markets
We're thrilled to announce that Zilliz Cloud is now available in the AWS Sydney, Australia region (ap-southeast-2).