




Consensus、Zilliz Cloudを活用し4億以上の学術情報源にわたるエージェント型学術検索を構築
4億+
検索可能な学術情報源
~45 ms
本番環境におけるP99デンス検索のレイテンシ
14%高い
セマンティック検索追加後の検索結果の精度
4×大きい
クラスターサイズのわずか2.5倍のベクトルで、レイテンシーのペナルティなし
1日 → 1時間
毎日のバルクインポートによる、4億以上のベクトルコレクション全体の完全な再インデックス化
私たちの仕事は、Consensusを利用するすべての人にとって最高の研究を見つけられるようにすることです。Zilliz Cloudは、私たちのリサーチエージェントに高速で高品質なセマンティック検索を提供し、到達できるエビデンスの範囲を直接的に広げます。
Christian Salem
Consensusについて
Consensusは科学研究のためのオペレーティングシステムを構築しています。12,500以上の大学で1,000万人以上の研究者、学生、臨床医が利用するエージェントプラットフォームであり、論文のスクリーニング、エビデンスの統合、研究の退屈な部分の自動化を行い、本当の科学に戻れるようにします。Consensusはこれまでに1億5,000万以上の研究質問を処理し、世界中の次の1億人の研究者を加速するために4,500万ドルを調達しました。
 Consensus插图1.png
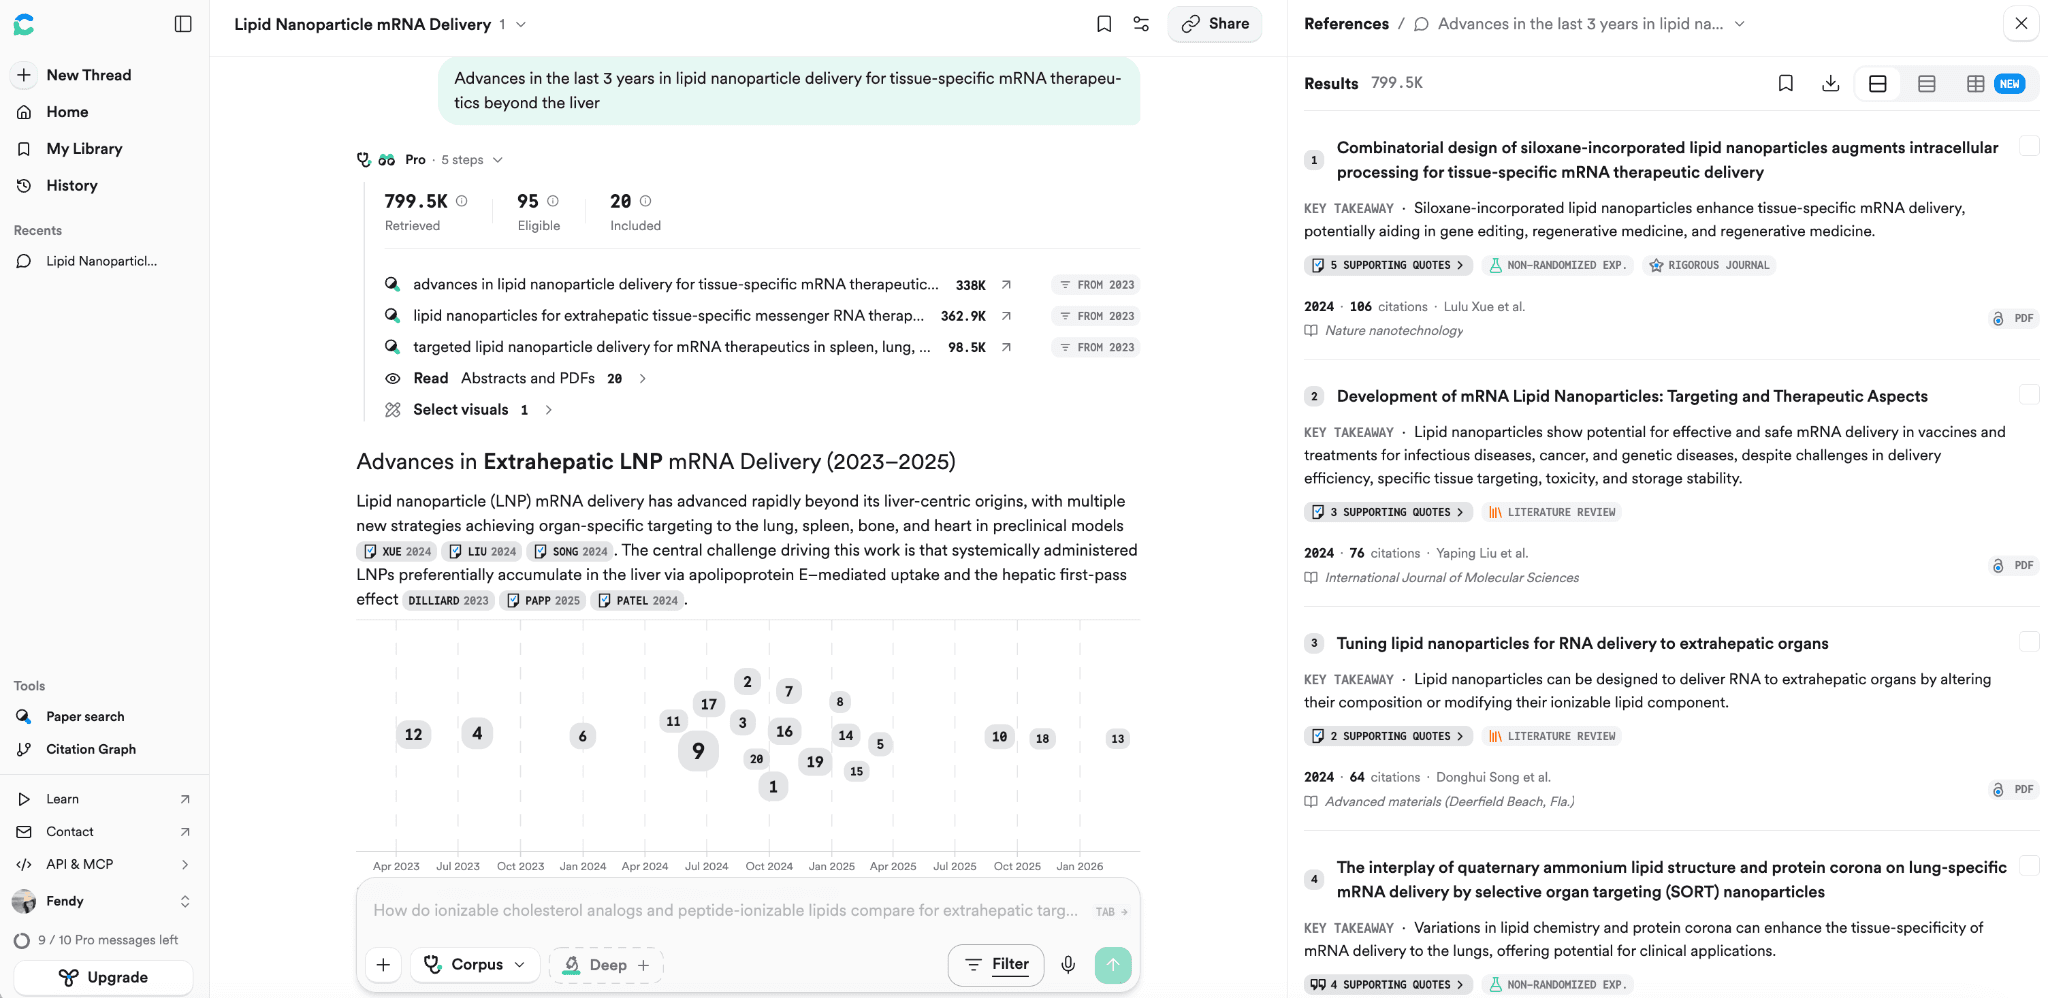
このプラットフォームの基盤は、4億以上の学術ソースにわたるワールドクラスのエージェント型検索です。ConsensusはAIモデル自身の知識から答えることは決してなく、すべての主張は実際に取得された論文に遡る必要があります。また、研究エージェントは単一の質問に答えるために何度も検索を呼び出すことができます。製品の品質は見つけ出した論文によって決まるため、検索はConsensusの中核です。Zilliz Cloudはその最も重要なコンポーネントの1つを支えています。それは、研究者が本当に尋ねていることを理解し、それに答える研究を提示するセマンティック検索です。
課題
Consensusの検索エンジンは以前、スパース検索とBM25キーワード検索の2つの検索手法を実行していました。これらはほとんどのクエリをうまく処理していました。しかし、ハードルは上がっていました。Consensusは文献レビューをエージェント型アーキテクチャに移行しており、1つの質問が多くの検索呼び出しに変わるため、検索は毎回正しい論文を見つけて高速に返す必要がありました。キーワード検索とスパース検索は、同じことを異なる用語で表現している論文を見落とします。研究者は常にこの問題に直面します。なぜなら、質問に答える論文は、同じ概念に対して独自の用語を使う近隣分野からのものであることが多いからです。このギャップを埋めるには密ベクトル検索が鍵となります。そこでチームはまずElasticsearchでテストしましたが、さらに3つの問題に直面しました。
- 数億ベクトルで検索品質が低下しました。 その数の密ベクトルを格納するために、チームはバイナリ量子化で圧縮する必要があり、その圧縮によりランキング品質に測定可能な損失が生じました。研究製品にとって、これは誤ったトレードオフです。
- 全コレクションの再インデックス化に24時間以上かかりました。 新しい研究が検索可能になるまでに1日以上かかり、また各候補の埋め込みモデルの評価に本番環境で丸1日かかるため、チームがより良いモデルを採用するスピードが遅れました。
- ベクトルを大きくすると、ストレージ請求額が大幅に増加しました。 数億ベクトルの場合、ベクトルサイズやカバレッジを増やすたびにコレクション全体でコストが発生するため、チームはベクトルを希望よりも小さく保たざるを得ませんでした。
Zilliz Cloudを選んだ理由
Consensusは4つの選択肢で実際の比較検証を行いました。すでに実行していたElasticsearch内の密ベクトル検索、プロトタイプを作成した自己運用のオープンソースベクトルライブラリFAISS、Pinecone、そしてZilliz Cloudです。Zilliz Cloudは4つの点で勝利しました。
- ベクトルを圧縮せずに、より良い結果を実現。 チーム自身のテストでは、Zilliz Cloudは億単位のスケールで、精度を犠牲にしていた以前の圧縮を行わずに、より正確な検索結果を高い再現率を保ったまま提供しました。
- フルコレクションの再構築が、1日以上かかっていたところから約1時間に短縮。 コレクション全体を毎日一括インポートすることで、完全な再構築は特別なプロジェクトから毎晩のジョブに変わりました。これにより、新しい埋め込みモデルをテストする際のイテレーションも大幅に高速化されました。
- 同じトラフィックとベクトル数で、ストレージコストを削減。 その削減効果により、4倍のサイズのベクトルを最大4分の1のコストで利用でき、その結果、関連性が顕著に向上しました。
- マネージドサービスであり、チームが好む開発者体験を提供。 ConsensusはFAISSでプロトタイプを作成し、技術的には能力があると判断しましたが、本番環境で運用するには、チームが所有することに興味のないオーケストレーションと運用のオーバーヘッドを引き受ける必要がありました。また、チームはZilliz Cloud SDKのドキュメントが充実しており、開発しやすく、日常のコレクション操作のためのコンソールも分かりやすいと感じました。
ソリューション
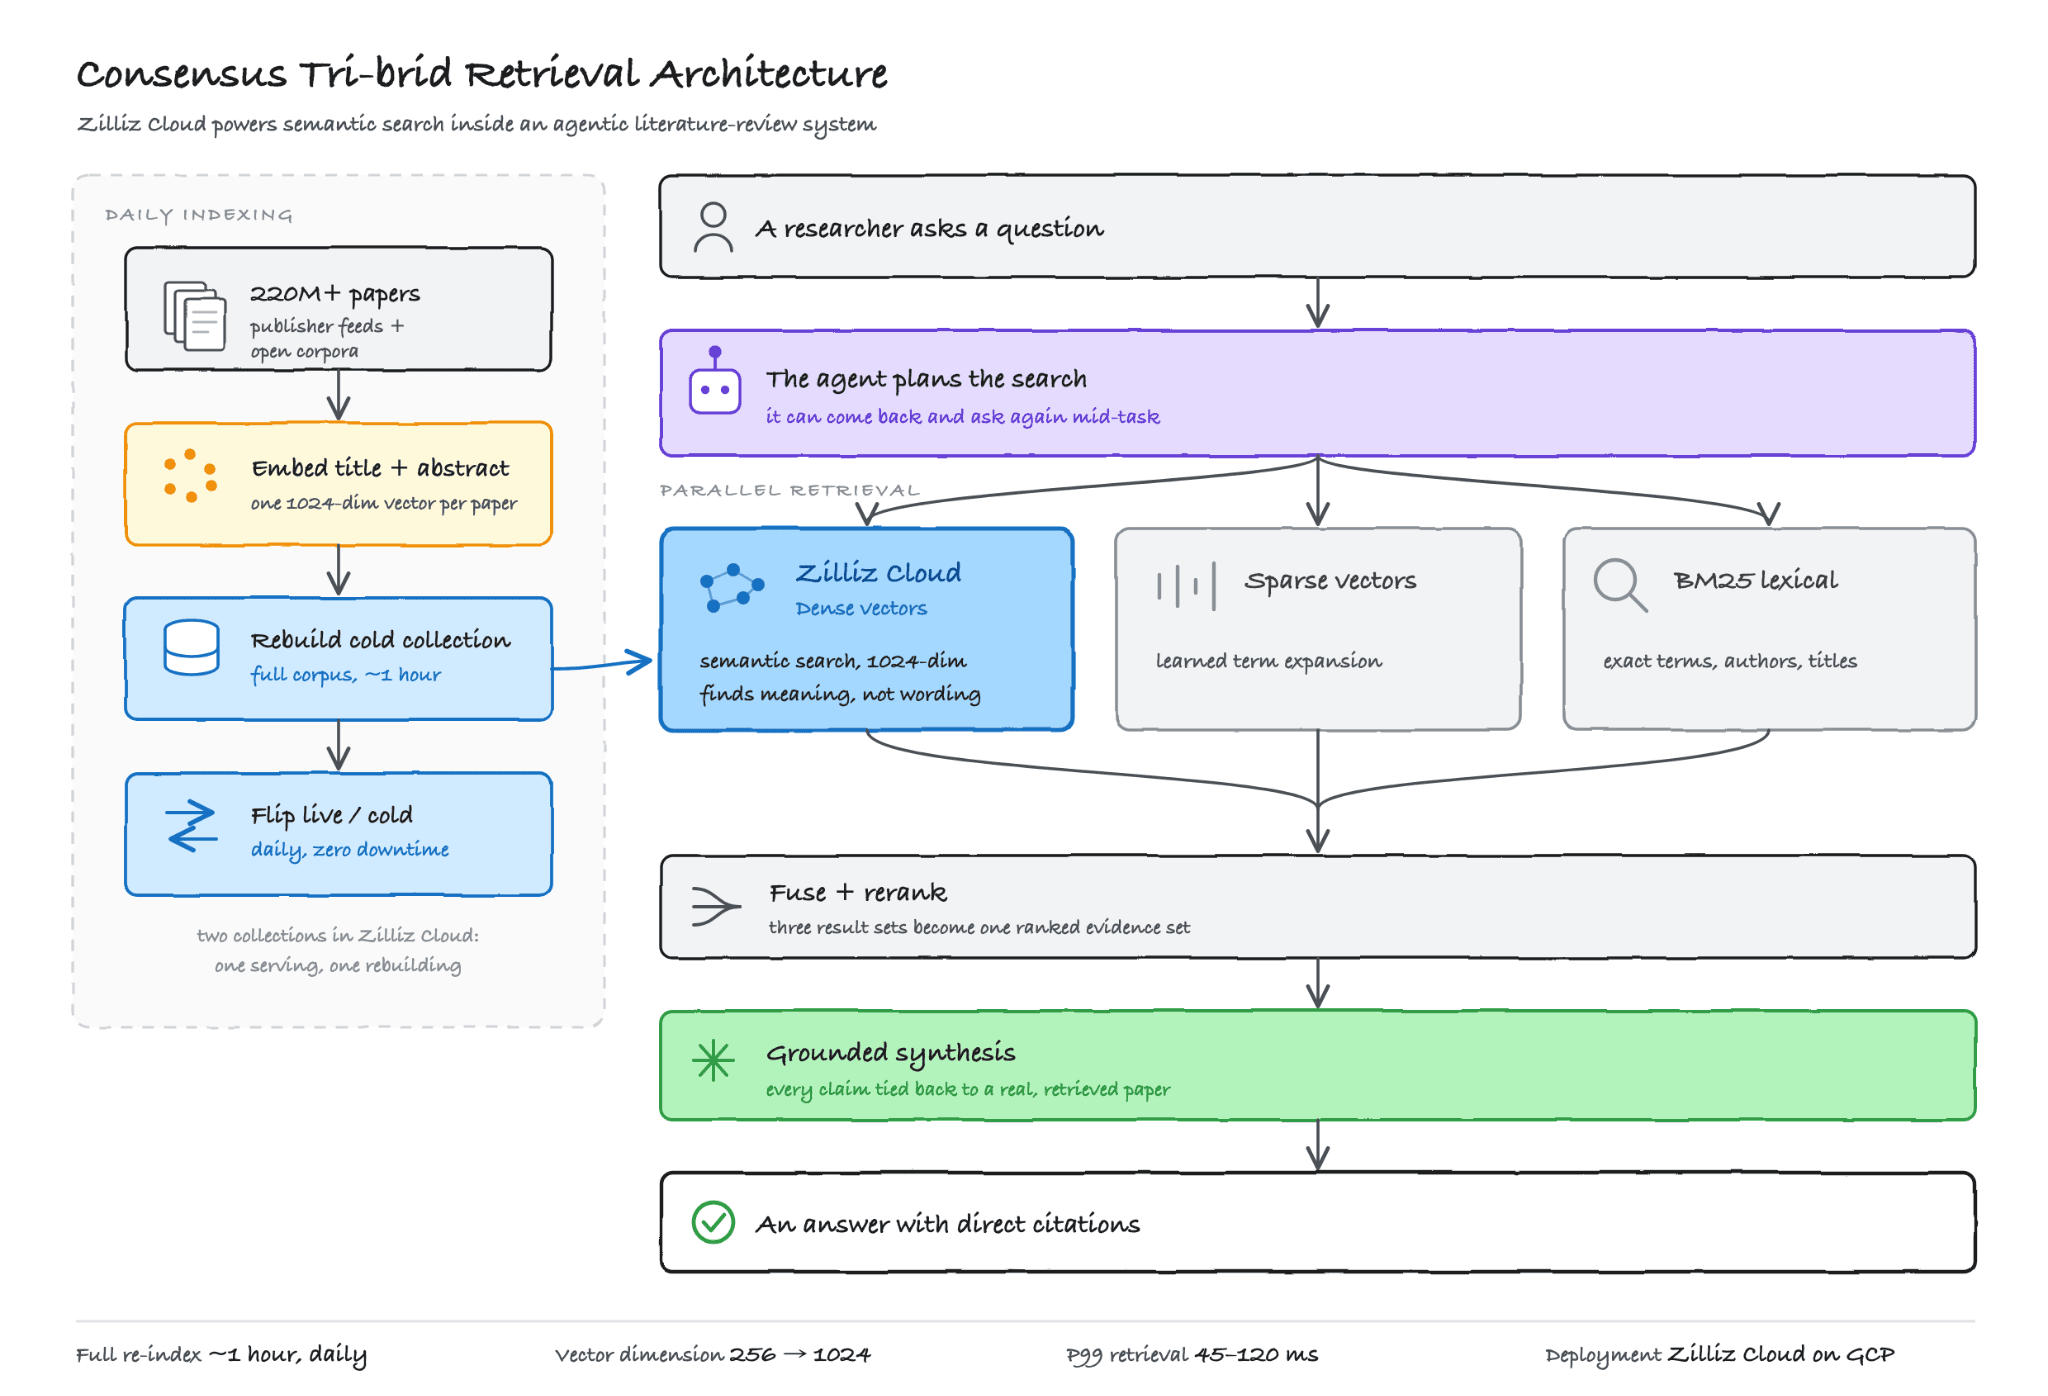
Consensusは、検索質問に対して、適切な論文または論文の一部を取得し、それらから回答を合成することで回答します。すべての主張は実際の出版物に引用されて裏付けられます。これらの論文を見つけるために3つの検索パスが並行して実行されます。これはチームが「トライブリッド検索」と呼ぶアーキテクチャであり、Zilliz Cloudがセマンティック検索レイヤーを支えています。つまり、使用されている単語ではなく意味によって質問を論文にマッチングし、他のパスが見逃す論文も見つけ出します。スタックの他の部分と同様にGoogle Cloud上で実行されます。
 Concensus插图2.png
クエリ時に、エージェントは検索を計画し、ツールとして検索を呼び出します。パスは並行して実行され、その結果は融合され、単一のエビデンスセットに再ランク付けされます。そしてモデルは回答を書き、すべての主張を取得した論文に結び付けます。これが、文献レビューエージェントと、主張の賛否に関する発表済みエビデンスを評価するConsensus Meterの背後にある仕組みです。
これを機能させる3つの設計上の選択があります。
Zilliz Cloud内のライブ/コールドのコレクションペアを、毎日ゼロから再構築。
この規模のインデックスを最新に保つ一般的な方法は、その場で更新することです。つまり、変更を検出し、新しいベクトルを書き込み、古いベクトルを削除し、台帳を正しく保つことです。Consensusはそのすべてをスキップします。Zilliz Cloudにコレクションのコピーを2つ(合計4億以上のベクトル)保持し、1つはクエリを処理し、もう1つはアイドル状態です。そして毎日、アイドル状態のコピーを一括インポートでゼロから再構築し、ライブに切り替えます。
これは、完全な再構築が毎日実行できるほど高速であり、ストレージが2つ目のコピーを保持できるほど安価である場合にのみ、賢明な設計です。 以前のシステムでは、どちらも当てはまりませんでした。Zilliz Cloudでは、両方とも当てはまります。つまり、コレクション全体が約1時間でインポート、インデックス作成され、利用可能になり、しかもストレージコストは低くなります。したがって、より単純な設計が勝ちます。つまり、サービス提供中のコレクションに書き込まれることは決してなく、調整するバックログもなく、新しい埋め込みモデルは、異なるベクトルを使用した同じ再構築にすぎません。コーパスは常に最新であり、研究者が常に最新の出版物にアクセスできることを保証します。
「チームがZillizで見つけたのは、非常に高速であるため、基本的にコレクション全体をゼロから再取り込みできるということです。インデックスのコピーが2つあり、1時間で全体を取り込み、その後スイッチを切り替えます。現在では基本的に毎日実行できます。これにより、新しいアイデアを試すことにためらいがないため、実験も大幅に促進されました。」 — ヒース・ホーワルド氏、Consensus、テックリーダー兼検索マネージャー
学術ソースごとに1つの1,024次元ベクトル。
各ソースは、タイトルとアブストラクトから単一のベクトルに埋め込まれます。チームは当初、コストとレイテンシがベクトルサイズに比例して増大すると想定し、256次元から始めました。Zilliz Cloudでは、次元を256から1,024へ4倍に増やしたところ、クラスターサイズはチームが予想した4倍ではなくおよそ2.5倍で済み、レイテンシの増加もごくわずかでした。チームの内部ベンチマークでは、1,024次元の埋め込みにより、小さいモデルと比較して発見された論文の品質が27%向上したため、Consensusは1,024次元を採用しました。
エージェントが直接呼び出すツールとしてのセマンティック検索
Zilliz Cloudは、単一の検索ステップの背後に隠されるのではなく、文献レビューエージェントが呼び出し可能なツールとして公開されています。エージェントは質問を作り直し、複数の角度から検索し、見つけたものを読んだ後にさらに検索することができるため、1つのタスクが多数の呼び出しになることもあります。このようなツール呼び出しは、すべての呼び出しが高速かつ正確である場合にのみ機能します。遅いまたは不正確な検索は、エージェントが行う追加の呼び出しごとに増幅されるからです。400M以上のベクトルに対してP99約45msという性能により、セマンティック検索はエージェントにツールとして提供できるほど高速かつ正確であり、単一のクエリでは見逃してしまうような見つけにくい論文を追跡することができます。
結果と利点
- ストレージコストを最大4分の1に削減、その節約分は検索品質の向上に充てられました。同じトラフィックとベクトル数でストレージコストが低減し、チームが品質向上に費やせる余裕が生まれました。
- セマンティック検索の追加により検索結果の精度が14%向上。Consensus独自の内部ベンチマークで測定されました。この効果は、研究者が使ったことのない言葉で質問に答える論文、つまり従来のスタックでは見逃していたであろう論文に対して最も顕著です。
- 400M以上のベクトルに対するP99検索が約45ms。これはチームがZilliz Cloudに設定した150msというP90目標の3分の1です。研究エージェントが一度きりの検索で重要な結果を見逃すことがある代わりに、単一のリクエスト内で複数回検索、検討、反復できるほど高速です。
- ベクトル次元の4倍化(256 → 1,024)は、Zilliz Cloudではクラスターサイズ2.5倍のコストで済み、線形スケーリングより約40%低く、レイテンシのペナルティもありませんでした。Consensusの内部ベンチマークでは、より大きな埋め込みにより、発見された論文の品質が27%向上しました。
- コレクション全体の完全再構築:24時間以上 → 約1時間。毎日の一括インポートとして実現。Consensusは現在、サービスを中断することなくコレクション全体を毎日再構築して入れ替えています。新しい研究は公開されたその日に検索可能になります。
- 反復ループが高速化。 より大きな埋め込み、新しいモデル、新しい検索戦略は、効果があるかどうかを確認する前に、1日かかる再構築と天秤にかける必要がなくなりました。
次のステップ
Consensusが進むすべての方向性において、Zilliz Cloudへの依存度は高まっています。エージェントフレームワークを通じてセマンティック検索をより広く公開することで、タスクごとの検索呼び出しが増え、高密度コレクションへのトラフィックも増加します。新しい埋め込みモデルは、1時間での再構築が可能にした毎日のペースでリリースされ続けるでしょう。現在アプリケーション層で処理されているメタデータフィルタリングは、Zilliz Cloudへの移行候補です。
最大の機会は、全文コンテンツをさらに活用することです。Consensusは出版社とのパートナーシップを通じてライセンスされた全文コンテンツを保有しており、その深みをZillizの高密度コレクションに取り込むことが自然な次のステップです。タイトルとアブストラクトではなく各論文の本文をインデックス化することで、コレクションは数倍に増え、研究者によりはるかにきめ細かいマッチングを提供できるでしょう。
「Consensusは本当に困難なことに挑戦しています。1つのタスクで同じコーパスに対して十数通りの質問をするかもしれないエージェントのために、世界の科学文献を意味によって検索可能にすることです。Zilliz Cloudがその背後にある検索基盤であることを誇りに思い、エージェント型研究が拡大していく中で、引き続き共に構築していくことを楽しみにしています。」 — Zilliz CTO、ジェームズ・ルアン
Zilliz Cloudでエージェント型AIを構築
エージェンティックシステムは検索に新たなプレッシャーをもたらします。1つのユーザーリクエストが、複数のセマンティック検索、再構成、エビデンス収集のパスになることがあります。RAGをスケーリングする場合でも、エージェンティック検索を構築する場合でも、Zilliz CloudはConsensusを支えるのと同じ検索基盤を提供します。
Zilliz Cloud で無料で始めるか、私たちのチームに直接相談 してください。
「これまでで最大の成果の一つは、テキスト上は一致しなくても意味的に関連するクエリをより適切に処理できるようになったことです。また、より長く会話的なクエリも大幅に改善されました。」
Heath Hohwald