Entmystifizierung des Milvus Sizing Tool
Einführung
Die Auswahl der optimalen Konfiguration für Ihre Milvus-Bereitstellung ist entscheidend für Performance-Optimierung, effiziente Ressourcennutzung und Kostenmanagement. Ganz gleich, ob Sie einen Prototyp erstellen oder eine Produktionsbereitstellung planen: Die richtige Dimensionierung Ihrer Milvus-Instanz kann den Unterschied zwischen einer reibungslos laufenden Vektordatenbank und einer ausmachen, die mit Performance-Problemen kämpft oder unnötige Kosten verursacht.
Um diesen Prozess zu vereinfachen, haben wir unser Milvus Sizing Tool überarbeitet, einen benutzerfreundlichen Rechner, der auf Grundlage Ihrer spezifischen Anforderungen empfohlene Ressourcenschätzungen erstellt. In diesem Leitfaden zeigen wir Ihnen, wie Sie das Tool verwenden, und geben tiefere Einblicke in die Faktoren, die die Milvus-Performance beeinflussen.
So verwenden Sie das Milvus Sizing Tool
Dieses Sizing-Tool ist super einfach zu verwenden. Folgen Sie einfach den folgenden Schritten.
Besuchen Sie die Seite des Milvus Sizing Tool.
Geben Sie Ihre wichtigsten Parameter ein:
Anzahl der Vektoren und Dimensionen pro Vektor
Indextyp
Datengröße skalarer Felder
Segmentgröße
Ihr bevorzugter Bereitstellungsmodus
Überprüfen Sie die generierten Ressourcenempfehlungen
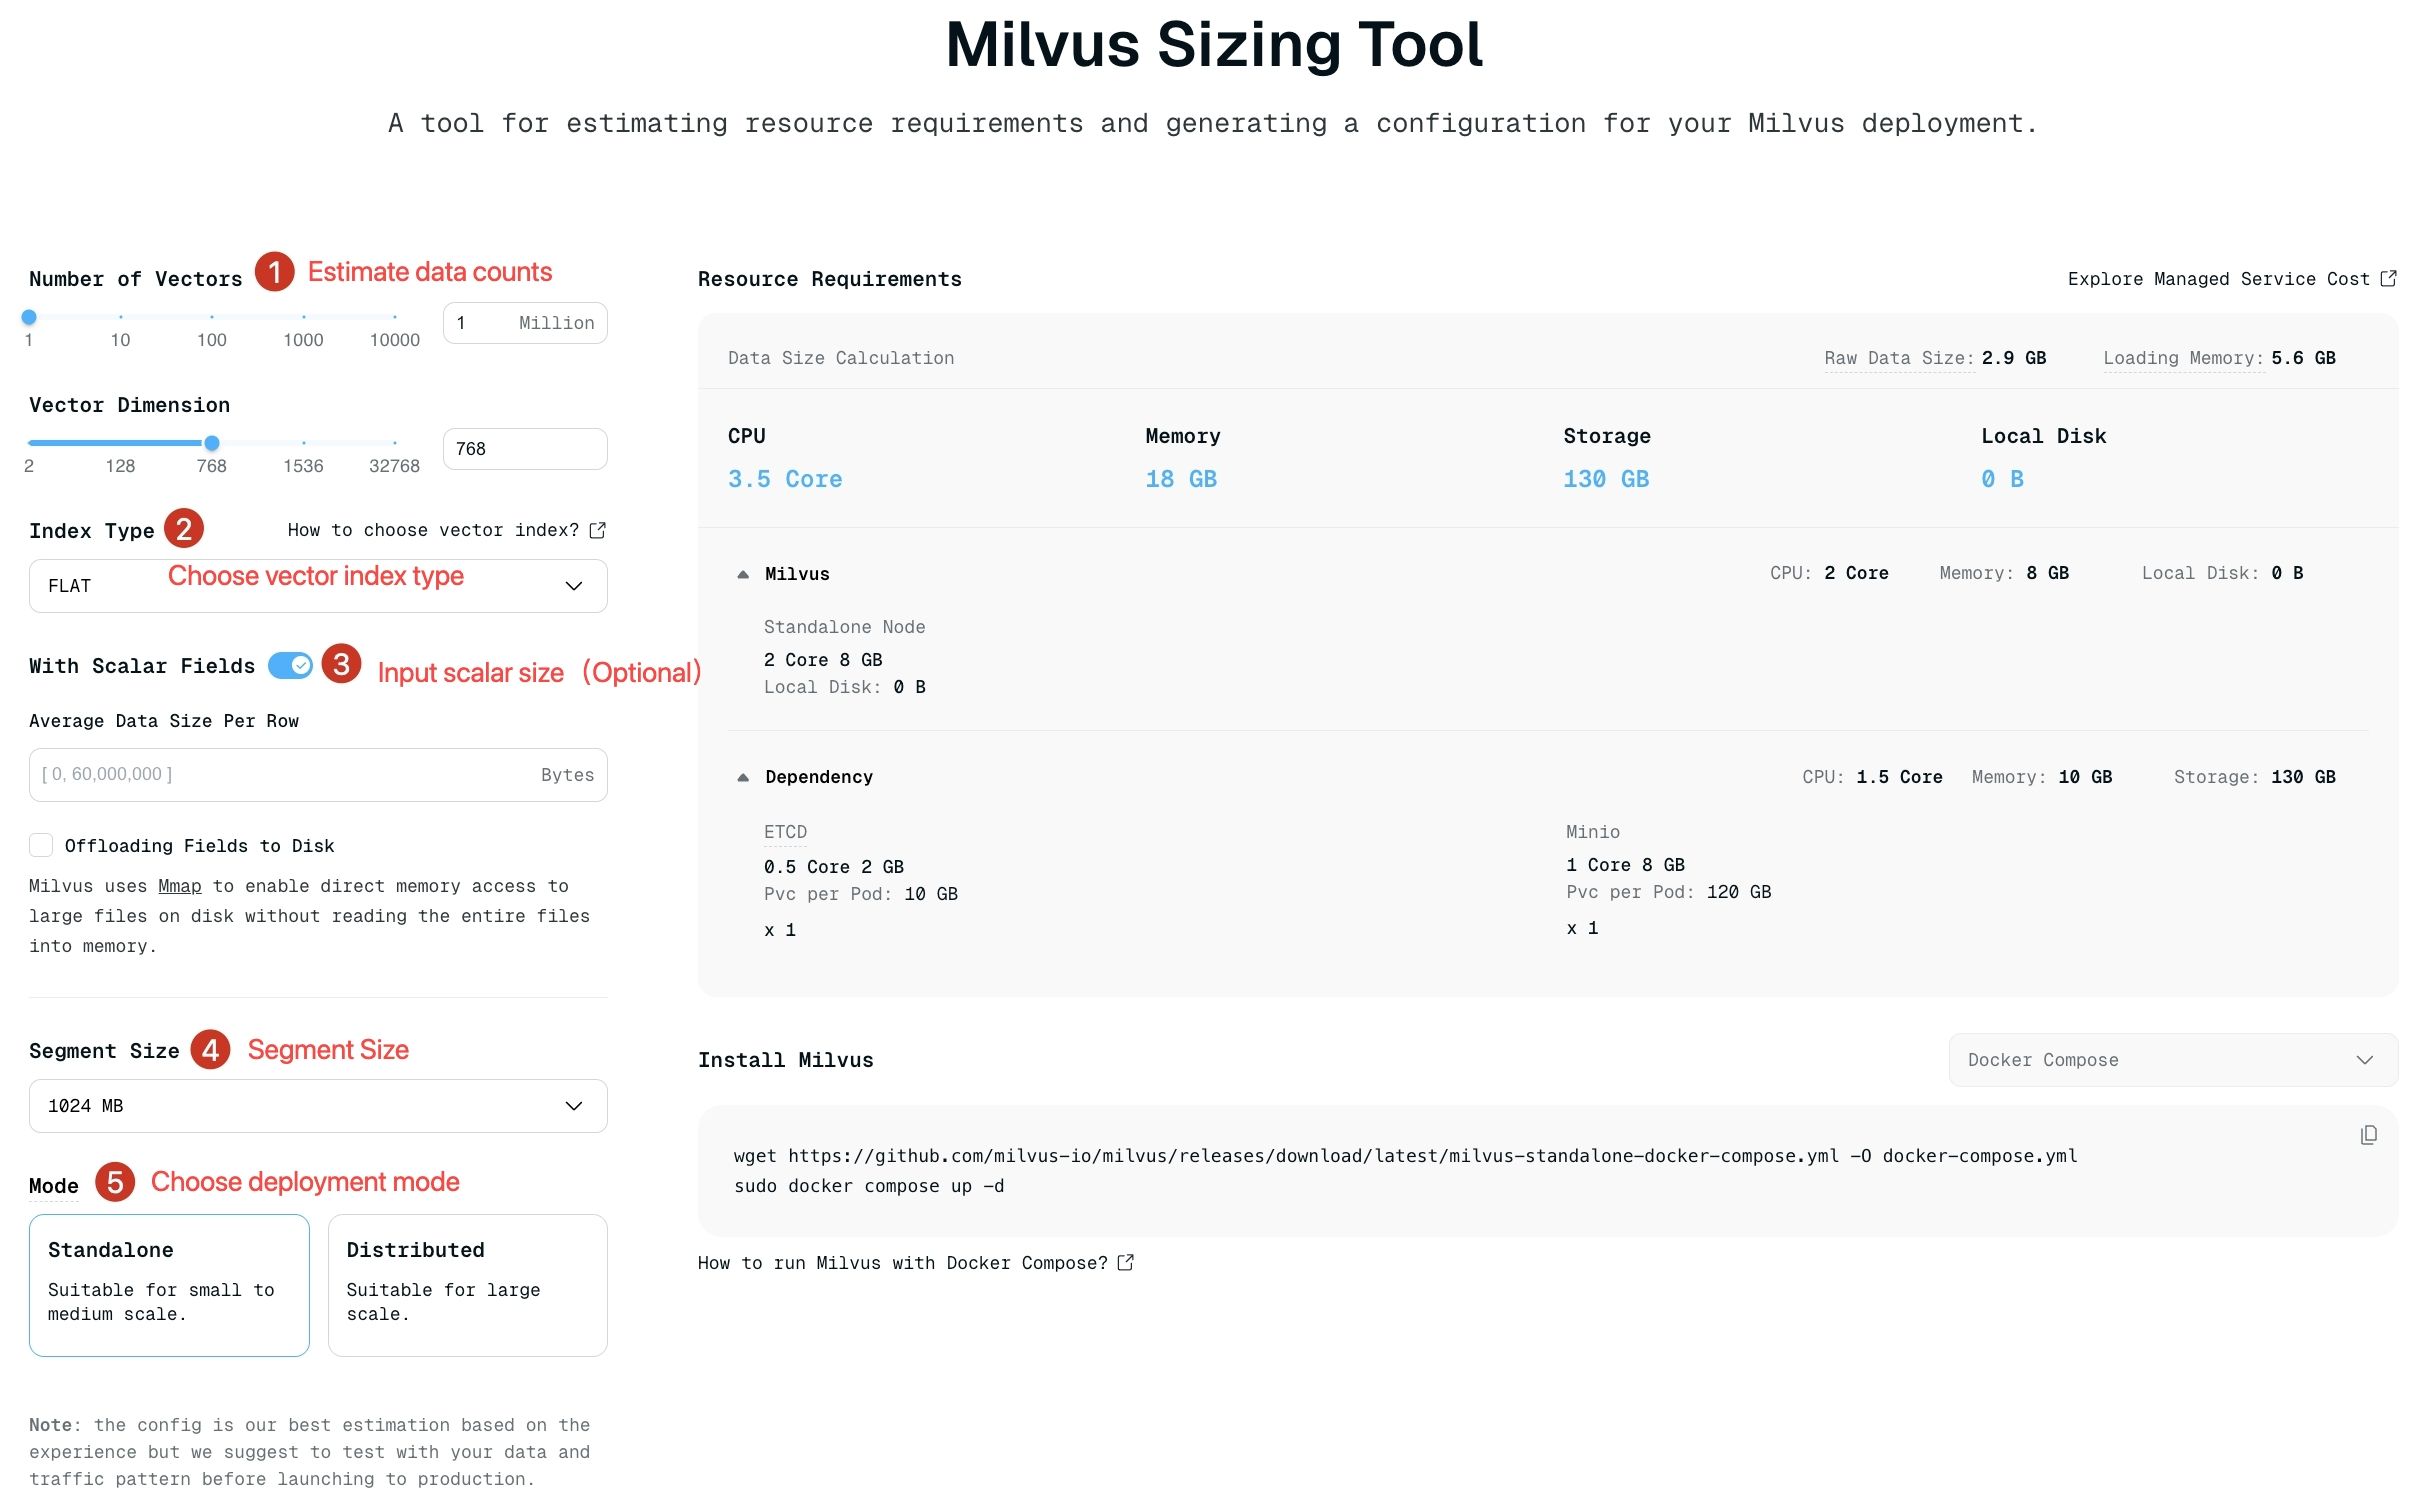 milvus sizing tool
Sehen wir uns an, wie sich jeder dieser Parameter auf Ihre Milvus-Bereitstellung auswirkt.
Indexauswahl: Speicher, Kosten, Genauigkeit und Geschwindigkeit ausbalancieren
Milvus bietet verschiedene Indexalgorithmen, darunter HNSW, FLAT, IVF_FLAT, IVF_SQ8, ScaNN, DiskANN und weitere, jeweils mit unterschiedlichen Kompromissen bei Speichernutzung, Speicherplatzanforderungen, Abfragegeschwindigkeit und Suchgenauigkeit.
Folgendes müssen Sie über die gängigsten Optionen wissen:
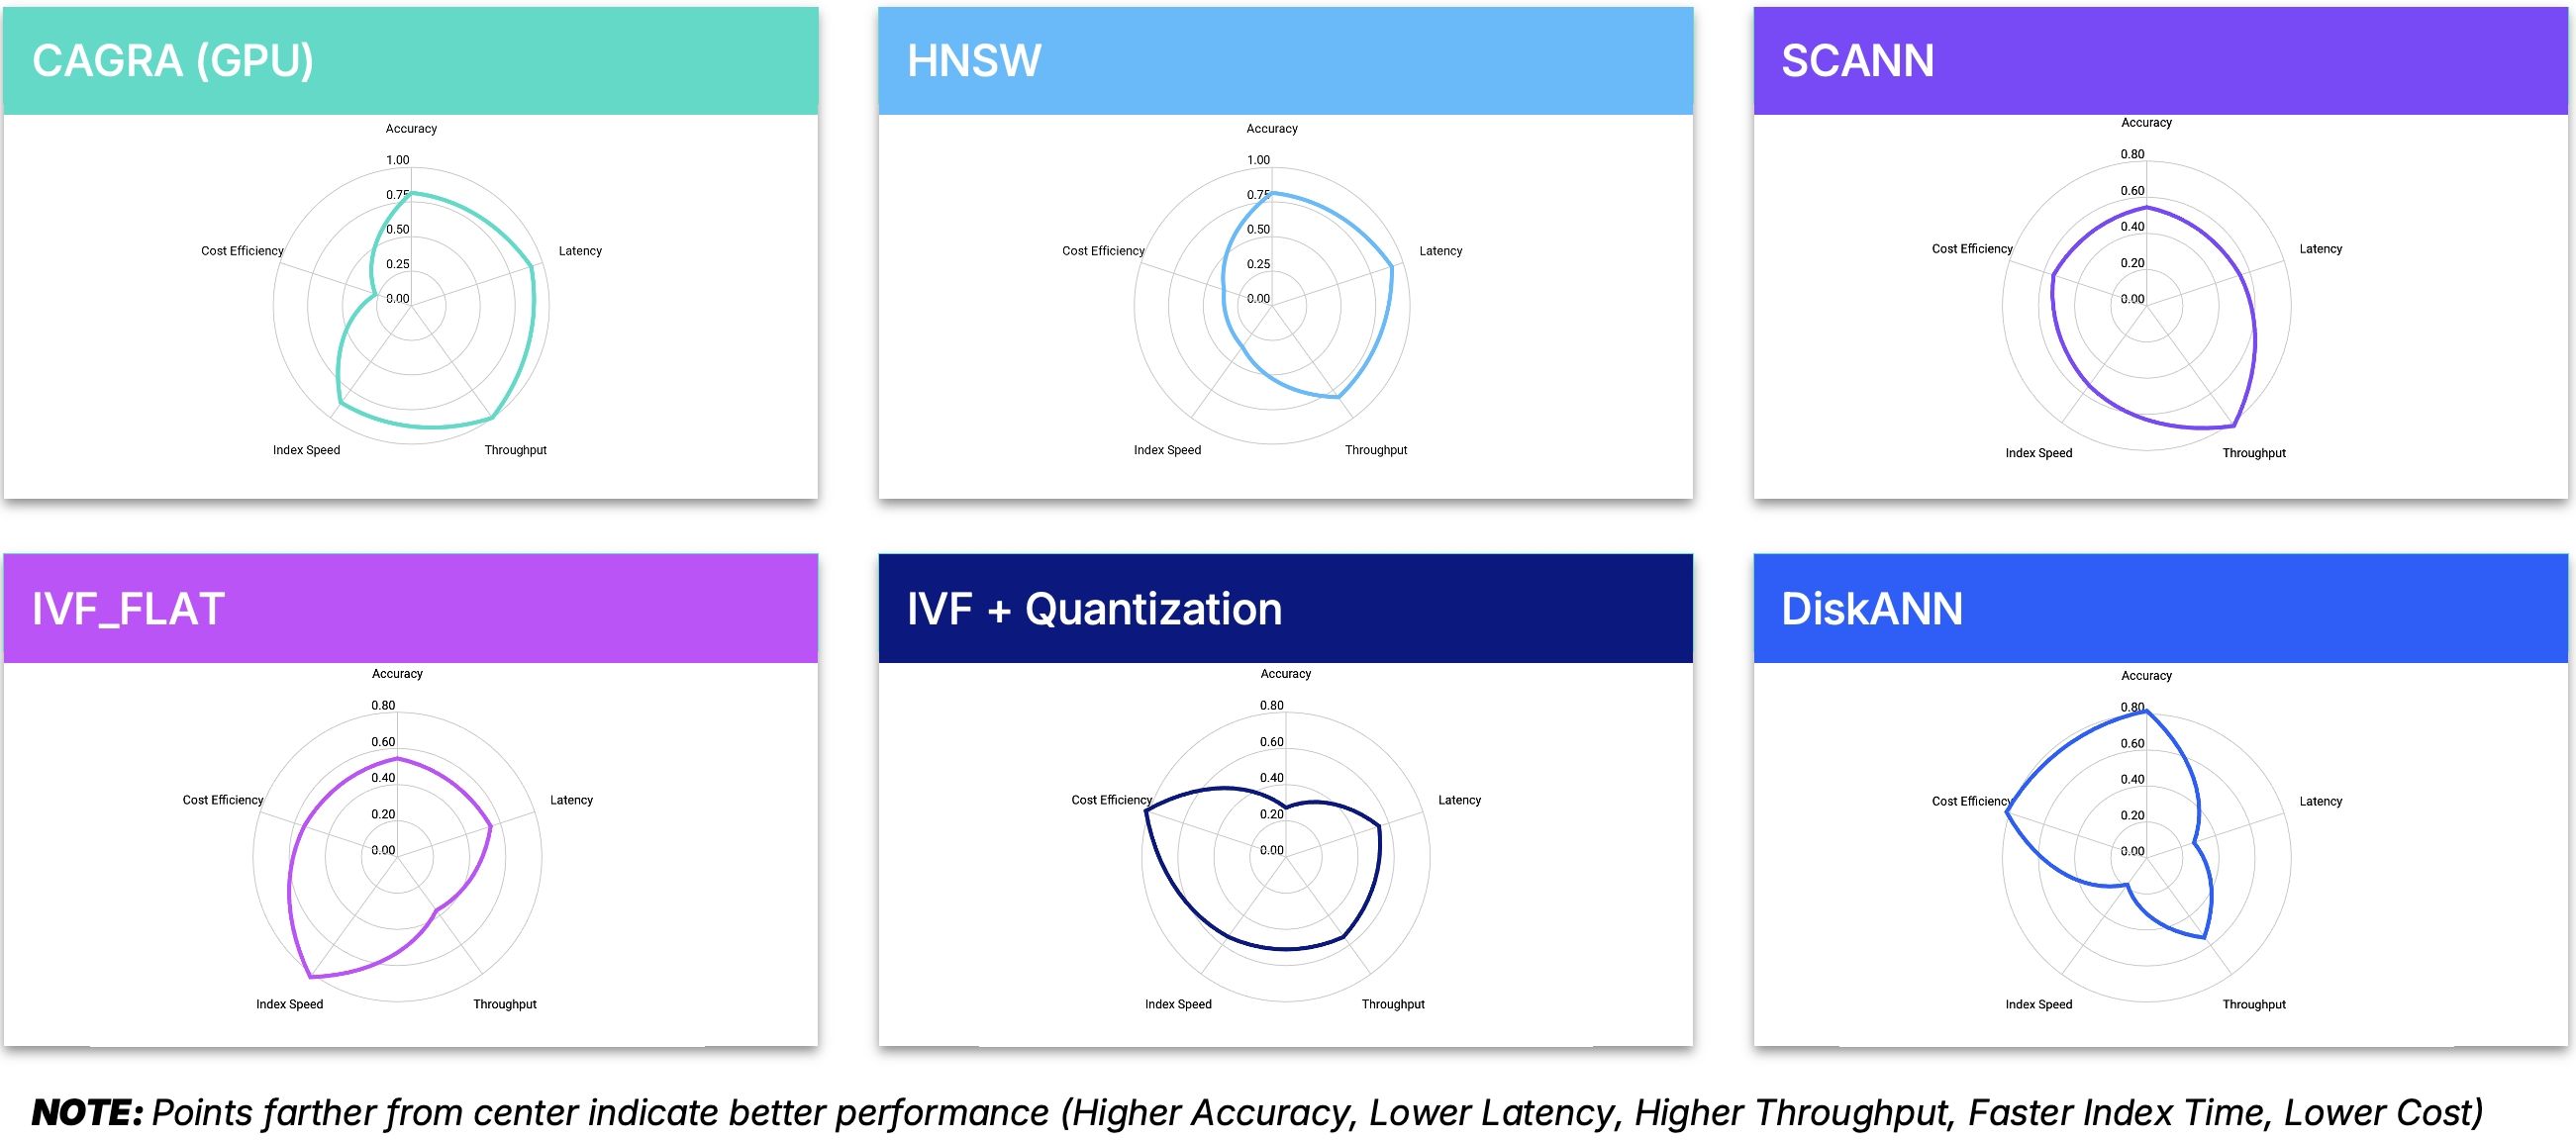 index
HNSW (Hierarchical Navigable Small World)
Architektur: Kombiniert Skip-Listen mit Navigable-Small-Worlds-(NSWs)-Graphen in einer hierarchischen Struktur
Performance: Sehr schnelle Abfragen mit hervorragenden Recall-Raten
Ressourcennutzung: Benötigt den meisten Speicher pro Vektor (höchste Kosten)
Am besten geeignet für: Anwendungen, bei denen Geschwindigkeit und Genauigkeit entscheidend sind und Speicherbeschränkungen weniger relevant sind
Technischer Hinweis: Die Suche beginnt in der obersten Ebene mit den wenigsten Knoten und verläuft nach unten durch zunehmend dichtere Ebenen
FLAT
Architektur: Einfache erschöpfende Suche ohne Approximation
Performance: 100 % Recall, aber extrem langsame Abfragezeiten (
O(n)für Datengrößen)Ressourcennutzung: Indexgröße entspricht der Größe der Rohvektordaten
Am besten geeignet für: Kleine Datensätze oder Anwendungen, die perfekten Recall erfordern
Technischer Hinweis: Führt vollständige Distanzberechnungen zwischen dem Abfragevektor und jedem Vektor in der Datenbank durch
IVF_FLAT
Architektur: Teilt den Vektorraum in Cluster auf, um effizienter zu suchen
Performance: Mittelhoher Recall bei moderater Abfragegeschwindigkeit (langsamer als HNSW, aber schneller als FLAT)
Ressourcennutzung: Benötigt weniger Speicher als FLAT, aber mehr als HNSW
Am besten geeignet für: Ausgewogene Anwendungen, bei denen ein gewisser Recall zugunsten besserer Performance eingetauscht werden kann
Technischer Hinweis: Während der Suche werden nur
nlistCluster untersucht, wodurch der Rechenaufwand erheblich reduziert wird
IVF_SQ8
Architektur: Wendet skalare Quantisierung auf IVF_FLAT an und komprimiert Vektordaten
Performance: Mittlerer Recall bei mittelhoher Abfragegeschwindigkeit
Ressourcennutzung: Reduziert Festplatten-, Rechen- und Speicherverbrauch im Vergleich zu IVF_FLAT um 70–75 %
Am besten geeignet für: Umgebungen mit begrenzten Ressourcen, in denen die Genauigkeit leicht beeinträchtigt werden kann
Technischer Hinweis: Komprimiert 32-Bit-Gleitkommawerte zu 8-Bit-Ganzzahlwerten
Erweiterte Indexoptionen: ScaNN, DiskANN, CAGRA und mehr
Für Entwickler mit spezialisierten Anforderungen bietet Milvus außerdem:
ScaNN: 20 % schneller auf der CPU als HNSW bei ähnlichen Recall-Raten
DiskANN: Ein hybrider Festplatten-/Speicherindex, der ideal ist, wenn Sie eine große Anzahl von Vektoren mit hoher Recall-Rate unterstützen müssen und eine etwas längere Latenz (~100 ms) akzeptieren können. Er gleicht Speichernutzung und Leistung aus, indem nur ein Teil des Index im Speicher gehalten wird, während der Rest auf der Festplatte verbleibt.
GPU-basierte Indizes:
GPU_CAGRA: Dies ist der schnellste der GPU-Indizes, erfordert jedoch eine Inferenzkarte mit GDDR-Speicher statt einer mit HBM-Speicher
GPU_BRUTE_FORCE: Auf GPU implementierte erschöpfende Suche
GPU_IVF_FLAT: GPU-beschleunigte Version von IVF_FLAT
GPU_IVF_PQ: GPU-beschleunigte Version von IVF mit Product Quantization
HNSW-PQ/SQ/PRQ:
HNSW_SQ: Sehr schnelle Abfrage, begrenzte Speicherressourcen; akzeptiert geringfügige Kompromisse bei der Recall-Rate.
HNSW_PQ: Abfrage mit mittlerer Geschwindigkeit; sehr begrenzte Speicherressourcen; akzeptiert geringfügige Kompromisse bei der Recall-Rate
HNSW_PRQ: Abfrage mit mittlerer Geschwindigkeit; sehr begrenzte Speicherressourcen; akzeptiert geringfügige Kompromisse bei der Recall-Rate
AUTOINDEX: Verwendet standardmäßig HNSW in Open-Source-Milvus (oder nutzt leistungsfähigere proprietäre Indizes in Zilliz Cloud, dem verwalteten Milvus).
Binäre, Sparse- und andere spezialisierte Indizes: Für spezifische Datentypen und Anwendungsfälle. Weitere Details finden Sie auf dieser Index-Dokumentationsseite.
Segmentgröße und Bereitstellungskonfiguration
Segmente sind die grundlegenden Bausteine der internen Datenorganisation von Milvus. Sie fungieren als Datenblöcke, die verteilte Suche und Lastverteilung über Ihre Bereitstellung hinweg ermöglichen. Dieses Milvus-Dimensionierungstool bietet drei Segmentgrößenoptionen (512 MB, 1024 MB, 2048 MB), wobei 1024 MB die Standardeinstellung ist.
Das Verständnis von Segmenten ist entscheidend für die Leistungsoptimierung. Als allgemeine Richtlinie gilt:
512-MB-Segmente: Am besten für Query Nodes mit 4–8 GB Speicher
1-GB-Segmente: Optimal für Query Nodes mit 8–16 GB Speicher
2-GB-Segmente: Empfohlen für Query Nodes mit >16 GB Speicher
Entwicklerhinweis: Weniger, größere Segmente liefern in der Regel eine schnellere Suchleistung. Für groß angelegte Bereitstellungen bieten 2-GB-Segmente oft das beste Gleichgewicht zwischen Speichereffizienz und Abfragegeschwindigkeit.
Auswahl des Message-Queue-Systems
Bei der Wahl zwischen Pulsar und Kafka als Messaging-System:
Pulsar: Empfohlen für neue Projekte aufgrund geringerer Overheads pro Topic und besserer Skalierbarkeit
Kafka: Kann vorzuziehen sein, wenn in Ihrer Organisation bereits Kafka-Expertise oder -Infrastruktur vorhanden ist
Enterprise-Optimierungen in Zilliz Cloud
Für Produktionsbereitstellungen mit strengen Leistungsanforderungen bietet Zilliz Cloud (die vollständig verwaltete und Enterprise-Version von Milvus in der Cloud) zusätzliche Optimierungen bei Indizierung und Quantisierung:
Verhinderung von Out of Memory (OOM): Ausgereiftes Speichermanagement zur Vermeidung von Abstürzen aufgrund von Speichermangel
Kompaktierungsoptimierung: Verbessert Suchleistung und Ressourcennutzung
Tiered Storage: Effiziente Verwaltung von Hot- und Cold-Daten mit geeigneten Compute Units
Standard-Compute-Units (CUs) für häufig abgerufene Daten
Tiered-Storage-CUs für kosteneffiziente Speicherung selten abgerufener Daten
Detaillierte Enterprise-Dimensionierungsoptionen finden Sie in der Dokumentation zu Zilliz Cloud-Serviceplänen.
Erweiterte Konfigurationstipps für Entwickler
Mehrere Indextypen: Das Dimensionierungstool konzentriert sich auf einen einzelnen Index. Für komplexe Anwendungen, die unterschiedliche Indexalgorithmen für verschiedene Collections erfordern, erstellen Sie separate Collections mit benutzerdefinierten Konfigurationen.
Speicherzuweisung: Berücksichtigen Sie bei der Planung Ihrer Bereitstellung sowohl die Anforderungen an Vektordaten als auch an den Indexspeicher. HNSW benötigt typischerweise das 2-3-Fache des Speichers der rohen Vektordaten.
Leistungstests: Bevor Sie Ihre Konfiguration finalisieren, benchmarken Sie Ihre spezifischen Abfragemuster auf einem repräsentativen Datensatz.
Skalierungsüberlegungen: Berücksichtigen Sie zukünftiges Wachstum. Es ist einfacher, mit etwas mehr Ressourcen zu beginnen, als später neu zu konfigurieren.
Fazit
Das Milvus Sizing Tool bietet einen hervorragenden Ausgangspunkt für die Ressourcenplanung, aber denken Sie daran, dass jede Anwendung individuelle Anforderungen hat. Für optimale Leistung sollten Sie Ihre Konfiguration basierend auf Ihren spezifischen Workload-Eigenschaften, Abfragemustern und Skalierungsanforderungen feinabstimmen.
Wir verbessern unsere Tools und Dokumentation kontinuierlich auf Grundlage von Nutzerfeedback. Wenn Sie Fragen haben oder weitere Unterstützung bei der Dimensionierung Ihrer Milvus-Bereitstellung benötigen, wenden Sie sich an unsere Community auf GitHub oder Discord.
Referenzen
 Fendy Feng
 is the Technical Marketing Writer at Zilliz. She has extensive experience developing and enhancing the impact of open-source projects in various global markets by producing high-quality, tailored content. Before joining Zilliz, Fendy worked as a Content Strategist at PingCAP, a fast-growing E-Series startup renowned for its open-source distributed SQL database.
 Ken Zhang
 is a Senior Product Manager at Zilliz, leading the development of the Milvus vector database by setting its strategic direction and key features. Prior to Zilliz, he served as a kernel engineer at SAP HANA and enhanced his product management skills at PingCAP. Ken holds a master's degree from Fudan University and has over eight years of experience specializing in database development and big data infrastructure management.
Weiterlesen
Migrating Self-Managed Milvus to Zilliz Cloud for >99% Latency Reduction
Step-by-step guide to migrating 50M vectors from self-managed Milvus to Zilliz Cloud using milvus-backup. Achieve >99% query latency reduction with zero data loss.
How to Choose the Best Embedding Model for RAG in 2026: 10 Models Benchmarked
We benchmarked 10 embedding models on cross-modal, cross-lingual, long-document, and dimension compression tasks. See which one fits your RAG pipeline.
Why Not All VectorDBs Are Agent-Ready
Explore why choosing the right vector database is critical for scaling AI agents, and why traditional solutions fall short in production.