Как ведущая мировая музыкальная платформа ищет более 100 миллионов песен по звуку и текстам с помощью Milvus
100M+ треков
Весь каталог встроен и доступен для поиска, включая длинный хвост.
~10 ms P99
Сопоставление среди миллиардов аудио-эмбеддингов со скоростью сотни поисков в секунду
По звучанию и смыслу
Найдите песню по напеву, фрагменту или перефразированному тексту, а не только по названию.
О музыкальной платформе
Платформа является одним из крупнейших в мире музыкальных стриминговых сервисов: в её каталоге более 100 миллионов треков, а сотни миллионов слушателей пользуются ею более чем в 100 странах.
Слушатели делают гораздо больше, чем просто нажимают play. Они подносят телефон, чтобы определить песню, играющую в другом конце комнаты, вводят наполовину запомнившуюся строку, чтобы найти трек, просят «больше похожего», чтобы заполнить вечер, и загружают собственные аудиозаписи, которые необходимо проверять на предмет прав по каталогу. Каждый из этих запросов ищет по всему каталогу, и нужно мгновенно попасть в нужный трек. Этот поисковый слой работает на Milvus.
Задача
Каталог платформы превышает 100 миллионов треков, а то, как слушатели выполняют поиск, создаёт сразу три требования.
Поиск музыки должен работать по звучанию и смыслу, а не только по ключевым словам. Слушатель напевает мелодию, включает пять секунд из динамика или вводит текст песни так, как его запомнил, а не так, как он был написан. Совпадений по названию или тегу нет. Платформе был нужен поиск, который работает с тем, как песня звучит и что означает текст, — то, что невозможно сделать только сопоставлением ключевых слов.
Каталог — это миллиарды векторов, и все они должны оставаться доступными для поиска. Поиск по звучанию означает разбиение каждого трека на короткие сегменты и построение эмбеддингов для каждого из них, поэтому более 100 миллионов треков превращаются в миллиарды аудиовекторов плюс текстовый вектор для каждого набора текстов песен. Каждый вектор должен оставаться в сети одновременно, включая «длинный хвост», — иначе малоизвестный трек, который никто не слушал год, окажется именно тем, который поиск не найдёт.
Каждый поиск должен выполняться в реальном времени в масштабе. Определение песни или ответ на запрос по тексту — это то, чего слушатель ждёт, поэтому ответ должен приходить за миллисекунды, при сотнях запросов в секунду, по всем этим миллиардам векторов. Скорость не должна падать по мере роста каталога.
Почему Milvus
Milvus напрямую отвечает на все три требования, поэтому команда построила на нём свой поиск.
Создан специально для векторного, полнотекстового поиска и фильтрации по метаданным в одном запросе. Milvus хранит аудио- и текстовые эмбеддинги и находит ближайших соседей на основе того, как звучит фрагмент или что означает текст, поэтому напев или перефразированная строка приводят к нужному треку. Для текстов он объединяет полнотекстовый поиск по ключевым словам с векторным поиском в едином гибридном запросе — сопоставляя слова и смысл вместе — и применяет фильтры по метаданным (исполнитель, жанр, территория, права) в том же вызове. Это гибридный поиск, который не может обеспечить система, работающая только с ключевыми словами.
Проверен на миллиардах векторов. Milvus — это распределённая база данных, предназначенная для коллекций биллионного масштаба, поэтому весь каталог эмбеддингов живёт в одной системе и масштабируется вместе с кластером по мере роста библиотеки, без перестройки архитектуры на каждом новом этапе.
Миллисекундная задержка при высокой пропускной способности. Milvus возвращает совпадение примерно за 10 миллисекунд при сотнях запросов в секунду по миллиардам векторов и изолирует ресурсоёмкое индексирование от живых запросов, поэтому поиск остаётся быстрым, пока добавляется новая музыка.
Открытый исходный код, работающий на собственной инфраструктуре. Помимо выполнения этих требований, Milvus имеет открытый исходный код, поэтому команды, работающие в таком масштабе, запускают его на своей инфраструктуре, настраивают и расширяют его под свою нагрузку и интегрируют в свой стек без привязки к вендору.
Решение
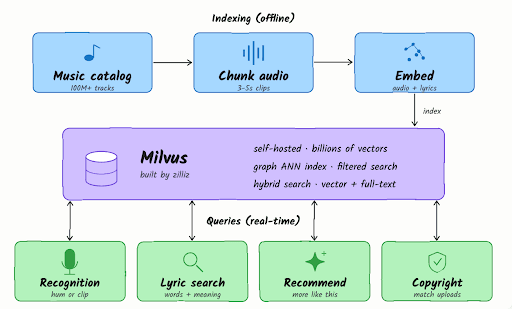
Milvus — это слой поиска по сходству, лежащий в основе каждой функции, которая находит музыку по её звучанию или смыслу. И аудио, и текст превращаются в векторы и живут в Milvus рядом с метаданными, используемыми для их фильтрации.
 Anonymous Music Insert.png
Индексация каталога. Каждый трек нарезается на короткие перекрывающиеся клипы, и аудиомодель превращает каждый клип в вектор, отражающий его звучание: тембр, мелодию и ритм. Таким образом, один трек становится последовательностью векторов — по одному каждые несколько секунд, а не одной точкой. Тексты песен обрабатываются отдельно текстовой моделью: каждый текст эмбедится как вектор и индексируется для полнотекстового поиска, поэтому запрос может соответствовать смыслу или точным словам. Исполнитель, альбом, жанр, дата релиза, популярность и территория/права записываются как скалярные поля в тех же записях. Аудиоклипы образуют коллекцию миллиардного масштаба; рядом с ними располагаются векторы текстов, полнотекстовый индекс и метаданные. Графовый ANN-индекс (HNSW) обеспечивает быстрое нахождение ближайших соседей, а скалярные индексы делают метаданные фильтруемыми.
Ответ на запрос. Все четыре продуктовые функции сводятся к поиску по сходству в Milvus:
- Распознавание песни. Несколько секунд захваченного аудио эмбедятся и ищутся по аудиоколлекции в Milvus, где каждый трек хранится в виде множества коротких клипов по порядку. Запись совпадает с последовательностью подряд идущих клипов из одной песни — это может дать только правильный трек, поэтому Milvus привязывает её к этой единственной песне и возвращает результат в реальном времени.
- Поиск по тексту песни. Каждый текст хранится в Milvus с семантическим плотным вектором и полнотекстовым индексом (BM25) в одной записи, поэтому один гибридный поиск сопоставляет смысл и формулировку вместе и возвращает единый ранжированный список. Помнит ли слушатель строку дословно или только её суть — запрос попадает на нужную песню.
- Рекомендации. Трек, который слушает пользователь, становится запросом, и Milvus возвращает похожие по звучанию треки для радио и открытия новой музыки, отфильтрованные по территории и вкусам слушателя.
- Проверка авторских прав. Загруженный клип разбивается на фрагменты и ищется по каталогу; последовательность результатов с высокой степенью сходства помечает использование охраняемого материала, а поля прав определяют правообладателя.
Все четыре функции ищут по одним и тем же данным в Milvus: по тем же аудио- и текстовым векторам, по тем же метаданным и с теми же фильтрами в каждом запросе. Различается только настройка. Команда размещает слой поиска на собственной инфраструктуре в виде парка кластеров Milvus и масштабирует каждый под свою задачу: путь распознавания — для минимальной задержки, коллекции полного каталога — для пропускной способности и полноты при росте до миллиардов. Новая музыка проходит тот же путь индексации и становится доступной для поиска в момент появления.
Результаты и преимущества
- Любая песня распознаётся примерно за 10 миллисекунд при сотнях запросов в секунду. Несколько секунд аудио или одна строка текста возвращают точный трек достаточно быстро, чтобы слушатель воспринимал это как мгновенный ответ, даже при высокой параллельной нагрузке.
- Все 100 с лишним миллионов треков остаются доступными для поиска среди миллиардов векторов. Каждый трек эмбедится и находится онлайн, включая «длинный хвост», поэтому ни одна песня не теряется из-за слишком большого каталога.
- Песни находятся по звучанию и смыслу, а не только по названию. Напетая мелодия, пятисекундный клип или неточно запомнившийся текст приводят к нужному треку — то, что поиск по ключевым словам никогда бы не смог сделать.
- Распознавание, поиск по текстам, рекомендации и проверка авторских прав работают на одном движке. Новая аудиофункция стартует со слоя, который уже ищет по полному каталогу в реальном времени, а не с новой системы, которую нужно разворачивать.
- Всё это работает на собственной инфраструктуре команды и масштабируется за счёт роста кластера. С ростом трафика и каталога команда добавляет мощности к уже работающим кластерам Milvus, без перепроектирования слоя поиска.
Стратегический выигрыш в том, что «поиск по звуку» перестаёт быть проектом и становится возможностью. Всё, что платформа захочет построить на том, как звучит музыка, начинается с фундамента, который уже ищет по всем 100 с лишним миллионам треков в реальном времени.
Начните работу с Milvus
Milvus — самая широко используемая в мире опенсорсная векторная база данных с более чем 46 000 звёзд на GitHub, созданная для поиска по сходству в миллиардном масштабе. Она работает где угодно — от ноутбука до распределённого кластера — и даёт командам полный контроль над тем, как они индексируют, фильтруют и масштабируют векторные нагрузки.
Начните работу с Milvus на GitHub, читайте документацию или присоединяйтесь к сообществу в Discord.
Команды, которые предпочитают не запускать Milvus самостоятельно, могут использовать тот же движок как полностью управляемый сервис на Zilliz Cloud, с бесплатным тарифом для старта.
- О музыкальной платформе
- Задача
- Почему Milvus
- Решение
- Результаты и преимущества
- Начните работу с Milvus
Контент
Отрасль
Развлечения