Como uma Plataforma de Música Líder Mundial Pesquisa Mais de 100 Milhões de Músicas por Som e Letras com Milvus
100M+ faixas
Todo o catálogo incorporado e pesquisável, incluindo a cauda longa.
~10 ms P99
Uma correspondência entre bilhões de embeddings de áudio, a centenas de buscas por segundo.
Pelo som e pelo significado
Encontre uma música a partir de um cantarolar, um clipe ou uma letra parafraseada, não apenas o seu título.
Sobre a Plataforma de Música
A plataforma é um dos maiores serviços de streaming de música do mundo, com um catálogo de mais de 100 milhões de faixas e centenas de milhões de ouvintes em mais de 100 países.
Seus ouvintes fazem muito mais do que apertar o play. Eles levantam o telefone para identificar uma música tocando do outro lado da sala, digitam um trecho lembrado pela metade para encontrar uma faixa, pedem "mais como esta" para preencher uma noite e enviam seu próprio áudio que precisa ser verificado em relação ao catálogo para questões de direitos. Cada um pesquisa o catálogo inteiro, e a busca precisa encontrar a faixa certa instantaneamente. Essa camada de busca roda no Milvus.
O Desafio
O catálogo da plataforma ultrapassa 100 milhões de faixas, e a forma como os ouvintes o pesquisam criou três exigências ao mesmo tempo.
A busca de música precisa funcionar por som e significado, não apenas por palavras-chave. Um ouvinte cantarola uma melodia, toca cinco segundos de uma caixa de som ou digita um verso do jeito que se lembra dele, em vez de como foi escrito. Não há título ou tag para usar na correspondência. A plataforma precisava de uma busca que funcionasse com o som de uma música e o significado de uma letra — algo que a correspondência por palavras-chave sozinha não pode fazer.
O catálogo são bilhões de vetores, e tudo precisa continuar pesquisável. A correspondência por som significa dividir cada faixa em segmentos curtos e gerar embeddings para cada um; assim, mais de 100 milhões de faixas se tornam bilhões de vetores de áudio, além de um vetor de texto para cada conjunto de letras. Todos precisam permanecer online ao mesmo tempo, incluindo a cauda longa; caso contrário, a faixa obscura que ninguém tocou em um ano é exatamente aquela que a busca não consegue encontrar.
Toda busca precisa retornar em tempo real, em escala. Identificar uma música ou responder a uma consulta de letra é algo que o ouvinte espera, então precisa retornar em milissegundos, a centenas de buscas por segundo, sobre esses bilhões de vetores. A velocidade não pode degradar conforme o catálogo continua crescendo.
Por que Milvus
Milvus atende diretamente a todas as três exigências, por isso a equipe construiu sua busca sobre ele.
Construído especificamente para busca vetorial, de texto completo e com filtro de metadados em uma única consulta. O Milvus armazena embeddings de áudio e de letras e encontra vizinhos mais próximos com base em como um trecho soa ou no que uma letra significa; assim, um cantarolar ou uma linha parafraseada leva à faixa certa. Para letras, ele combina busca por palavras-chave em texto completo com busca vetorial em uma única consulta híbrida — unindo as palavras e o significado — e aplica filtros de metadados (artista, gênero, território, direitos) na mesma chamada. Isso é busca híbrida que um sistema apenas por palavras-chave não consegue oferecer.
Comprovado em bilhões de vetores. O Milvus é um banco de dados distribuído projetado para coleções em escala de bilhões; assim, todo o catálogo com embeddings vive em um único sistema e escala horizontalmente com o cluster à medida que o acervo cresce, sem necessidade de rearquitetura a cada novo marco.
Latência de milissegundos com alto throughput. O Milvus retorna uma correspondência em cerca de 10 milissegundos, a centenas de consultas por segundo, sobre bilhões de vetores, e isola a indexação pesada das consultas ao vivo para que a busca continue rápida enquanto novas músicas são adicionadas.
Open source, executado em sua própria infraestrutura. Além de atender a essas exigências, o Milvus é open source; assim, equipes que operam nessa escala o executam em sua própria infraestrutura, ajustam e estendem conforme a carga de trabalho e o integram à sua stack sem ficar presas a um fornecedor.
A Solução
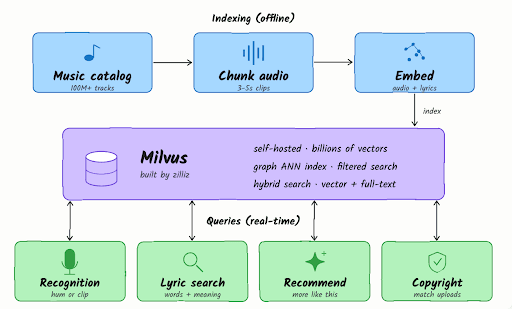
Milvus é a camada de busca por similaridade sob cada recurso que encontra música pelo som ou pelo significado. Áudio e texto se tornam vetores e vivem no Milvus ao lado dos metadados usados para filtrá-los.
 Anonymous Music Insert.png
Indexando o catálogo. Cada faixa é cortada em clipes curtos e sobrepostos, e um modelo de áudio transforma cada clipe em um vetor que captura como ele soa: seu timbre, melodia e ritmo. Uma faixa torna-se, portanto, uma sequência de vetores, um a cada poucos segundos, em vez de um único ponto. As letras são tratadas separadamente por um modelo de texto: cada conjunto é incorporado como um vetor e indexado para busca em texto completo, de modo que uma consulta pode corresponder pelo significado ou pelas palavras exatas. Artista, álbum, gênero, data de lançamento, popularidade e território/direitos são gravados como campos escalares nos mesmos registros. Os clipes de áudio formam uma coleção em escala de bilhões; os vetores de letras, o índice de texto completo e os metadados ficam ao lado deles. Um índice ANN baseado em grafo (HNSW) mantém a revocação rápida, e os índices escalares tornam os metadados filtráveis.
Respondendo a uma consulta. Quatro funcionalidades do produto se resumem a uma busca por similaridade no Milvus:
- Reconhecimento de músicas. Alguns segundos de áudio capturado são incorporados e pesquisados na coleção de áudio no Milvus, onde cada faixa é armazenada como muitos clipes curtos em ordem. A gravação corresponde a uma sequência de clipes consecutivos da mesma música, algo que apenas a faixa certa pode produzir, então o Milvus a associa a essa única música e a retorna em tempo real.
- Busca por letra. Cada letra é armazenada no Milvus com um vetor denso semântico e um índice de texto completo (BM25) no mesmo registro, de modo que uma única busca híbrida combine significado e redação juntos e retorne uma lista classificada. Quer o ouvinte se lembre da frase palavra por palavra ou apenas do sentido geral, a consulta chega à música certa.
- Recomendação. A faixa que um ouvinte está tocando torna-se a consulta, e o Milvus retorna faixas sonicamente semelhantes para rádio e descoberta, filtradas pelo território e gosto do ouvinte.
- Correspondência de direitos autorais. Um clipe enviado é dividido em partes e pesquisado no catálogo; uma sequência de correspondências de alta similaridade sinaliza reutilização de material protegido, e os campos de direitos resolvem a propriedade.
Todas as quatro funcionalidades pesquisam os mesmos dados no Milvus: os mesmos vetores de áudio e de letras, os mesmos metadados e os mesmos filtros contidos em cada consulta. O que difere é o ajuste. A equipe auto-hospeda a camada de recuperação como uma frota de clusters Milvus e dimensiona cada um para sua função: o caminho de reconhecimento para a menor latência, as coleções do catálogo completo para vazão e revocação à medida que escalam para os bilhões. A música nova passa pelo mesmo caminho de indexação e fica pesquisável no momento em que chega.
Resultados e Benefícios
- Qualquer música é identificada em cerca de 10 milissegundos, a centenas de buscas por segundo. Alguns segundos de áudio, ou uma única linha de texto, retornam a faixa exata rápido o suficiente para parecer instantâneo ao ouvinte, mesmo sob alta carga concorrente.
- Todas as mais de 100 milhões de faixas permanecem pesquisáveis, em bilhões de vetores. Cada faixa é incorporada e fica online, incluindo a cauda longa, de modo que nenhuma música fica impossível de encontrar porque o catálogo cresceu demais.
- As músicas são encontradas pelo som e pelo significado, não apenas pelo título. Uma melodia cantarolada, um clipe de cinco segundos ou uma letra mal lembrada chegam à faixa certa, algo que a busca por palavras-chave nunca conseguiria fazer.
- Reconhecimento, busca por letra, recomendação e correspondência de direitos autorais rodam em um único mecanismo. Uma nova funcionalidade de áudio parte de uma camada que já pesquisa o catálogo completo em tempo real, e não de um novo sistema a ser implementado.
- Tudo roda na infraestrutura própria da equipe, escalando pelo crescimento do cluster. À medida que o tráfego e o catálogo crescem, a equipe adiciona capacidade aos clusters Milvus que já opera, sem redesenhar a camada de busca.
O retorno estratégico é que a "busca por som" deixa de ser um projeto e se torna uma capacidade. Qualquer coisa que a plataforma queira construir sobre como a música soa parte de uma fundação que já pesquisa todas as mais de 100 milhões de faixas em tempo real.
Milvus é o banco de dados vetorial de código aberto mais adotado do mundo, com 46K+ estrelas no GitHub, construído para busca de similaridade em escala de bilhões. Ele roda em qualquer lugar, de um laptop a um cluster distribuído, e dá às equipes controle total sobre como indexar, filtrar e dimensionar cargas de trabalho vetoriais.
Comece com o Milvus no GitHub, leia a documentação, ou participe da comunidade no Discord.
Equipes que preferem não executar o próprio Milvus podem usar o mesmo mecanismo como um serviço totalmente gerenciado no Zilliz Cloud, com uma camada gratuita para começar.
Indústria
Entretenimento