Wie eine weltweit führende Musikplattform mit Milvus über 100 Millionen Songs nach Klang und Songtext durchsucht
100M+ Titel
Der gesamte Katalog eingebettet und durchsuchbar, einschließlich des Long Tails.
~10 ms P99
Ein Treffer unter Milliarden von Audio-Embeddings, bei hunderten Suchanfragen pro Sekunde
Durch Klang und Bedeutung
Finde einen Song anhand einer Melodie, eines Clips oder eines umschriebenen Liedtexts, nicht nur anhand seines Titels.
Über die Musikplattform
Die Plattform ist einer der größten Musik-Streaming-Dienste der Welt, mit einem Katalog von mehr als 100 Millionen Titeln und Hunderten Millionen Hörern in über 100 Ländern.
Ihre Hörer tun weit mehr, als nur Play zu drücken. Sie halten ein Telefon hoch, um einen Song zu benennen, der in einem Raum gespielt wird, tippen eine halb erinnerte Zeile ein, um einen Titel zu finden, fragen nach "mehr davon", um einen Abend zu füllen, und laden eigene Audiodateien hoch, die zur Rechteklärung mit dem Katalog abgeglichen werden müssen. Jede Suchanfrage durchsucht den gesamten Katalog und muss sofort den richtigen Titel treffen. Diese Suchschicht läuft auf Milvus.
Die Herausforderung
Der Katalog der Plattform geht über 100 Millionen Titel hinaus, und die Art und Weise, wie Hörer darin suchen, brachte drei Anforderungen zugleich mit sich.
Die Musiksuche muss mit Klang und Bedeutung arbeiten, nicht nur mit Stichwörtern. Ein Hörer summt eine Melodie, spielt fünf Sekunden über einen Lautsprecher ab oder tippt einen Liedtext so ein, wie er ihn in Erinnerung hat, statt so, wie er geschrieben wurde. Es gibt keine Titel oder Tags, mit denen man abgleichen könnte. Die Plattform brauchte eine Suche, die darauf basiert, wie ein Song klingt und was ein Liedtext bedeutet — etwas, das reine Stichwortsuche allein nicht leisten kann.
Der Katalog umfasst Milliarden von Vektoren, und alles muss durchsuchbar bleiben. Das Abgleichen anhand des Klangs bedeutet, jeden Titel in kurze Segmente zu zerlegen und jedes einzelne einzubetten. So werden aus über 100 Millionen Titeln Milliarden von Audio-Vektoren plus ein Textvektor für jeden Liedtext. Jeder einzelne muss gleichzeitig online bleiben, einschließlich des Long Tails — sonst ist genau der obskure Titel, den seit einem Jahr niemand gespielt hat, der, den die Suche nicht findet.
Jede Suche muss in Echtzeit und in großem Maßstab zurückkommen. Einen Song zu identifizieren oder eine Liedtextabfrage zu beantworten ist etwas, auf das ein Hörer wartet. Das Ergebnis muss also in Millisekunden zurückkommen, bei Hunderten von Suchanfragen pro Sekunde und über diese Milliarden von Vektoren hinweg. Die Geschwindigkeit darf nicht nachlassen, während der Katalog weiter wächst.
Warum Milvus
Milvus erfüllt alle drei Anforderungen direkt, weshalb das Team seine Suche darauf aufgebaut hat.
Speziell entwickelt für Vektor-, Volltext- und metadaten-gefilterte Suche in einer einzigen Abfrage. Milvus speichert Audio- und Liedtext-Embeddings und findet die nächsten Nachbarn basierend darauf, wie ein Clip klingt oder was ein Liedtext bedeutet, sodass ein Summen oder eine paraphrasierte Zeile zum richtigen Titel führt. Für Liedtexte kombiniert es die Volltext-Stichwortsuche mit der Vektorsuche in einer einzigen Hybrid-Abfrage — die Wörter und die Bedeutung werden zusammen abgeglichen — und wendet Metadatenfilter (Künstler, Genre, Gebiet, Rechte) im selben Aufruf an. Das ist eine hybride Suche, die ein reines Stichwort-System nicht liefern kann.
Bewährt bei Milliarden von Vektoren. Milvus ist eine verteilte Datenbank, die für Sammlungen im Milliardenmaßstab entwickelt wurde. So lebt der gesamte Embedding-Katalog in einem System und skaliert mit dem Cluster mit, während die Bibliothek wächst — ohne dass bei jedem neuen Meilenstein eine Neuarchitektur nötig wird.
Millisekunden-Latenz bei hohem Durchsatz. Milvus liefert in etwa 10 Millisekunden eine Übereinstimmung, bei Hunderten von Abfragen pro Sekunde über Milliarden von Vektoren, und trennt aufwendige Indexierung von Live-Abfragen, sodass die Suche schnell bleibt, während neue Musik hinzugefügt wird.
Open Source, betrieben auf der eigenen Infrastruktur. Über die Erfüllung dieser Anforderungen hinaus ist Milvus Open Source, sodass Teams, die in dieser Größenordnung arbeiten, es auf ihrer eigenen Infrastruktur betreiben, es je nach Workload anpassen und erweitern und in ihren Stack integrieren können — ohne Vendor-Lock-in.
Die Lösung
Milvus ist die Schicht für Ähnlichkeitssuche, die jeder Funktion zugrunde liegt, die Musik danach findet, wie sie klingt oder was sie bedeutet. Audio und Liedtexte werden beide zu Vektoren und liegen in Milvus neben den Metadaten, mit denen sie gefiltert werden.
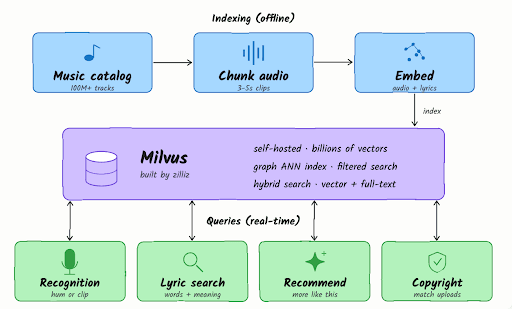 Anonymous Music Insert.png
Indizierung des Katalogs. Jeder Titel wird in kurze, überlappende Clips geschnitten, und ein Audiomodell wandelt jeden Clip in einen Vektor um, der erfasst, wie er klingt: Klangfarbe, Melodie und Rhythmus. Ein Titel wird also zu einer Folge von Vektoren, einem alle paar Sekunden, statt zu einem einzelnen Punkt. Songtexte werden separat von einem Textmodell verarbeitet: Jeder Text wird als Vektor eingebettet und für die Volltextsuche indiziert, sodass eine Abfrage auf Bedeutung oder auf die genauen Wörter passen kann. Künstler, Album, Genre, Veröffentlichungsdatum, Popularität und Gebiet/Rechte werden als Skalarfelder auf denselben Datensätzen gespeichert. Die Audioclips bilden eine Sammlung im Milliardenmaßstab; die Textvektoren, der Volltextindex und die Metadaten liegen daneben. Ein graphbasierter ANN-Index (HNSW) hält den Recall schnell, und Skalarindizes machen die Metadaten filterbar.
Beantwortung einer Abfrage. Vier Produktfunktionen laufen alle auf eine Ähnlichkeitssuche in Milvus hinaus:
- Songerkennung. Einige Sekunden aufgenommenen Audios werden eingebettet und gegen die Audiosammlung in Milvus gesucht, in der jeder Titel als viele kurze Clips in der richtigen Reihenfolge gespeichert ist. Die Aufnahme passt auf eine Folge aufeinanderfolgender Clips aus demselben Song – etwas, das nur der richtige Titel erzeugen kann –, daher ordnet Milvus sie genau diesem einen Song zu und gibt ihn in Echtzeit zurück.
- Liedtextsuche. Jeder Liedtext wird in Milvus mit sowohl einem semantischen dichten Vektor als auch einem Volltext-Index (BM25) auf demselben Datensatz gespeichert, sodass eine einzelne hybride Suche Bedeutung und Wortlaut zusammen abgleicht und eine einzige Rangliste zurückgibt. Ob sich ein Hörer die Zeile wortwörtlich merkt oder nur ihren Kern, die Abfrage landet beim richtigen Song.
- Empfehlung. Der Titel, den ein Hörer gerade abspielt, wird zur Abfrage, und Milvus liefert klanglich ähnliche Titel für Radio und Entdeckung, gefiltert nach dem Gebiet und Geschmack des Hörers.
- Urheberrechtsabgleich. Ein hochgeladener Clip wird in Stücke zerlegt und gegen den Katalog gesucht; eine Folge von Treffern mit hoher Ähnlichkeit kennzeichnet die Wiederverwendung von geschütztem Material, und die Rechtefelder klären die Eigentümerschaft.
Alle vier Funktionen durchsuchen dieselben Daten in Milvus: dieselben Audio- und Textvektoren, dieselben Metadaten und dieselben Filter, die in jeder Abfrage mitgeführt werden. Unterschiedlich ist die Abstimmung. Das Team hostet die Abrufschicht selbst als eine Flotte von Milvus-Clustern und dimensioniert jeden nach seiner Aufgabe: den Erkennungspfad für die niedrigste Latenz, die Sammlungen des vollständigen Katalogs für Durchsatz und Recall, während sie in die Milliarden skalieren. Neue Musik durchläuft denselben Indizierungspfad und ist in dem Moment durchsuchbar, in dem sie eintrifft.
Ergebnisse & Vorteile
- Jeder Song wird in etwa 10 Millisekunden identifiziert, bei Hunderten von Suchanfragen pro Sekunde. Ein paar Sekunden Audio oder eine einzelne Textzeile liefern den exakten Titel schnell genug, um sich für den Hörer augenblicklich anzufühlen, selbst unter hoher paralleler Last.
- Alle über 100 Millionen Titel bleiben durchsuchbar, über Milliarden von Vektoren hinweg. Jeder Titel ist eingebettet und online, einschließlich des Long Tails, sodass kein Song unauffindbar ist, weil der Katalog zu groß geworden ist.
- Songs werden nach Klang und Bedeutung gefunden, nicht nur nach Titel. Eine gesummte Melodie, ein Fünf-Sekunden-Clip oder ein falsch erinnerter Liedtext führt zum richtigen Titel – etwas, das eine Stichwortsuche nie leisten könnte.
- Erkennung, Liedtextsuche, Empfehlung und Urheberrechtsabgleich laufen auf einer Engine. Eine neue Audiofunktion startet von einer Ebene aus, die bereits den gesamten Katalog in Echtzeit durchsucht, nicht von einem neuen System, das erst aufgebaut werden muss.
- Alles läuft auf der eigenen Infrastruktur des Teams und skaliert durch das Wachstum des Clusters. Wenn Datenverkehr und Katalog wachsen, erweitert das Team die Kapazität der bereits betriebenen Milvus-Cluster, ohne die Suchschicht neu zu gestalten.
Der strategische Nutzen ist, dass „Suche nach Klang“ kein Projekt mehr ist, sondern eine Fähigkeit wird. Alles, was die Plattform auf der Grundlage des Klangs von Musik aufbauen möchte, beginnt mit einer Basis, die bereits alle über 100 Millionen Titel in Echtzeit durchsucht.
Erste Schritte mit Milvus
Milvus ist die weltweit am weitesten verbreitete Open-Source-Vektordatenbank mit 46K+ GitHub-Sternen, entwickelt für die Ähnlichkeitssuche im Milliardenmaßstab. Sie läuft überall, vom Laptop bis zum verteilten Cluster, und gibt Teams die volle Kontrolle darüber, wie sie Vektor-Workloads indizieren, filtern und skalieren.
Starten Sie mit Milvus auf GitHub, lesen Sie die Dokumentation, oder treten Sie der Community auf Discord bei.
Teams, die Milvus lieber nicht selbst betreiben möchten, können dieselbe Engine als vollständig verwalteten Dienst auf Zilliz Cloud nutzen, mit einem kostenlosen Einstiegstarif.